Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Megjegyzés
Azure AI Keresés a Azure portálon, REST API-kon és Azure SDK-k keresztül érhető el. Emellett a Foundry IQ-t is támogatja, amely a vállalati tartalmakat újrafelhasználható, engedélytudatos tudásbázisokká alakítja át az Microsoft Foundry portálon található ügynökök számára.
Az indexelők időnként olyan problémákba ütköznek, amelyek nem okoznak hibákat, vagy más Azure-szolgáltatásokban fordulnak elő, például a hitelesítés vagy a csatlakozás során. Ez a cikk az indexelők problémáinak elhárítására összpontosít, ha nincsenek olyan üzenetek, amelyek irányítják Önt. Az indexelés során használt nem keresési erőforrásokból származó hibák hibaelhárítását is biztosítja.
Megjegyzés
Ha egy Azure AI Keresés hibát kell kivizsgálni, akkor inkább tekintse meg az indexelők gyakori hibáinak és figyelmeztetéseinek hibaelhárító útmutatóját.
Ajánlott eljárások
Az indexelők használata során az alábbi ajánlott eljárások és javaslatok érhetők el:
Az indexelőket úgy tervezték, hogy ütemezés szerint fussanak
- A megbízható indexelés érdekében konfigurálja az indexelőket úgy, hogy rendszeres ütemezés szerint fussanak. Az ütemezett futtatások automatikusan felveszik azokat a dokumentumokat, amelyek átmeneti hibák, hálózati problémák vagy ideiglenes szolgáltatáshibák miatt kimaradtak az előző futtatásokból. Ez a megközelítés segít fenntartani az adatkonzisztenciát, és minimálisra csökkenti a manuális beavatkozás szükségességét.
- Nagy adatforrások esetén a kezdeti enumerálás és indexelés órákat vagy akár napokat is igénybe vehet. Az indexelő ütemezés szerinti futtatása lehetővé teszi az előrehaladás folytatását, és a hibák automatikus újrapróbálkozódása. Ne támaszkodjon kizárólag manuális vagy igény szerinti indexelő futtatásokra, mivel ezek a beállítások nem biztosítják ugyanazt a megbízhatóságot vagy átmeneti hibahelyreállítást.
Az indexelők az idő függvényében biztosítják az optimális indexelést
- A beépített indexelők állandó hibák nélkül dolgozzák fel a dokumentumokat, és újrapróbálkoznak az ütemezett futtatások között. Kényelmes, alacsony kódszámú vagy kód nélküli módot kínálnak az adatok indexelésére a gyakori forgatókönyvek esetében, ami gyorsabb fejlesztést és könnyebb karbantartást tesz lehetővé. Ha egy indexelő egy képességkészletet futtat, minden futtatáshoz rögzített végrehajtási időkorlát tartozik. A több-bérlős végrehajtási környezetben futó indexelők maximális futási ideje két óra. Ez a korlát a leggyakoribb eset, amelyet akkor használnak, ha a képességkészletek nem igényelnek megosztott privát kapcsolatokat. A megosztott privát hivatkozások használatára konfigurált indexelők legfeljebb 24 órás privát végrehajtási környezetben futnak. A teljes táblázatért tekintse meg az Indexelő korlátait. Ha a dokumentumonkénti készségkészlet-feldolgozás megakadályozza, hogy az indexelő az időkorlát előtt befejeződjön, leáll, és a fennmaradó dokumentumokat feldolgozatlan állapotban hagyja. A teljes feldolgozás nem garantált, ha a dokumentumkötet, a fájlméret, a képességkészlet összetettsége vagy a végrehajtási környezet megakadályozza, hogy az indexelő a maximális futási időn belül befejeződik. Az adatforrás particionálása csökkentheti ezt a kockázatot, de nem szünteti meg azt, különösen akkor, ha később nagy mennyiségű fájlt ad hozzá egy partícióhoz. Ez egy elvárt viselkedés. A nagy adathalmazok kezelésére és a növekményes helyreállítás támogatására vonatkozó stratégiákért lásd: Nagyméretű adathalmazokindexelése és indexelők ütemezése. Ha a megoldás szigorú ellenőrzést igényel, amikor az indexelő feldolgozza a dokumentumokat, használja ebben a cikkben a Push API alternatívát.
- Ha a megoldás szigorúan szabályozni szeretné az indexelési ütemterveket, használja inkább a Push API-kat, például a Documents Index REST API-t vagy az IndexDocuments metódust (Azure SDK for .NET). Ezekkel a beállításokkal teljes mértékben szabályozhatja az indexelési folyamatot.
- Az indexelők időnként lemaradhatnak az ütemtervről. Bár ez a feltétel nem gyakori, és léteznek automatikus helyreállítási mechanizmusok, a helyreállítás időt vehet igénybe. Ez egy elvárt viselkedés.
Korlátozott erőforrásokhoz való kapcsolatok hibaelhárítása
Az Azure hálózati biztonsága alatt álló adatforrások esetében az indexelők korlátozottak a kapcsolat létrehozásának módjában. Az indexelők jelenleg egy IP-tűzfal mögött vagy egy virtuális hálózaton keresztül férhetnek hozzá korlátozott adatforrásokhoz egy privát végponton keresztül egy megosztott privát hivatkozás használatával.
Hiba történt egy Microsoft Foundry-erőforráshoz való csatlakozáskor egy privát kapcsolaton
Ha a következő üzenettel 403-ás hibakódot kap, előfordulhat, hogy probléma merül fel az erőforrásvégpont egy készségkészletben való megadásának módjával kapcsolatban:
"A Virtual Network is configured for this resource. Please use the correct endpoint for making requests. Check https://aka.ms/cogsvc-vnet for more details."
Ez a hiba akkor fordul elő, ha megosztott privát hivatkozást konfigurált egy Azure Foundry-erőforráshoz való kapcsolatokhoz, és a végpont hiányzik egy egyéni altartományból. Az egyéni altartomány a végpont első része (például http://my-custom-subdomain.services.ai.azure.com). Előfordulhat, hogy hiányzik egy egyéni tartomány, ha az erőforrást az Azure Portal helyett az Foundry portálon hozta létre.
Ha az Foundry-erőforrás nem ugyanabban a régióban található, mint az Azure AI Keresés, használjon kulcs nélküli kapcsolatot az erőforrás csatolásához.
Hiba megosztott privát hivatkozás használatával
Ha a következő üzenettel 403-ás hibakódot kap, előfordulhat, hogy az indexelő egy jóváhagyott megosztott privát hivatkozás helyett a nyilvános végponton keresztül csatlakozik:
Unexpected error validating provided resource. {"error":{"code":"403","message":"Public access is disabled. Please configure private endpoint."}}
Ez a hiba akkor fordulhat elő, ha az indexelő nincs konfigurálva a privát végrehajtási környezet használatára. Győződjön meg arról, hogy a megosztott privát kapcsolat jóvá van hagyva, állítsa az indexelő értékére executionEnvironmentprivate, és ellenőrizze, hogy a kapcsolat a megfelelő erőforrásvégpontot és csoportazonosítót használja-e.
Tűzfalszabályok
Az Azure Storage, az Azure Cosmos DB és az Azure SQL konfigurálható tűzfalat biztosít. Nincs konkrét hibaüzenet, ha a tűzfal blokkolja a kérést. A tűzfalhibák általában általánosak. Néhány gyakori hiba:
The remote server returned an error: (403) ForbiddenThis request is not authorized to perform this operationCredentials provided in the connection string are invalid or have expired
Ha engedélyezni szeretné, hogy az indexelők hozzáférjenek ezekhez az erőforrásokhoz, használja az alábbi lehetőségek egyikét:
Konfiguráljon egy bejövő szabályt a keresési szolgáltatás IP-címéhez és a szolgáltatáscímke IP-címtartományához.
AzureCognitiveSearchAz EGYES adatforrástípusok IP-címtartomány-korlátozásainak konfigurálásával kapcsolatos részletekért tekintse meg az alábbi hivatkozásokat:Végső megoldásként vagy ideiglenes intézkedésként tiltsa le a tűzfalat a minden hálózatról való hozzáférés engedélyezésével.
Korlátozás: Az IP-címtartomány korlátozásai csak akkor működnek, ha a keresési szolgáltatás és a tárfiók különböző régiókban található.
Az adatlekérés mellett az indexelők készségkészleteken és egyéni képességeken keresztül is küldenek kimenő kéréseket. Az Azure-függvényeken alapuló egyéni képességek esetében vegye figyelembe, hogy az Azure-függvények IP-címkorlátozásokkal is rendelkeznek. Az egyéni képességek végrehajtásához engedélyezni kívánt IP-címek listája tartalmazza a keresési szolgáltatás IP-címét és a szolgáltatáscímke IP-címtartományát AzureCognitiveSearch .
Hálózati biztonsági csoport- (NSG-) szabályok
Ha egy indexelő hozzáfér egy felügyelt SQL-példány adataihoz, vagy ha egy Azure-beli virtuális gépet használnak webszolgáltatás-URI-ként egy egyéni képességhez, a hálózati biztonsági csoport határozza meg, hogy a kérelmek engedélyezve vannak-e.
A virtuális hálózaton található külső erőforrások esetén konfigurálja a bejövő NSG szabályokat a AzureCognitiveSearch szolgáltatás címkéhez.
További információ a virtuális géphez való csatlakozásról: Sql Server-kapcsolat konfigurálása Azure-beli virtuális gépen.
Hálózati hibák
A hálózati hibák általában általánosak. Néhány gyakori hiba:
A network-related or instance-specific error occurred while establishing a connection to the serverThe server was not found or was not accessibleVerify that the instance name is correct and that the source is configured to allow remote connections
Ha a következő hibák bármelyikét kapja:
- Győződjön meg arról, hogy a forrást úgy érheti el, hogy közvetlenül próbál hozzá csatlakozni, nem pedig a keresési szolgáltatáson keresztül.
- Ellenőrizze az erőforrást a Azure portálon az aktuális hibákért vagy kimaradásokért.
- Ellenőrizze, hogy vannak-e hálózati kimaradások Azure állapotában.
- Ellenőrizze, hogy nyilvános DNS-t használ-e névfeloldáshoz, és nem Azure saját DNS.
Azure SQL Database kiszolgáló nélküli indexelés (hibakód: 40613)
Ha az SQL-adatbázis kiszolgáló nélküli számítási szinten van, győződjön meg arról, hogy az adatbázis fut (és nem szünetel), amikor az indexelő csatlakozik hozzá.
Ha az adatbázis szüneteltetve van, a keresési szolgáltatásból való első bejelentkezés automatikusan folytatja az adatbázist, de ehelyett hibaüzenetet ad vissza, amely szerint az adatbázis nem érhető el, és a 40613-ás hibakódot adja vissza. Az adatbázis futtatása után próbálkozzon újra a bejelentkezéslel a kapcsolat létrehozásához.
Microsoft Entra feltételes hozzáférési irányelvek
Amikor létrehoz egy SharePoint indexelőt, be kell jelentkeznie a Microsoft Entra alkalmazásba egy eszközkód megadása után. Ha egy üzenet jelenik "Your sign-in was successful but your admin requires the device requesting access to be managed"meg, a feltételes hozzáférési szabályzat valószínűleg blokkolja az indexelőt a SharePoint dokumentumtárból.
A szabályzat frissítése és az indexelő hozzáférésének engedélyezése a dokumentumtárhoz:
Nyissa meg az Azure Portalt, és keresse meg a Microsoft Entra feltételes hozzáférését.
Válassza a bal oldali menü Házirendek elemét. Ha nem rendelkezik hozzáféréssel ezen oldal megtekintéséhez, vagy meg kell keresnie valakit, aki rendelkezik hozzáféréssel, vagy meg kell szereznie a hozzáférést.
Határozza meg, hogy melyik szabályzat blokkolja a SharePoint-indexelőt a dokumentumtár elérésében. Az indexelőt letiltó szabályzat tartalmazza azt a felhasználói fiókot, amelyet az indexelő létrehozási lépése során használt a Felhasználók és csoportok szakaszban. A szabályzat olyan feltételekkel is rendelkezhet, amelyek:
- Windows-platformok korlátozása.
- Mobilalkalmazások és asztali kliensek korlátozása.
- Eszközállapot beállítása Igen értékre.
Miután megerősítette, hogy melyik szabályzat blokkolja az indexelőt, tegyen kivételt az indexelő számára. Kezdje a keresési szolgáltatás IP-címének beolvasásával.
Először szerezze be a keresési szolgáltatás teljes tartománynevét (FQDN). Az FQDN így néz ki:
<your-search-service-name>.search.windows.net. A FQDN-t az Azure portálon találja.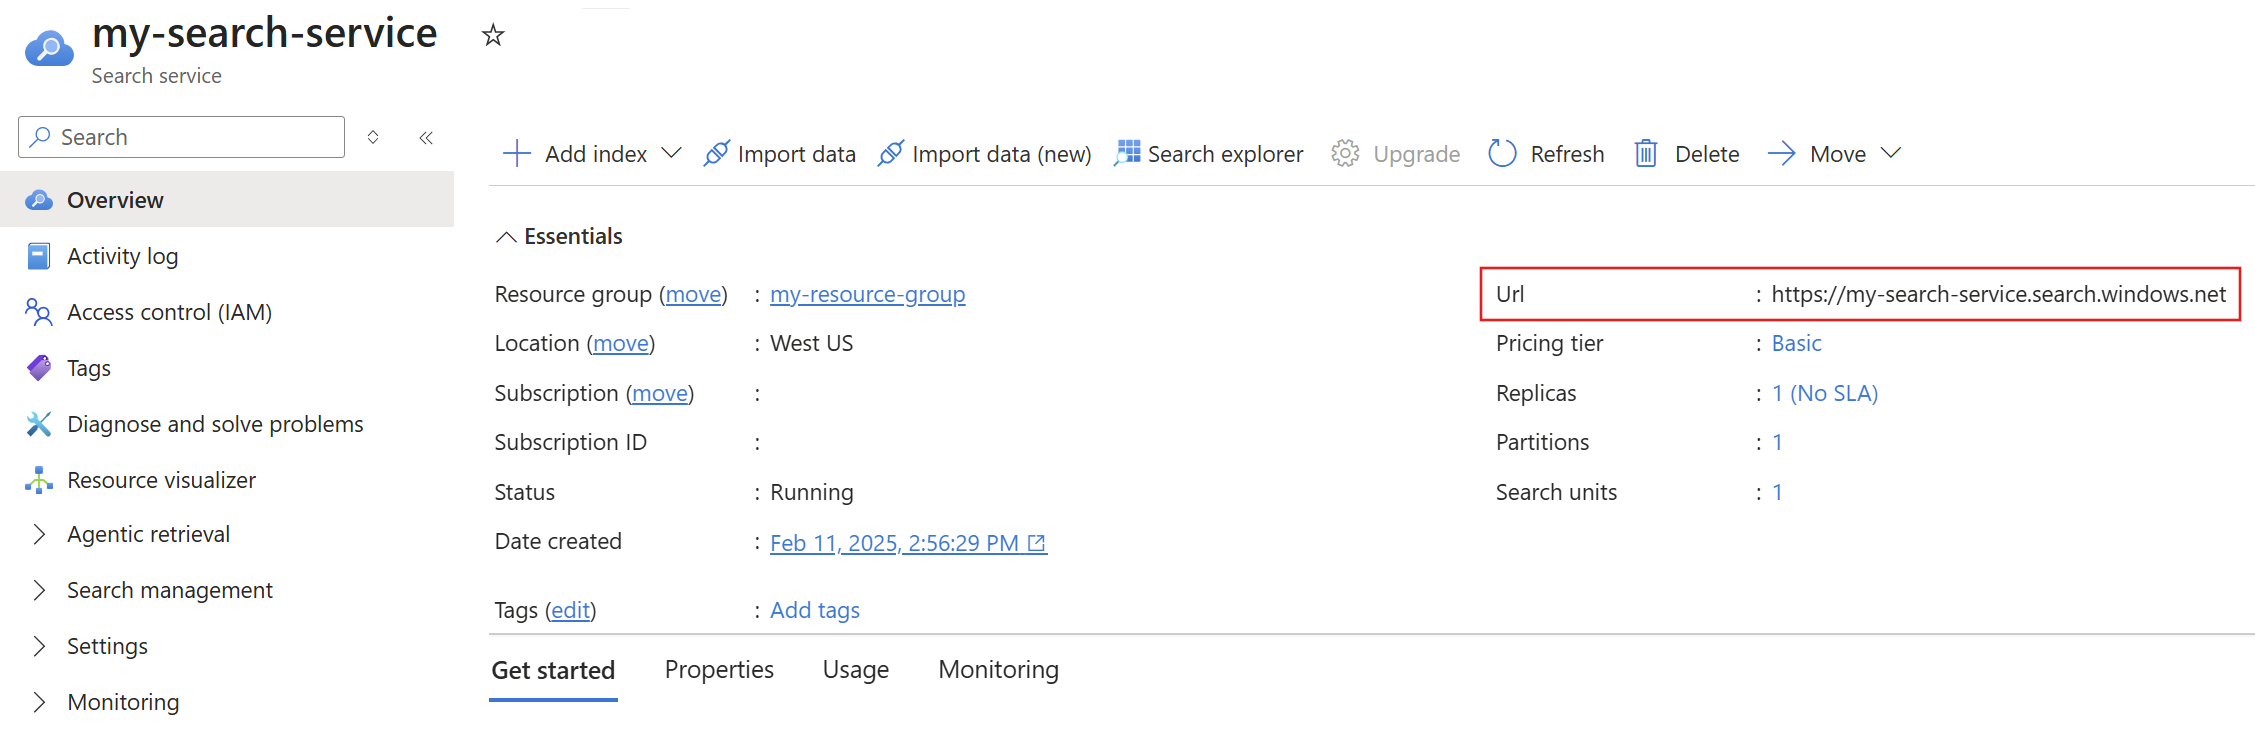
Most, hogy megszerezte a teljes tartománynév (FQDN), szerezze meg a keresési szolgáltatás IP-címét, a teljes tartománynév egy
nslookup(vagy egyping) végrehajtásával. Az alábbi példában hozzáadja a150.0.0.1elemet az Azure Storage tűzfalának egy bejövő szabályához. A keresési szolgáltatás indexelőjének a tűzfalbeállítások frissítése után akár 15 percig is eltarthat a Azure Storage-fiók elérése.nslookup contoso.search.windows.net Server: server.example.org Address: 10.50.10.50 Non-authoritative answer: Name: <name> Address: 150.0.0.1 Aliases: contoso.search.windows.netKérje le a régió indexelő végrehajtási környezetének IP-címtartományait.
A rendszer további IP-címeket használ az indexelő több-bérlős végrehajtási környezetéből származó kérelmekhez. Ezt az IP-címtartományt a szolgáltatáscímkéből szerezheti be.
A szolgáltatáscímke IP-címtartományait a
AzureCognitiveSearchfelderítési API-val vagy a letölthető JSON-fájllal szerezheti be.Ebben a gyakorlatban, feltéve, hogy a keresési szolgáltatás a Azure nyilvános felhő, töltse le a Azure nyilvános JSON-fájlt.
A JSON-fájlban, feltéve, hogy a keresési szolgáltatás az USA nyugati középső régiójában található, a több-bérlős indexelő végrehajtási környezet IP-címeinek listája megjelenik.
    {
      "name": "AzureCognitiveSearch.WestCentralUS",
      "id": "AzureCognitiveSearch.WestCentralUS",
      "properties": {
        "changeNumber": 1,
        "region": "westcentralus",
        "platform": "Azure",
        "systemService": "AzureCognitiveSearch",
        "addressPrefixes": [
          "52.150.139.0/26",
          "52.253.133.74/32"
        ]
      }
    }
Az Azure Portal Feltételes hozzáférés lapjára visszatérve válassza a bal oldali menüBen a Nevesített helyek lehetőséget, majd válassza a + IP-tartományok helyét. Adjon nevet az új névvel ellátott helynek, és adja hozzá a keresési szolgáltatás és az indexelő végrehajtási környezeteinek IP-tartományait, amelyeket az utolsó két lépésben gyűjtött össze. 1
- Előfordulhat, hogy a keresési szolgáltatás IP-címéhez hozzá kell adnia a "/32" értéket az IP-cím végéhez, mivel csak érvényes IP-címtartományokat fogad el.
- Ne feledje, hogy az indexelő végrehajtási környezetÉNEK IP-tartományaihoz csak ahhoz a régióhoz kell hozzáadnia az IP-tartományokat, amelyben a keresési szolgáltatás található.
Zárja ki az új elnevezett helyet a szabályzatból:
- Válassza a bal oldali menü Házirendek elemét.
- Válassza ki az indexelőt blokkoló szabályzatot.
- Válassza a Feltételek lehetőséget.
- Válassza a Helyek lehetőséget.
- Válassza a Kizárás lehetőséget, majd adja hozzá az új névvel ellátott helyet.
- Mentse a módosításokat.
Várjon néhány percet, amíg a szabályzat frissíti és kikényszeríti az új szabályzatszabályokat.
Próbálja meg újból létrehozni az indexelőt:
- Küldjön egy frissítési kérést a létrehozott adatforrás-objektumhoz.
- Az indexelő létrehozási kérésének újraküldése. Az új kód használatával jelentkezzen be, majd küldjön egy másik indexelő létrehozási kérelmet.
Nem támogatott dokumentumtípusok indexelése
Ha Azure Blob Storage-ból indexel tartalmat, és a tároló nem támogatott tartalomtípusú blobokat tartalmaz, az indexelő kihagyja a dokumentumot. Más esetekben problémák merülhetnek fel az egyes dokumentumokkal kapcsolatban.
Ebben az esetben megadhatja a konfigurációs beállításokat , amelyek lehetővé teszik az indexelők feldolgozásának folytatását, ha problémák merülnek fel az egyes dokumentumokkal kapcsolatban.
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-04-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "failOnUnsupportedContentType" : false, "failOnUnprocessableDocument" : false } }
}
Hiányzó dokumentumok
Az indexelők kinyerik a dokumentumokat vagy sorokat egy külső adatforrásból , és létrehoznak keresési dokumentumokat, amelyeket a keresési szolgáltatás indexel. Előfordulhat, hogy az adatforrásban található dokumentumok nem jelennek meg a keresési indexekben. Ez a váratlan eredmény a következő okok miatt fordulhat elő:
- Az indexelő futtatása után frissítette a dokumentumot. Ha az indexelő ütemezés szerint működik, az végül újrafut, és felveszi a dokumentumot.
- Az indexelő időtúllépést észlelt a dokumentum betöltése előtt. Vannak maximális feldolgozási határidők , amelyek után nem dolgoznak fel dokumentumokat. Az indexelő állapotát az Azure Portalon vagy az Indexelő állapotának lekérése (REST API) meghívásával ellenőrizheti.
- A mezőleképezések vagy az AI-bővítés módosította a dokumentumot, és a keresési indexben való artikulációja eltér a várttól.
- A változáskövetési értékek hibásak, vagy hiányoznak az előfeltételek. Ha a magas vízjel értéke egy jövőbeli időpontra beállított dátum, az indexelő kihagyja a korábbi dátummal rendelkező dokumentumokat. Az indexelő változáskövetési állapotát az
initialTrackingStateésfinalTrackingStatemezőinek használatával határozhatja meg. Az Azure SQL és a MySQL indexelőknek indexszel kell ellátniuk a forrástábla legmagasabb szint oszlopát, különben az indexelő által használt lekérdezések időtúllépést eredményezhetnek.
Tipp
Ha a dokumentumok hiányoznak, ellenőrizze a használt lekérdezést , hogy ne zárja-e ki a kérdéses dokumentumot. Egy adott dokumentum lekérdezéséhez használja a Lookup Document REST API-t.
Hiányzó tartalom a Blob Storage-ból
A blobindexelő megkeresi és kinyeri a tárolóban lévő blobok szövegét. A szöveg kinyerésével kapcsolatos problémák közé tartoznak a következők:
A dokumentum csak beolvasott képeket tartalmaz. A nem szöveges tartalmú PDF-blobok, például a beolvasott képek (JPG-k) nem hoznak létre eredményeket egy szabványos blobindexelési folyamat során. Ha szöveges elemeket tartalmazó képtartalommal rendelkezik, az OCR vagy a képelemzés használatával megkeresheti és kinyerheti a szöveget.
A blobindexelő csak indexelési metaadatokra van konfigurálva. A tartalom kinyeréséhez konfigurálnia kell a blobindexelőt a tartalom és a metaadatok kinyeréséhez:
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-04-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "dataToExtract" : "contentAndMetadata" } }
}
Hiányzó tartalom az Azure Cosmos DB-ből
Az Azure AI Keresés implicit függőséget ad az Azure Cosmos DB-indexeléshez. Ha kikapcsolja az automatikus indexelést az Azure Cosmos DB-ben, az Azure AI Keresés sikeres állapotot ad vissza, de nem indexeli a tároló tartalmát. A beállítások ellenőrzésére és az indexelés bekapcsolására vonatkozó utasításokért lásd : Indexelés kezelése az Azure Cosmos DB-ben.
Dokumentumszám eltérése az adatforrás és az index között
Az indexelők eltérő dokumentumszámot mutathatnak, mint az adatforrás, maga az index vagy a kódban szereplő szám. Az alábbiakban néhány lehetséges oka lehet ennek a viselkedésnek:
- Az index késésben lehet a valós dokumentumok számának megjelenítésében, különösen az Azure Portalon.
- Az indexelő törölt dokumentumszabályzattal rendelkezik. A törölt dokumentumokat az indexelő megszámolja, ha a dokumentumok indexelve vannak a törlés előtt.
- Ha az adatforrás azonosító oszlopa nem egyedi. Ez a feltétel olyan adatforrásokra vonatkozik, amelyek az oszlopok fogalmával rendelkeznek, például Azure Cosmos DB.
- Ha az adatforrás definíciója eltér a rekordok számának becsléséhez használt lekérdezésétől. Az adatbázisban például az adatbázisrekordok számát kérdezi le, míg az adatforrásdefiníciós lekérdezésben csak a rekordok egy részhalmazát kell indexelnie.
- A rendszer a folyamat minden összetevőjére vonatkozóan különböző időközönként ellenőrzi a darabszámokat: adatforrás, indexelő és index.
- Az adatforrás egy sok dokumentumra leképezett fájllal rendelkezik. Ez a feltétel akkor fordulhat elő, amikor indexeljük a blobokat, és a "parsingMode" értéke
jsonArrayésjsonLines.
Többször feldolgozott dokumentumok
Az indexelők konzervatív pufferelési stratégiát használnak annak biztosítására, hogy az adatforrás minden új és módosított dokumentuma bekerüljön az indexelés során. Bizonyos helyzetekben ezek a pufferek átfedésben lehetnek, ami miatt az indexelő két vagy több alkalommal indexel egy dokumentumot. Ennek eredményeképpen a feldolgozott dokumentumok száma meghaladja az adatforrásban lévő dokumentumok tényleges számát. Ez a viselkedés nem befolyásolja az indexben tárolt adatokat, például a dokumentumok duplikálását, csak azt, hogy a végleges konzisztencia elérése hosszabb időt vehet igénybe. Ez a feltétel különösen elterjedt, ha az alábbi feltételek bármelyike igaz:
- Az igény szerinti indexelő kérések gyors egymásutánban jelennek meg.
- Az adatforrás topológiája több replikát és partíciót tartalmaz, például a Azure Cosmos DB konzisztenciaszintjeiben leírt topológiát.
- Az adatforrás egy Azure SQL-adatbázis, és a „felső vízjelként” kiválasztott oszlop
datetime2típusú.
Az indexelőket nem úgy tervezték, hogy rövid időn belül többször is meghívják. Ha gyorsan szüksége van frissítésekre, a támogatott módszer az, hogy az adatforrás egyidejű frissítése mellett leküldi a frissítéseket az indexbe. Igény szerinti feldolgozáshoz a kéréseket ötperces időközönként vagy több időintervallumban kell végrehajtania, és az indexelőt ütemezés szerint kell futtatnia.
Példa duplikált dokumentumfeldolgozásra 30 másodperces pufferrel
Az alábbi ütemterv ismerteti a dokumentumok kétszeri feldolgozásának feltételeit. Rögzíti minden műveletet és ellenlépést. Az alábbi ütemterv a problémát mutatja be:
| Idővonal (óó:mm:ss) | Esemény | Indexelő csúcspontérték | Megjegyzés |
|---|---|---|---|
| 00:01:00 | Írás doc1 adatforrásba végleges konzisztenciával |
null |
A dokumentum időbélyege 00:01:00. |
| 00:01:05 | Írás doc2 adatforrásba végleges konzisztenciával |
null |
A dokumentum időbélyege 00:01:05. |
| 00:01:10 | Az indexelő elindul | null |
|
| 00:01:11 | Az indexelő a 00:01:10 előtti összes módosítást lekérdezi; a replika, amelyről az indexelő lekérdez, csak doc2-ról tud; csak doc2 kerül lekérdezésre. |
null |
Az indexelő minden módosítást kér az időbélyeg indítása előtt, de valójában egy részhalmazt kap. Ez a viselkedés megköveteli a visszatekintési pufferidőszakot. |
| 00:01:12 | Az indexelő feldolgozza doc2 első alkalommal |
null |
|
| 00:01:13 | Indexelő vége | 00:01:10 | A magas vízjel frissül az indexelő aktuális végrehajtásának kezdő időbélyegére. |
| 00:01:20 | Az indexelő elindul | 00:01:10 | |
| 00:01:21 | Az indexelő lekérdezi a 00:00:40 és 00:01:20 közötti összes módosítást; a replika, amelyet az indexelő lekérdez, mind doc1-ról és doc2-ről tudomással bír; lekéri doc1 és doc2 |
00:01:10 | Az indexelő az aktuális magas vízjel és a 30 másodperces puffer közötti összes módosításra vonatkozó kérést, valamint az indexelő aktuális végrehajtásának kezdő időbélyegét kéri. |
| 00:01:22 | Az indexelő feldolgozza doc1 első alkalommal |
00:01:10 | |
| 00:01:23 | Indexelő feldolgozza doc2 másodszor |
00:01:10 | |
| 00:01:24 | Indexelő vége | 00:01:20 | A magas vízjel frissül az indexelő aktuális végrehajtásának kezdő időbélyegére. |
| 00:01:32 | Az indexelő elindul | 00:01:20 | |
| 00:01:33 | Az indexelő a 00:00:50 és 00:01:32 közötti összes módosítást lekérdezi; lekéri doc1 és doc2 |
00:01:20 | Az indexelő az aktuális magas vízjel és a 30 másodperces puffer közötti összes módosításra vonatkozó kérést, valamint az indexelő aktuális végrehajtásának kezdő időbélyegét kéri. |
| 00:01:34 | Indexelő feldolgozza doc1 másodszor |
00:01:20 | |
| 00:01:35 | Az indexelő harmadszor dolgozza fel a doc2-t. |
00:01:20 | |
| 00:01:36 | Indexelő vége | 00:01:32 | A magas vízjel frissül az indexelő aktuális végrehajtásának kezdő időbélyegére. |
| 00:01:40 | Az indexelő elindul | 00:01:32 | |
| 00:01:41 | Az indexelő lekérdezi a 00:01:02 és 00:01:40 közötti összes módosítást; lekéri doc2 |
00:01:32 | Az indexelő az aktuális magas vízjel és a 30 másodperces puffer közötti összes módosításra vonatkozó kérést, valamint az indexelő aktuális végrehajtásának kezdő időbélyegét kéri. |
| 00:01:42 | Indexer doc2 negyedik alkalommal dolgozza fel |
00:01:32 | |
| 00:01:43 | Indexelő vége | 00:01:40 | Figyelje meg, hogy ez az indexelő végrehajtása több mint 30 másodperccel az adatforrásba történt utolsó írás után kezdődött, és doc2-t is feldolgozott. Ez a várt viselkedés, mert ha a 00:01:35 előtti összes indexelő-végrehajtást kiküszöbölik, akkor ez az első és egyetlen végrehajtás, amely doc1-et és doc2-et dolgoz fel. |
A gyakorlatban ez a forgatókönyv csak akkor fordul elő, ha bizonyos adatforrások esetében manuálisan hív meg igény szerinti indexelőket néhány percen belül. Ez eltérő számokat eredményezhet (például az indexelő összesen 345 dokumentumot feldolgozott az indexelő végrehajtási statisztikái szerint, de 340 dokumentum található az adatforrásban és az indexben), vagy növelheti a számlázást, ha ugyanazt a képességet többször futtatja ugyanazon dokumentumhoz. Az indexelő ütemezéssel történő futtatása az előnyben részesített javaslat.
Párhuzamos indexelés
Ha egyszerre több indexelő fut, egyes indexelők általában várólistára kerülnek, és a rendelkezésre álló erőforrásokra várnak, mielőtt elindulnának. Több tényező határozza meg, hogy hány indexelő futhat egyszerre. Ha az indexelők nem kapcsolódnak a képességkészletekhez, az AI Search szolgáltatás replikáinak és partícióinak száma határozza meg, hogy hány indexelő futhat párhuzamosan.
Ha egy indexelőt egy képességkészlethez társít, akkor az az AI Search belső klaszterein fut le. A képességkészlet összetettsége és az, hogy a többi képességkészlet egyszerre fut-e, meghatározza, hogy hány indexelő futhat egyszerre. A beépített indexelők megbízhatóan kinyerik az adatokat a forrásból, így nem maradnak le adatokról, ha ütemezés szerint futnak. A párhuzamosításhoz és a horizontális felskálázáshoz szükséges indexelő folyamatoknak azonban időre van szükségük.
Dokumentumok indexelése bizalmassági címkékkel
Ha bizalmassági címkéket állít be a dokumentumokon, előfordulhat, hogy nem tudja indexelni őket. Ha hibaüzenetet kap, az indexelés előtt távolítsa el a címkéket.