Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Megjegyzés:
Azure AI Keresés a Azure portálon, REST API-kon és Azure SDK-k keresztül érhető el. Emellett a Foundry IQ-t is támogatja, amely a vállalati tartalmakat újrafelhasználható, engedélytudatos tudásbázisokká alakítja át az Microsoft Foundry portálon található ügynökök számára.
Azure AI Keresés kétféle díjszabási modellt kínál, amelyek eltérően kezelik a kapacitást:
Dedikált: Kapacitás megtervezése replikák és partíciók méretezésével és egy szolgáltatási szint kiválasztásával.
- A kapacitást közvetlenül a replikák és partíciók használatával előre lefoglalhatja.
- Becsülje meg a szükséges tárterületet (partíciókat) és a szükséges átviteli sebességet (replikákat).
- Válasszon egy szolgáltatási szintet a szükséges kapacitás kiépítéséhez a várt csúcsigény alapján.
- Miután előre konfigurálta a kapacitást, a használattól függetlenül a keresési egységek (termékváltozatok) szerint mért óránkénti díjat kell fizetnie.
Kiszolgáló nélküli (előzetes verzió): A szolgáltatás automatikusan kezeli a kapacitást a használat és a szolgáltatás korlátai alapján. Nem kell előre kiépítenie a kapacitást. Ehelyett optimalizálja a számítási feladatok hatékonyságát a költségek kezeléséhez.
- A kapacitás automatikusan skálázódik igény szerint (tétlen állapotban nullára skálázható).
- A számlázás a számítási egységek (CU-k) és a tárterület által mért tényleges használat alapján történik.
- Az infrastruktúra helyett a tervezés a következő költségillesztőkre összpontosít: lekérdezési minták, indexméret és növekedés, valamint adatbetöltési minták. Lásd : A kiszolgáló nélküli modell költségeinek optimalizálása.
| Dimenzió | dedikált | Serverless |
|---|---|---|
| Kapacitásmodell | Kiépített (replikák × partíciók) | Használatalapú |
| Scaling | Kézikönyv | Automatikus |
| Felhasználói vezérlő | Explicit (replikák és partíciók konfigurálása) | Közvetett (a terhelés jellemzői által befolyásolt) |
| Billing | Rögzített óradíj keresési egységenként (SU) | Számítási egységek (CU-k) és tárolás fogyasztásalapú díjszabása |
| Tétlen költség | Mindig felszámítva (minimálisan lefoglalt kapacitás) | Ha inaktív, nullára csökkenthető |
| Optimalizálási fókusz | Infrastruktúra méretezése | A munkaterhelés hatékonysága |
| Legjobb a számára | Kiszámítható, állandó számítási feladatok | Változó, időszakosan kiugró terhelésű vagy több-bérlős munkaterhelések, beleértve az ügynökvezérelt forgatókönyveket is |
| Kapacitástervezési megközelítés | Infrastruktúra mérete és méretezése (replikák és partíciók) | A munkaterhelés-hatékonyság és a használati minták optimalizálása |
| A hatékonysághiány hatása | Késés és skálázási nyomás | Közvetlen költségnövekedés |
Important
A kiszolgáló nélküli fejlesztői szint jelenleg előzetes verzióban érhető el. Ez az előzetes verzió szolgáltatásszintű szerződés nélkül érhető el, és éles számítási feladatokhoz nem ajánlott. Előfordulhat, hogy bizonyos funkciók nem támogatottak, vagy korlátozott képességekkel rendelkeznek. További információkért lásd: Microsoft Azure Previews Kiegészítő Felhasználási Feltételek.
A kiszolgáló nélküli fejlesztői szint számlázása 2026. szeptember 13-án kezdődött. Az ezen a napon vagy azt követő használat díjai megjelennek a Azure számlán. A használatért 2026. szeptember 13-a előtt nem kell fizetnie.
A kiszolgáló nélküli fejlesztői szint nem támogatja a más tarifacsomagokra való migrálást, és a más szinteken elérhető egyes funkciók nem támogatottak a nyilvános előzetes verzióban. A szolgáltatáskorlátok, a támogatott funkciók és a díjszabás részletei az általános elérhetőség előtt változhatnak.
Az előzetes verzióban a kiszolgáló nélküli díjszabási modell csak bizonyos régiókban támogatott.
További információkért lásd:
- Költségtervezés és a költségek kezelése
- Tarifamodell és szolgáltatási szint kiválasztása
- Költségek optimalizálása a kiszolgáló nélküli díjszabási modellel
A dedikált modell kapacitásának megtervezése
A dedikált modellben a kapacitást a keresési egységek (SU) használatával építheti ki:
- Keresési egység (SU) = replikák × partíciók
- Replika: A keresőmotor másolatai. Lekérdezési átviteli sebességet és magas rendelkezésre állást biztosít.
- Partíció: Tárolási egységek. Tárolási és indexelési átviteli sebességet biztosít.
Minden szolgáltatás 1 replikával × 1 partícióval (1 SU) kezdődik. A replikákat és partíciókat egymástól függetlenül is hozzáadhatja vagy eltávolíthatja, hogy alkalmazkodjon az ingadozó számítási feladatokhoz. A kapacitás hozzáadása növeli a keresési szolgáltatás futtatásának költségeit.
| Fogalom | Definíció |
|---|---|
| Keresési egység | A teljes rendelkezésre álló kapacitás egyetlen növekménye. A szolgáltatás futtatásához legalább egy keresési egység szükséges. A tarifacsomagtól függően a maximális tartomány egytől 36 egységig terjed. A keresési egységek száma megegyezik a replikák számával és a partíciók számával: R × P = SU. Minden szolgáltatás egy replikával és egy partícióval kezdődik, amely egy egységet használ fel: 1 × 1 = 1. A második replika hozzáadása két egységet használ fel: 2 × 1 = 2. A keresési egység egyben a keresési szolgáltatás számlázási egysége is. |
| replika | A keresési szolgáltatás példányai, amelyeket elsősorban a lekérdezési műveletek terheléselosztására használnak. Minden replika egy index egy példányát tárolja. Ha három replikát foglal le, három példányban érhető el egy index a lekérdezési kérelmek kiszolgálásához. |
| partíció | Fizikai tárolás és I/O olvasási/írási műveletekhez (például index újraépítésekor vagy frissítésekor). Minden partícióhoz hozzá van rendelve egy szelet a teljes indexből. Ha három partíciót foglal le, az index harmadokra van osztva. |
Tekintse át a partíciók és replikák tábláját a 36 egységkorlát alatt maradó lehetséges kombinációkért.
A replikák és partíciók fizikai jellemzői, például a feldolgozási sebesség és a lemez I/ O-jának fizikai jellemzői szolgáltatási szint szerint változnak. Egy standard keresési szolgáltatásban a replikák és partíciók gyorsabbak és nagyobbak, mint az alapszintű szolgáltatásoké.
Mikor kell kapacitást hozzáadni a dedikált modellhez?
Fontolja meg replikák vagy partíciók hozzáadását a következő esetekben:
- A lekérdezés késése nő, vagy a szolgáltatásiszint-szerződés feltételei nem teljesülnek.
- A HTTP 503 (Szolgáltatás nem érhető el) hibák gyakorisága nő.
- Az HTTP 429-es („túl sok kérés”) hibák gyakoribbá válnak, ami a kérelmek korlátozására utal.
- Nagy lekérdezési mennyiségek várhatók.
- Az indexelési feladatok lassúak vagy elmaradnak.
- A tárolás vagy az indexelés átviteli sebessége nem elegendő.
Skálázási útmutató:
- Replikák hozzáadása a lekérdezés átviteli sebességének és rendelkezésre állásának növeléséhez.
- Partíciók hozzáadása a tárolási és indexelési teljesítmény növeléséhez.
- A lekérdezési terhelésű számítási feladatok általában több replikát igényelnek.
- A nagy indexekhez további replikákra lehet szükség a teljesítmény fenntartásához.
Important
A skálázási műveletek végrehajtása és a költségek növelése időt vehet igénybe. A változtatásokat mindig teljesítményteszteléssel és költségbecslésekkel ellenőrizze.
A választott szolgáltatási szint határozza meg a partíció méretét és sebességét. Minden szint különböző forgatókönyvekhez illeszkedő jellemzők köré van optimalizálva. Ha magasabb szintű szintet választ, előfordulhat, hogy kevesebb partícióra van szüksége , mint ha az S1-et használja. Az önkiszolgáló teszteléssel megválaszolandó kérdések egyike, hogy egy nagyobb és drágább partíció jobb teljesítményt nyújt-e, mint egy alacsonyabb szinten kiépített szolgáltatás két olcsóbb partíciója.
Egyetlen szolgáltatásnak elegendő erőforrással kell rendelkeznie az összes számítási feladat (indexelés és lekérdezés) kezeléséhez. Egyik számítási feladat sem fut a háttérben. Ütemezheti az indexelést olyan időszakokra, amikor a lekérdezési kérések természetesen ritkábban fordulnak elő, de a szolgáltatás egyébként nem rangsorolja az egyik feladatot a másiknál. Emellett bizonyos mértékű redundancia kisimítja a lekérdezési teljesítményt a szolgáltatások vagy csomópontok belső frissítésekor.
Általános szabály, hogy a keresési alkalmazásoknak általában több replikára van szükségük, mint a partíciókra, különösen akkor, ha a szolgáltatásműveletek elfogultak a lekérdezési számítási feladatok felé. Minden replika az index egy másolata, így a szolgáltatás eloszthatja a kéréseket több másolat között. Azure AI Keresés kezeli az index összes terheléselosztását és replikációját. A szolgáltatáshoz lefoglalt replikák számát bármikor módosíthatja. Egy Standard keresési szolgáltatásban legfeljebb 12 replikát, egy alapszintű keresési szolgáltatásban pedig 3 replikát foglalhat le. A replikafoglalást a Azure portálon vagy a programozott lehetőségek egyikén végezheti el.
A további partíciók hasznosak az intenzív indexelési számítási feladatokhoz. A további partíciók olvasási és írási műveleteket osztanak szét nagyobb számú számítási erőforrás között.
Végül a nagyobb indexek lekérdezése tovább tart. Így előfordulhat, hogy a partíciók növekményes növekedéséhez kisebb, de arányos replikákra van szükség. A lekérdezések összetettsége és mennyisége befolyásolja, hogy milyen gyorsan hajtják végre a lekérdezéseket.
A szolgáltatáskorlátokról és az érvényes skálázási tartományokról lásd:
- Szolgáltatási korlátok a rétegekhez és termékváltozatokhoz
- Tarifamodell és szolgáltatási szint kiválasztása
Megjegyzés:
További replikák vagy partíciók hozzáadása növeli a szolgáltatás futtatásának költségeit, és enyhe eltéréseket okozhat az eredmények sorrendjében. Ellenőrizze a díjkalkulátort , hogy megértse a további csomópontok hozzáadásának számlázási következményeit. A partíció- és replikakombinációk táblázata segíthet kereszthivatkozást adni az adott konfigurációhoz szükséges keresési egységek számának. További információ arról, hogy a további replikák hogyan befolyásolják a lekérdezésfeldolgozást, tekintse meg az eredmények sorrendjét.
Kapacitás kezelése és módosítása
A kapacitás módosítása nem azonnali. Az adatmennyiségtől és a művelet típusától függően a skálázás perctől több óráig is eltarthat.
Keresési szolgáltatás skálázása során az alábbi eszközök és megközelítések közül választhat:
Megjegyzés:
Ha a keresési szolgáltatás 2024 áprilisa vagy májusa előtt jött létre, akkor előfordulhat, hogy jogosult lehet egy egyszeri frissítésre az újabb, nagyobb partícióméreteket tartalmazó infrastruktúrára, külön költség nélkül. Ez a frissítés növelheti a partíciónként elérhető tárterületet, és csökkentheti a számítási feladathoz szükséges partíciók számát. További információ: A keresési szolgáltatás frissítése.
A szolgáltatás kapacitásának növeléséhez vagy csökkentéséhez két lehetősége van:
Partíciók és replikák hozzáadása vagy eltávolítása
Nyissa meg a keresőszolgáltatást a Azure portálon.
A bal oldali panelen válassza .
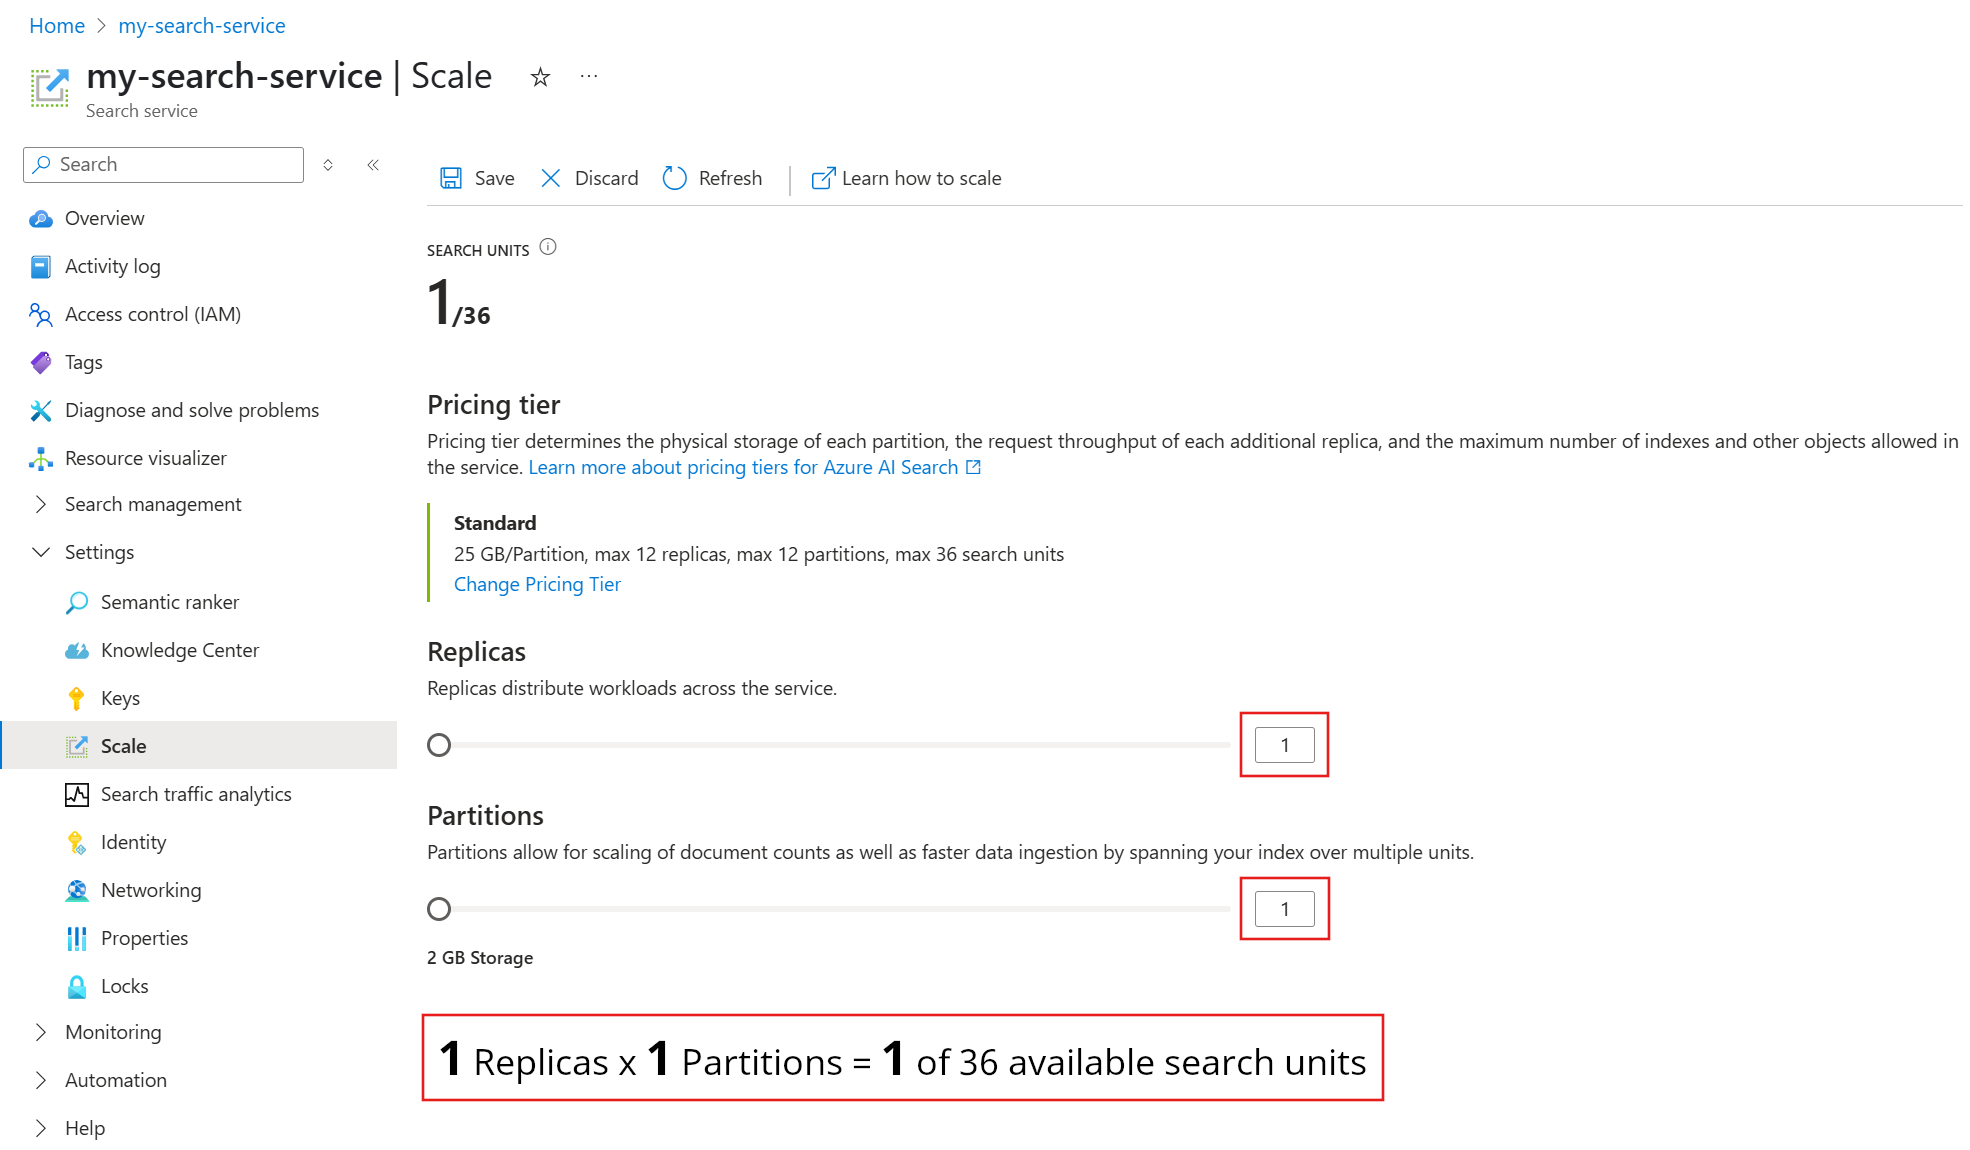
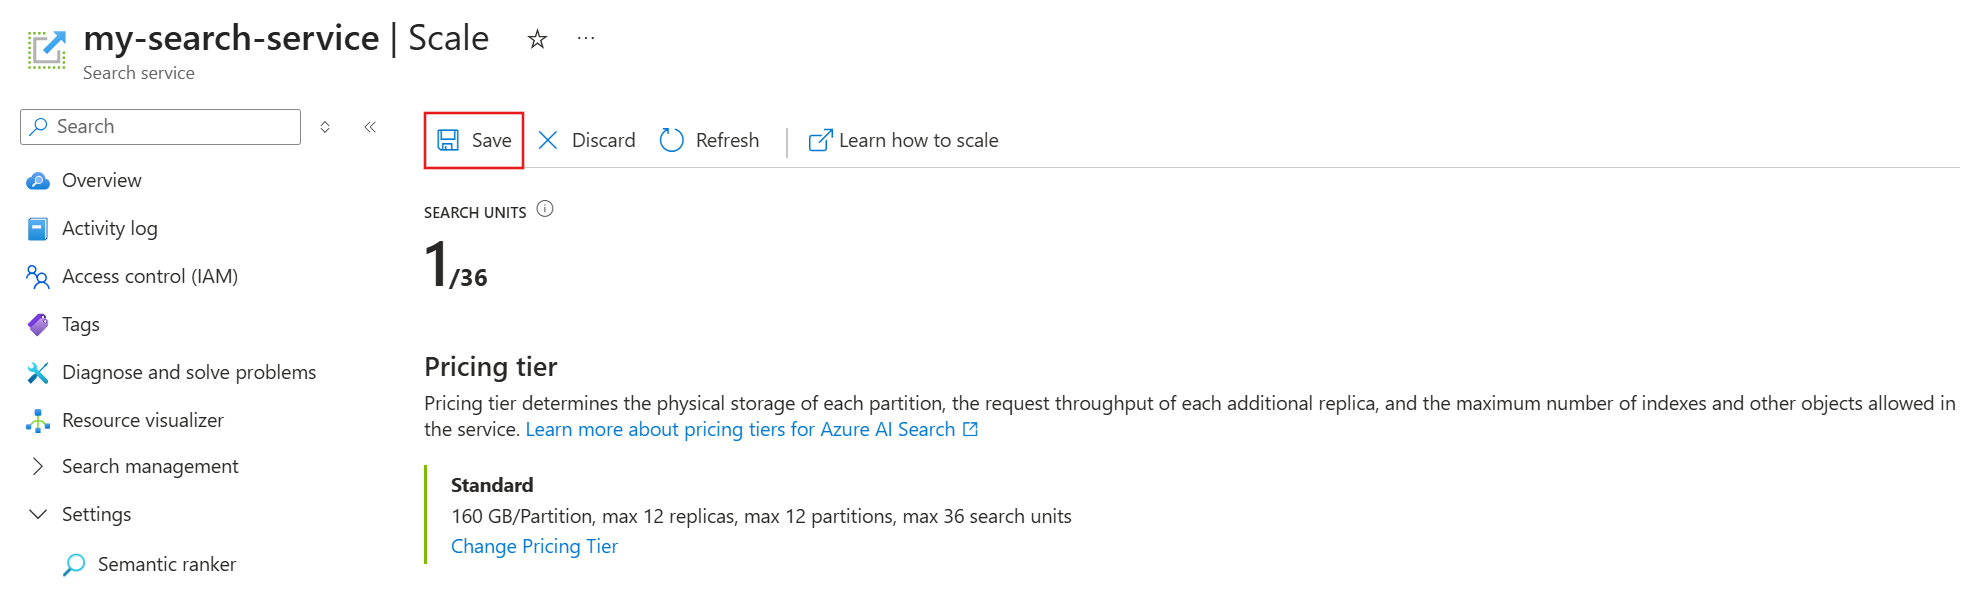
Az alábbi képernyőképen egy standard szolgáltatás látható, amely egyetlen replikával és partícióval van kiépítve. Az alsó képlet azt jelzi, hogy hány keresési egység van használatban (1). Ha az egységár 100 dollár (nem valós ár), a szolgáltatás futtatásának havi költsége átlagosan 100 dollár lenne.
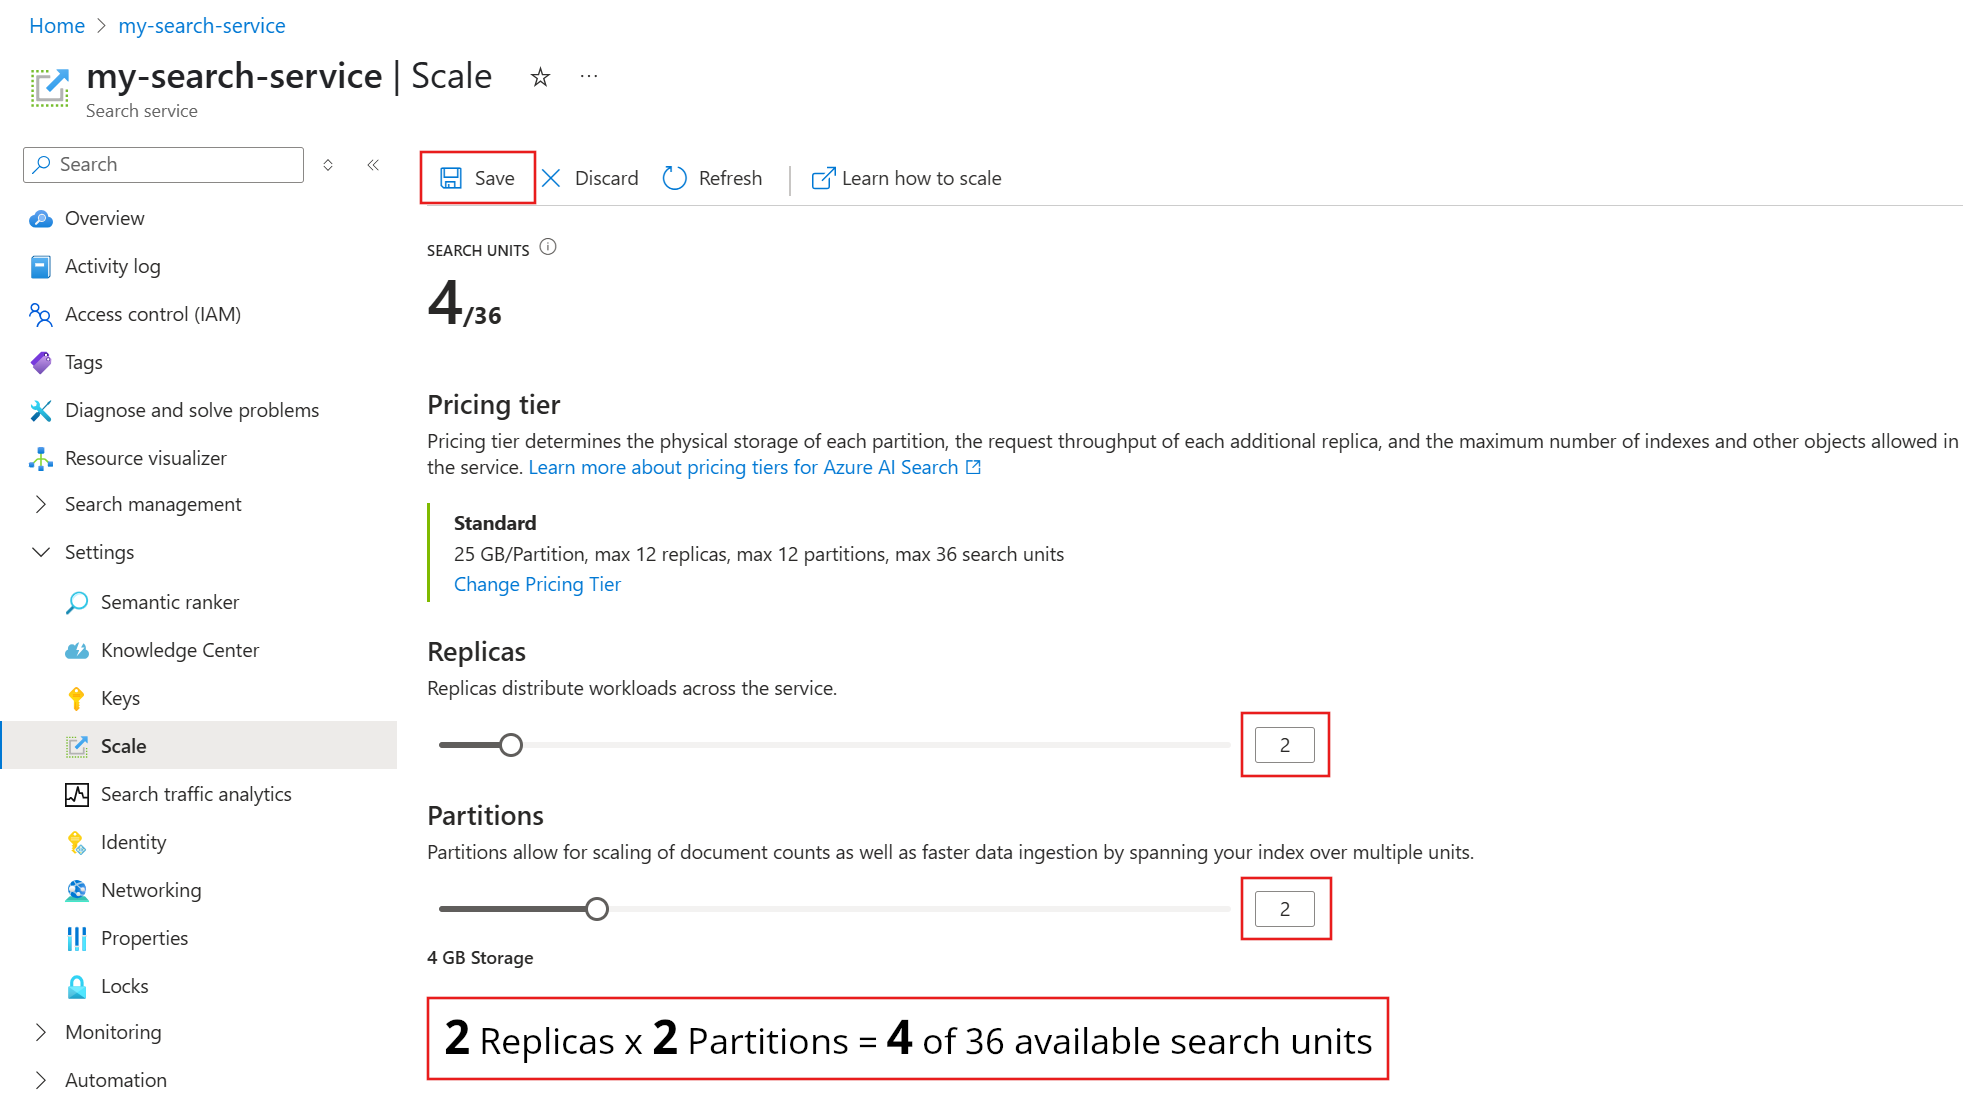
A csúszkával növelje vagy csökkentse a partíciók számát, majd válassza a Mentés lehetőséget.
Ez a példa egy második replikát és partíciót ad hozzá. Figyelje meg a keresési egységek számát; ez most négy, mert a számlázási képlet replikák és partíciók szorzata (2 x 2). A kapacitás megduplázása több mint duplája a szolgáltatás futtatásának költségeinek. Ha a keresési egység költsége 100 usd volt, az új havi számla most 400 dollár lesz.
Az egyes szintek egységenkénti aktuális költségeiért látogasson el a díjszabási oldalra.
Ellenőrizze az értesítéseket, hogy a művelet elindult-e.
Ez a művelet több órát is igénybe vehet. Ez a háttérben történik, így a keresési szolgáltatás teljes mértékben működőképes marad, és elérhető az olvasási és írási műveletekhez.
Nem szakíthatja meg a műveletet, és nem figyelheti annak előrehaladását. Az alábbi üzenet azonban megjelenik, amíg a módosítások folyamatban vannak.
Az Azure portál frissítési üzenetének képernyőképe.
A tarifacsomag módosítása
Megjegyzés:
A Azure portál és a Szolgáltatások – Frissítés (REST API) támogatja az Alapszintű és a Standard (S1, S2 és S3) szintek közötti változásokat. Frissítheti vagy leskálázhatja a szinteket, feltéve, hogy az aktuális szolgáltatáskonfiguráció nem lépi túl a célszint korlátait. A régió nem rendelkezhet kapacitáskorlátozásokkal a célszinten.
A tarifacsomag határozza meg a keresési szolgáltatás maximális tárterületét a dedikált díjszabási modellhez. Ha több vagy kevesebb kapacitásra van szüksége, átválthat egy másik tarifacsomagra, amely megfelel a tárolási igényeknek. (Ez csak a dedikált tarifamodell-szintekre vonatkozik. A kiszolgáló nélküli modell fejlesztői szintje nem módosítható a kijelölés után.
A kapacitás mellett a tarifacsomagok határozzák meg az indexekre, indexelőkre és más keresési objektumokra vonatkozó korlátokat. Mielőtt továbblép, hasonlítsa össze az aktuális szint és a kívánt szint szolgáltatási korlátait . A magasabb szintre való váltás általában növeli a tárterületkorlátot és a vektorkorlátot, növeli a kérelmek átviteli sebességét és csökkenti a késést, míg az alacsonyabb szintre való váltás ellentétes hatással van.
Ha magasabb tarifacsomagra vált, az növeli a keresési szolgáltatás futtatásának költségeit is. További tájékoztatás a díjszabási oldalon olvasható.
A tarifacsomag módosítása:
Nyissa meg a keresőszolgáltatást a Azure portálon.
A bal oldali panelen válassza .
Az aktuális szint alatt válassza a Tarifacsomag módosítása lehetőséget.
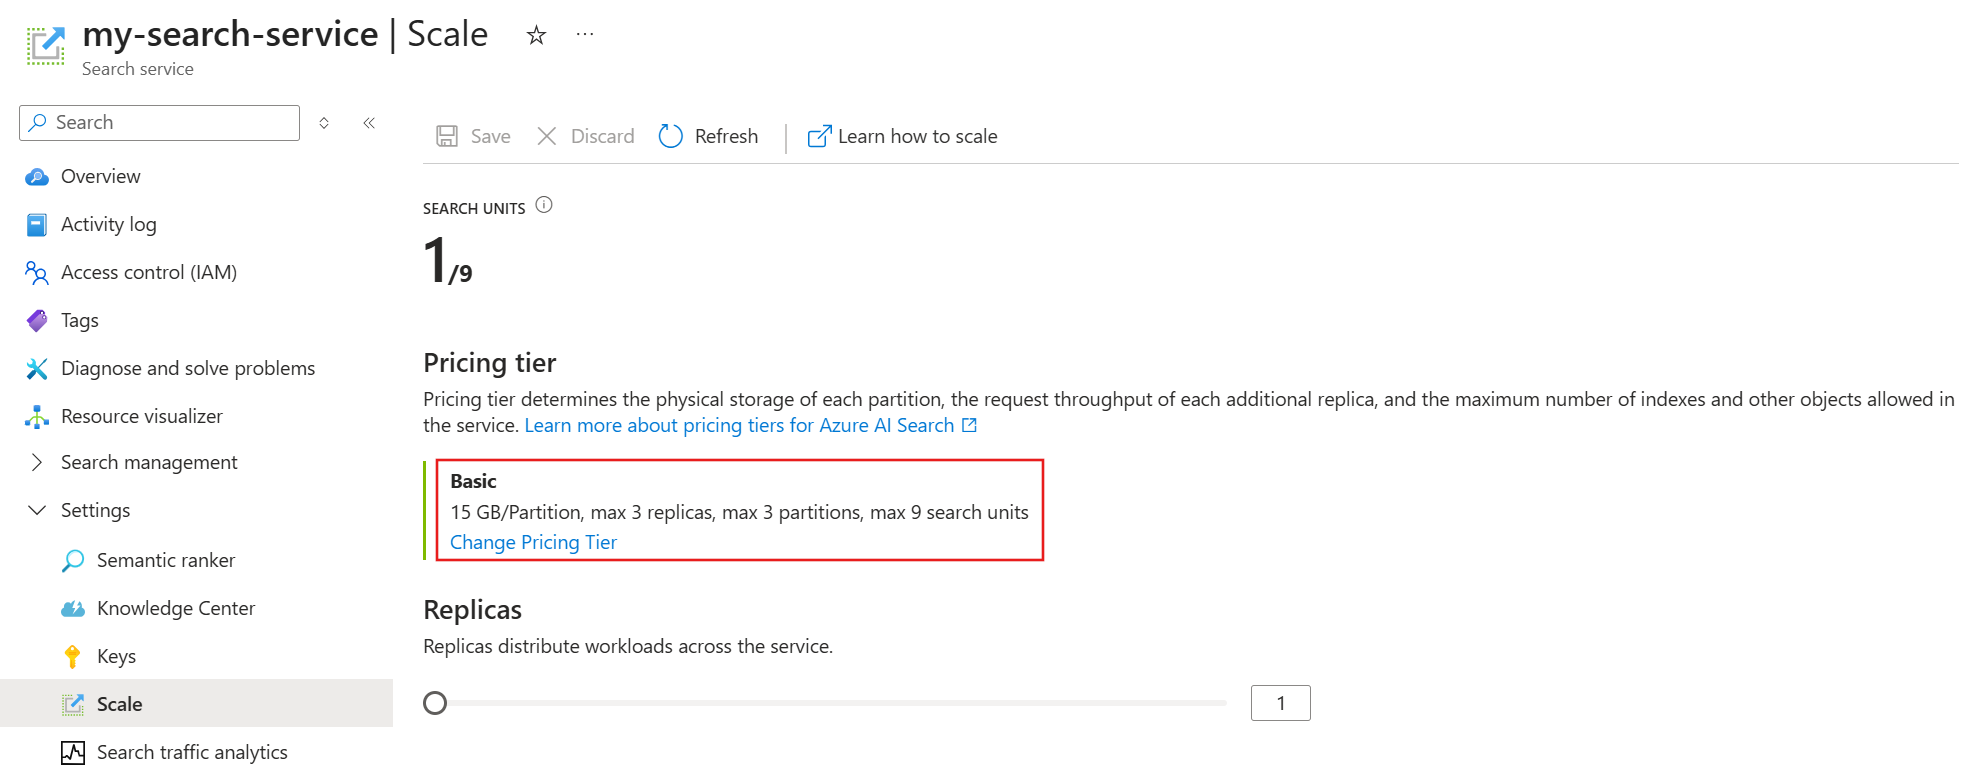
A Tarifacsomag kiválasztása lapon válasszon másik szintet a listából.
Válthat az Alapszintű, az S1, az S2 és az S3 között, de nem válthat az ingyenes, az S3HD, az L1 vagy az L2 verzióra. Ezek a szintek nem választhatók ki, és halványan jelennek meg.
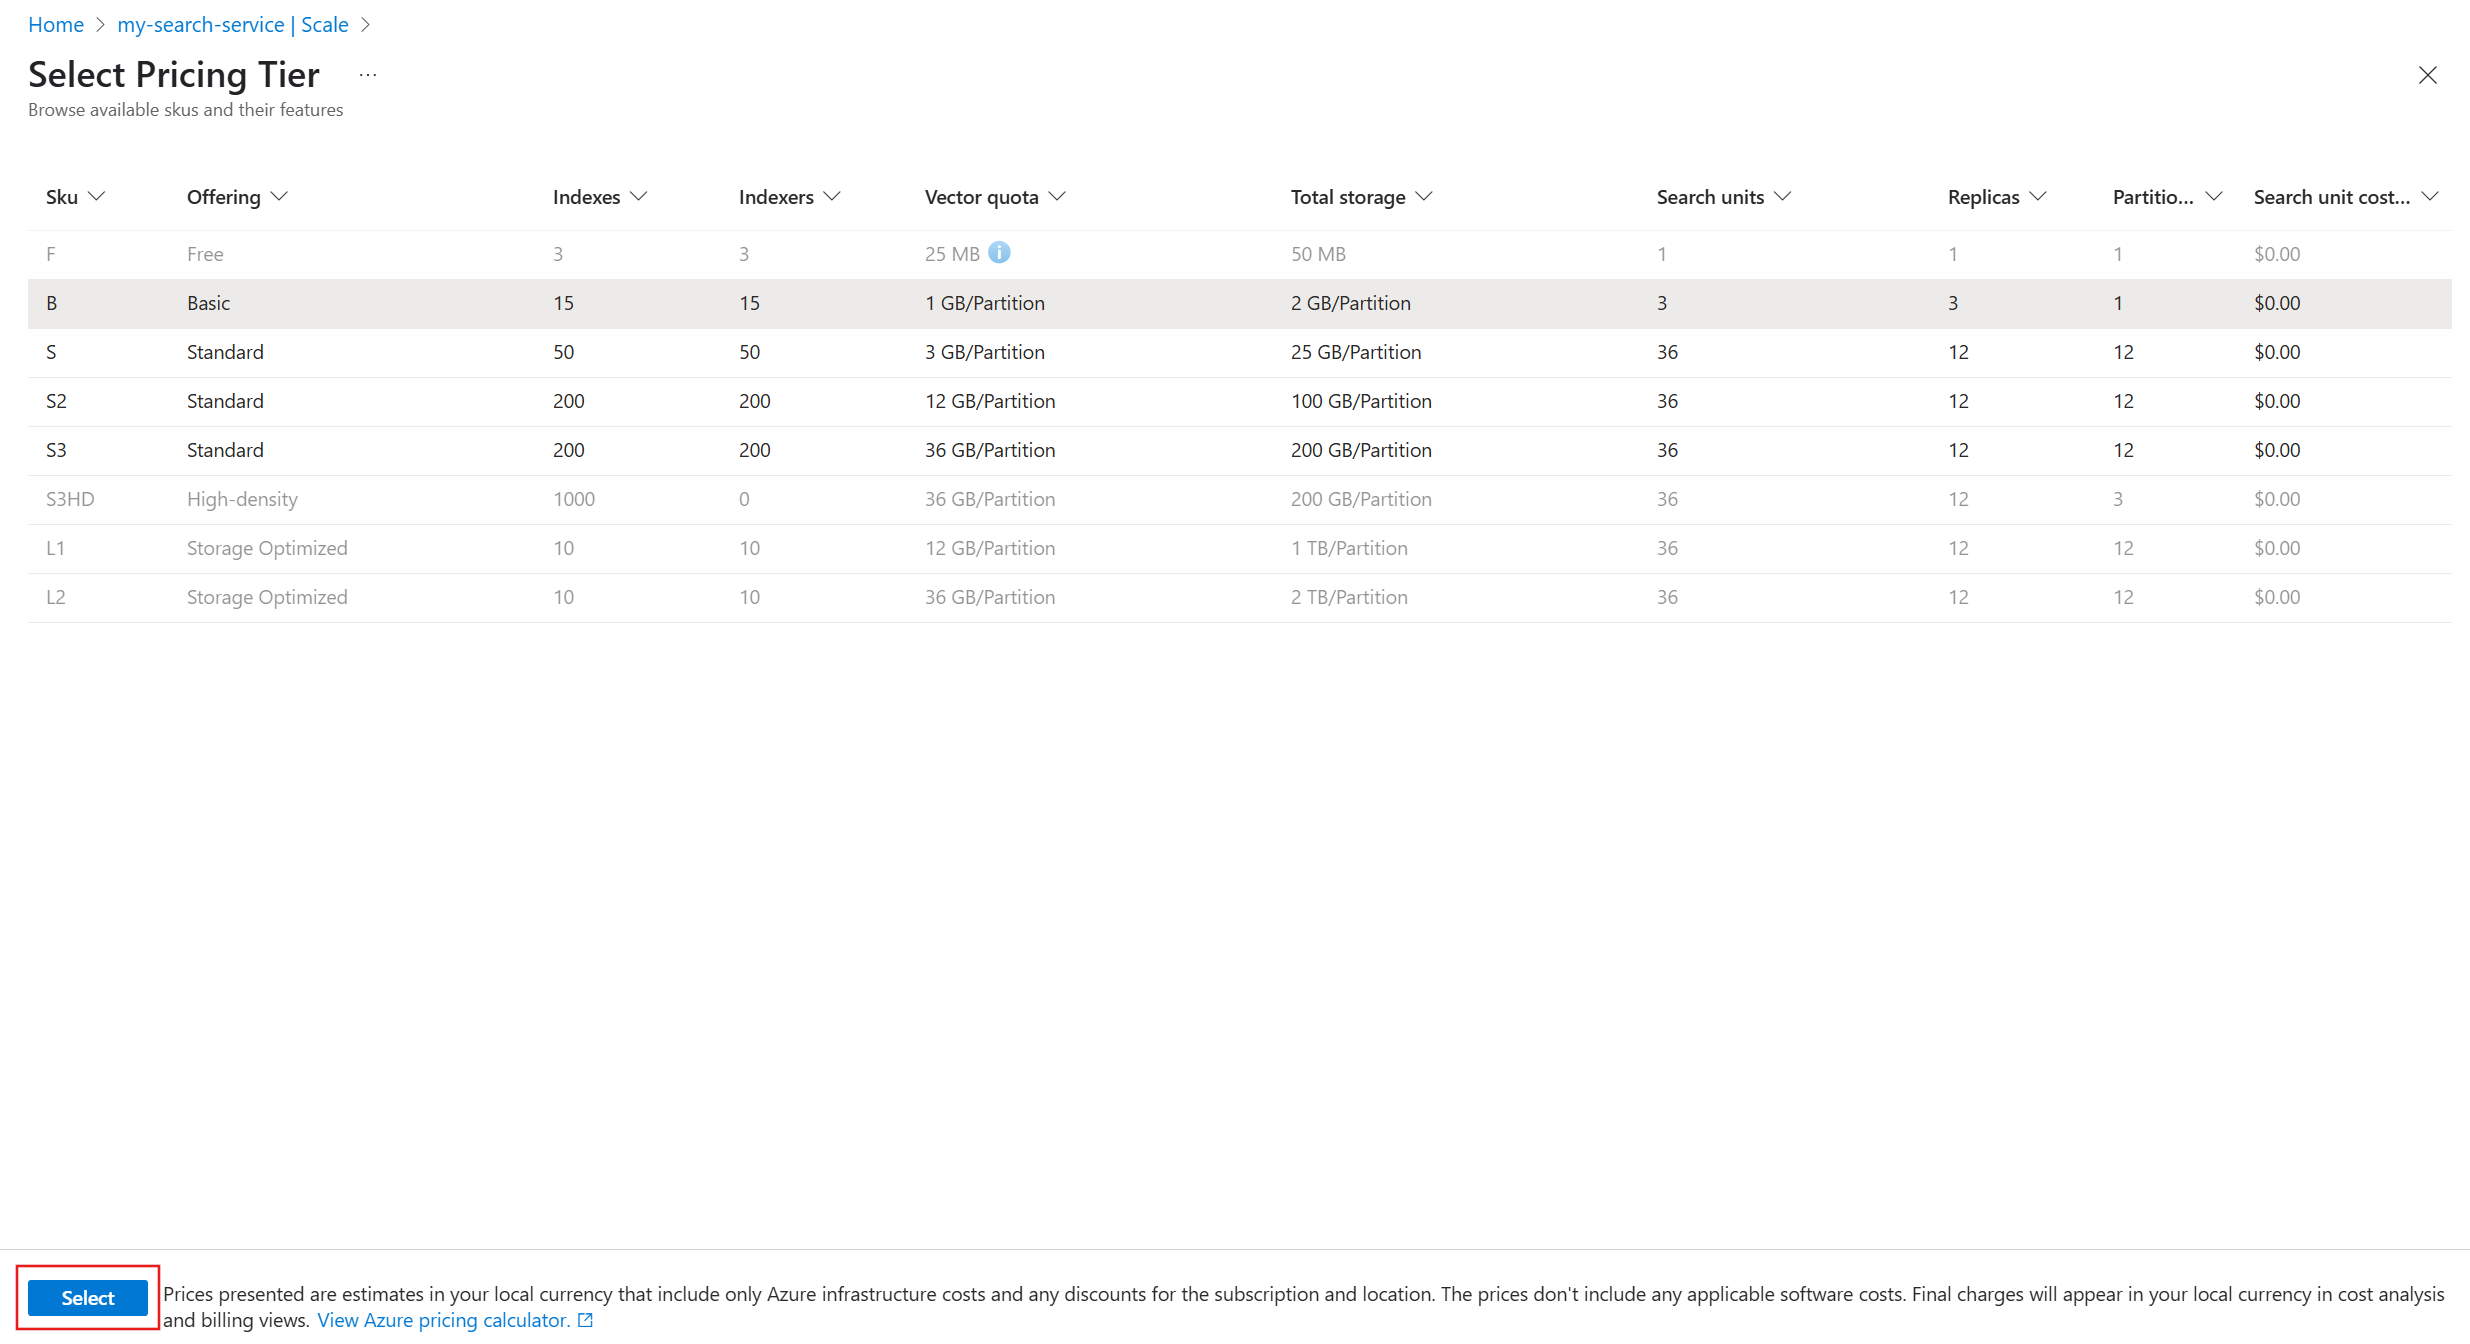
A méretezési művelet elindításához válassza a Mentés lehetőséget.
Ez a művelet több órát is igénybe vehet. Ez a háttérben történik, így a keresési szolgáltatás teljes mértékben működőképes marad, és elérhető az olvasási és írási műveletekhez.
Nem szakíthatja meg a műveletet, és nem figyelheti annak előrehaladását. Az alábbi üzenet azonban megjelenik, amíg a módosítások folyamatban vannak.
Az Azure portál frissítési üzenetének képernyőképe.
A dedikált modell méretezési kéréseinek kezelése
Amikor a keresési szolgáltatás méretezési kérelmet kap, az a következő:
- Ellenőrzi, hogy a kérelem érvényes-e.
- Megkezdi az adatok és a rendszerinformációk biztonsági mentését.
- Ellenőrzi, hogy a szolgáltatás már kiépítési állapotban van-e (jelenleg replikákat vagy partíciókat ad hozzá vagy szüntet meg).
- Megkezdi az ellátást.
A szolgáltatás skálázása a szolgáltatás méretétől és a kérés hatókörétől függően több percet és több órát is igénybe vehet. A biztonsági mentés időtartama az adatok mennyiségétől, valamint a partíciók és replikák számától függően változik.
A méretezési kérelmek kezelésének lépései nem teljesen egymást követőek. A rendszer például akkor kezdi el a kiépítést, amikor biztonságosan megteheti, ami akár a biztonsági mentés fokozatos befejeződésének ideje alatt is megtörténhet.
Skálázási hibák
Az alábbi táblázat a skálázási műveletek során előforduló hibák okait és megoldásait sorolja fel.
| Hibaüzenet | Oka | Megoldás |
|---|---|---|
| "A szolgáltatásfrissítési műveletek jelenleg nem engedélyezettek, mert egy korábbi kérést dolgozunk fel." | Egy másik skálázási művelet is folyamatban van. | Ellenőrizze a Overview lapot a Azure portálon, vagy használja a Search Management REST API, Azure PowerShell vagy Azure CLI a keresési szolgáltatás állapotát. Ha az állapot "Kiépítés alatt áll", várjon, amíg "Sikeres" vagy "Sikertelen" lesz, mielőtt újra próbálkozik. 1, 2 |
| "Nem sikerült skálázni a keresési szolgáltatás nevét. Hiba: Az objektumszámtényleges száma meghaladja a megengedett korlátot: MaximumCount." | Az aktuális szolgáltatáskonfiguráció túllépi a cél tarifacsomag korlátait. | Ellenőrizze, hogy a tárterület kihasználtsága, a vektorhasználat, az indexek, az indexelők és más objektumok megfelelnek-e az alsó réteg szolgáltatási korlátainak. Az Alapszintű szint például legfeljebb 15 indexet támogat, így 16 index esetén nem válthat S1-ről Alapszintűre. Módosítsa az erőforrásokat, mielőtt újra próbálkozik. |
1 Nincs állapot a biztonsági másolatok esetében, amelyek olyan belső műveletek, amelyek valószínűleg nem zavarják a skálázási gyakorlatot.
2 Ha úgy tűnik, hogy a keresési szolgáltatás kiépítési állapotban elakadt, ellenőrizze, hogy vannak-e használhatatlan árva indexek, nulla lekérdezési forgalommal és indexfrissítések nélkül. A használhatatlan indexek blokkolhatják a szolgáltatási kapacitás változásait. Különösen olyan CMK-titkosított indexeket keressen, amelyek kulcsai már nem érvényesek. Törölje az indexet, vagy állítsa vissza a kulcsokat az index online állapotba helyezéséhez és a skálázási művelet letiltásához.
Partíció- és replikakombinációk
Az alábbi diagram a Standard szintre és a magasabb szintre vonatkozik. Megjeleníti a partíciók és replikák összes lehetséges kombinációját, a szolgáltatásonkénti 36 keresési egység maximális értékétől függően.
| 1 partíció | 2 partíciók | 3 partíciók | 4 partíciók | 6 partíció | 12 partíció | |
|---|---|---|---|---|---|---|
| 1 replika | 1 SU | 2 SU | 3 SU | 4 SU | 6 SU | 12 SU |
| 2 másolat | 2 SU | 4 SU | 6 SU | 8 SU | 12 SU | 24 SU |
| 3 replikák | 3 SU | 6 SU | 9 SU | 12 SU | 18 SU | 36 SU |
| 4 példány | 4 SU | 8 SU | 12 SU | 16 SU | 24 SU | Nincs adat. |
| 5 másolat | 5 SU | 10 SU | 15 SU | 20 SU | 30 SU | Nincs adat. |
| 6 példány | 6 SU | 12 SU | 18 SU | 24 SU | 36 SU | Nincs adat. |
| 12 replikák | 12 SU | 24 SU | 36 SU | Nincs adat. | Nincs adat. | Nincs adat. |
Az alapszintű keresési szolgáltatásokban alacsonyabb a keresési egységek száma.
A 2024. április 3. előtt létrehozott keresési szolgáltatások esetében az alapszolgáltatások pontosan egy partícióval és legfeljebb három replikával rendelkezhetnek, ami összességében legfeljebb három szolgáltatási egységet jelent. Az egyetlen állítható erőforrás a replikák. A szolgáltatás frissítésével azonban növelheti a partíciók számát.
A 2024. április 3. után támogatott régiókban létrehozott keresési szolgáltatásokban az alapszintű szolgáltatások legfeljebb három partícióval és három replikával rendelkezhetnek. A maximális SU-korlát kilenc, amely támogatja a partíciók és replikák teljes kiegészítését.
Bármely számlázható szinten elérhető keresési szolgáltatásokhoz a létrehozás dátumától függetlenül legalább két replikára van szükség a lekérdezések magas rendelkezésre állásához.
A tarifacsomagonkénti és pénznemenkénti számlázási díjakért tekintse meg a Azure AI Keresés díjszabási oldalt.
Kapacitás becslése dedikált tarifamodell-szinttel
A tárolási igények attól függenek, hogy milyen méretű indexeket szeretne létrehozni. Nincsenek olyan szilárd heurisztikus vagy általános irányelvek, amelyek segítenek a becslésekben. Az index méretének meghatározásának egyetlen módja az, ha létrehozunk egyet. Mérete függ a tokenizálástól és a beágyazásoktól, valamint attól, hogy engedélyezi-e a javaslattevőket, a szűrést és a rendezést, vagy kihasználhatja a vektoros tömörítés előnyeit.
Kapacitás becslése számlázható szinten, alapszintű vagy magasabb szinten. Az ingyenes szint több ügyfél által megosztott fizikai erőforrásokon fut, és az Ön által nem befolyásolható tényezőknek van kitéve. Csak a számlázható keresési szolgáltatás dedikált erőforrásai képesek nagyobb mintavételi és feldolgozási időt biztosítani az index mennyiségének, méretének és lekérdezési mennyiségének reálisabb becsléséhez a fejlesztés során.
Tekintse át az egyes szintek szolgáltatási korlátait annak megállapításához, hogy az alacsonyabb szintek támogatják-e a szükséges indexek számát. Fontolja meg, hogy szüksége van-e egy index több másolatára az aktív fejlesztéshez, teszteléshez és termelési környezethez.
A keresési szolgáltatásokra objektumkorlátok (indexek, indexelők, képességkészletek stb.) és tárolási korlátok vonatkoznak. Amelyik korlátot előbb eléri a rendszer, az a tényleges korlát.
Szolgáltatás létrehozása számlázható szinten. A rétegek bizonyos számítási feladatokhoz vannak optimalizálva. A Tároptimalizált szint például 10 indexkorláttal rendelkezik, mivel alacsony számú nagy index támogatására lett kialakítva.
Ha nem biztos az előre jelzett terhelésben, kezdjen alacsonyan, alapszintű vagy S1 szinten.
Ha a tesztelés nagy léptékű indexelést és lekérdezési terhelést is tartalmaz, kezdjen magasra, S2-nél vagy akár S3-nál is.
Ha nagy mennyiségű adatot indexel, és a lekérdezési terhelés viszonylag alacsony, az L1 vagy L2 tárolóra optimalizált tárolással kell kezdenie, mint egy belső üzleti alkalmazás esetén.
Hozzon létre egy kezdeti indexet annak meghatározásához, hogy a forrásadatok hogyan fordítják le az indexet. Csak így becsülhet meg indexméretet. A meződefiníciók attribútumai hatással vannak a fizikai tárolási követelményekre:
Kulcsszókeresés esetén a mezők szűrhetőként és rendezhetőként való megjelölése növeli az index méretét.
A vektorkereséshez paramétereket állíthat be a vektorméret csökkentésére.
Monitor storage, szolgáltatási korlátok, lekérdezési mennyiség és késés a Azure portálon. A Azure portál másodpercenként megjeleníti a lekérdezéseket, a szabályozott lekérdezéseket és a keresési késést. Ezek az értékek segíthetnek eldönteni, hogy a megfelelő szintet választotta-e.
Replikák hozzáadása magas rendelkezésre álláshoz vagy a lassú lekérdezési teljesítmény csökkentése érdekében.
Nincs irányelv arra vonatkozóan, hogy hány replikára van szükség a lekérdezési terhelések kezeléséhez. A lekérdezés teljesítménye a lekérdezés összetettségétől és a versengő számítási feladatoktól függ. Bár a replikák hozzáadása egyértelműen jobb teljesítményt eredményez, az eredmény nem szigorúan lineáris: a három replika hozzáadása nem garantálja a háromszoros átviteli sebességet. A QPS megoldáshoz való becsléséhez a teljesítmény elemzése és a lekérdezések monitorozása című témakörben talál útmutatást.
Az invertált indexek esetében a méretet és az összetettségeket a tartalom határozza meg, nem feltétlenül a benne tárolt adatok mennyisége. A nagy redundanciával rendelkező nagy adatforrások kisebb indexet eredményezhetnek, mint egy nagy mértékben változó tartalmat tartalmazó kisebb adathalmaz. Ezért ritkán lehet az index méretét az eredeti adathalmaz mérete alapján következtetni.
A tárolási követelmények felfújhatók, ha olyan adatokat is tartalmaz, amelyeket soha nem keres. Ideális esetben a dokumentumok csak a keresési élményhez szükséges adatokat tartalmazzák.
Szolgáltatásiszint-szerződéssel kapcsolatos szempontok
A szolgáltatási szintű szerződések (SLA-k) nem fedik le az ingyenes szintet és az előzetes verziójú funkciókat. Az összes számlázható szint esetében az SLA-k akkor lépnek érvénybe, amikor elegendő redundanciát épít ki a szolgáltatáshoz.
Két vagy több replika felel meg a lekérdezési (olvasási) SLA-knak.
Három vagy több replika felel meg a lekérdezési és indexelési (olvasási-írási) SLA-knak.
A partíciók száma nem befolyásolja az SLA-kat.
A kiszolgáló nélküli modell költségeinek optimalizálása
A kiszolgáló nélküli díjszabási modellben:
- A szolgáltatás automatikusan kezeli a kapacitást.
- Nem kell replikákat, partíciókat vagy keresési egységeket konfigurálnia.
- A számítási feladatok (lekérdezési és indexelési igények) alapján a számítás dinamikusan skálázható, és tétlen állapotban nullára skálázható.
A kiszolgáló nélküli modell korlátaival kapcsolatos további információkért tekintse meg a szolgáltatáskorlátokat.
A számlázás két dimenzión alapul:
- Számítási egységek használata (CUs): A díjszabás a lekérdezési és indexelési műveletek alapján történik.
- Indexelt tároló: Havonta gb-onként számítjuk fel.
Mivel a számlázás használatalapú, a költség közvetlenül a használathoz van kötve:
- Az összetett lekérdezések több számítást használnak fel.
- A nem hatékony sématervezés növeli az indexelési és a lekérdezési költségeket.
- A nagy vagy gyakran frissített indexekkel rendelkező gyenge lekérdezési minták növelik a tárolást és a számítási használatot.
A munkaterhelés hatékonyságának optimalizálása
Mivel a hatékonysághiány költségként jelenik meg a kiszolgáló nélküli modellben, többet kell fizetnie azért a munkáért, ha nem gyakorol számítási feladatokkal kapcsolatos tervezést. A kiszolgáló nélküli kiadások szabályozásának legjobb módja az indexek és lekérdezések hatékony megtervezése az elejétől kezdve.
A kiszolgáló nélküli díjszabási modell használatakor a hatékonyság érdekében a számítási feladatok tervezéséhez vegye figyelembe a következő szempontokat:
Index kialakítása
- Csak a lekérdezésekben használt mezőket vegye fel.
- Lehetőség szerint csökkentse a vektorméreteket.
- Kerülje a szükségtelen szűrhető, rendezhető vagy szempontok szerint csoportosítható jellemzőket.
Lekérdezési minták
- A visszaadott mezők korlátozására használható
$select. - Szűrők korai alkalmazása az eredményhalmazok csökkentéséhez.
- Kerülje a mély lapozást (
$skip). - A célzott lekérdezések előnyben részesíthetők a széles körű teljes szöveges lekérdezésekkel szemben.
- A magasabb számítási költség miatt körültekintően használja a hibrid keresést.
Monitoring
- A CU-használat monitorozása a költséges lekérdezések azonosításához.
- A tárterület növekedésének nyomon követése és a nem használt adatok eltávolítása.
Kiszolgáló nélküli környezetben a teljesítmény javítása (gyorsabb, célzottabb lekérdezések) általában csökkentik a költségeket.
További információkért lásd: A költségek optimalizálása az Azure AI Keresés kiszolgáló nélküli díjszabási modelljével.
Regionális kapacitással kapcsolatos szempontok
A kapacitás és a rendelkezésre állás a támogatott régiótól függően változhat. Egyes régiókban korlátozások lehetnek az új szolgáltatások kiépítésére vagy a meglévők skálázására.
Megjegyzés:
A nyilvános előzetes verzióban a kiszolgáló nélküli díjszabási modell csak bizonyos régiókban érhető el.
Ha az előnyben részesített Azure AI Keresés régió kapacitáskorlátozások miatt nem érhető el, tekintse meg a Az Azure AI Keresés régióbeli kapacitáskorlátozások kezelésére vonatkozó útmutatót.