Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Megjegyzés
Azure AI Keresés a Azure portálon, REST API-kon és Azure SDK-k keresztül érhető el. Emellett a Foundry IQ-t is támogatja, amely a vállalati tartalmakat újrafelhasználható, engedélytudatos tudásbázisokká alakítja át az Microsoft Foundry portálon található ügynökök számára.
Ez a cikk ismerteti a keresési eredmények összetételét, valamint azt, hogyan alakíthatja a teljes szöveges keresési eredményeket a forgatókönyvek szerint. A keresési eredmények egy lekérdezési válaszban jelennek meg. A válasz alakját maga a lekérdezés paraméterei határozzák meg. Ezek a paraméterek a következők:
- Az indexben található egyezések száma (
count) - A válaszban visszaadott egyezések száma (alapértelmezés szerint 50, konfigurálható
top) vagy oldalanként (skipéstop) - Az egyes találatok keresési pontszáma, amelyet a rangsoroláshoz használnak (
@search.score) - Keresési eredményekben szereplő mezők (
select) - Rendezési logika (
orderby) - Az eredményen belüli kifejezések kiemelése, egyezés a teljes vagy részleges kifejezésre a szövegtörzsben.
- Választható elemek a szemantikai rangsorolóból (
answersfelül,captionsminden mérkőzéshez)
A keresési eredmények tartalmazhatnak legfelső szintű mezőket, de a válasz nagy része egy tömb dokumentumainak egyeztetéséből áll.
Ügyfelek és API-k a lekérdezési válasz meghatározásához
A lekérdezési válasz konfigurálásához az alábbi ügyfeleket használhatja:
- Kereséskezelő az Azure Portalon JSON-nézetben, hogy bármilyen támogatott paramétert meg tud adni
- Dokumentumok – POST (REST API-k)
- SearchClient.Search metódus (.NET-hez készült Azure SDK)
- SearchClient.Search metódus (Azure SDK for Python)
- SearchClient.Search módszer (Azure for JavaScript)
- SearchClient.Search metódus (Azure for Java)
Eredményösszeállítás
Az eredmények többnyire táblázatosak, vagy az összes retrievable mező mezőiből állnak, vagy csak a select paraméterben megadott mezőkre korlátozódnak. A sorok az egyező dokumentumok, amelyek általában relevancia szerinti sorrendben vannak rangsorolva, kivéve, ha a lekérdezési logika nem zárja ki a relevancia szerinti rangsorolást.
Kiválaszthatja, hogy mely mezők szerepelnek a keresési eredmények között. Bár a keresődokumentumok sok mezővel rendelkezhetnek, általában csak néhányra van szükség az egyes dokumentumok eredményben való megjelenítéséhez. Egy lekérdezési kérelemhez fűzze hozzá select=<field list> , hogy megadja, mely retrievable mezők jelenjenek meg a válaszban.
Válasszon olyan mezőket, amelyek kontrasztot és különbséget kínálnak a dokumentumok között, és elegendő információt nyújtanak a felhasználó átkattintási válaszának meghívásához. Egy e-kereskedelmi webhelyen ez lehet egy terméknév, leírás, márka, szín, méret, ár és értékelés. A szállodai mintaindex esetében a következő példában a "kiválasztás" mezők lehetnek:
POST /indexes/hotels-sample/docs/search?api-version=2026-04-01
    {
      "search": "sandy beaches",
      "select": "HotelId, HotelName, Description, Rating, Address/City",
      "count": true
    }
Tippek váratlan eredményekhez
Időnként a lekérdezés kimenete nem az, amire számít. Előfordulhat például, hogy egyes találatok duplikáltnak tűnnek, vagy a felső rész közelében megjelenő találatok az eredményekben alacsonyabban vannak elhelyezve. Ha a lekérdezés eredménye váratlan, megpróbálhatja ezeket a lekérdezésmódosításokat, hogy lássa, javulnak-e az eredmények:
Módosítsa
searchMode=any(alapértelmezés szerint) úgy, hogysearchMode=allmegkövetelje az összes feltétel teljesülését, ne csak bármelyikét. Ez különösen igaz, ha logikai operátorok szerepelnek a lekérdezésben.Kísérletezzen különböző lexikális elemzőkkel vagy egyéni elemzőkkel annak ellenőrzéséhez, hogy módosítja-e a lekérdezés eredményét. Az alapértelmezett elemző megszakítja az elválasztott szavakat, és gyökéralakokra csökkenti a szavakat, ami általában javítja a lekérdezési válaszok robusztusságát. Ha azonban meg kell őriznie a kötőjeleket, vagy ha a karakterláncok speciális karaktereket tartalmaznak, előfordulhat, hogy egyéni elemzőket kell konfigurálnia annak érdekében, hogy az index a megfelelő formában lévő tokeneket tartalmazza. További információ: Részleges kifejezéskeresés és speciális karakterekkel (kötőjelek, helyettesítő karakterek, regex, minták) rendelkező minták.
Egyezések számlálása
A count paraméter az index azon dokumentumainak számát adja vissza, amelyek egyezésnek minősülnek a lekérdezéshez. A szám visszaadásához adja hozzá count=true a lekérdezési kérelemhez. A keresési szolgáltatás nem ír elő maximális értéket. A lekérdezéstől és a dokumentumok tartalmától függően a szám olyan magas lehet, mint az index összes dokumentuma.
A darabszám akkor pontos, ha az index stabil. Ha a rendszer aktívan ad hozzá, frissít vagy töröl dokumentumokat, a szám hozzávetőleges, kivéve a nem teljes indexelt dokumentumokat.
A keresési szolgáltatás rutinszerű karbantartása vagy egyéb számítási feladatai nem befolyásolják a számokat. Ha azonban több partícióval és egyetlen replikával rendelkezik, a partíciók újraindítása során rövid távú ingadozások léphetnek fel a dokumentumszámban (néhány perc).
Tipp
Az indexelési műveletek ellenőrzéséhez egy üres keresési count=true lekérdezés hozzáadásával search=* ellenőrizheti, hogy az index tartalmazza-e a várt számú dokumentumot. Az eredmény az indexben lévő dokumentumok teljes száma.
A lekérdezés szintaxisának tesztelése során gyorsan megállapíthatja, count=true hogy a módosítások nagyobb vagy kevesebb eredményt adnak-e vissza, ami hasznos visszajelzés lehet.
A válaszban szereplő eredmények száma
Az Azure AI Keresés kiszolgálóoldali lapozással megakadályozza, hogy a lekérdezések egyszerre túl sok dokumentumot beolvasjanak. A válaszban szereplő eredmények számát meghatározó lekérdezési paraméterek a következők top : és skip.
top a lapon található keresési eredmények számát jelöli.
skip egy top időköz, és azt jelzi a keresőmotornak, hogy hány eredményt kell kihagynia a következő eredményhalmaz előtt.
Az alapértelmezett oldalméret 50, míg a maximális oldalméret 1000. Ha 1000-nél nagyobb értéket ad meg, és az indexben több mint 1000 találat található, csak az első 1000 találat lesz visszaadva. Ha az egyezések száma meghaladja az oldalméretet, a válasz tartalmazza a következő találatoldal lekérésére vonatkozó információkat. Példa:
"@odata.nextLink": "https://contoso-search-eastus.search.windows.net/indexes/hotels-sample/docs/search?api-version=2026-04-01"
A leggyakoribb találatokat a keresési pontszám határozza meg, feltéve, hogy a lekérdezés teljes szöveges keresés vagy szemantikai. Ellenkező esetben a legfelső egyezések tetszőleges sorrendben jelennek meg a pontos egyezéses lekérdezéseknél (ahol az egységes @search.score=1.0 tetszőleges rangsorolást jelöl).
Állítsa be top az 50-es alapértelmezett érték felülírásához. Az újabb előzetes verziójú API-kban, ha hibrid lekérdezést használ, legfeljebb 10 000 dokumentum visszaadásához megadhatja a maxTextRecallSize értéket.
Az eredményhalmazban visszaadott összes dokumentum lapozásának szabályozásához használja a top és a skip elemeket együtt. Ez a lekérdezés 15 egyező dokumentum első halmazát adja vissza, valamint a teljes egyezések számát.
POST https://contoso-search-eastus.search.windows.net/indexes/hotels-sample/docs/search?api-version=2026-04-01

{
    "search": "room with a view",
    "count": true,
    "top": 15,
    "skip": 0
}
Ez a lekérdezés a második halmazt adja vissza, és kihagyja az első 15-öt a következő 15 lekéréséhez (16–30):
POST https://contoso-search-eastus.search.windows.net/indexes/hotels-sample/docs/search?api-version=2026-04-01

{
    "search": "room with a view",
    "count": true,
    "top": 15,
    "skip": 15
}
A lapszámozott lekérdezések eredményei nem garantáltan stabilak, ha a mögöttes index megváltozik. A lapozás során az egyes oldalak skip értéke megváltozik, de minden lekérdezés független, és az adatok aktuális nézetét veszi alapul, ahogy az lekérdezéskor az indexben szerepel (vagyis nincs gyorsítótárazás vagy pillanatkép az eredményekről, mint amilyenek például egy általános célú adatbázisban találhatók).
Az alábbiakban egy példát mutatunk be arra, hogyan találkozhat ismétlődésekkel. Tegyük fel, hogy egy index négy dokumentummal rendelkezik:
{ "id": "1", "rating": 5 }
{ "id": "2", "rating": 3 }
{ "id": "3", "rating": 2 }
{ "id": "4", "rating": 1 }
Most tegyük fel, hogy az eredményeket egyszerre kettővel szeretné visszaadni, értékelés szerint rendezve. Ezt a lekérdezést az eredmények első oldalának lekéréséhez hajtja végre: $top=2&$skip=0&$orderby=rating desca következő eredményeket hozva létre:
{ "id": "1", "rating": 5 }
{ "id": "2", "rating": 3 }
A szolgáltatásban tegyük fel, hogy egy ötödik dokumentumot ad hozzá az indexhez a lekérdezéshívások között: { "id": "5", "rating": 4 }. Röviddel ezután végrehajt egy lekérdezést a második oldal lekéréséhez, $top=2&$skip=2&$orderby=rating descés lekéri az alábbi eredményeket:
{ "id": "2", "rating": 3 }
{ "id": "3", "rating": 2 }
Figyelje meg, hogy a 2. dokumentum kétszer lesz beolvasva. Ennek az az oka, hogy az új 5. dokumentum nagyobb értékkel rendelkezik az értékeléshez, ezért a 2. dokumentum előtt rendez, és az első oldalra kerül. Bár ez a viselkedés váratlan lehet, jellemző, hogy a keresőmotor hogyan viselkedik.
Sok találat lapozása
A lapozás alternatív módszere a rendezési sorrend és a tartományszűrő használata megoldásként skip.
Ebben az alternatív megoldásban a rendezést és a szűrést egy dokumentumazonosító vagy más egyedi mező szerint alkalmazzák. Az egyedi mezőnek a keresési indexben kell rendelkeznie filterable és sortable hozzárendeléssel.
Adjon ki egy lekérdezést a rendezett eredmények teljes oldalának visszaadásához.
POST /indexes/good-books/docs/search?api-version=2026-04-01
    {
      "search": "divine secrets",
      "top": 50,
      "orderby": "id asc"
    }
Válassza ki a keresési lekérdezés által visszaadott utolsó eredményt. Itt egy csak azonosító értékkel rendelkező példaeredmény jelenik meg.
{
    "id": "50"
}
Használja ezt az azonosítóértéket egy tartománylekérdezésben a következő találatoldal lekéréséhez. Ennek az azonosítómezőnek egyedi értékekkel kell rendelkeznie, ellenkező esetben a lapozás ismétlődő eredményeket tartalmazhat.
POST /indexes/good-books/docs/search?api-version=2026-04-01
    {
      "search": "divine secrets",
      "top": 50,
      "orderby": "id asc",
      "filter": "id gt 50"
    }
A lapozás akkor fejeződik be, amikor a lekérdezés nulla eredményt ad vissza.
Megjegyzés
Az filterable és sortable az attribútumok csak akkor engedélyezhetők, ha először hozzáadnak egy mezőt egy indexhez, és nem engedélyezhetők egy meglévő mezőben.
Az eredmények rendezése
Egy teljes szöveges keresési lekérdezésben a találatok a következő sorrendben rangsorolhatók:
- keresési pontszám
- szemantikai újjárendező pontszám
- rendezési sorrend egy
sortablemezőben
Az adott mezőkben található találatokat pontozási profil hozzáadásával is növelheti.
Sorrend keresési pontszám szerint
A teljes szöveges keresési lekérdezések esetében az eredményeket automatikusan rangsorolja egy keresési pontszám a BM25 algoritmussal, amely a kifejezés gyakoriságát, a dokumentum hosszát és a dokumentum átlagos hosszát veszi figyelembe a relevancia meghatározásához.
A @search.score tartomány vagy korlátlan, vagy 0-tól 1,00-ig terjed, de nem tartalmazza az 1,00-t a régebbi szolgáltatásokon.
Bármelyik algoritmus @search.score esetében az 1,00-es érték egy nem rangsorolt vagy nem értékelt eredményhalmazt jelent, ahol az 1,0 pontszám minden eredményben egységesen van jelen. A pontszámozás nélküli eredmények akkor fordulnak elő, ha a lekérdezési űrlap homályos keresés, wildcard vagy regex lekérdések, vagy üres keresés (search=*). Ha rangsorolási struktúrát kell előírnia a nem rögzített eredményekhez képest, fontolja meg ezt a célt elérő orderby kifejezést.
Rendelés a szemantikai reranker szerint
Ha szemantikai rangsorolót használ, az @search.rerankerScore határozza meg az eredmények rendezési sorrendjét.
A @search.rerankerScore tartomány 1 és 4,00 között van, ahol a magasabb pontszám erősebb szemantikai egyezést jelez.
Rendelés az 'orderby' használatával
Ha a konzisztens rendezés alkalmazáskövetelmény, definiálhat egy orderby kifejezést egy mezőben. Az eredmények rendezéséhez csak a rendezhetőként indexelt mezők használhatók.
A gyakran használt mezők közé tartozik a orderby minősítés, a dátum és a hely. A hely szerinti szűréshez a szűrőkifejezés a mezőnév mellett a geo.distance() függvényt is meghívja.
A numerikus mezők (Edm.Double, Edm.Int32, ) Edm.Int64numerikus sorrendbe vannak rendezve (például 1, 2, 10, 11, 20).
A sztringmezők (Edm.String almezők Edm.ComplexType) a nyelvtől függően ASCII rendezési sorrendben vagy Unicode rendezési sorrendben vannak rendezve.
A sztringmezők numerikus tartalma betűrendbe van rendezve (1, 10, 11, 2, 20).
A nagybetűs sztringek a kisbetűsek előtt vannak rendezve (APPLE, Apple, BANANA, Banana, alma, banán). Rendezés előtt hozzárendelhet egy szövegnormalizálót a szöveg előfeldolgozásához, hogy módosítsa ezt a viselkedést. A kisbetűs tokenizer mezőn való használata nincs hatással a rendezési viselkedésre, mivel az Azure AI Keresés a mező nem elemezett példányán rendez.
Az ékezetes karakterekkel kezdődő karakterláncok utolsóként jelennek meg (Äpfel, Öffnen, Üben)
Relevancia növelése pontozási profillal
A rendszerességet előmozdító másik módszer az egyéni pontozási profil használata. A pontozási profilok nagyobb mértékben szabályozják a keresési eredményekben szereplő elemek rangsorolását, így az adott mezőkben található találatok is növelhetők. A többletpontozási logika segíthet felülbírálni a replikák közötti kisebb különbségeket, mivel az egyes dokumentumok keresési pontszámai távolabb vannak egymástól. Ehhez a megközelítéshez a rangsorolási algoritmust javasoljuk.
Találatok kiemelése
A találatkiemelés a szöveg formázását jelenti (például félkövér vagy sárga kiemelést), amelyet az eredményekben szereplő egyező kifejezésekre alkalmaznak, így az egyezés könnyen észrevehetővé válik. A kiemelés olyan hosszabb tartalommezők esetén hasznos, mint például egy leírásmező, ahol az egyezés nem egyértelmű azonnal.
Figyelje meg, hogy a kiemelés az egyes kifejezésekre vonatkozik. Nincs lehetőség egy teljes mező tartalmának kiemelésére. Ha ki szeretne emelni egy kifejezést, meg kell adnia az egyező kifejezéseket (vagy kifejezést) egy idézőjelbe foglalt lekérdezési sztringben. Ezt a technikát részletesebben ebben a szakaszban ismertetjük.
A találatkiemelési utasításokat a lekérdezési kérelem tartalmazza. A lekérdezésbővítést a motorban aktiváló lekérdezések, például a homályos és a helyettesítő keresés korlátozottan támogatják a találatok kiemelését.
A találatok kiemelésének követelményei
- A mezőknek
Edm.StringvagyCollection(Edm.String) - A mezőknek a
searchablekell tulajdonítva lenniük.
Adja meg a kiemelést a kérelemben
A kiemelt kifejezések visszaadásához adja meg a kiemelési paramétert a lekérdezési kérelemben. A paraméter a mezők vesszővel tagolt listájára van beállítva.
Alapértelmezés szerint a jelölőformátum <em>, de ezt a címkét a highlightPostTag és highlightPreTag paraméterek használatával felülírhatja. Az ügyfélkód kezeli a választ (például félkövér betűtípus vagy sárga háttér alkalmazásával).
POST /indexes/good-books/docs/search?api-version=2026-04-01
    {
      "search": "divine secrets",
      "highlight": "title, original_title",
      "highlightPreTag": "<b>",
      "highlightPostTag": "</b>"
    }
Az Azure AI Keresés alapértelmezés szerint mezőnként legfeljebb öt kiemelést ad vissza. Ezt a számot egy kötőjel és egy egész szám összefűzésével módosíthatja. A leírásmező egyező tartalmában például a "highlight": "description-10" legfeljebb 10 kiemelt kifejezést ad vissza.
Kiemelt eredmények
Amikor kiemelést adnak hozzá a lekérdezéshez, a válasz minden eredményhez tartalmaz egy @search.highlights-t, hogy az alkalmazáskód megcélozza ezt a struktúrát. A "kiemelés" mezőben megadott mezők listája szerepel a válaszban.
A kulcsszókeresésben minden kifejezés önállóan van ellenőrizve. Az "isteni titkos kódok" lekérdezése egyezést ad vissza minden olyan dokumentumon, amely bármelyik kifejezést tartalmazza.
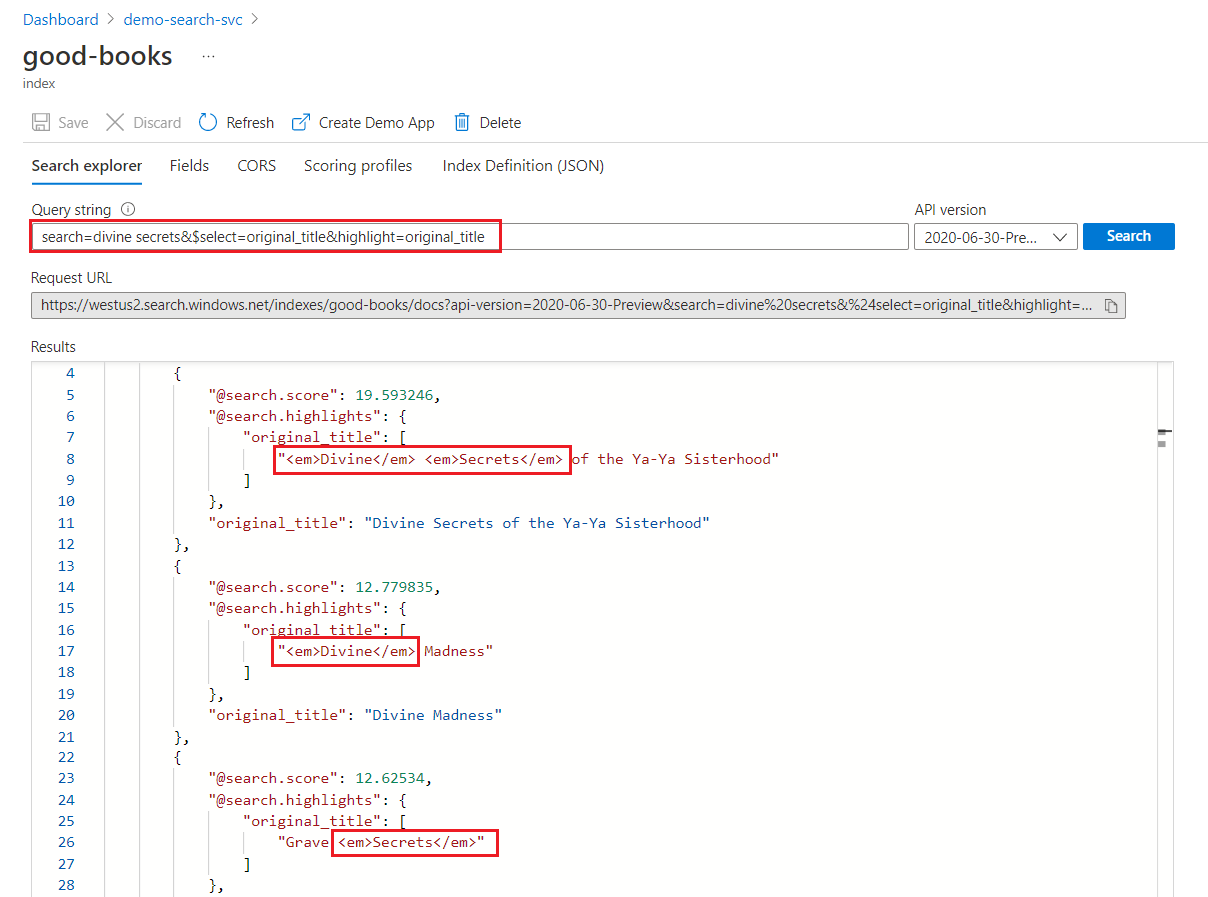
Kulcsszókeresés kiemelése
A kiemelt mezőkben a program a formázást egész kifejezésekre alkalmazza. Például a "The Divine Secrets of the Ya-Ya Sisterhood" (A Ya-Ya Testvériség isteni titkai) elleni mérkőzésen a formázást minden kifejezésre külön-külön alkalmazza a rendszer, annak ellenére, hogy egymás után vannak.
"@odata.count": 39,
"value": [
    {
        "@search.score": 19.593246,
        "@search.highlights": {
            "original_title": [
                "<em>Divine</em> <em>Secrets</em> of the Ya-Ya Sisterhood"
            ],
            "title": [
                "<em>Divine</em> <em>Secrets</em> of the Ya-Ya Sisterhood"
            ]
        },
        "original_title": "Divine Secrets of the Ya-Ya Sisterhood",
        "title": "Divine Secrets of the Ya-Ya Sisterhood"
    },
    {
        "@search.score": 12.779835,
        "@search.highlights": {
            "original_title": [
                "<em>Divine</em> Madness"
            ],
            "title": [
                "<em>Divine</em> Madness (Cherub, #5)"
            ]
        },
        "original_title": "Divine Madness",
        "title": "Divine Madness (Cherub, #5)"
    },
    {
        "@search.score": 12.62534,
        "@search.highlights": {
            "original_title": [
                "Grave <em>Secrets</em>"
            ],
            "title": [
                "Grave <em>Secrets</em> (Temperance Brennan, #5)"
            ]
        },
        "original_title": "Grave Secrets",
        "title": "Grave Secrets (Temperance Brennan, #5)"
    }
]
Kifejezéskeresés kiemelése
A teljes kifejezésformázás a kifejezéskeresésre is vonatkozik, ahol több kifejezés is kettős idézőjelek közé van zárva. Az alábbi példa ugyanaz a lekérdezés, azzal a kivétellel, hogy az "isteni titkok" idézőjeles kifejezésként lesznek elküldve (egyes REST-ügyfelek megkövetelik, hogy a belső idézőjeleket fordított perjellel \"hárítsa el):
POST /indexes/good-books/docs/search?api-version=2026-04-01
    {
      "search": "\"divine secrets\"",
      "select": "title,original_title",
      "highlight": "title",
      "highlightPreTag": "<b>",
      "highlightPostTag": "</b>",
      "count": true
    }
Mivel a feltételeknek most már mindkét kifejezésük van, csak egy egyezés található a keresési indexben. Az előző lekérdezésre adott válasz a következőképpen néz ki:
{
    "@odata.count": 1,
    "value": [
        {
            "@search.score": 19.593246,
            "@search.highlights": {
                "title": [
                    "<b>Divine</b> <b>Secrets</b> of the Ya-Ya Sisterhood"
                ]
            },
            "original_title": "Divine Secrets of the Ya-Ya Sisterhood",
            "title": "Divine Secrets of the Ya-Ya Sisterhood"
        }
    ]
}
Kifejezéskiemelés a régebbi szolgáltatásokon
A 2020. július 15. előtt létrehozott keresési szolgáltatások más kiemelési módot implementálnak a kifejezés-lekérdezésekhez.
Az alábbi példákhoz tegyük fel, hogy egy lekérdezési sztring tartalmazza a "super bowl" idézőjelbe foglalt kifejezést. 2020 júliusa előtt a kifejezés bármely kifejezése ki van emelve:
"@search.highlights": {
    "sentence": [
        "The <em>super</em> <em>bowl</em> is <em>super</em> awesome with a <em>bowl</em> of chips"
   ]
A 2020 júliusa után létrehozott keresési szolgáltatások esetében a rendszer csak a teljes kifejezés-lekérdezésnek megfelelő kifejezéseket adja vissza @search.highlights:
"@search.highlights": {
    "sentence": [
        "The <em>super</em> <em>bowl</em> is super awesome with a bowl of chips"
   ]
Következő lépések
Az ügyfél keresési oldalának gyors létrehozásához vegye figyelembe az alábbi lehetőségeket:
Bemutatóalkalmazás létrehozása az Azure portálon, amely létrehoz egy HTML-oldalt keresősávval, kategorizált navigációval, és egy miniatűr területtel, ha vannak képei.
Keresés hozzáadása webalkalmazásokhoz egy C#-oktatóanyag és kódminta, amely a React JavaScript-kódtárakat használja a felhasználói élmény érdekében. Az alkalmazás az Azure Static Web Apps használatával van üzembe helyezve, és a lapozást implementálja.