Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Megjegyzés
Azure AI Keresés a Azure portálon, REST API-kon és Azure SDK-k keresztül érhető el. Emellett a Foundry IQ-t is támogatja, amely a vállalati tartalmakat újrafelhasználható, engedélytudatos tudásbázisokká alakítja át az Microsoft Foundry portálon található ügynökök számára.
Ez a cikk a teljes szöveges keresés keresési pontszámainak kiszámításához használt BM25 relevanciapontozási algoritmust ismerteti. A BM25 relevanciája csak a teljes szöveges keresésre vonatkozik. A szűrőlekérdezések, az automatikus kiegészítés és a javasolt keresési lekérdezések, a helyettesítő karakterek és a homályos keresés nem nincsenek pontozva vagy rangsorolva relevancia szerint.
A teljes szöveges keresésben használt pontozási algoritmusok
Az Azure AI Keresés a következő pontozási algoritmusokat biztosítja a teljes szöveges kereséshez:
| Algoritmus | Használat | Tartomány |
|---|---|---|
BM25Similarity |
Kijavítottuk a 2020 júliusa után létrehozott összes keresési szolgáltatás algoritmusát. Ezt az algoritmust konfigurálhatja, de nem válthat régebbire (klasszikusra). | Korlátlan. |
ClassicSimilarity |
A 2020. júliust megelőző régebbi keresési szolgáltatások alapértelmezett értéke. A régebbi szolgáltatásokban a BM25-öt is választhatja, és indexenkénti alapon választhatja ki a BM25 algoritmust. | 0 < 1,00 |
A BM25 és a klasszikus egyaránt TF-IDF-szerű lekérési függvények, amelyek a kifejezés gyakoriságát (TF) és az inverz dokumentum gyakoriságát (IDF) használják változóként az egyes dokumentumlekérdezési párok relevanciájának kiszámításához, amelyet aztán a rangsorolási eredményekhez használnak. Bár a klasszikushoz fogalmilag hasonló, a BM25 olyan valószínűségi információlekérésben gyökerezik, amely intuitívabb egyezéseket hoz létre a felhasználói kutatások alapján.
A BM25 speciális testreszabási lehetőségeket kínál, például lehetővé teszi a felhasználó számára, hogy eldöntse, hogyan skálázható a relevanciapont a egyeztetett kifejezések kifejezési gyakoriságával.
A BM25 rangsorolásának működése
A relevanciapontszámozás egy keresési pontszám (@search.score) számítására utal, amely egy elem relevanciájának mutatójaként szolgál az aktuális lekérdezés kontextusában. A tartomány határtalan. Minél magasabb a pontszám, annál relevánsabb az elem.
A keresési pontszám kiszámítása a sztringbemenet és maga a lekérdezés statisztikai tulajdonságai alapján történik. Az Azure AI Keresés megkeresi a keresési kifejezésekkel egyező dokumentumokat (a keresési módtól függően néhányat vagy az összeset), előnyben részesítve a keresési kifejezés számos példányát tartalmazó dokumentumokat. A keresési pontszám még magasabb lesz, ha a kifejezés ritka az adatindexben, de gyakori a dokumentumban. A számítási relevancia ezen megközelítésének alapja a TF-IDF vagy a kifejezés frekvencia inverz dokumentum gyakorisága.
A keresési pontszámok a találatkészlet egészében megismételhetők. Ha több találat is azonos keresési pontszámmal rendelkezik, az azonos pontszámú elemek sorrendje nincs meghatározva, és nem stabil. Futtassa újra a lekérdezést, és előfordulhat, hogy az elemek eltolódnak, különösen akkor, ha az ingyenes szolgáltatást vagy a több replikával rendelkező számlázható szolgáltatást használja. Két azonos pontszámú elem esetén nincs garancia arra, hogy előbb megjelenik az egyik.
Ha meg szeretné szakítani a döntetlent az ismétlődő pontszámok között, hozzáadhat egy $orderby záradékot az első sorrendhez pontszám szerint, majd rendezhet egy másik rendezhető mező szerint (például $orderby=search.score() desc,Rating desc).
A rendszer csak az indexben vagy searchable a lekérdezésben megjelölt searchFields mezőket használja a pontozáshoz. Csak azok a mezők, amelyeket retrievable jelöltek meg, vagy amelyek a lekérdezésben select módon lettek meghatározva, szerepelnek a keresési eredményekben a keresési pontszámukkal együtt.
Megjegyzés
Az A @search.score = 1 nem pontozott vagy nem rangsorolt eredményhalmazt jelöl. A pontszám minden eredményben egységes. A nem pontozott eredmények akkor fordulnak elő, ha a lekérdezési űrlap homályos keresés, helyettesítő karakter vagy regex lekérdezés, vagy üres keresés (search=*), néha szűrőkkel párosítva, ahol a szűrő az elsődleges eszköz az egyezés visszaadására.
A következő videószegmens gyorsan előreugrik az Azure AI Keresés-ben használt általánosan hozzáférhető rangsorolási algoritmusok magyarázatához. A teljes videót a további háttérért tekintheti meg.
Pontszámok szöveges eredményekben
Az eredmények rangsorolásakor @search.score a tulajdonság az eredmények rendezéséhez használt értéket tartalmazza.
Az alábbi táblázat a pontozási tulajdonságot, az algoritmust és a tartományt azonosítja.
| Keresési módszer | Paraméter | Pontozási algoritmus | Tartomány |
|---|---|---|---|
| teljes szöveges keresés | @search.score |
BM25 algoritmus az indexben megadott paraméterekkel. | Korlátlan. |
Pontszám variációja
A keresési pontszámok általános relevanciaérzetet közvetítenek, amely tükrözi az egyezés erősségét az azonos eredményhalmazban lévő többi dokumentumhoz képest. A pontszámok azonban nem mindig konzisztensek az egyik lekérdezéstől a másikig, így a lekérdezések használatakor kis eltéréseket tapasztalhat a keresési dokumentumok sorrendjében. Ennek okaira több magyarázat is létezik.
| Ok | Leírás |
|---|---|
| Azonos pontszámok | Ha több dokumentum is ugyanazt a pontszámot használja, azok bármelyike megjelenhet először. |
| Adatok ingadozása | Az index tartalma a dokumentumok hozzáadása, módosítása vagy törlésekor változik. A kifejezés gyakorisága az indexfrissítések idővel történő feldolgozásakor változik, ami hatással van az egyező dokumentumok keresési pontszámára. |
| Több replika | A több replikát használó szolgáltatások esetében a rendszer az egyes replikákra párhuzamosan bocsát ki lekérdezéseket. A keresési pontszám kiszámításához használt indexstatisztikákat replikánként számítja ki a rendszer, az eredményeket egyesítve és rendezve a lekérdezési válaszban. A replikák többnyire egymás tükörképei, de a statisztikák az állapot kis eltérései miatt eltérhetnek. Előfordulhat például, hogy egy replika törölte a statisztikájukhoz hozzájáruló dokumentumokat, amelyeket más replikákból egyesítettek. A replikánkénti statisztikák különbségei általában észrevehetőbbek a kisebb indexekben. A következő szakasz további információt nyújt erről a feltételről. |
Horizontális skálázási hatások a lekérdezési eredményekre
A szegmens egy index darabja. Az Azure AI Keresés szegmensekre bontja az indexeket, hogy felgyorsítsa a partíciók hozzáadását (a szegmensek új keresési egységekbe való áthelyezésével). A keresési szolgáltatásban a szegmenskezelés implementálási részlet és nem konfigurálható, de az index horizontális felosztásának ismerete segít megérteni a rangsorolási és automatikus kiegészítési viselkedések időnkénti rendellenességeit:
Rangsorolási anomáliák: A keresési pontszámokat először a szegmens szintjén számítjuk ki, majd összesítjük egyetlen eredményhalmazba. A szegmenstartalom jellemzőitől függően előfordulhat, hogy az egyik szegmens találatai magasabb rangot kapnak, mint egy másik szegmens találatai. Ha ellentmondásos rangsorolást észlel a keresési eredményekben, az valószínűleg a shardolás hatásainak köszönhető, különösen akkor, ha az indexek kicsik. Ezeket a rangsorolási anomáliákat elkerülheti, ha úgy dönt, hogy globálisan számítja ki a pontszámokat a teljes indexben, de ez teljesítménybeli büntetést von maga után.
Automatikus kiegészítési anomáliák: Automatikus kiegészítési lekérdezések, amelyekben a részben megadott kifejezés első néhány karakterében egyezések jönnek létre, fogadjon el egy homályos paramétert, amely megbocsátja a helyesírás kis eltéréseit. Az automatikus kiegészítés esetében a homályos egyezés az aktuális szegmensen belüli kifejezésekre van korlátozva. Ha például egy szegmens tartalmazza a "Microsoft"-t, és a "mikro" kifejezés részleges kifejezése be van írva, a keresőmotor a "Microsoft" kifejezéssel fog egyezni az adott szegmensben, de az index fennmaradó részeit tartalmazó többi szegmensben nem.
Az alábbi ábra a replikák, partíciók, szegmensek és keresési egységek közötti kapcsolatot mutatja be. Egy példát mutat be arra, hogy egyetlen index hogyan van elosztva egy szolgáltatásban lévő négy keresési egység között két replikával és két partícióval. A négy keresési egység mindegyike az index szegmenseinek csak a felét tárolja. A bal oldali oszlop keresési egységei a szegmensek első felét tárolják, amely az első partíciót tartalmazza, míg a jobb oldali oszlopban lévők a szegmensek második felét tárolják, amely a második partíciót tartalmazza. Mivel két replika létezik, minden indexszilánk két példánya van. A felső sor keresési egységei egy példányt tárolnak, amely az első replikát tartalmazza, míg az alsó sorban lévők egy másik példányt tárolnak, amely a második replikát tartalmazza.
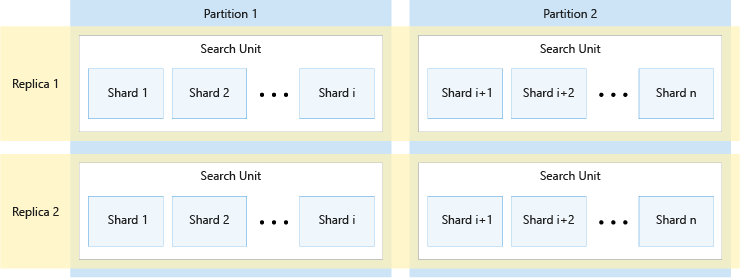
A fenti diagram csak egy példa. A partíciók és replikák számos kombinációja lehetséges, legfeljebb 36 keresési egységig.
Megjegyzés
A replikák és partíciók száma egyenletesen 12-re oszlik (pontosabban 1, 2, 3, 4, 6, 12). Az Azure AI Keresés előre osztja el az egyes indexeket 12 szegmensre, így egyenlő részekben osztható el az összes partíción. Ha például a szolgáltatás három partícióval rendelkezik, és létrehoz egy indexet, minden partíció az index négy szegmensét fogja tartalmazni. Hogyan osztja fel az Azure AI Keresés egy indexet szilánkokra, az egy implementációs részlet, ami a későbbi kiadásokban változhat. Bár a szám ma 12, nem várható, hogy ez a szám mindig 12 lesz a jövőben.
Pontozási statisztikák és ragadós munkamenetek
A méretezhetőség érdekében az Azure AI Keresés horizontálisan osztja el az indexeket sharding folyamat révén, ami azt jelenti, hogy az index egyes részei fizikailag elkülönülnek egymástól.
Alapértelmezés szerint egy dokumentum pontszáma a szegmensen belüli adatok statisztikai tulajdonságai alapján lesz kiszámítva. Ez a megközelítés általában nem jelent problémát nagy adathalmazok esetében, és jobb teljesítményt nyújt, mint az összes szegmens információi alapján kiszámítani a pontszámot. Ennek a teljesítményoptimalizálásnak a használata két nagyon hasonló dokumentumot (vagy akár azonos dokumentumot) okozhat, amelyek eltérő relevanciapontszámmal végződhetnek, ha különböző szegmensekbe kerülnek.
Ha inkább az összes szegmens statisztikai tulajdonságai alapján szeretné kiszámítani a pontszámot, ezt úgy teheti meg, hogy a scoringStatistics=global-t lekérdezési paraméterként adja meg, vagy a -t a lekérdezési kérés törzsparamétereként.
POST https://[service name].search.windows.net/indexes/hotels/docs/search?api-version=2026-04-01
{
    "search": "<query string>",
    "scoringStatistics": "global"
}
A scoringStatistics használata biztosítja, hogy az ugyanabban a replikában lévő összes szelet ugyanazt az eredményt adja. Ennek ellenére a különböző replikák kissé eltérhetnek egymástól, mivel mindig frissülnek az index legújabb módosításaival. Bizonyos esetekben előfordulhat, hogy a felhasználók konzisztensebb eredményeket szeretnének kapni egy lekérdezési munkamenet során. Ilyen esetekben a lekérdezések részeként is megadható sessionId . Az sessionId egy egyedi sztring, amelyet azért hoz létre, hogy egyedi felhasználói munkamenetre hivatkozzon.
POST https://[service name].search.windows.net/indexes/hotels/docs/search?api-version=2026-04-01
{
    "search": "<query string>",
    "sessionId": "<string>"
}
Mindaddig, amíg ugyanazt sessionId használja, a rendszer minden tőle telhetőt megtesz annak érdekében, hogy ugyanazt a replikát célozza meg, ezzel növelve a felhasználók által látott eredmények konzisztenciáját.
Megjegyzés
Ugyanazon sessionId értékek ismételt újrafelhasználása megzavarhatja a kérések terheléselosztását a replikák között, és hátrányosan befolyásolhatja a keresési szolgáltatás teljesítményét. A munkamenet-azonosítóként használt érték nem kezdődhet "_" karakterrel.
Relevanciahangolás
Az Azure AI Keresésben a kulcsszókereséshez és a hibrid lekérdezés szöveges részéhez konfigurálhatja a BM25-algoritmus paramétereit, valamint hangolhatja a keresési relevanciát, és az alábbi mechanizmusokkal növelheti a keresési pontszámokat.
| Megközelítés | Megvalósítás | Leírás |
|---|---|---|
| BM25-algoritmus konfigurálása | Keresési index | Konfigurálja, hogy a dokumentum hossza és a kifejezés gyakorisága hogyan befolyásolja a relevanciapontszámot. |
| Pontozási profilok | Keresési index | Adjon meg feltételeket az egyezés keresési pontszámának a tartalom jellemzői alapján történő növeléséhez. Például növelheti a találatokat a bevételi potenciáljuk alapján, népszerűsítheti az újabb elemeket, vagy népszerűsítheti a túl hosszú ideje a leltárban lévő elemeket. A pontozási profil az indexdefiníció része, amely súlyozott mezőkből, függvényekből és paraméterekből áll. A meglévő indexeket a pontozási profil módosításaival frissítheti anélkül, hogy az index újraépítése történne. |
| Szemantikai rangsorolás | Lekérdezési kérelem | Gépi olvasási megértést alkalmaz a keresési eredményekre, előtérbe hozva a szemantikailag relevánsabb találatokat. |
| featuresMode paraméter | Lekérdezési kérelem | Ezt a paramétert többnyire egy BM25 rangsorolt pontszám kicsomagolására használják, de egyéni pontozási megoldást biztosító kódban is használható. |
featuresMode paraméter (előzetes változat)
Megjegyzés
A featuresMode paraméter nincs dokumentálva a REST API-kban, de használhatja egy előzetes REST API-hívásban, amely a BM25-rangsorolt szöveges (kulcsszóalapú) kereséseket keresi.
A keresési dokumentumok (előzetes verzió) kérései támogatják azt a featuresMode paramétert, amely részletesebben ismerteti a BM25 relevanciapontszámát a mező szintjén. Míg a számítás a @searchScore teljes dokumentumra vonatkozik (mennyire releváns ez a dokumentum a lekérdezés kontextusában), a featuresMode az egyes mezőkkel kapcsolatos információkat fedi fel egy struktúrában @search.features kifejezve. A struktúra tartalmazza a lekérdezésben használt összes mezőt (vagy adott mezőket a lekérdezésben a searchFieldsen keresztül, vagy az indexben kereshetőként tulajdonított összes mezőt).
A featuresMode érvényes értékei:
- "none" (alapértelmezett). A rendszer nem ad vissza funkciószintű pontozási adatokat.
- engedélyezve Mezőnkénti részletes pontozási bontásokat ad vissza
Minden mezőhöz @search.features adja meg a következő értékeket:
- A mezőben található egyedi tokenek száma
- Hasonlósági pontszám vagy a mező tartalmának a lekérdezési kifejezéshez viszonyított hasonlóságának mértéke
- Kifejezés gyakorisága vagy a lekérdezési kifejezés számának száma a mezőben
Ez a paraméter különösen akkor hasznos, ha azt szeretné megtudni, hogy egyes dokumentumok miért rangsorolnak magasabb vagy alacsonyabb helyezést a keresési eredmények között. Segít elmagyarázni, hogy a különböző mezők hogyan járulnak hozzá az összesített pontszámhoz.
A "leírás" mezőt megcélzó lekérdezések esetében a kérések a következőképpen nézhetnek ki:
POST {{baseUrl}}/indexes/hotels-sample/docs/search?api-version=2026-08-01-preview  HTTP/1.1
  Content-Type: application/json
  Authorization: Bearer {{accessToken}}

    {
        "search": "lake view",
        "select": "HotelId, HotelName, Tags, Description",
        "featuresMode": "enabled",
        "searchFields": "Description, Tags",
        "count": true
    }
Egy olyan válasz, amely tartalmazza a @search.features kódot, így nézhet ki, mint a következő példa.
  "value": [
    {
      "@search.score": 3.0860271,
      "@search.features": {
        "Description": {
          "uniqueTokenMatches": 2.0,
          "similarityScore": 3.0860272,
          "termFrequency": 2.0
        }
      },
      "HotelName": "Downtown Mix Hotel",
      "Description": "Mix and mingle in the heart of the city. Shop and dine, mix and mingle in the heart of downtown, where fab lake views unite with a cheeky design.",
      "Tags": [
        "air conditioning",
        "laundry service",
        "free wifi"
      ]
    },
    {
      "@search.score": 2.7294855,
      "@search.features": {
        "Description": {
          "uniqueTokenMatches": 1.0,
          "similarityScore": 1.6023184,
          "termFrequency": 1.0
        },
        "Tags": {
          "uniqueTokenMatches": 1.0,
          "similarityScore": 1.1271671,
          "termFrequency": 1.0
        }
      },
      "HotelName": "Ocean Water Resort & Spa",
      "Description": "New Luxury Hotel for the vacation of a lifetime. Bay views from every room, location near the pier, rooftop pool, waterfront dining & more.",
      "Tags": [
        "view",
        "pool",
        "restaurant"
      ]
    }
  ]
Ezeket az adatpontokat egyéni pontozási megoldásokban használhatja fel, vagy az információkat a keresési relevanciával kapcsolatos problémák hibakeresésére használhatja.
Rangsorolt találatok száma teljes szöveges lekérdezési válaszban
Ha nem használ lapozást, a keresőmotor alapértelmezés szerint az 50 legmagasabb rangsorolt találatot adja vissza teljes szöveges keresés esetén. A top paraméterrel kisebb vagy nagyobb számú elemet adhat vissza (egyetlen válaszban akár 1000-et is). Használhatja a skip és next elemeket az eredmények oldalszámozásához. A lapozás határozza meg az egyes logikai oldalakon található eredmények számát, és támogatja a tartalomnavigációt. További információ: Alakzatkeresési eredmények.
Ha a teljes szöveges lekérdezés egy hibrid lekérdezés része, beállíthatja maxTextRecallSize , hogy növelje vagy csökkentse a lekérdezés szöveges oldaláról származó eredmények számát.
A teljes szöveges keresésre legfeljebb 1000 egyezés vonatkozik (lásd az API válaszkorlátait). Ha 1000 találatot talál, a keresőmotor már nem keres többet.