Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Megjegyzés
Azure AI Keresés a Azure portálon, REST API-kon és Azure SDK-k keresztül érhető el. Emellett a Foundry IQ-t is támogatja, amely a vállalati tartalmakat újrafelhasználható, engedélytudatos tudásbázisokká alakítja át az Microsoft Foundry portálon található ügynökök számára.
Az Azure AI Keresés több módon is futtathat indexelőt:
- Az indexelő létrehozása esetén fusson azonnal. Ez az alapértelmezett beállítás, kivéve, ha letiltott állapotban hozza létre az indexelőt.
- Ütemezett futtatás a rendszeres időközönkénti végrehajtáshoz. Ha egy ütemezett indexelő nem aktiválódik, a helyreállítási lépésekhez tekintse meg az Ütemezési viselkedéssel kapcsolatos gyakori kérdéseket .
- Igény szerinti futtatás, alaphelyzetbe állítással vagy anélkül.
Ez a cikk azt ismerteti, hogyan futtathat igény szerinti indexelőket alaphelyzetbe állítással és anélkül. Az indexelő végrehajtását, időtartamát és egyidejűségét is ismerteti.
Az indexelők kapcsolódása Azure erőforrásokhoz
Az indexelők azon kevés alrendszerek egyike, amelyek nyílt kimenő hívásokat hajtanak végre más Azure-erőforrásokhoz. A külső adatforrástól függően kulcsokkal vagy szerepkörök használatával hitelesítheti a kapcsolatot.
A Azure szerepkörök tekintetében az indexelők nem rendelkeznek külön identitásokkal: a keresőmotor és egy másik Azure erőforrás közötti kapcsolat egy keresési szolgáltatás rendszer- vagy felhasználó által hozzárendelt felügyelt identitását használja, valamint egy szerepkör-hozzárendelést a cél Azure erőforráshoz. Ha az indexelő egy virtuális hálózaton lévő Azure-erőforráshoz csatlakozik, létre kell hoznia egy osztott privát kapcsolatot ehhez a kapcsolathoz.
Megjegyzés
Az indexelők a felhasználói engedélyek helyett szolgáltatásszintű engedélyekkel működnek. Az indexelők a keresési szolgáltatás bármely indexére írhatnak, még akkor is, ha szerepköröket rendelt hozzá az adott indexekhez való hozzáférés korlátozásához. További információ: Indexenkénti hatókör- és indexelőműveletek.
Indexelő végrehajtása
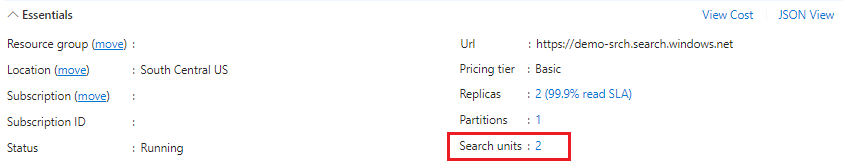
A keresési szolgáltatás keresési egységenként egy indexelő feladatot futtat. Minden keresési szolgáltatás egy keresési egységgel kezdődik, de minden új partíció vagy replika növeli a szolgáltatás keresési egységeit. A keresési egységek számát a Overview lap Azure portál Alapvető szakaszában ellenőrizheti. Ha egyidejű feldolgozásra van szüksége, győződjön meg arról, hogy a keresési egységek elegendő replikát tartalmaznak. Az indexelők nem futnak a háttérben, így a szokásosnál nagyobb lekérdezésszabályozást tapasztalhat, ha a szolgáltatás nyomás alatt áll.
Az alábbi képernyőképen a keresési egységek száma látható, amely meghatározza, hogy hány indexelő futtatható egyszerre.
Az indexelő végrehajtásának elindítása után nem szüneteltetheti és nem állíthatja le. Az indexelő végrehajtása leáll, ha nincs több betöltendő vagy frissítendő dokumentum, vagy ha eléri a maximális futási időkorlátot .
Egyszerre több indexelőt is futtathat elegendő kapacitást feltételezve, de maga az indexelő egypéldányos. Ha egy új példányt indít el, miközben az indexelő már végrehajtás alatt áll, a következő hibaüzenet jelenik meg: "Failed to run indexer "<indexer name>" error: "Another indexer invocation is currently in progress; concurrent invocations are not allowed."
Indexelő végrehajtási környezete
Az indexelőfeladat felügyelt végrehajtási környezetben fut. Jelenleg két környezet létezik:
A privát végrehajtási környezet a keresési szolgáltatáshoz tartozó keresési fürtökön fut.
A több-bérlős környezet tartalomfeldolgozókat tartalmaz, amelyeket a Microsoft külön költség nélkül kezel és véd. Ez a környezet számításilag intenzív feldolgozást végez, így a szolgáltatásspecifikus erőforrások továbbra is elérhetők maradnak a rutinműveletek számára. Amikor csak lehetséges, a legtöbb készségkészlet a több-bérlős környezetben fut. Ez a környezet az alapértelmezett.
A számítási igényes feldolgozás olyan tartalomfeldolgozókon és indexelő feladatokon futó készségkészleteket jelent, amelyek nagy mennyiségű dokumentumot vagy nagy méretű dokumentumot dolgoznak fel. A heurisztika és a rendszerinformációk határozzák meg a több-bérlős tartalomfeldolgozók nem készségalapú feldolgozását, és nem tartoznak az ügyfelek felügyelete alá.
Megakadályozhatja a több-bérlős környezet használatát a Standard2 vagy magasabb szintű szolgáltatásokban azáltal, hogy egy indexelőt és a képességkészlet feldolgozását kizárólag a keresési fürtökre rögzít.
Állítsa be az executionEnvironment indexelő definíciójában lévő paramétert úgy, hogy mindig futtasson egy indexelőt a privát végrehajtási környezetben.
Az IP-tűzfalak blokkolják a több-bérlős környezetet, ezért ha tűzfallal rendelkezik, hozzon létre egy szabályt , amely engedélyezi a több-bérlős processzorkapcsolatokat.
Az indexelők korlátai az egyes környezetekben eltérőek:
| Munkateher | Maximális időtartam | Feladatok maximális száma | Végrehajtási környezet |
|---|---|---|---|
| Privát végrehajtás | 24 óra | 1. keresési egységenként egy indexelő feladat. | Az indexelés nem fut a háttérben. Ehelyett a keresési szolgáltatás az összes indexelési feladatot a folyamatban lévő lekérdezésekkel és objektumkezelési műveletekkel (például indexek létrehozásával vagy frissítésével) egyensúlyba helyezi. Indexelők futtatásakor a lekérdezés késésére kell számítania, ha az indexelési kötetek nagyok. |
| Több-bérlős architektúra | 2 óra 2 | Határozatlan 3 | Mivel a tartalomfeldolgozó fürt több-bérlős, a rendszer az igényeknek megfelelően további tartalomfeldolgozókat ad hozzá. Ha késést tapasztal az igény szerinti vagy ütemezett végrehajtásban, az valószínűleg azért van, mert a rendszer processzorokat ad hozzá, vagy arra vár, hogy elérhetővé váljon. |
1 A keresési egységek lehetnek partíciók és replikák rugalmas kombinációi , de az indexelő feladatok nincsenek egyikhez vagy a másikhoz kötve. Más szóval, ha 12 egységgel rendelkezik, 12 indexelő feladat futhat egyidejűleg privát végrehajtásban, függetlenül attól, hogy a keresési egységek hogyan vannak üzembe helyezve.
2 Ha az összes adat feldolgozásához több mint két órára van szükség, engedélyezze a változásészlelést , és ütemezze, hogy az indexelő 5 perces időközönként fusson az indexelés gyors folytatásához, ha időtúllépés miatt leáll. További stratégiákért lásd : Nagy adatkészlet indexelése .
3 "Határozatlan" azt jelenti, hogy a korlátot nem számszerűsíti a feladatok száma. Egyes számítási feladatok, például a készségek feldolgozása párhuzamosan is futtathatók, ami sok feladatot eredményezhet, még ha csak egy indexelő is részt vesz benne. Bár a környezet nem ír elő korlátozásokat, a keresési szolgáltatás indexelőkorlátai továbbra is érvényesek.
Alaphelyzetbe állítás nélkül futtatás
Az Indexelő futtatása művelet csak azt észleli és dolgozza fel, amire szüksége van a keresési index és a mögöttes adatforrás változásainak szinkronizálásához. A növekményes indexelés azzal kezdődik, hogy megkeres egy belső felső határértéket, hogy megtalálja a legutóbb frissített keresési dokumentumot. Ez a dokumentum lesz az indexelő végrehajtásának kiindulópontja az adatforrás új és frissített dokumentumain keresztül.
A változásészlelés alapvető fontosságú az adatforrás újdonságainak vagy frissítésének meghatározásához. Az indexelők a mögöttes adatforrás változásészlelési képességeivel határozzák meg az adatforrás újdonságait vagy frissítéseit.
Azure Storage beépített változásészlelési funkcióval rendelkezik a LastModified tulajdonságán keresztül.
Más adatforrások, például az Azure SQL vagy az Azure Cosmos DB esetében a változásészlelés konfigurálása szükséges, mielőtt az indexelő be tudná olvasni az új és frissített sorokat.
Ha a mögöttes tartalom nem változik, a futtatási műveletnek nincs hatása. Ebben az esetben az indexelőzmények a feldolgozott dokumentumokat jelölik 0\0 .
Az összes dokumentum újrafeldolgozásához alaphelyzetbe kell állítania az indexelőt.
Indexelők alaphelyzetbe állítása
A kezdeti futtatás után az indexelő nyomon követi, hogy mely keresési dokumentumokat indexelnek egy belső határérték alapján. A jelölő nincs közzétéve, de az indexelő belsőleg tudja, hol állt le utoljára.
Egy index egészének vagy egy részének újraépítéséhez használja az objektumhierarchiában csökkenő szinteken elérhető Új API-kat:
- Az indexelők alaphelyzetbe állítása törli a felsővízjelet, és elvégzi az összes dokumentum teljes újraindexelését.
- Indexelők újraszinkronizálása (előzetes verzió) elvégzi az összes dokumentum hatékony, részleges újraindexelését.
- A Dokumentumok visszaállítása (előzetes verzió) újraindexel egy adott dokumentumot vagy dokumentumlistát.
- A Készségek alaphelyzetbe állítása (előzetes verzió) egy adott képesség képességfeldolgozását hívja meg.
Az alaphelyzetbe állítás után kövesse a Futtatás parancsot az új és a meglévő dokumentumok újrafeldolgozásához. Visszaállítással és futtatással nem távolíthatók el azok az árva keresési dokumentumok, amelyeknek nincs megfelelőjük az adatforrásban. Adott dokumentumok törléséhez lásd: Dokumentumok törlése keresési indexben vagy Dokumentumok – Index.
Megjegyzés
A táblák nem lehetnek üresek. Ha a TRUNCATE TABLE használatával töröl sorokat, az indexelő alaphelyzetbe állítása és újbóli futtatása nem távolítja el a hozzájuk tartozó keresési dokumentumokat. Az árva keresési dokumentumok eltávolításához törlési művelettel kell indexelnie őket.
Indexelők alaphelyzetbe állítása és futtatása
Az alaphelyzetbe állítás törli a csúcsteljesítményt. A keresési indexben lévő összes dokumentum teljes felülírás céljából van megjelölve, beágyazott frissítések és meglévő tartalmak egyesítése nélkül. A képességkészlettel és bővítési gyorsítótárazással (előzetes verzió) rendelkező indexelők esetében az index alaphelyzetbe állítása implicit módon alaphelyzetbe állítja a képességkészletet is.
A tényleges munka akkor következik be, ha futtatási paranccsal végez alaphelyzetbe állítást:
- Minden új dokumentum, amely a mögöttes forrást megtalálta, hozzáadódik a keresési indexhez.
- Az adatforrásban és a keresési indexben található összes dokumentum felülíródik a keresési indexben.
- A képességkészletekből létrehozott összes tartalom újra felépül. Ha engedélyezve van, a bővítési gyorsítótár frissül.
Ahogy korábban már említettük, az alaphelyzetbe állítás passzív művelet: az index újraépítéséhez egy futtatási kérést kell követnie.
Az alaphelyzetbe állítási/futtatási műveletek keresési indexre vagy tudástárra, adott dokumentumokra vagy előrejelzésekre, valamint gyorsítótárazott bővítésekre vonatkoznak, ha az alaphelyzetbe állítás explicit vagy implicit módon magában foglalja a készségeket.
Az alaphelyzetbe állítás a létrehozási és frissítési műveletekre is vonatkozik. Nem indítja el az árva dokumentumok törlését vagy eltávolítását a keresési indexben. A dokumentumok törléséről további információt a Dokumentumok – Index című témakörben talál.
Az alaphelyzetbe állítási művelet nem vonható vissza.
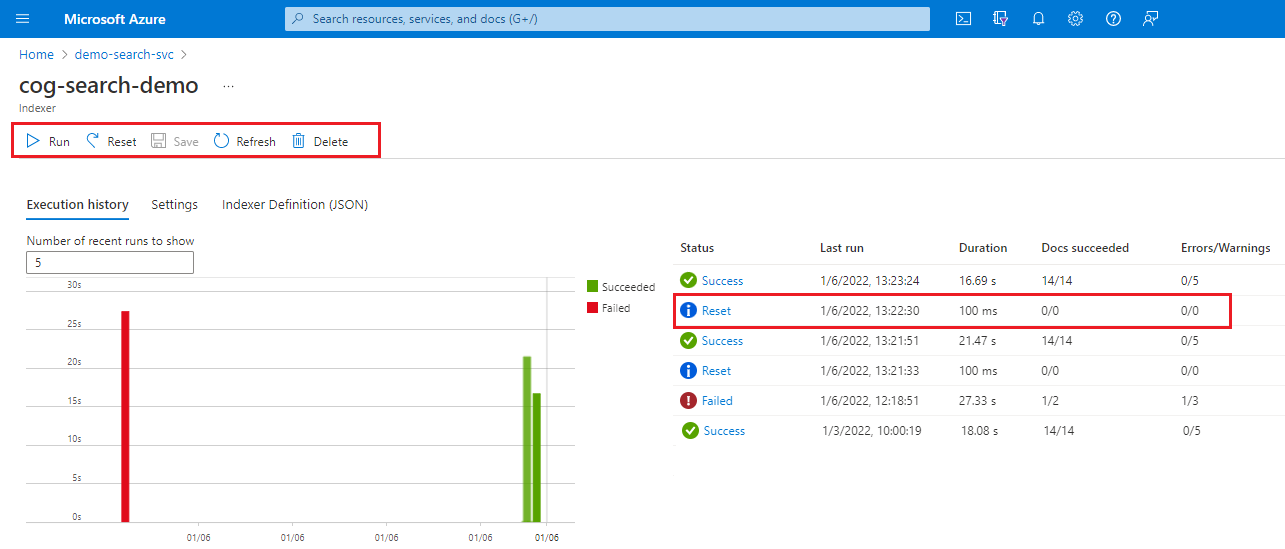
Nyissa meg a keresőszolgáltatást a Azure portálon.
Az Áttekintés lapon válassza az Indexelők lapot.
Jelöljön ki egy indexelőt.
Válassza az Alaphelyzetbe állítás parancsot, majd az Igen elemet a művelet megerősítéséhez.
Frissítse a lapot az állapot megjelenítéséhez. A részletek megtekintéséhez jelölje ki az elemet.
Válassza a Futtatás lehetőséget az indexelő feldolgozásának elindításához, vagy várja meg a következő ütemezett végrehajtást.
A készségek alaphelyzetbe állítása (előzetes verzió)
A Készségek alaphelyzetbe állítása kérés szelektíven dolgoz fel egy vagy több készséget a következő indexelő futtatása során. A képességkészletekkel rendelkező indexelők esetében alaphelyzetbe állíthatja az egyes készségeket, hogy csak az adott képesség és a kimenetétől függő alsóbb rétegbeli készségek újrafeldolgozását kényszerítse. Ha engedélyezte a bővítési gyorsítótárat, a kérés azt is frissíti.
A gyorsítótárazással rendelkező indexelők esetében explicit módon kérheti a képességfrissítések feldolgozását, amelyeket az indexelő nem tud észlelni. Ha például külső módosításokat hajt végre, például egy egyéni képesség módosításait, akkor ezzel az API-val futtassa újra a képességet. A folyamat frissíti a kimeneteket, például a tudástárat vagy a keresési indexet a gyorsítótárból származó újrafelhasználható adatok és a frissített képesség szerint új tartalom használatával.
Használja a legújabb előzetes verziójú API-t.
POST /skillsets/[skillset name]/resetskills?api-version=2026-08-01-preview
{
    "skillNames" : [
        "#1",
        "#5",
        "#6"
    ]
}
Az előző példában látható módon megadhatja az egyes készségeket, de ha ezek közül bármelyikhez nem sorolt készségekből (#2–4) származó kimenetre van szükség, a folyamat nem listázatlan készségeket futtat, kivéve, ha a gyorsítótár meg tudja adni a szükséges információkat. Ahhoz, hogy ez a feltétel teljesüljön, a 2–4. képességek gyorsítótárazott kibővítései nem függhetnek az 1. képességtől (visszaállításra kijelölve).
Ha nem ad meg készségeket, a folyamat végrehajtja a teljes készségkészletet, és ha a gyorsítótárazás engedélyezve van, a gyorsítótárat is frissíti.
Ne felejtse el elvégezni az Indexelő futtatását a tényleges feldolgozás elindításához.
Dokumentumok visszaállítása (előzetes verzió)
Az Indexelők – Docs alaphelyzetbe állítása (előzetes verzió) API elfogadja a dokumentumkulcsok listáját, hogy bizonyos dokumentumokat frissíthesse. Ha megadja az alaphelyzetbe állítási paramétereket, azok kizárólag azt határozzák meg, hogy mi lesz feldolgozva, függetlenül a mögöttes adatok egyéb változásaitól. Ha például a legutóbbi indexelő futtatása óta 20 blob lett hozzáadva vagy frissítve, de csak egy dokumentumot állít vissza, az indexelő csak ezt a dokumentumot dolgozza fel.
Az indexelő dokumentumonként frissíti a keresési dokumentum összes mezőjét az adatforrásból származó értékekkel és metaadatokkal. Nem válogathat a frissíteni kívánt mezők közül.
Ha az adatforrás Azure Data Lake Storage (ADLS) Gen2, és a blobok engedély-metaadatokhoz vannak társítva, az indexelő újra betölti ezeket az engedélyeket a keresési indexben, ha az engedélyek megváltoznak az alapul szolgáló adatokban. További információ: ACL és RBAC-hatókör újraindexelése ADLS Gen2 indexelőkkel.
Ha egy készségkészlettel bővíti a dokumentumot, és gyorsítótárazott adatokkal rendelkezik, az indexelő meghívja a készségkészletet csak a megadott dokumentumokhoz, és frissíti az újrafeldolgozott dokumentumok gyorsítótárát.
Amikor először teszteli ezt az API-t, az alábbi API-k segíthetnek a viselkedés ellenőrzésében és tesztelésében. Használja a legújabb előzetes verziójú API-t.
Indexelők hívása – Állapot lekérése előzetes API-verzióval az alaphelyzetbe állítás és a végrehajtás állapotának ellenőrzéséhez. Az alaphelyzetbe állítási kérelemről az állapotválasz végén talál információt.
Indexelők - Dokumentumok alaphelyzetbe állítása hívása egy előzetes API verzióval annak meghatározására, hogy mely dokumentumokat kell feldolgozni.
POST https://[service name].search.windows.net/indexers/[indexer name]/resetdocs?api-version=2026-08-01-preview
{
    "documentKeys" : [
        "1001",
        "4452"
    ]
}
Az API kétféle dokumentumazonosítót fogad el bemenetként: olyan dokumentumkulcsokat, amelyek egyedileg azonosítják a keresési indexben lévő dokumentumokat, és olyan adatforrás-dokumentumazonosítókat, amelyek egyedileg azonosítják az adatforrás dokumentumait. A törzsnek tartalmaznia kell a dokumentumkulcsok listáját vagy az adatforrásban az indexelő által az adatforrásban keresendő adatforrás-dokumentumazonosítók listáját. Az API meghívása hozzáadja a dokumentumkulcsokat vagy az adatforrás-dokumentumazonosítókat az indexelő metaadatainak visszaállításához. Az indexelő következő ütemezett vagy igény szerinti futtatásakor az indexelő csak az alaphelyzetbe állítási dokumentumokat dolgozza fel.
Ha dokumentumkulcsokkal állítja alaphelyzetbe a dokumentumokat, és a dokumentumkulcsok egy indexelő mezőleképezésben szerepelnek, az indexelő mezőleképezéssel megkeresi a megfelelő mezőt az alapul szolgáló adatforrásban.
A kérelemben megadott dokumentumkulcsok a keresési index értékei, amelyek eltérhetnek az adatforrás megfelelő mezőitől. Ha nem biztos a kulcsértékben, küldjön egy lekérdezést az érték visszaadásához. Csak a dokumentumkulcsmező visszaadására használható
select.Azon blobok esetében, amelyeket az indexelő több keresési dokumentumba elemez (ahol
parsingModejsonLines vagy jsonArrays vagy delimitedText értékre van beállítva), az indexelő létrehozza a dokumentumkulcsot, és ön ismeretlen lehet számára. Ebben az esetben a dokumentumkulcs lekérdezése a megfelelő értéket adja vissza.Ha azt szeretné, hogy az indexelő ne próbálja meg feldolgozni a visszaállított dokumentumokat, állítsa a(z)
"documentKeys"vagy"datasourceDocumentIds"értékét üres listára:[]. Ez a művelet azt eredményezi, hogy az indexelő a felső vízjel alapján folytatja a rendszeres indexelést. A rendszer figyelmen kívül hagyja az érvénytelen dokumentumkulcsokat vagy a nem létező dokumentumkulcsokat.
A megadott dokumentumok feldolgozásához hívja meg a Run Indexer (bármely API-verzió) funkciót. Az indexelő csak az adott dokumentumokat indexeli.
Hívja meg másodszor az Indexelő futtatását az utoljára elért állapottól való feldolgozáshoz.
Hívja meg a keresési dokumentumokat a frissített értékek ellenőrzéséhez, és ha bizonytalan az értékeket illetően, kérje le a dokumentumkulcsokat. Használja
"select": "<field names>", ha korlátozni szeretné, hogy mely mezők jelenjenek meg a válaszban.
A dokumentumkulcsok listájának felülírása
Ha többször hívja meg a Dokumentumok alaphelyzetbe állítása API-t különböző kulcsokkal, az új kulcsok hozzá lesznek adva a dokumentumkulcsok alaphelyzetbe állításának listájához. Ha az API-t úgy hívja meg, hogy a overwrite paraméter értéke true, akkor az aktuális listát az új lista váltja fel:
POST https://[service name].search.windows.net/indexers/[indexer name]/resetdocs?api-version=2026-08-01-preview
{
    "documentKeys" : [
        "200",
        "630"
    ],
    "overwrite": true
}
Indexelők újraszinkronizálása (előzetes verzió)
Az Indexelők újraszinkronizálása egy előzetes REST API, amely az összes dokumentum részleges újraindexelését hajtja végre. Az indexelő akkor tekinthető szinkronizáltnak az adatforrással, ha a célindexben lévő összes dokumentum adott mezői összhangban vannak az adatforrás adataival. Az indexelők általában a sikeres kezdeti futtatás után érik el a szinkronizálást. Ha töröl egy dokumentumot az adatforrásból, az indexelő ennek a definíciónak megfelelően szinkronizálva marad. A következő indexelő futtatása során azonban a célindex megfelelő dokumentuma törlődik, ha engedélyezve van a törléskövetés.
Ha módosít egy dokumentumot az adatforrásban, az indexelő nem lesz szinkronizálva. A változáskövetési mechanizmusok általában újraszinkronizálják az indexelőt a következő futtatás során. A Azure Storage például a blobok módosítása frissíti az utolsó módosítás időpontját, így az indexelő újraindexelheti azt a későbbi indexelőfuttatásban, mert a frissített idő meghaladja az előző futtatás által beállított magas vízjelet.
Ezzel szemben bizonyos adatforrások, például az ADLS Gen2 esetében a blobok hozzáférés-vezérlési listáinak (ACL-einek) módosítása nem változtatja meg az utolsó módosítás időpontját, így a változáskövetés nem hatékony, ha az ACL-eket be kell venni. Ennek következtében a módosított blob nem lesz újra indexelve a következő futtatás során, mivel csak az utolsó magas vízjelet követően módosított dokumentumokat dolgozza fel a rendszer.
Az "alaphelyzetbe állítás" vagy a "visszaállítási dokumentumok" használata megoldhatja ezt a problémát, az "alaphelyzetbe állítás" időigényes és nem hatékony lehet a nagy adathalmazok esetében, a "visszaállítási dokumentumok" pedig a frissíteni kívánt blob dokumentumkulcsának azonosítását igénylik.
Az újraszinkronizálási indexelők hatékony és kényelmes alternatívát kínálnak. Egyszerűen újraszinkronizálási módba helyezi az indexelőt, majd az indexelők újraszinkronizálására szolgáló API meghívásával megadja az újraszinkronizálandó tartalmat. A következő futtatás során az indexelő csak a forrásban lévő adatok releváns részét vizsgálja meg, és elkerüli a megadott adatokhoz nem kapcsolódó szükségtelen feldolgozást. A célindexben lévő meglévő dokumentumokat is lekérdezi, és csak az adatforrás és a célindex közötti eltéréseket mutató dokumentumokat frissíti. Az újraszinkronizálás futtatása után a rendszer szinkronizálja az indexelőt, és visszaáll a normál indexelő-futtatási módra a későbbi futtatásokhoz.
Indexelők újraszinkronizálása és futtatása
Indexelők hívása – Újraszinkronizálás egy előzetes API-verzióval, amely megadja a szinkronizálandó tartalmakat.
POST https://[service name].search.windows.net/indexers/[indexer name]/resync?api-version=2026-08-01-preview { "options" : [ "permissions" ] }- A
optionsmező megadása kötelező. Jelenleg az egyetlen támogatott lehetőség azpermissions. Vagyis csak a célindex engedélyszűrő mezői frissülnek.
- A
Hívja meg a Run Indexer-t (bármelyik API-verziót) az indexelő újraszinkronizálásához.
Hívja meg másodszor az Indexelő futtatását az utoljára elért állapottól való feldolgozáshoz.
Ellenőrizze a "currentState" alaphelyzetbe állítási állapotát
Az alaphelyzetbe állítás állapotának ellenőrzéséhez és annak megtekintéséhez, hogy mely dokumentumkulcsok lesznek várólistán feldolgozásra, kövesse az alábbi lépéseket:
Hívja meg az Indexelő állapotának lekérése műveletet preview API használatával.
Az előzetes verziójú API a
currentStateválasz végén található szakaszt adja vissza."currentState": { "mode": "indexingResetDocs", "allDocsInitialTrackingState": "{\"LastFullEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"LastAttemptedEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"NameHighWaterMark\":null}", "allDocsFinalTrackingState": "{\"LastFullEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"LastAttemptedEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"NameHighWaterMark\":null}", "resetDocsInitialTrackingState": null, "resetDocsFinalTrackingState": null, "resyncInitialTrackingState": null, "resyncFinalTrackingState": null, "resetDocumentKeys": [ "200", "630" ] }Ellenőrizze a "módot":
A képességek visszaállításához állítsa a „mode” értékét erre:
indexingAllDocs, mert az AI-gazdagítás által kitöltött mezők szempontjából akár az összes dokumentum érintett lehet.Az indexelők újraszinkronizálásához állítsa a "mode" (mód) értéket
indexingResync. Az indexelő ellenőrzi az összes dokumentumot, és az adatforrás és a célindex érdekelt mezőinek érdekelt adataira összpontosít.A Dokumentumok visszaállítása esetében állítsa a „mode” értékét erre:
indexingResetDocs. Az indexelő mindaddig megőrzi ezt az állapotot, amíg feldolgozza az alaphelyzetbe állítási dokumentumok hívásában megadott összes dokumentumkulcsot. Ez alatt az idő alatt a művelet előrehaladása alatt nem hajtanak végre más indexelőfeladatokat. A dokumentumkulcsok listájában szereplő összes dokumentum megtalálásához minden dokumentumot fel kell dolgozni a kulcs megkereséséhez és az egyezés ellenőrzéséhez. Ez a folyamat eltarthat egy ideig, ha az adathalmaz nagy. Ha egy blobtároló több száz blobot tartalmaz, és az alaphelyzetbe állítani kívánt dokumentumok a végén vannak, az indexelő nem találja az egyező blobokat, amíg először nem ellenőrzi az összes többit.Miután az indexelő újra feldolgozta a dokumentumokat, futtassa újra az Indexelő állapotának lekérése parancsot. Az indexelő visszatér a
indexingAllDocsmódhoz, és a következő futtatáskor feldolgozza az új vagy frissített dokumentumokat.
Indexelő futásidejű kvótájának ellenőrzése az S3 HD és a kiszolgáló nélküli keresési szolgáltatások esetében
Ez a szakasz a Standard 3 nagy sűrűségű (S3 HD) és a kiszolgáló nélküli keresési szolgáltatásokra vonatkozik. Az aggregátumkvóta-működéssel és a tervezéssel kapcsolatos útmutatásért tekintse meg az Indexelő kiszolgáló nélküli és S3 HD-n történő végrehajtását (előzetes verzió) ismertető témakört.
Az indexelő egyes futtatásai legfeljebb két óráig tarthatnak. Külön minden indexelő szolgáltatásonként 24 órányi kumulatív futásidet oszt meg minden 24 órás UTC-ablakban.
Az indexelő 24 órás időszakhoz viszonyított futási idejének figyeléséhez a Szolgáltatásstatisztikák lekérése és az Indexelő állapotának lekérése mostantól további információkat ad vissza a válaszban.
Kumulatív futásidejű kvóta nyomon követése
Nyomon követheti egy keresési szolgáltatás kumulatív indexelő-futtatókörnyezet-használatát, és meghatározhatja, hogy mennyi futásidejű kvóta maradjon az aktuális 24 órás ablakban.
GET-kérés küldése a keresési szolgáltatás végpontjának. A REST-ügyfél beállításával és a hozzáférési jogkivonat lekérésével kapcsolatos segítségért tekintse meg a Csatlakozás keresési szolgáltatáshoz című témakört.
GET {{search-endpoint}}/servicestats?api-version=2026-08-01-preview
  Content-Type: application/json
  Authorization: Bearer {{accessToken}}
A válaszok olyan tulajdonságokat tartalmaznak indexersRuntime , amelyek az ablak kezdési és befejezési idejét, az összes indexelő által használt összes másodpercet és a szolgáltatáshoz hátralévő másodperceket jelenítik meg.
Indexelő futásidejű kvótáinak nyomon követése
Ugyanazt az információt adja vissza egyetlen indexelőhöz.
GET {{search-endpoint}}/indexers/hotels-sample-indexer/search.status?api-version=2026-08-01-preview
  Content-Type: application/json
  Authorization: Bearer {{accessToken}}
A válaszok olyan tulajdonságokat tartalmaznak runtime , amelyek az ablak kezdési és befejezési idejét, az indexelő által használt másodperceket és a szolgáltatás összes indexelőjének másodpercét jelenítik meg.
Következő lépések
Az alaphelyzetbe állítási API-k a következő indexelő futtatásának hatókörének tájékoztatására szolgálnak. A tényleges feldolgozáshoz meg kell hívnia egy igény szerinti indexelő futtatását, vagy engedélyeznie kell egy ütemezett feladat számára a munka befejezését. A futtatás befejezése után az indexelő visszatér a normál feldolgozáshoz, függetlenül attól, hogy az ütemezés szerint vagy igény szerinti feldolgozáson alapul.
Az indexelői feladatok alaphelyzetbe állítása és újrafuttatása után a keresési szolgáltatásból figyelheti az állapotot, vagy részletes információkat kérhet le az erőforrásnaplózáson keresztül.