Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Note
Azure AI Keresés a Azure portálon, REST API-kon és Azure SDK-k keresztül érhető el. Emellett a Foundry IQ-t is támogatja, amely a vállalati tartalmakat újrafelhasználható, engedélytudatos tudásbázisokká alakítja át az Microsoft Foundry portálon található ügynökök számára.
Ez a cikk a támogatott adatforrások adatbetöltését automatizáló indexelő létrehozásának alapvető lépéseit ismerteti. Az adatforrástól és a munkafolyamattól függően további konfigurációra lehet szükség.
Indexelővel automatizálhatja az adatok importálását és indexelését Azure AI Keresés. Az indexelő egy elnevezett objektum egy keresőszolgáltatásban, amely egy külső Azure adatforráshoz csatlakozik, beolvassa és szerializálja az adatokat, majd átadja azokat a keresőmotornak indexelés céljából. Az indexelők használata jelentősen csökkenti a támogatott adatforrásokhoz írandó kód mennyiségét és összetettségét.
Az indexelők két munkafolyamatot támogatnak:
Nyers tartalomindexelés (egyszerű szöveg vagy vektorok):Sztringek és metaadatok kinyerése szöveges tartalomból teljes szöveges keresési forgatókönyvekhez. A vektorkereséshez nyers vektortartalmat is kinyer (például vektorokat egy Azure SQL database vagy Azure Cosmos DB-gyűjteményben). Ebben a munkafolyamatban az indexelés csak az Ön által megadott meglévő tartalommal történik.
Képességalapú indexelés: Az indexelés kiterjesztése beépített vagy egyéni készségekkel, amelyek új kereshető tartalmakat hoznak létre. Hozzáadhat például integrált gépi tanulást képek és strukturálatlan szövegek elemzéséhez, szöveg és szerkezet kinyerésére vagy következtetésére. A készségekkel szövegből és képekből származó tartalmakat is átcsoportosíthat és vektorizálhat. A képességalapú indexelés olyan új tartalmakat hoz létre, amelyek nem léteznek a külső adatforrásban. Az új tartalom akkor válik az index részévé, amikor mezőket ad hozzá a bejövő adatokat elfogadó indexsémához. További információért lásd: MI gazdagítás az Azure AI Keresés-ben.
Prerequisites
Támogatott adatforrás , amely tartalmazza a betöltendő tartalmat.
Adatforrásdefiníció, amely külső adatokhoz való kapcsolatot állít be.
Keresési index , amely képes fogadni a bejövő adatokat.
A szolgáltatási szint maximális korlátja alatt kell lennie. Az ingyenes szint három objektumot tesz lehetővé minden típusból, és 1-3 perc indexelőfeldolgozást, illetve 3–10 percet, ha van hozzáértés.
Indexelő minták
Indexelő létrehozásakor a definíció két minta egyikét követi: a tartalomalapú indexelést vagy a képességalapú indexelést. A minták hasonlóak, de a képességalapú indexelés további tulajdonságokat is tartalmaz.
Indexelő példa tartalomalapú indexeléshez
A teljes szöveges vagy vektoros keresés tartalomalapú indexelése az indexelők elsődleges használati esete. Ebben a munkafolyamatban egy indexelő az alábbi példához hasonlóan néz ki.
{
  "name": (required) String that uniquely identifies the indexer,
  "description": (optional),
  "dataSourceName": (required) String indicating which existing data source to use,
  "targetIndexName": (required) String indicating which existing index to use,
  "parameters": {
    "batchSize": null,
    "maxFailedItems": 0,
    "maxFailedItemsPerBatch": 0,
    "base64EncodeKeys": false,
    "configuration": {}
  },
  "fieldMappings": (optional) unless field discrepancies need resolution,
  "disabled": null,
  "schedule": null,
  "encryptionKey": null
}
Az indexelőkre a következő követelmények vonatkoznak:
- Olyan
nametulajdonság, amely egyedileg azonosítja az indexelőt az indexelő gyűjteményében - Egy
dataSourceNameadatforrás-objektumra mutató tulajdonság. Külső adatokhoz való kapcsolatot ad meg - A
targetIndexNamecélkeresési indexre mutató tulajdonság
Más paraméterek nem kötelezőek, és módosíthatják a futtatókörnyezet viselkedését, például azt, hogy hány hibát kell elfogadni, mielőtt a teljes feladat meghiúsulna. A szükséges paraméterek minden indexelőben meg vannak adva, és a REST API-referencia dokumentálja.
A blobokhoz, SQL-hez és Azure Cosmos DB-hez készült adatforrás-specifikus indexelők további configuration paramétereket biztosítanak a forrásspecifikus viselkedésekhez. Ha például a forrás Blob Storage, beállíthat egy paramétert fájlkiterjesztés alapján történő szűrésre, például:
"parameters" : { "configuration" : { "indexedFileNameExtensions" : ".pdf,.docx" } }
Ha a forrás Azure SQL, beállíthatja a lekérdezés időtúllépési paraméterét.
A mezőleképezések a forrás–cél mezők explicit leképezésére szolgálnak, ha név vagy típus szerinti eltérés van az adatforrás és a keresési index egy mezője között.
Alapértelmezés szerint az indexelő azonnal fut, amikor létrehozza a keresőszolgáltatáson. Ha nem szeretné az indexelő végrehajtását, állítsa disabled igaz értékre az indexelő létrehozásakor.
Az indexelő definíciójának kiegészítő titkosításához ütemezést vagy titkosítási kulcsot is megadhat.
Indexelő példa a képességalapú indexeléshez
A képességalapú indexelés AI-bővítést használ a nyers formában nem kereshető tartalmak feldolgozásához. Az összes korábbi tulajdonság és paraméter érvényes, de a következő további tulajdonságok kifejezetten a MI-dúsításra vonatkoznak: skillsetName, cache, outputFieldMappings.
{
  "name": (required) String that uniquely identifies the indexer,
  "dataSourceName": (required) String, provides raw content that will be enriched,
  "targetIndexName": (required) String, name of an existing index,
  "skillsetName" : (required for AI enrichment) String, name of an existing skillset,
  "cache":  {
    "storageConnectionString" : (required if you enable the cache) Connection string to a blob container,
    "enableReprocessing": true
    },
  "parameters": { },
  "fieldMappings": (optional) Maps fields in the underlying data source to fields in an index,
  "outputFieldMappings" : (required) Maps skill outputs to fields in an index,
}
Az AI-bővítés a saját területe, és nem terjed ki erre a cikkre. További információkért kezdje az AI-bővítéssel, a Azure AI Keresés képességkészleteivel, a képességkészlet létrehozásával, a bővített kimeneti mezők leképezésével és az AI-bővítés gyorsítótárazásának engedélyezésével (előzetes verzió).
Külső adatok előkészítése
Az indexelők adatkészletekkel dolgoznak. Amikor indexelőt futtat, az csatlakozik az adatforráshoz, adatokat kér le a tárolóból vagy mappából, igény szerint szerializálja őket a JSON-ban, majd átadja a keresőmotornak indexelés céljából. Ez a szakasz a szöveges indexelés bejövő adatkövetelményét ismerteti.
| Forrásadatok | Tasks |
|---|---|
| JSON-dokumentumok | A JSON-dokumentumok tartalmazhatnak szöveget, számokat és vektorokat. Győződjön meg arról, hogy a bejövő adatok szerkezete vagy alakja megfelel a keresési index sémájának. A legtöbb keresési index meglehetősen lapos, ahol a mezőgyűjtemény azonos szintű mezőkből áll. A hierarchikus vagy beágyazott struktúrák azonban összetett mezőkön és gyűjteményeken keresztül is lehetségesek. |
| Relational | Adjon meg adatokat lapított sorkészletként, ahol minden sor teljes vagy részleges keresési dokumentum lesz az indexben. A relációs adatok sorkészletbe való összesimításához hozzon létre egy SQL-nézetet, vagy hozzon létre egy lekérdezést, amely szülő- és gyermekrekordokat ad vissza ugyanabban a sorban. A beépített szállodák mintaadatkészlete például egy SQL-adatbázis, amely 50 rekordot tartalmaz (minden szállodához egyet), amelyek egy kapcsolódó tábla helyiségrekordjaihoz vannak csatolva. Az a lekérdezés, amely a csoportos adatokat egy sorhalmazba alakítja, beágyazza az összes szobainformációt JSON-dokumentumokba minden szállodarekordba. A beágyazott helyiség adatait egy FOR JSON AUTO záradékot használó lekérdezés hozza létre. Erről a technikáról a beágyazott JSON-t visszaadó lekérdezések definiálása során tudhat meg többet. Ez csak egy példa; más módszereket is használhat, amelyek ugyanazt az eredményt eredményezik. |
| Files | Az indexelők általában minden fájlhoz létrehoznak egy keresési dokumentumot, ahol a keresési dokumentum tartalom- és metaadatok mezőiből áll. A fájl típusától függően az indexelő néha egy fájlt több keresési dokumentumba elemezhet. Egy CSV-fájlban például minden sor önálló keresési dokumentummá válhat. |
Ne feledje, hogy csak kereshető és szűrhető adatokat kell betöltenie:
- A kereshető adatok szöveg vagy vektorok
- A szűrhető adatok szöveg és számok (nem vektoros mezők)
Azure AI Keresés nem tud teljes szöveges keresést végezni bináris adatokon bármilyen formátumban, bár képes kinyerni és kikövetkeztetni a képfájlok szöveges leírását (lásd: AI-bővítés) a kereshető tartalom létrehozásához. Hasonlóképpen, a nagyméretű szövegeket természetes nyelvi modellek is lebonthatják és elemezhetik a szerkezet vagy a releváns információk megkereséséhez, és új tartalmakat hozhatnak létre, amelyeket hozzáadhat egy keresési dokumentumhoz. Vektorkeresést is végezhet beágyazásokon keresztül, beleértve a bináris formátumú kvantált beágyazásokat is.
Mivel az indexelők nem oldják meg az adatminőséggel kapcsolatos problémákat, előfordulhat, hogy külön adattisztítási vagy átalakítási lépésekre van szükség. További információt a Azure adatbázis termék dokumentációjában talál.
Adatforrás előkészítése
Az indexelőknek olyan adatforrásra van szükségük, amely meghatározza a típust, a tárolót és a kapcsolatot.
Győződjön meg arról, hogy támogatott adatforrástípust használ.
Adatforrásdefiníció létrehozása. A leggyakrabban használt források közül az alábbi adatforrások találhatók:
Ha az adatforrás egy adatbázis, például Azure SQL vagy Cosmos DB, engedélyezze a change tracking. Azure Storage beépített változáskövetési funkcióval rendelkezik a
LastModifiedtulajdonságon keresztül minden blob, fájl és táblázat esetében. A különböző adatforrások hivatkozásai ismertetik, hogy mely változáskövetési módszereket támogatják az indexelők.
Index előkészítése
Az indexelőknek keresési indexre is szükségük van. Ne feledje, hogy az indexelők adatokat adnak át a keresőmotornak indexelés céljából. Ahogyan az indexelők olyan tulajdonságokkal rendelkeznek, amelyek meghatározzák a végrehajtási viselkedést, az indexséma olyan tulajdonságokkal rendelkezik, amelyek jelentősen befolyásolják a sztringek indexelt állapotát (csak a sztringmezők elemzése és tokenizálása).
Első lépésként hozzon létre egy keresési indexet.
A mezők gyűjteményének és mezőattribútumainak beállítása.
A bejövő tartalom csak a mezőket célozza meg. A séma mezőattribútumaitól függően a rendszer minden mezőértéket elemez, tokenizál, vagy szó szerint tárol, különböző szűrők, homályos keresések és typeahead lekérdezések céljából.
Az indexelők automatikusan leképezik a forrásmezőket a célindexmezőkre, ha a nevek és a típusok egyenértékűek. Ha egy mezőt nem lehet implicit módon leképezni, ne feledje, hogy definiálhat egy explicit mezőleképezést , amely tájékoztatja az indexelőt a tartalom átirányításáról.
Tekintse át az elemző-hozzárendeléseket az egyes mezőkben. Az elemzők átalakíthatják a karakterláncokat. Így az indexelt sztringek eltérhetnek az átadott sztringektől. Az elemzők hatását a Szövegelemzés (REST) használatával értékelheti ki. Az elemzőkről további információt a szövegfeldolgozás elemzői című témakörben talál.
Az indexelés során az indexelők csak a mezőneveket és a típusokat ellenőrzik. Nincs olyan érvényesítési lépés, amely biztosíthatja, hogy a bejövő tartalom helyes legyen az index megfelelő keresőmezőjében.
Indexelő létrehozása
Amikor készen áll arra, hogy egy indexelőt hozzon létre egy távoli keresési szolgáltatáson, szüksége lesz egy keresési kliensre. A keresési ügyfél lehet a Azure portal, a REST-ügyfél vagy az indexelő ügyfelet példányosító alkalmazáskód. Javasoljuk a Azure portal vagy REST API-kat a korai fejlesztéshez és a megvalósíthatósági vizsgálathoz.
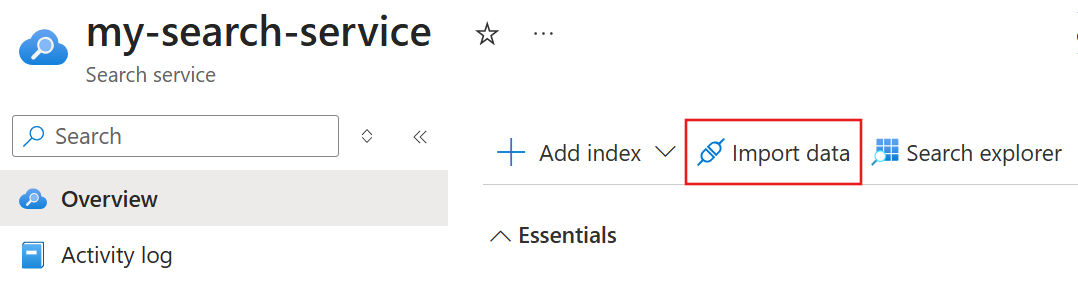
Nyissa meg a keresési szolgáltatást az Azure Portalon.
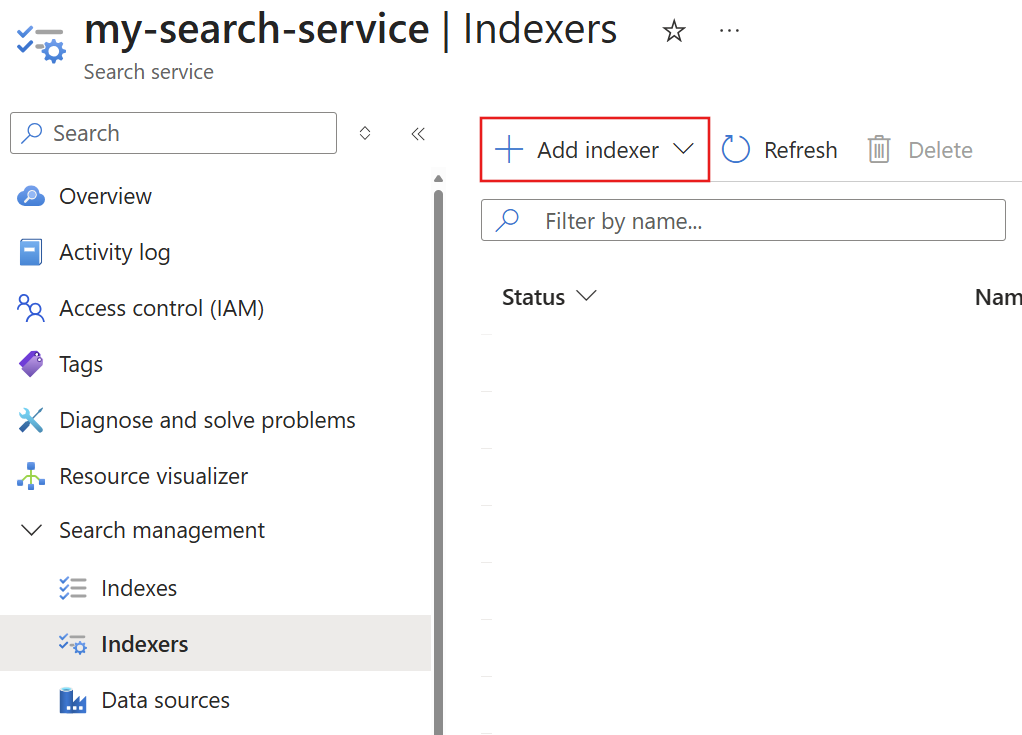
Válasszon az alábbi lehetőségek közül:
Adatok importálása: Ez a varázsló létrehozza az összes szükséges elemet, beleértve az indexelőt is. Más megközelítésekhez előre definiált adatforrásra és indexre van szükség.
Indexelő hozzáadása: Egy indexelő definíciójának megadására szolgáló vizualizációszerkesztő.
Az indexelő futtatása
Alapértelmezés szerint az indexelő azonnal fut, amikor létrehozza a keresőszolgáltatáson. Az indexelő definíciójában a disabled értéket igaz értékre állítva felülbírálhatja ezt a viselkedést. Az indexelő végrehajtása az igazság pillanata, ahol megtudhatja, hogy problémák merülnek-e fel a kapcsolatok, a mezőleképezések vagy a képességkészletek felépítésével kapcsolatban.
Az indexelők többféleképpen is futtathatók:
Futtatás az indexelő létrehozásakor vagy frissítésekor (alapértelmezett).
Indítsa el igény szerint, ha nincs módosítás a definícióban, vagy kezdje meg a teljes indexelést visszaállítással. További információ: Indexelők futtatása vagy alaphelyzetbe állítása.
Ütemezze az indexelő feldolgozását , hogy rendszeres időközönként meghívja a végrehajtást.
Az ütemezett végrehajtás általában akkor implementálódik, ha növekményes indexelésre van szüksége, hogy a legújabb módosításokat is átvehesse. Így az ütemezés függ a változásészlelésre.
Az indexelők azon kevés alrendszer egyike, amelyek kimenő hívásokat hajtanak végre más Azure erőforrások felé. Az Azure szerepkörök tekintetében az indexelők nem rendelkeznek különálló identitásokkal; a keresőmotor és egy másik Azure erőforrás közötti kapcsolat a rendszer vagy a felhasználó által hozzárendelt felügyelt identitás használatával jön létre egy keresőszolgáltatás. Ha az indexelő egy virtuális hálózaton keresztül csatlakozik egy Azure-erőforráshoz, létre kell hoznia egy megosztott privát kapcsolatot ehhez a kapcsolathoz. További információ: Biztonságos hozzáférés külső adatokhoz.
Eredmények ellenőrzése
Az indexelő állapotának monitorozása a végrehajtás állapotának ellenőrzéséhez. A sikeres végrehajtás továbbra is tartalmazhat figyelmeztetéseket és értesítéseket. Győződjön meg arról, hogy a feladat részleteiért ellenőrizze a sikeres és a sikertelen állapotértesítéseket is.
Tartalom-ellenőrzéshez futtasson lekérdezéseket a kitöltött indexen, amely teljes dokumentumokat vagy kijelölt mezőket ad vissza.
Változás észlelés és belső állapot
Ha az adatforrás támogatja a változásészlelést, az indexelő képes észlelni az adatok mögöttes változásait, és csak az egyes indexelők új vagy frissített dokumentumait dolgozza fel, változatlan tartalmat hagyva. Ha az indexelőzmények szerint a futtatás sikeres volt a 0/0-s dokumentumok feldolgozásával, az azt jelenti, hogy az indexelő nem talált új vagy módosított sorokat vagy blobokat a mögöttes adatforrásban.
A változásészlelési logika be van építve az adatplatformokba. Hogy az indexelő hogyan támogatja a változásészlelést, az adatforrásonként eltérő:
Azure Storage beépített változásészleléssel rendelkezik, ami azt jelenti, hogy az indexelők automatikusan felismerhetik az új és frissített dokumentumokat. Blob Storage, Azure Table Storage és Azure Data Lake Storage Gen2 minden blob- vagy sorfrissítést dátummal és időponttal lát el. Az indexelők automatikusan ezt az információt használják annak meghatározására, hogy mely dokumentumok frissüljenek az indexben. További információ a törlésészlelésről az alábbi oldalon található: Változás- és törlésészlelés indexelők használatával az Azure Storage-ben.
A felhőalapú adatbázis-szolgáltatások opcionális változásészlelési funkciókat biztosítanak. Ezen adatforrások esetében a változásészlelés nem automatikus. Az adatforrás definíciójában meg kell adnia, hogy melyik szabályzatot használja:
Az indexelők egy belső küszöbérték segítségével követik nyomon az utolsó dokumentumot, amelyet az adatforrásból feldolgoztak. A jelölő soha nem jelenik meg az API-ban, de belsőleg az indexelő nyomon követi, hogy hol állt le. Amikor az indexelés folytatódik, akár ütemezett futtatás, akár igény szerinti meghívás útján, az indexelő a magas vízjelre hivatkozik, hogy ott folytassa, ahol abbahagyta.
Ha törölnie kell a csúcspontot a teljes újraindexeléshez, használhatja a Indexelő visszaállítása lehetőséget. A szelektívebb újraindexeléshez használja az Alaphelyzetbe állítási készségeket vagy a Dokumentumok alaphelyzetbe állítását. Az alaphelyzetbe állítási API-k segítségével törölheti a belső állapotot, és kiürítheti a gyorsítótárat is, ha engedélyezte a növekményes bővítést. Az egyes visszaállítási beállítások hátteréről és összehasonlításáról további információt az indexelők, a készségek és a dokumentumok futtatása vagy alaphelyzetbe állítása című témakörben talál.