Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Note
Azure AI Keresés a Azure portálon, REST API-kon és Azure SDK-k keresztül érhető el. Emellett a Foundry IQ-t is támogatja, amely a vállalati tartalmakat újrafelhasználható, engedélytudatos tudásbázisokká alakítja át az Microsoft Foundry portálon található ügynökök számára.
Ez a cikk olyan fejlesztőknek szól, akiknek mélyebb ismeretekre van szükségük a képességkészletek összetételéről, és feltételezik, hogy ismerik az AI-bővítés magas szintű fogalmait, illetve azt, hogy hogyan alkalmazzák az AI-t az Azure AI Keresésben a nyers tartalom indexelés közbeni átalakításához.
A készségkészlet egy újrahasználható objektum az Azure AI Keresésben, amely egy indexelőhöz van csatolva. Egy vagy több olyan készséget tartalmaz, amely beépített AI-t vagy külső egyéni feldolgozást hív meg külső adatforrásból lekért nyers tartalomon keresztül.
Az alábbi ábra a készségkészletek végrehajtásának alapszintű adatfolyamát mutatja be.
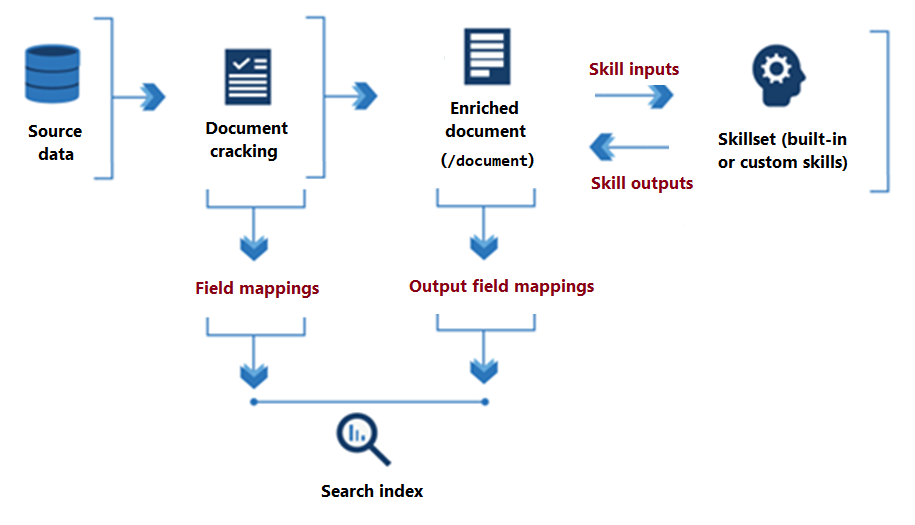
A készségkészlet feldolgozásának kezdetétől a végéig a készségek olvasnak és írnak a memóriában lévő *gazdagított dokumentumfára. A bővített dokumentum kezdetben csak az adatforrásból kinyert nyers tartalom (a "/document" gyökér csomópontként van tagolva). Az egyes képességek végrehajtásával a bővített dokumentum struktúrát és anyagot nyer, mivel minden képesség csomópontként írja a kimenetét a gráfban.
A képességkészlet végrehajtása után a bővített dokumentum kimenete a felhasználó által definiált kimeneti mezőleképezéseken keresztül egy indexhez lesz irányítva. A nyers tartalom, amelyet változtatások nélkül akarunk átvinni a forrásból az indexbe, a mezőleképezésen keresztül határozódik meg. Ezzel szemben a kimeneti mezőleképezések memórián belüli tartalmat (csomópontokat) adnak át az indexhez.
Az alkalmazott AI konfigurálásához adjon meg beállításokat egy képességkészletben és egy indexelőben.
Képességkészlet definíciója
A képességkészlet egy vagy több olyan képesség tömbje, amely bővítést végez, például szöveg fordítása vagy optikai karakterfelismerés (OCR) egy képfájlon. A készségek lehetnek a Microsoft beépített készségei , vagy egyéni képességek a külsőleg üzemeltetett logika feldolgozásához. A képességkészletek olyan bővített dokumentumokat állítanak elő, amelyeket az indexelés során használnak fel, vagy egy tudástárba vetítik.
A készségek környezettel, bemenetekkel és kimenetekkel rendelkeznek:
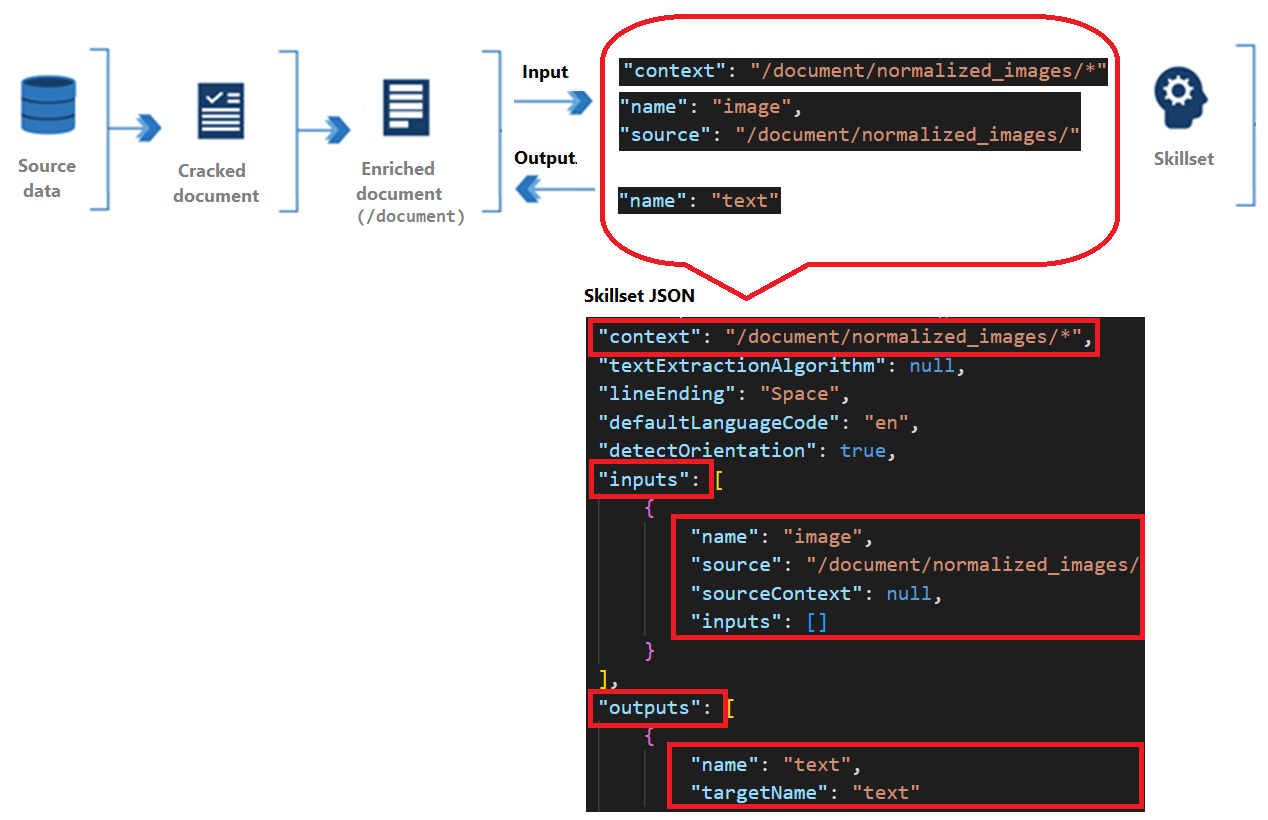
A környezet a művelet hatókörére hivatkozik, amely dokumentumonként egyszer vagy egy gyűjtemény minden egyes eleméhez lehet.
A bemenetek egy bővített dokumentum csomópontjaiból származnak, ahol a "forrás" és a "név" azonosít egy adott csomópontot.
A rendszer a kimenetet új csomópontként küldi vissza a bővített dokumentumba. Az értékek a csomópont "neve" és a csomópont tartalma. Ha egy csomópont neve duplikálva van, megadhatja a célnevet a egyértelműsítéshez.
Jártassági kontextus
Minden képesség rendelkezik egy környezettel, amely lehet a teljes dokumentum (/document) vagy a fa (/document/countries/*) alsó csomópontja.
A környezet a következőt határozza meg:
A képesség végrehajtásának száma egyetlen értéken (mezőnként egyszer, dokumentumonként egyszer) vagy egy gyűjtemény esetén, ahol a gyűjtemény minden példányához egy
/*hozzáadása képesség-meghívást eredményez.Kimeneti deklaráció, vagy hogy hol a bővítési fában adódnak hozzá a képességkimenetek. A kimenetek mindig a környezeti csomópont gyermekeiként lesznek hozzáadva a fához.
A bemenetek alakja. Többszintű gyűjtemények esetén a környezet szülőgyűjteményre való beállítása befolyásolja a képesség bemenetének alakját. Ha például rendelkezik egy gazdagítófával, amely tartalmazza az országok/régiók listáját, és mindegyik az irányítószámokat tartalmazó államok listájával van kiegészítve, a környezet beállítása határozza meg a bemenet értelmezését.
Context Input Bemenet alakzata Képesség aktiválása /document/countries/*/document/countries/*/states/*/zipcodes/*Az ország/régió összes irányítószámának listája Országonként/régiónként egyszer /document/countries/*/states/*/document/countries/*/states/*/zipcodes/*Az állam irányítószámainak listája Ország/régió és állam kombinációnként egyszer
Képességfüggőségek
A képességek egymástól függetlenül és párhuzamosan, vagy egymás után hajthatók végre függő kapcsolatban, ha az egyik képesség kimenetét beilleszti egy másik képességbe. Az alábbi példa két beépített készséget mutat be, amelyek egymás után futnak:
Az 1. képesség egy szövegfelosztási képesség , amely bemenetként elfogadja a "reviews_text" forrásmező tartalmát, és kimenetként 5000 karakterből álló "oldalakra" osztja fel a tartalmat. A nagy szöveg kisebb adattömbökre való felosztása jobb eredményeket hozhat az olyan készségek számára, mint a hangulatészlelés.
A 2. képesség egy hangulatfelismerési képesség , amely a felosztott képesség kimenetétől függ. Bemenetként elfogadja a "pages" értéket, és létrehoz egy "Sentiment" nevű új mezőt kimenetként, amely tartalmazza a hangulatelemzés eredményeit.
Figyelje meg, hogyan használható az első képesség ("oldalak") kimenete a hangulatelemzés során, ahol a "/document/reviews_text/pages/*" mind a kontextus, mind a bemenet. Az elérési út kialakításával kapcsolatos további információkért tekintse meg a dúsítások hivatkozását ismertető témakört.
{
    "skills": [
        {
            "@odata.type": "#Microsoft.Skills.Text.SplitSkill",
            "name": "#1",
            "description": null,
            "context": "/document/reviews_text",
            "defaultLanguageCode": "en",
            "textSplitMode": "pages",
            "maximumPageLength": 5000,
            "inputs": [
                {
                    "name": "text",
                    "source": "/document/reviews_text"
                }
            ],
            "outputs": [
                {
                    "name": "textItems",
                    "targetName": "pages"
                }
            ]
        },
        {
            "@odata.type": "#Microsoft.Skills.Text.SentimentSkill",
            "name": "#2",
            "description": null,
            "context": "/document/reviews_text/pages/*",
            "defaultLanguageCode": "en",
            "inputs": [
                {
                    "name": "text",
                    "source": "/document/reviews_text/pages/*",
                }
            ],
            "outputs": [
                {
                    "name": "sentiment",
                    "targetName": "sentiment"
                },
                {
                    "name": "confidenceScores",
                    "targetName": "confidenceScores"
                },
                {
                    "name": "sentences",
                    "targetName": "sentences"
                }
            ]
        }
      . . .
  ]
}
Dúsítási fa
A bővített dokumentum egy ideiglenes, faszerű adatstruktúra, amely a képességkészlet végrehajtása során jön létre, amely összegyűjti a készségeken keresztül bevezetett összes módosítást. A bővítések együttesen a címezhető csomópontok hierarchiájaként jelennek meg. A csomópontok tartalmazzák a külső adatforrásból szó szerint átadott nem gazdagított mezőket is. A bővítési fa szerkezetének és tartalmának vizsgálatához a legjobb módszer egy hibakeresési munkameneten keresztül az Azure Portalon.
Egy bővített dokumentum a képességkészlet végrehajtásának időtartamára létezik, de gyorsítótárazható (előzetes verzió), vagy elküldhető egy tudástárba.
Kezdetben a bővített dokumentum egyszerűen az adatforrásból kinyert tartalom a dokumentum feltörésekor, ahol a szöveg és a képek kinyerése a forrásból történik, és nyelvi vagy képelemzési célokra elérhetővé válik.
A kezdeti tartalom a metaadatok és a gyökércsomópont (document/content). A gyökércsomópont általában egy teljes dokumentum vagy egy normalizált rendszerkép, amelyet egy adatforrásból nyernek ki a dokumentum feltörése során. Az adattartalom-bővítő fa felépítése az egyes adatforrástípusoktól függően változik. Az alábbi táblázat egy dokumentum állapotát mutatja be, amely több támogatott adatforrás esetében belép a bővítési folyamatba:
| Adatforrás\Elemzési mód | Default | JSON, JSON Lines és CSV |
|---|---|---|
| Blob Storage | /document/content /document/normalized_images/* … |
/document/{key1} /document/{key2} … |
| Azure SQL | /document/{column1} /document/{column2} … |
N/A |
| Azure Cosmos DB | /document/{key1} /document/{key2} … |
N/A |
A képességek végrehajtásakor a kimenet új csomópontokként lesz hozzáadva a bővítési fához. Ha a szakértelem végrehajtása a teljes dokumentumra vonatkozik, a gyökér alatti első szinten adódnak hozzá a csomópontok.
A csomópontok bemenetként használhatók az alsóbb rétegbeli készségekhez. A tartalmat létrehozó képességek, például a lefordított sztringek például olyan képességek bemenetévé válhatnak, amelyek entitásokat ismernek fel vagy kulcskifejezéseket nyernek ki.
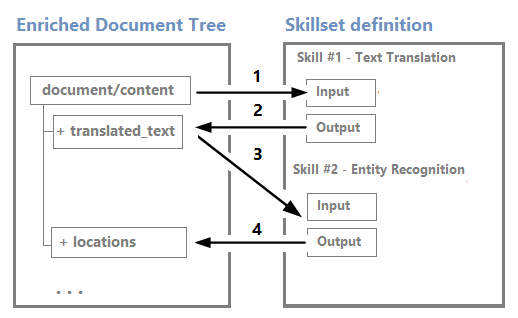
Bár a Debug Sessions vizualizációszerkesztőjével vizualizálhat és dolgozhat egy bővítőfával, ez többnyire egy belső struktúra.
A bővítés nem módosítható: a létrehozás után a csomópontok nem szerkeszthetők. Ahogy a képességkészletek egyre összetettebbek lesznek, a bővítési fa is, de a bővítési fa összes csomópontjának nem kell az indexbe vagy a tudástárba eljutnia.
A bővítési kimenetek csak egy részhalmazát őrizheti meg szelektíven, hogy csak a használni kívánt elemeket tartsa meg. Az indexelő definíciójában szereplő kimeneti mezőleképezések határozzák meg, hogy valójában milyen tartalmak kerülnek be a keresési indexbe. Hasonlóképpen, ha egy tudástárat hoz létre, a kimeneteket kivetítésekhez rendelt alakzatokra is leképezheti.
Note
A bővítési fa formátuma lehetővé teszi, hogy a bővítési folyamat metaadatokat csatoljon még a primitív adattípusokhoz is. A metaadatok nem lesznek érvényes JSON-objektumok, de érvényes JSON-formátumba vethetők a tudástárban lévő leképezési definíciókban. További információ: Shaper skill.
Indexelő definíciója
Az indexelők tulajdonságai és paraméterei az indexelő végrehajtásának konfigurálására szolgálnak. Ilyen tulajdonságok közé tartoznak azok a leképezések, amelyek az adatelérési utat egy keresési index mezőire állítják be.
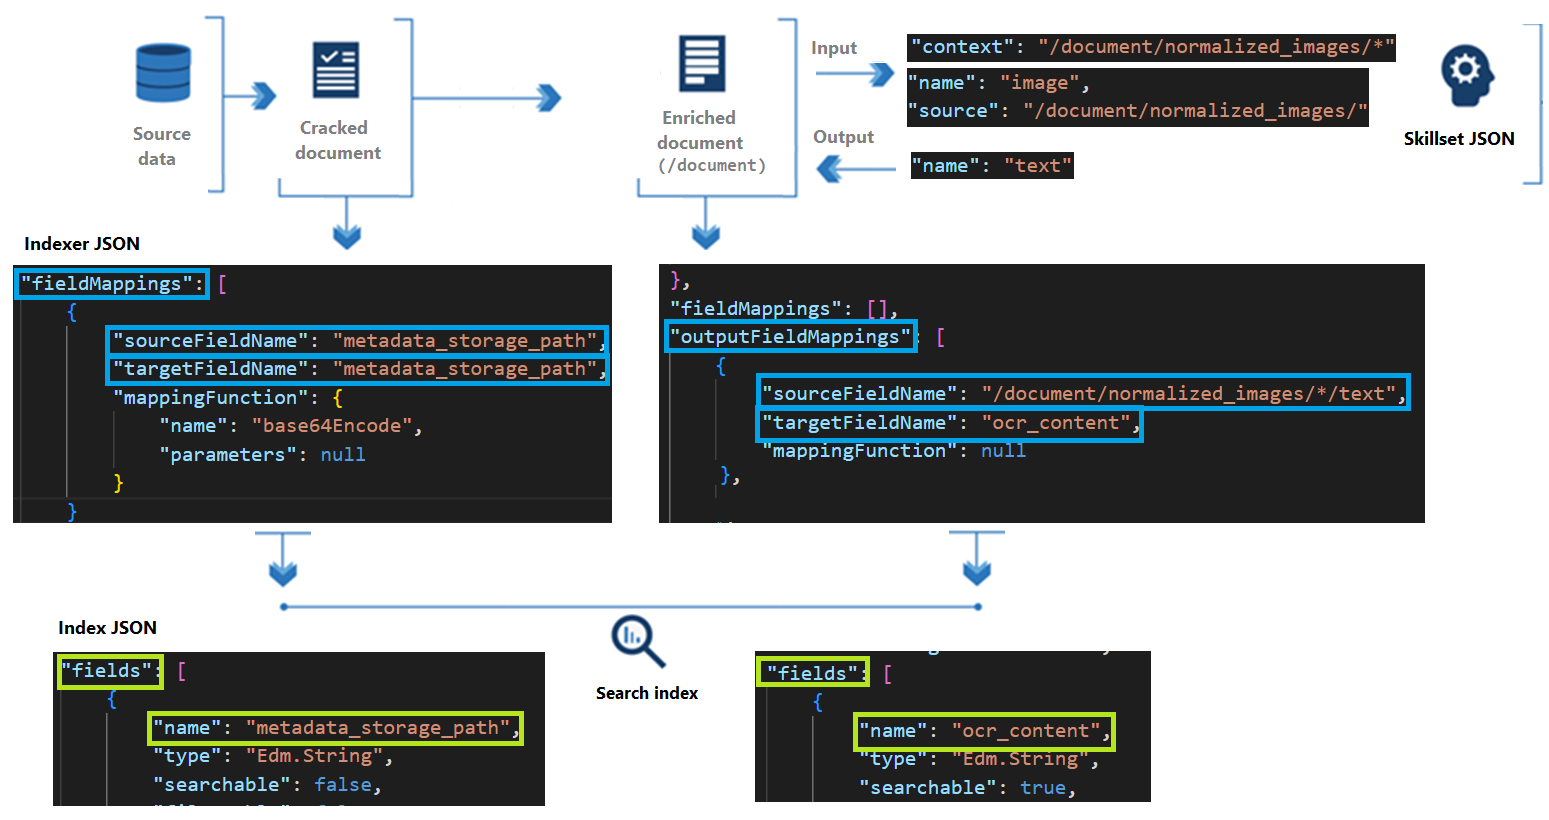
Két leképezési csoport létezik:
A "fieldMappings" egy forrásmezőt egy keresőmezőbe képez le.
Az "outputFieldMappings" egy bővített dokumentum csomópontját egy keresőmezőbe rendeli.
A "sourceFieldName" tulajdonság egy mezőt határoz meg az adatforrásban, vagy egy csomópontot egy bővítőfán. A "targetFieldName" tulajdonság a tartalmat fogadó index keresési mezőjét adja meg.
Dúsítási példa
A szállodai értékelések készségkészletét referenciapontként használva ez a példa bemutatja, hogyan fejlődik egy fejlesztési fa a készségek végrehajtása során, fogalmi diagramok segítségével.
Ez a példa a következőket is mutatja:
- A képesség környezetének és bemeneteinek működése annak meghatározásához, hogy egy képesség hányszor hajt végre
- A bemenet formája a környezeten alapul
Ebben a példában egy CSV-fájl forrásmezői közé tartoznak a szállodákra ("reviews_text") és a minősítésekre ("reviews_rating") vonatkozó ügyfélértékelések. Az indexelő metaadatmezőket ad hozzá a Blob Storage-ból, a készségek pedig lefordított szöveget, hangulatpontszámokat és kulcskifejezés-észlelést adnak hozzá.
A szállodaértékelési példában a bővítési folyamat "dokumentuma" egyetlen szállodai felülvizsgálatot jelöl.
Tip
Rest API-k használatával létrehozhat keresési indexet és tudástárat ezekhez az adatokhoz. A Hibakeresési munkamenetek segítségével betekintést nyerhet a képességkészletek összetételébe, függőségeibe és a bővítési fára gyakorolt hatásokba. A cikkben szereplő képek a hibakeresési munkamenetekből származnak.
Elméletileg a kezdeti bővítési fa a következőképpen néz ki:
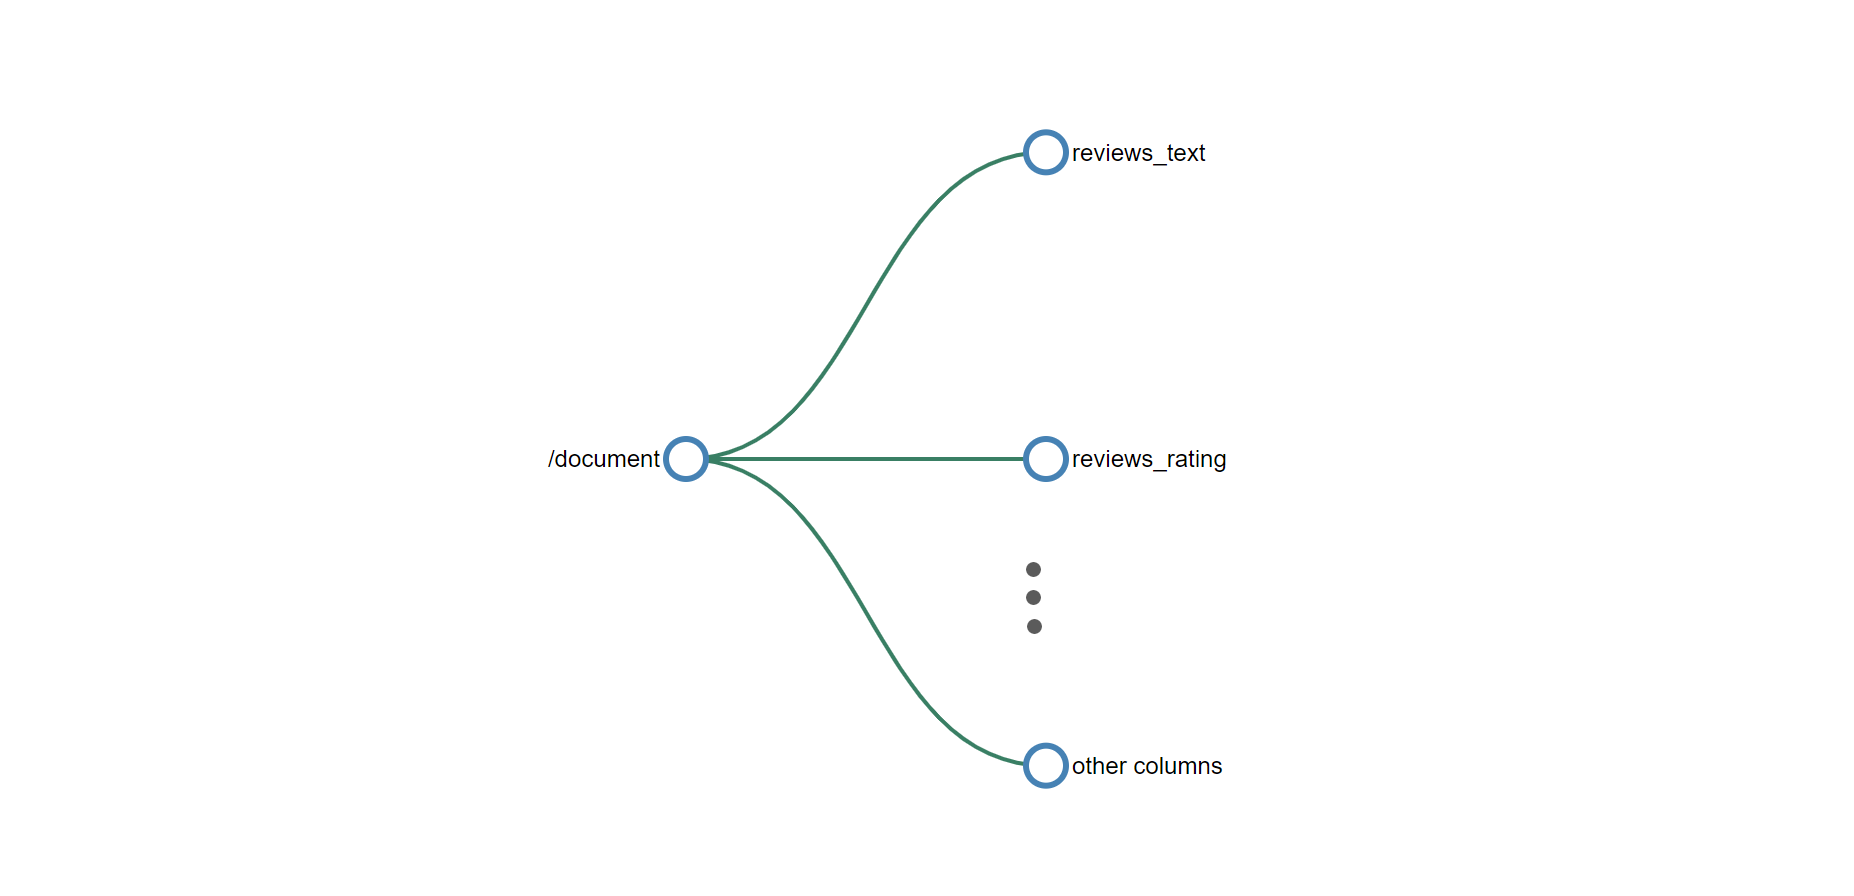
Az összes bővítés gyökércsomópontja a "/document". Amikor blobindexelőkkel dolgozik, a "/document" csomópont gyermekcsomópontjai "/document/content" és "/document/normalized_images". Ha az adatok CSV-nek minősülnek, mint ebben a példában, az oszlopnevek az alatta lévő "/document"csomópontokra lesznek leképezve.
1. képesség: Megosztott képesség
Ha a forrástartalom nagy mennyiségű szövegből áll, hasznos lehet kisebb összetevőkre bontani az integrált vektorizáláshoz, illetve a nyelv, a hangulat és a kulcskifejezések észlelésének nagyobb pontossága érdekében. Két szemcse érhető el: oldalak és mondatok. Egy oldal körülbelül 5000 karakterből áll.
A felosztási képességekkel végzett adattömbözés alternatívát a Azure Tartalomértés képességen keresztül lehet elvégezni, de ez a képesség nem tartozik a jelen cikk hatókörébe.
Ha a tartalom feldarabolása szükséges, a felosztási funkció jellemzően az első egy készségkészletben.
"@odata.type": "#Microsoft.Skills.Text.SplitSkill",
"name": "#1",
"description": null,
"context": "/document/reviews_text",
"defaultLanguageCode": "en",
"textSplitMode": "pages",
"maximumPageLength": 5000,
"inputs": [
    {
        "name": "text",
        "source": "/document/reviews_text"
    }
],
"outputs": [
    {
        "name": "textItems",
        "targetName": "pages"
    }
]
A képességkörnyezet "/document/reviews_text" esetén a felosztott képesség egyszer hajtódik végre a reviews_text. A képességkimenet egy lista, ahol a reviews_text rendszer 5000 karakterszegmensre bontja azokat. A felosztási képesség kimenete el van nevezve pages , és hozzá lesz adva a bővítési fához. A targetName funkció lehetővé teszi, hogy átnevezze a képességkimenetet, mielőtt hozzáadja őket a bővítőfához.
A bővítési fa most egy új csomópontot helyez el a képesség kontextusában. Ez a csomópont bármely képesség-, kivetítési vagy kimeneti mezőleképezéshez elérhető.
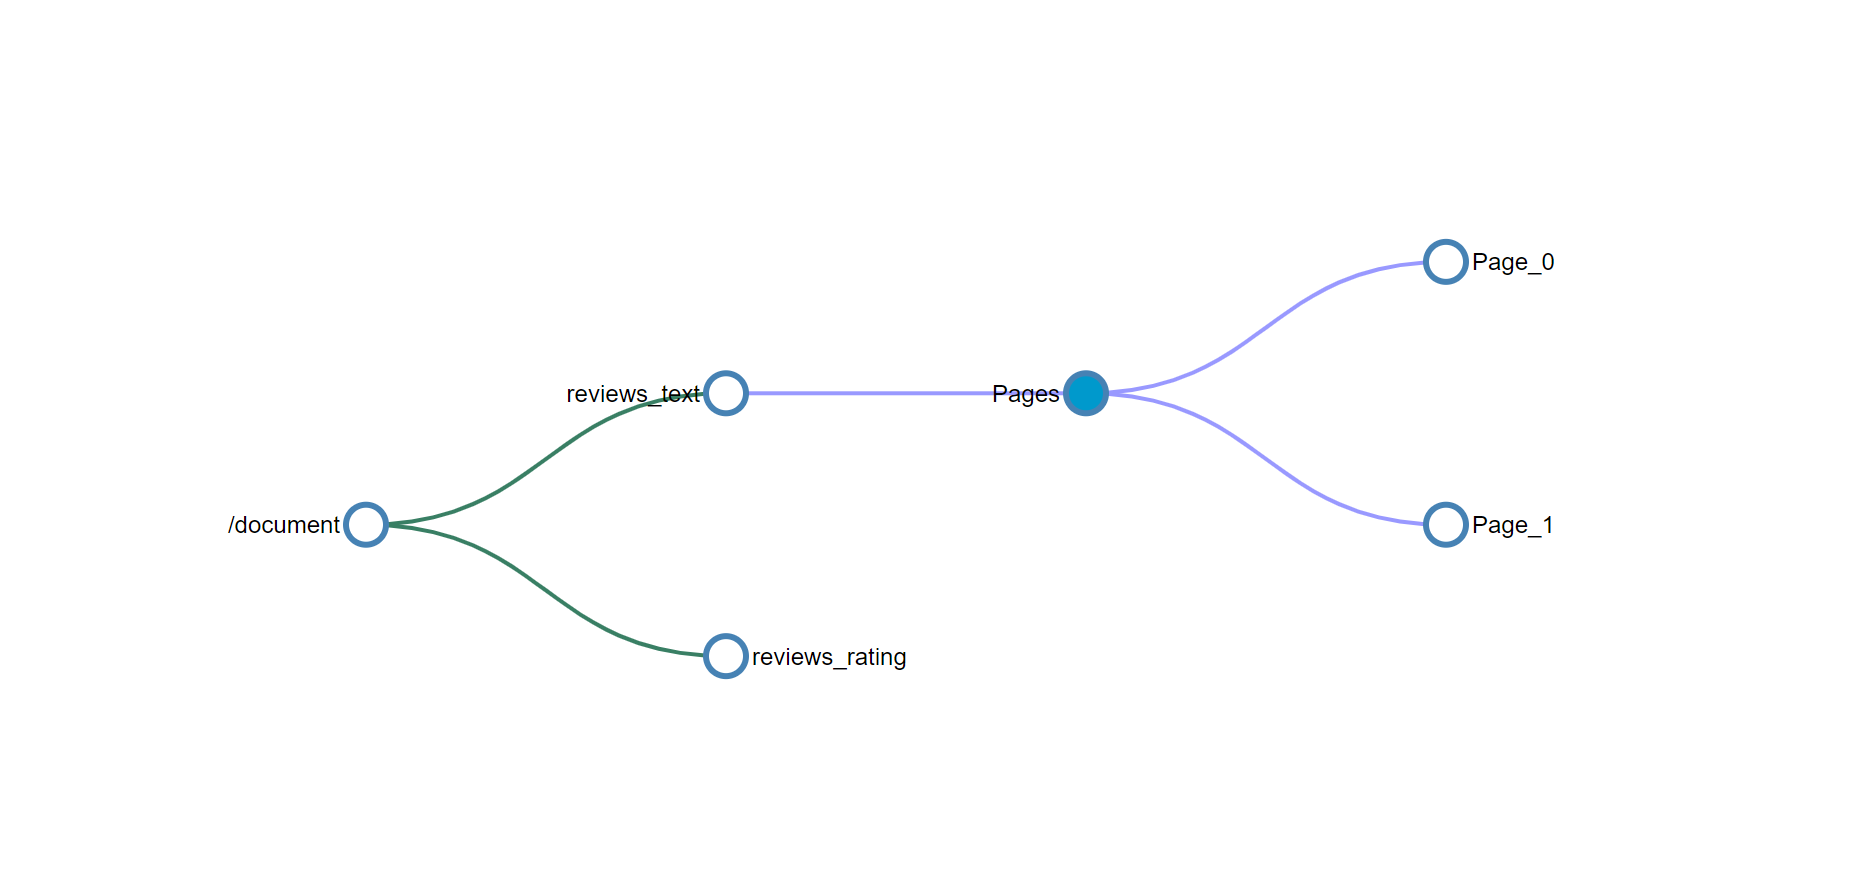
Ahhoz, hogy a csomóponthoz egy adott képesség által hozzáadott összes bővítés elérhető legyen, a gazdagítás teljes útvonalára van szükség. Ha például az pages elem szövegét szeretné használni egy másik funkció bemeneteként, adja meg azt "/document/reviews_text/pages/*". Az elérési utakról további információt a Referencia-bővítések című témakörben talál.
Skill #2 Nyelvfelismerés
A szálloda felülvizsgálati dokumentumai több nyelven kifejezett ügyfél-visszajelzést tartalmaznak. A nyelvfelismerési képesség határozza meg, hogy melyik nyelvet használják. Ezt követően a rendszer átadja az eredményt a kulcskifejezések kinyerésének és a hangulatészlelésnek (nem jelenik meg), figyelembe véve a nyelvet a hangulatok és kifejezések észlelésekor.
Bár a nyelvfelismerő készség a készségkészlet harmadik (készség #3) elemeként van definiálva, ez a következő végrehajtandó készség. Nincs szükség bemenetre, így az az előző szakértelemmel párhuzamosan fut. Az azt megelőző felosztási képességhez hasonlóan a nyelvfelismerési készség is egyszer lesz meghívva minden dokumentumhoz. A bővítőfának most egy új csomópontja van a nyelvhez.
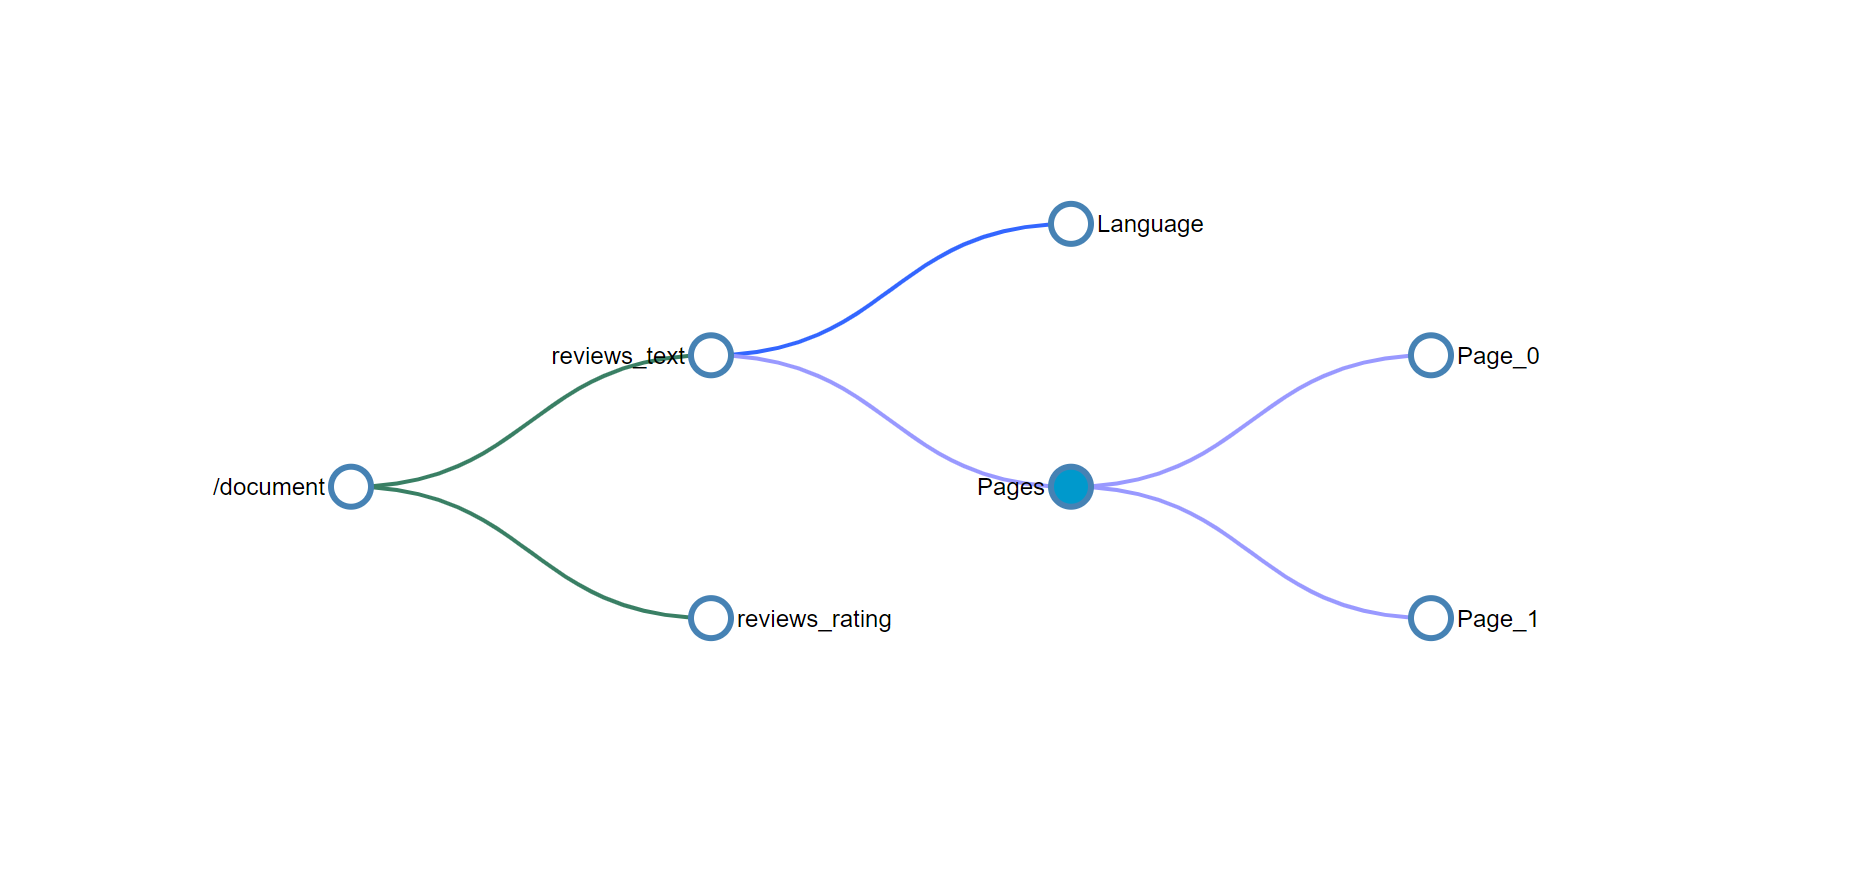
Készségek #3 és #4 (hangulatelemzés és kulcskifejezés-észlelés)
Az ügyfelek visszajelzései számos pozitív és negatív élményt tükröznek. A hangulatelemzési képesség elemzi a visszajelzést, és egy pontszámot rendel hozzá, amely a negatív és pozitív számok között mozog, vagy semleges, ha a hangulat meghatározatlan. A hangulatelemzéssel párhuzamosan a kulcskifejezések észlelése azonosítja és kinyeri a következményként megjelenő szavakat és rövid kifejezéseket.
A hangulatelemzés és a kulcskifejezés-képességek kontextusát /document/reviews_text/pages/*figyelembe véve a rendszer egyszer meghívja a pages gyűjtemény minden elemét. A képesség kimenete egy csomópont lesz a társított oldalelem alatt.
Most már képesnek kell lennie arra, hogy megtekintse a készségkészlet többi szakértelmét, és vizualizálja, hogyan nő a bővítési fa az egyes képességek végrehajtásával. Egyes készségek, például az egyesítési képesség és az alakzatkészítő képesség is létrehoznak új csomópontokat, de csak a meglévő csomópontokból származó adatokat használják, és nem hoznak létre nettó új bővítéseket.
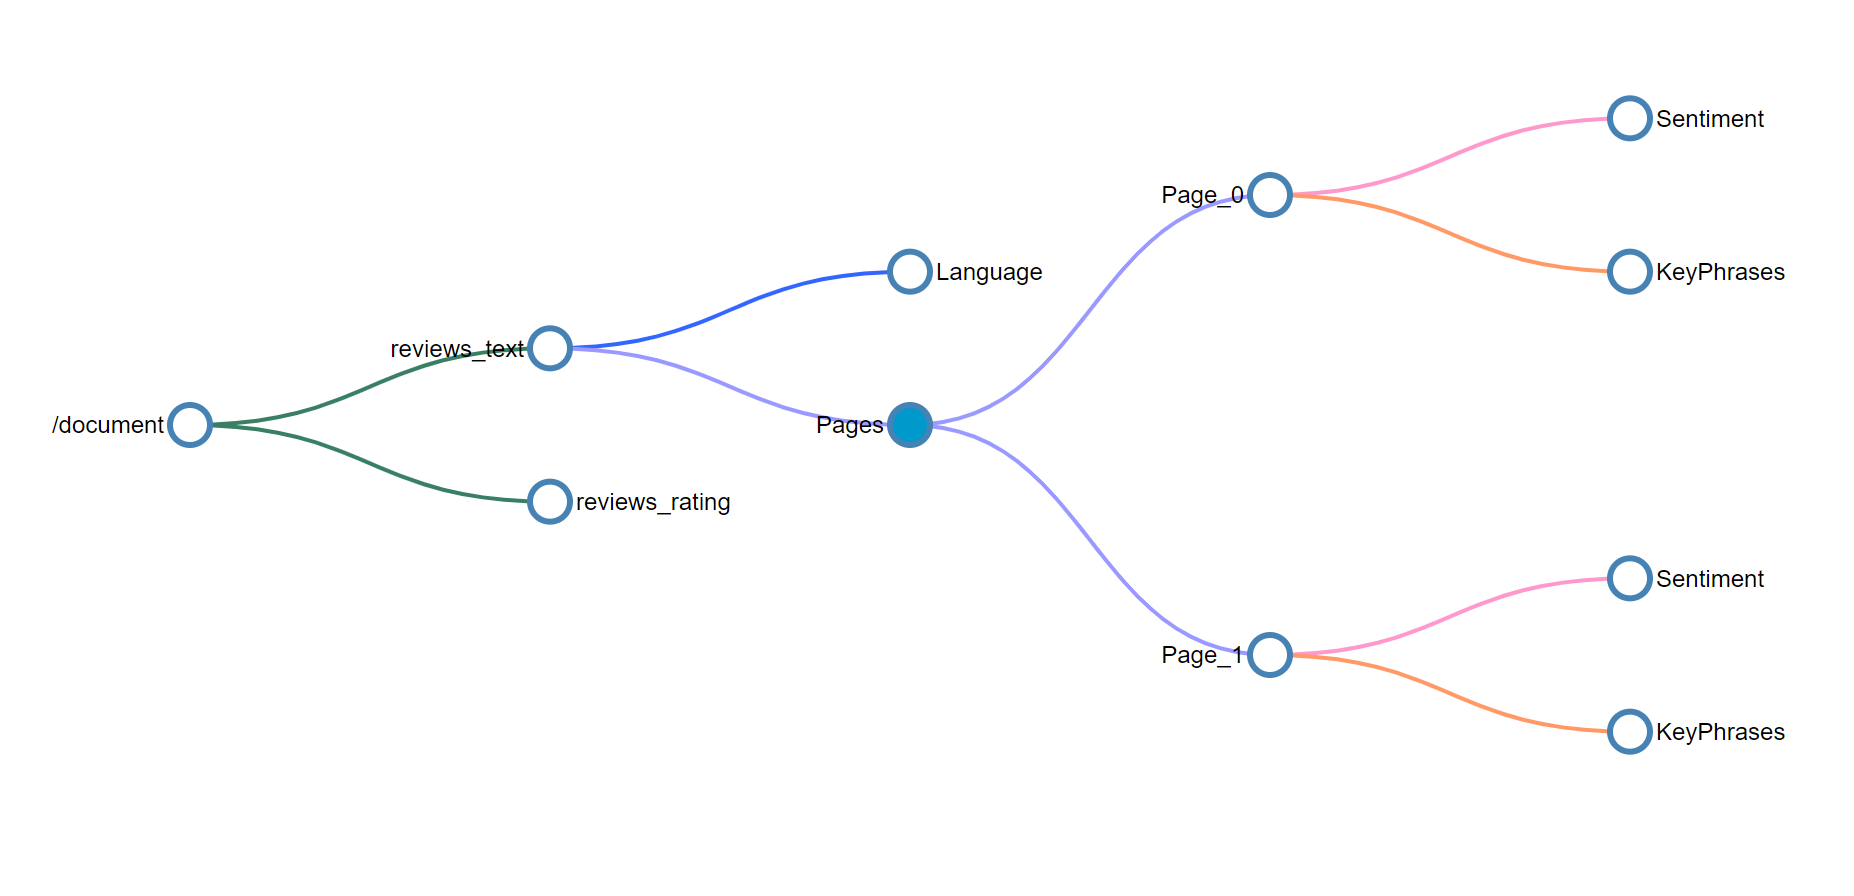
A fenti fa összekötőinek színei azt jelzik, hogy a bővítéseket különböző képességek hozták létre, és a csomópontokat egyenként kell kezelni, és nem lesznek részei a szülőcsomópont kiválasztásakor visszaadott objektumnak.
#5-ös Készség Formáló Készség
Ha a kimenet tartalmaz egy tudástárat, adjon hozzá egy Shaper-készséget utolsó lépésként. Az Alakzatkezelő képesség adatalakzatokat hoz létre a csomópontok közül egy bővítőfán. Előfordulhat például, hogy több csomópontot szeretne egyetlen alakzatba egyesíteni. Ezután táblázatként vetítheti ki ezt az alakzatot (a csomópontok egy tábla oszlopaivá válnak), és név szerint átadják az alakzatot egy táblázatvetítésnek.
A Shaper-képesség könnyen használható, mert egy képesség alatt való alakításra összpontosít. Alternatív megoldásként választhatja az egyes vetítéseken belüli beépített formázást is. A Shaper-képesség nem ad hozzá vagy von le a gazdagítási fából, ezért nincs ábrázolva. Ehelyett egy Shaper képességre úgy gondolhat, mint azokra a módokra, amelyekkel újratervezheti a már meglévő gazdagítási fát. Ez elméletileg hasonló ahhoz, mint amikor egy adatbázis tábláiból hoz létre nézeteket.
{
  "@odata.type": "#Microsoft.Skills.Util.ShaperSkill",
  "name": "#5",
  "description": null,
  "context": "/document",
  "inputs": [
    {
      "name": "name",
      "source": "/document/name"
    },
    {
      "name": "reviews_date",
      "source": "/document/reviews_date"
    },
    {
      "name": "reviews_rating",
      "source": "/document/reviews_rating"
    },
    {
      "name": "reviews_text",
      "source": "/document/reviews_text"
    },
    {
      "name": "reviews_title",
      "source": "/document/reviews_title"
    },
    {
      "name": "AzureSearch_DocumentKey",
      "source": "/document/AzureSearch_DocumentKey"
    },
    {
      "name": "pages",
      "sourceContext": "/document/reviews_text/pages/*",
      "inputs": [
        {
          "name": "Sentiment",
          "source": "/document/reviews_text/pages/*/Sentiment"
        },
        {
          "name": "LanguageCode",
          "source": "/document/Language"
        },
        {
          "name": "Page",
          "source": "/document/reviews_text/pages/*"
        },
        {
          "name": "keyphrase",
          "sourceContext": "/document/reviews_text/pages/*/Keyphrases/*",
          "inputs": [
            {
              "name": "Keyphrases",
              "source": "/document/reviews_text/pages/*/Keyphrases/*"
            }
          ]
        }
      ]
    }
  ],
  "outputs": [
    {
      "name": "output",
      "targetName": "tableprojection"
    }
  ]
}
Következő lépések
Miután megismerkedett a bevezetővel és a példával, próbálja meg létrehozni az első készségkészletét a beépített készségek használatával.