Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Note
Azure AI Keresés a Azure portálon, REST API-kon és Azure SDK-k keresztül érhető el. Emellett a Foundry IQ-t is támogatja, amely a vállalati tartalmakat újrafelhasználható, engedélytudatos tudásbázisokká alakítja át az Microsoft Foundry portálon található ügynökök számára.
A képességkészlet végrehajtása során a motor létrehoz egy memóriabeli dúsítási fát , amely rögzíti az egyes bővítéseket, például felismert entitásokat vagy lefordított szöveget. Ebből a cikkből megtudhatja, hogyan hivatkozhat a gazdagítási fában található bővítési csomópontra, hogy átadhassa a kimenetet az alsóbb rétegbeli készségeknek, vagy megadhat egy kimeneti mezőleképezést egy keresési indexmezőhöz.
Ez a cikk példákkal szemlélteti a különböző forgatókönyveket. A teljes szintaxist a Szakértelem környezete és a beviteli széljegyzet nyelve című témakörben tekintheti meg.
Háttérfogalmak
Mielőtt áttekintené a szintaxist, tekintsünk át néhány fontos fogalmat a cikk későbbi részében bemutatott példák jobb megértéséhez.
| Időszak | Leírás |
|---|---|
| "bővített dokumentum" | A bővített dokumentum egy memórián belüli struktúra, amely összegyűjti a képességkimenetet a létrehozásakor, és a dokumentumhoz kapcsolódó összes bővítést tartalmazza. Gondoljon egy bővített dokumentumra, mint egy fára. A fa általában a gyökérdokumentum szintjén kezdődik, és minden új gazdagítás vagy kiterjesztés egy korábbi csomópont gyermekeként jön létre. |
| csomópont | A bővített dokumentumokban a csomópontok (más néven "széljegyzetek") olyan konkrét kimenetek, mint például az OCR-képesség "text" vagy "layoutText", vagy egy eredeti forrásmező értéke, például egy termékazonosító mező tartalma, vagy a forrásból másolt metaadatok, például metadata_storage_path az Azure Storage-blobokból. |
| "környezet" | A bővítés hatóköre lehet a teljes dokumentum, a dokumentum egy része (oldalak vagy mondatok), vagy ha képekkel dolgozik, a dokumentumból kivont képek. Alapértelmezés szerint a bővítési környezet a "/document" szinten van, és az adatforrásban található egyes dokumentumokra terjed ki. Egy képesség futtatásakor a képesség kimenetei a meghatározott környezet tulajdonságaivá válnak. |
Különböző forgatókönyvek elérési útjai
Az elérési utak egy képességkészlet "környezet" és "forrás" tulajdonságaiban, valamint az indexelő kimeneti mezőleképezéseiben vannak megadva.
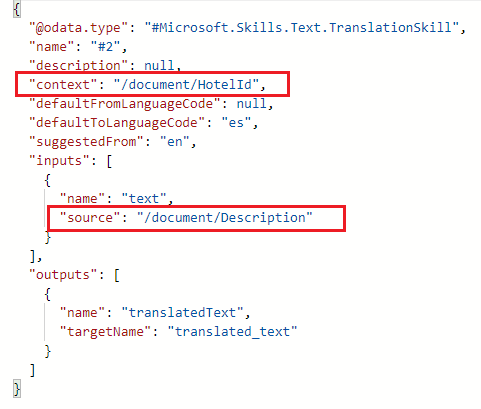
A képernyőképen látható példa egy Azure Cosmos DB-gyűjtemény egy elemének elérési útját mutatja be.
contextelérési út azért/document/HotelId, mert a gyűjtemény a/HotelIdmező szerint dokumentumokra van particionálva.sourceaz elérési út azért van,/document/Descriptionmert a készség fordítási készség, és a lefordítani kívánt mező azDescriptionmező minden dokumentumban.
Minden elérési út ezzel /documentkezdődik: . A bővített dokumentum az indexelő végrehajtásának "dokumentum feltárása" szakaszában jön létre, amikor az indexelő megnyit egy dokumentumot, vagy beolvas egy sort az adatforrásból. Kezdetben a bővített dokumentumok egyetlen csomópontja a gyökércsomópont (/document), és ez az a csomópont, ahonnan az összes többi bővítés történik.
Az alábbi lista számos gyakori példát tartalmaz:
-
/documenta gyökércsomópont, amely egy teljes blobot jelöl az Azure Storage-ban, vagy egy SQL-tábla egy sorát. -
/document/{key}Egy Azure Cosmos DB-gyűjtemény dokumentumának vagy elemének szintaxisa, ahol{key}a tényleges kulcs található, például/document/HotelIdaz előző példában. -
/document/contentegy JSON-blob "content" tulajdonságát adja meg. -
/document/{field}egy adott mezőn végrehajtott művelet szintaxisa, például a/document/Descriptionmező lefordítása, amely az előző példában látható. -
/document/pages/*vagy/document/sentences/*válik a kontextussá, ha egy nagy dokumentumot kisebb részekre bont feldolgozás céljából. Ha a "környezet" az/document/pages/*, a funkció minden oldalon egyszer végrehajtódik a dokumentumban. Mivel egynél több oldal vagy mondat is lehet, hozzáfűzheti a/*szimbólumot az összes elfogására. -
/document/normalized_images/*a dokumentum feltörése során jön létre, ha a dokumentum képeket tartalmaz. A képek elérési útjai normalized_images kezdődnek. Mivel gyakran több kép van beágyazva egy dokumentumba, fűzze hozzá/*.
A cikk hátralévő részében található példák az Azure blobindexelők által automatikusan létrehozott "tartalom" mezőn alapulnak a dokumentumtörési fázis részeként. Amikor blobtárolóból származó dokumentumokra hivatkozik, használjon olyan formátumot, mint "/document/content"például a "tartalom" mező a "dokumentum" része.
1. példa: Egyszerű széljegyzethivatkozás
Tegyük fel, hogy az Azure Blob Storage-ban különböző fájlok találhatók, amelyek az entitásfelismeréssel kinyerni kívánt személyek nevére mutató hivatkozásokat tartalmaznak. A következő képességdefinícióban "/document/content" a teljes dokumentum szöveges ábrázolása, a "személyek" pedig a személyekként azonosított entitások teljes nevének kinyerése.
Mivel az alapértelmezett környezet az "/document", a személyek listájára most "/document/people"-ként hivatkozhatunk. Ebben a konkrét esetben "/document/people" egy széljegyzet, amely mostantól leképezhető egy index egy mezőjére, vagy egy másik készségben is használható ugyanabban a képességkészletben.
  {
    "@odata.type": "#Microsoft.Skills.Text.V3.EntityRecognitionSkill",
    "categories": [ "Person"],
    "defaultLanguageCode": "en",
    "inputs": [
      {
        "name": "text",
        "source": "/document/content"
      }
    ],
    "outputs": [
      {
        "name": "persons",
        "targetName": "people"
      }
    ]
  }
2. példa: Hivatkozás egy tömbre egy dokumentumban
Ez a példa az előzőre épül, amely bemutatja, hogyan hívhat meg többször egy bővítési lépést ugyanazon a dokumentumon keresztül. Tegyük fel, hogy az előző példa sztringekből álló tömböt hozott létre egyetlen dokumentumból 10 személynévvel. Egy ésszerű következő lépés lehet egy második bővítés, amely kinyeri a vezetéknevet egy teljes névből. Mivel 10 név van, ezt a lépést 10-szer kell meghívni ebben a dokumentumban, egyenként egyszer.
A megfelelő számú iteráció meghívásához állítsa be a környezetet úgy, hogy "/document/people/*", ahol a csillag ("*") a bővített dokumentum összes csomópontját a "/document/people" leszármazottjaiként jelöli. Bár ez a képesség csak egyszer van definiálva a képességtömbben, a rendszer a dokumentum minden tagjához meghívja, amíg az összes tag feldolgozásra nem kerül.
  {
    "@odata.type": "#Microsoft.Skills.Custom.WebApiSkill",
    "description": "Fictitious skill that gets the last name from a full name",
    "uri": "http://names.azurewebsites.net/api/GetLastName",
    "context" : "/document/people/*",
    "defaultLanguageCode": "en",
    "inputs": [
      {
        "name": "fullname",
        "source": "/document/people/*"
      }
    ],
    "outputs": [
      {
        "name": "lastname",
        "targetName": "lastname"
      }
    ]
  }
Ha a széljegyzetek tömbök vagy sztringek gyűjteményei, feltételezhetően az adott tagokat szeretnénk megcélozni a tömb egésze helyett. Az előző példa egy annotációt hoz létre "lastname" néven minden csomópont alatt, amelyet a környezet képvisel. Ha a jegyzetcsaládra szeretne hivatkozni, használja a szintaxist "/document/people/*/lastname". Ha egy adott megjegyzésre szeretne hivatkozni, használjon explicit indexet ("/document/people/1/lastname") a dokumentumban azonosított első személy vezetéknevére való hivatkozáshoz. Figyelje meg, hogy ebben a szintaxisban a tömbök indexelése nulla.
3. példa: Hivatkozás tagokra egy tömbben
Néha egy adott típusú annotációt kell csoportosítania, hogy átadja őket egy adott funkciónak. Vegyünk egy hipotetikus egyéni képességet, amely a 2. példában kinyert összes vezetéknév leggyakoribb vezetéknevét azonosítja. Ha csak a vezetékneveket szeretné megadni az egyéni képességnek, adja meg a kontextust "/document" és a bemenetet."/document/people/*/lastname"
Figyelje meg, hogy a "/document/people/*/lastname" számossága nagyobb, mint a dokumentumé. Előfordulhat, hogy 10 vezetéknévcsomópont van, míg ehhez a dokumentumhoz csak egy dokumentumcsomópont van. Ebben az esetben a rendszer automatikusan létrehoz egy tömböt "/document/people/*/lastname" , amely tartalmazza a dokumentum összes elemét.
  {
    "@odata.type": "#Microsoft.Skills.Custom.WebApiSkill",
    "description": "Fictitious skill that gets the most common string from an array of strings",
    "uri": "http://names.azurewebsites.net/api/MostCommonString",
    "context" : "/document",
    "inputs": [
      {
        "name": "strings",
        "source": "/document/people/*/lastname"
      }
    ],
    "outputs": [
      {
        "name": "mostcommon",
        "targetName": "common-lastname"
      }
    ]
  }
Tippek a jegyzetek elérési útjának hibaelhárításához
Ha problémákat tapasztal a képességbemenetek megadásával kapcsolatban, az alábbi tippek segíthetnek a továbblépésben:
Futtassa az Adatok importálása varázslót a saját adatain a varázsló által generált képességkészlet-definíciók és mezőleképezések áttekintéséhez.
Hibakeresési munkamenet indítása egy készségkészleten a bővített dokumentumok szerkezetének megtekintéséhez. Szerkesztheti a képességdefiníció elérési útjait és más részeit, majd futtathatja a képességet a módosítások ellenőrzéséhez.