Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Megjegyzés
Azure AI Keresés a Azure portálon, REST API-kon és Azure SDK-k keresztül érhető el. Emellett a Foundry IQ-t is támogatja, amely a vállalati tartalmakat újrafelhasználható, engedélytudatos tudásbázisokká alakítja át az Microsoft Foundry portálon található ügynökök számára.
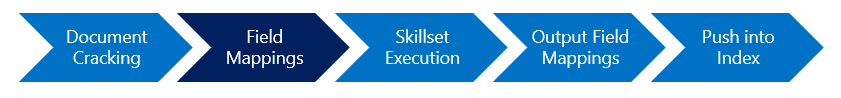
Ez a cikk bemutatja, hogyan állíthat be explicit mezőleképezéseket, amelyek létrehozzák a támogatott adatforrás forrásmezői és a keresési index célmezői közötti adatelérési utat.
Mikor kell mezőleképezést beállítani?
Amikor egy Azure AI Keresés indexelő betölt egy keresési indexet, a forrás–cél mező leképezésével határozza meg az elérési utat. Az implicit mezőleképezések belsőek, és akkor fordulnak elő, ha a mezőnevek és az adattípusok kompatibilisek a forrás és a cél között. Ha a bemenetek és kimenetek nem egyeznek, explicit mezőleképezéseket határozhat meg az adatútvonal beállításához a jelen cikkben leírtak szerint.
A mezőleképezések a leképezési függvényeken keresztül kis súlyú adatátalakításokhoz is használhatók, például kódoláshoz vagy dekódoláshoz. Ha további feldolgozásra van szükség, fontolja meg Azure Data Factory a rés áthidalásához.
A mezőleképezések a következőre vonatkoznak:
Fizikai adatstruktúrák az adatútvonal mindkét oldalán. A készségek által létrehozott logikai adatstruktúrák csak a memóriában találhatók. Az outputFieldMappings használatával leképezheti a memóriában lévő csomópontokat a keresési indexben lévő mezőkre.
Csak a szülői AI keresési indexeket. A "gyermek" dokumentumokat vagy adattömböket tartalmazó "másodlagos" indexek esetében tekintse meg a speciális mezőleképezési forgatókönyveket.
Csak legfelső szintű keresési mezők, ahol az
targetFieldNameegyszerű mező vagy gyűjtemény. A célmező nem lehet összetett típus.
Támogatott forgatókönyvek
Győződjön meg arról, hogy támogatott adatforrást használ az indexelők által vezetett indexeléshez.
| Használati eset | Leírás |
|---|---|
| Néveltérés | Tegyük fel, hogy az adatforrásnak van egy nevű mezője _city. Mivel az Azure AI Keresés nem engedélyezi az aláhúzásjellel kezdődő mezőneveket, a mezőtérképezés lehetővé teszi, hogy a „_city” név a „city” névhez legyen társítva. Ha az indexelési követelmények közé tartozik a tartalom lekérése több adatforrásból, ahol a mezőnevek eltérőek a források között, akkor egy mezőleképezéssel tisztázhatja az elérési utat. |
| Típuseltérés | Tegyük fel, hogy azt szeretné, hogy egy forrás egész mező típusa Edm.String legyen úgy, hogy az kereshető legyen a keresési indexben. Mivel a típusok eltérőek, meg kell határoznia egy mezőleképezést ahhoz, hogy az adatelérési út sikeres legyen. Vegye figyelembe, hogy az Azure AI Keresés kevesebb támogatott adattípussal rendelkezik, mint számos adatforrás. HA SQL-adatokat importál, a mezőleképezés lehetővé teszi a keresési indexben a kívánt SQL-adattípus leképezését . |
| Egy-a-többhöz adatelérési utak | Az indexben több mezőt is feltölthet ugyanabból a forrásmezőből származó tartalommal. Előfordulhat például, hogy különböző elemzőket szeretne alkalmazni az egyes mezőkre az ügyfélalkalmazás különböző használati eseteinek támogatásához. |
| Kódolás és dekódolás | Leképezési függvényeket alkalmazhat a Base64-adatok kódolásának vagy dekódolásának támogatására az indexelés során. |
| Karakterláncok felosztása vagy tömbök átalakítása gyűjteményekbe |
A leképezési függvényeket alkalmazhatja egy elválasztójelet tartalmazó sztring felosztására, vagy JSON-tömb küldésére egy típusú Collection(Edm.String)keresőmezőbe. |
Megjegyzés
Ha nincsenek mezőleképezések, az indexelők feltételezik, hogy az adatforrásmezőket azonos nevű indexmezőkre kell leképezni. A mezőleképezés hozzáadása felülbírálja a forrás- és célmező alapértelmezett mezőleképezéseit. Egyes indexelők, például a blobtároló indexelője automatikusan hozzáadják az indexkulcs mező alapértelmezett mezőleképezéseit.
Az összetett mezők nem támogatottak a mezőleképezésben. A forrásstruktúrának (beágyazott vagy hierarchikus struktúráknak) pontosan meg kell egyeznie az index összetett típusával, hogy az alapértelmezett leképezések működhessenek. További információért lásd a Oktatóanyag: Beágyazott JSON-blobok indexelése példaként. Ha hasonló hibaüzenetet kap, annak az az oka, hogy a "Field mapping specifies target field 'Address/city' that doesn't exist in the index" célmező-leképezések nem lehetnek összetett típusok.
Igény szerint csak néhány csomópontot szeretne az összetett struktúrában. Az egyes csomópontok lekéréséhez a bejövő adatokat sztringgyűjteménnyé lehet laposítani (ezzel a megoldással kapcsolatban lásd az outputFieldMappings mezőt).
Mezőleképezés definiálása
Ez a szakasz a mezőleképezések beállításának lépéseit ismerteti.
Használja a Create Indexer vagy Indexer létrehozása vagy frissítése vagy egy Azure SDK egyenértékű metódusát. Íme egy példa egy indexelő definíciójára.
{
   "name": "myindexer",
   "description": null,
   "dataSourceName": "mydatasource",
   "targetIndexName": "myindex",
   "schedule": { },
   "parameters": { },
   "fieldMappings": [],
   "disabled": false,
   "encryptionKey": { }
 }
Töltse ki a
fieldMappingstömböt a leképezések megadásához. A mezőleképezés három részből áll."fieldMappings": [ { "sourceFieldName": "_city", "targetFieldName": "city", "mappingFunction": null } ]Tulajdonság Leírás sourceFieldName Szükséges. Az adatforrás egy mezőjét jelöli. célmezőNév Választható. A keresési index egy mezőjét jelöli. Ha hiányzik, a sourceFieldNameértéket feltételezzük a cél számára. A célmezőknek felső szintű egyszerű mezőknek vagy gyűjteményeknek kell lenniük. Nem lehet összetett típus vagy gyűjtemény. Adattípus-probléma kezelése esetén a mező adattípusa az indexdefinícióban van megadva. A mezőleképezésnek csak a mező nevével kell rendelkeznie.mappingFunction Választható. Előre definiált függvényekből áll, amelyek átalakítják az adatokat.
Példa: Név- vagy típuseltérés
Az explicit mezőleképezés adatelérési utat hoz létre olyan esetekben, amikor a név és a típus nem azonos.
Azure AI Keresés a kis- és nagybetűkre nem érzékeny összehasonlítást alkalmazva oldja meg a mező- és függvényneveket a mezőleképezésekben. Ez kényelmes (nem kell minden burkolatot helyesen beszereznie), de ez azt jelenti, hogy az adatforrás vagy az index nem tartalmazhat olyan mezőket, amelyek csak esetenként különböznek.
PUT https://[service name].search.windows.net/indexers/myindexer?api-version=[api-version]
Content-Type: application/json
api-key: [admin key]
{
    "dataSourceName" : "mydatasource",
    "targetIndexName" : "myindex",
    "fieldMappings" : [ { "sourceFieldName" : "_city", "targetFieldName" : "city" } ]
}
Példa: Egy-a-többhöz kapcsolatok vagy elágazó adatútvonalak
Ez a példa egy forrásmezőt több célmezőre térképez le ("egy-a-többhöz" leképezések). Egy mezőt elágaztathat, és ugyanazon forrásmező tartalmát két különböző indexmezőbe másolhatja, amelyek az indexben másként lesznek elemezve vagy attribútálva.
"fieldMappings" : [
    { "sourceFieldName" : "text", "targetFieldName" : "textStandardEnglishAnalyzer" },
    { "sourceFieldName" : "text", "targetFieldName" : "textSoundexAnalyzer" }
]
Hasonló megközelítést használhat a készségek által létrehozott tartalmakhoz.
Leképezési függvények és példák
A mezőleképezési függvény átalakítja egy mező tartalmát az indexben való tárolás előtt. Jelenleg a következő leképezési függvények támogatottak:
- base64Encode
- base64Decode
- extractTokenAtPosition
- fixedLengthEncode
- jsonArrayToStringCollection
- toJson
- urlEncode
- urlDecode
Vegye figyelembe, hogy ezek a függvények jelenleg kizárólag a szülőindexek esetében támogatottak. Nem kompatibilisek az adattömbök indexleképezésével, ezért ezek a függvények nem használhatók index-előrejelzésekhez.
base64Encode függvény
A bemeneti karakterlánc URL-biztos Base64-kódolását hajtja végre. Feltételezi, hogy a bemenet UTF-8 kódolású.
Példa: Dokumentumkulcs alapkódolása
Egy Azure AI Keresés dokumentumkulcsban csak URL-címmel rendelkező karakterek jelenhetnek meg (így a Lookup API használatával kezelheti a dokumentumot). Ha a kulcs forrásmezője URL-nem biztonságos karaktereket tartalmaz, például - és \, használja a függvényt az base64Encode indexelés idején való konvertáláshoz.
Az alábbi példa a base64Encode függvényt adja meg a metadata_storage_name nem támogatott karakterek kezeléséhez.
PUT /indexers?api-version=2026-04-01
{
  "dataSourceName" : "my-blob-datasource ",
  "targetIndexName" : "my-search-index",
  "fieldMappings" : [
    {
        "sourceFieldName" : "metadata_storage_name",
        "targetFieldName" : "key",
        "mappingFunction" : {
            "name" : "base64Encode",
            "parameters" : { "useHttpServerUtilityUrlTokenEncode" : false }
        }
    }
  ]
}
A dokumentumkulcsok (átalakítás előtt és után is) nem lehetnek hosszabbak 1024 karakternél. A kódolt kulcs keresési időpontban történő lekérésekor a base64Decode függvény használatával szerezze be az eredeti kulcs értékét, és ezzel kérje le a forrásdokumentumot.
Példa: Alapkódolt mező "kereshetővé tétele"
Vannak esetek, amikor egy mező kódolt verzióját kell használnia, például metadata_storage_path kulcsként, de a teljes szöveges kereséshez is kódolatlan verzióra van szüksége. Mindkét forgatókönyv támogatásához két mezőhöz rendelhet leképezést metadata_storage_path : az egyik a kulcshoz (kódolt), a másodikhoz pedig egy olyan elérésiút-mezőhöz, amelyet feltételezhetünk, az indexsémához hasonlóan searchable van hozzárendelve.
PUT /indexers/blob-indexer?api-version=2026-04-01
{
    "dataSourceName" : " blob-datasource ",
    "targetIndexName" : "my-target-index",
    "schedule" : { "interval" : "PT2H" },
    "fieldMappings" : [
        { "sourceFieldName" : "metadata_storage_path", "targetFieldName" : "key", "mappingFunction" : { "name" : "base64Encode" } },
        { "sourceFieldName" : "metadata_storage_path", "targetFieldName" : "path" }
      ]
}
Példa – eredeti értékek megőrzése
A blobtároló indexelője automatikusan hozzáad egy mezőleképezést a blob URI-jából metadata_storage_pathaz indexkulcs mezőhöz, ha nincs megadva mezőleképezés. Ez az érték Base64 kódolású, így biztonságosan használható Azure AI Keresés dokumentumkulcsként. Az alábbi példa bemutatja, hogyan képezheti le egyszerre az URL-címvédett Base64 kódolt verzióját metadata_storage_path egy index_key mezőre, és hogyan őrizheti meg az eredeti értéket egy metadata_storage_path mezőben:
"fieldMappings": [
  {
    "sourceFieldName": "metadata_storage_path",
    "targetFieldName": "metadata_storage_path"
  },
  {
    "sourceFieldName": "metadata_storage_path",
    "targetFieldName": "index_key",
    "mappingFunction": {
       "name": "base64Encode"
    }
  }
]
Ha nem tartalmaz paramétertulajdonságot a leképezési függvényhez, az alapértelmezés szerint az érték {"useHttpServerUtilityUrlTokenEncode" : true}lesz.
Azure AI Keresés két különböző Base64-kódolást támogat. Ugyanazokat a paramétereket kell használnia ugyanazon mező kódolása és dekódolása során. További információ: base64 kódolási beállítások , amelyek eldöntik, hogy mely paramétereket érdemes használni.
base64Decode függvény
A bemeneti sztring Base64-dekódolását hajtja végre. A bemenet egy URL-biztos Base64-kódolású sztringnek számít.
Példa – blob metaadatainak vagy URL-címeinek dekódolás
A forrásadatok tartalmazhatnak Base64-kódolt sztringeket, például blob metaadat-sztringeket vagy webes URL-címeket, amelyeket egyszerű szövegként szeretne kereshetővé tenni. A függvény használatával a base64Decode kódolt adatokat normál sztringekké alakíthatja a keresési index feltöltésekor.
"fieldMappings" : [
  {
    "sourceFieldName" : "Base64EncodedMetadata",
    "targetFieldName" : "SearchableMetadata",
    "mappingFunction" : {
      "name" : "base64Decode",
      "parameters" : { "useHttpServerUtilityUrlTokenDecode" : false }
    }
  }
]
Ha nem tartalmaz paramétertulajdonságot, az alapértelmezés szerint az érték {"useHttpServerUtilityUrlTokenEncode" : true}lesz.
Azure AI Keresés két különböző Base64-kódolást támogat. Ugyanazokat a paramétereket kell használnia ugyanazon mező kódolása és dekódolása során. További információ: base64 kódolási beállítások , amelyek eldöntik, hogy mely paramétereket érdemes használni.
Base64 kódolási lehetőségek
Azure AI Keresés támogatja az URL-biztonságos base64 kódolást és a normál base64 kódolást. Az indexelés során base64 kódolású sztringet később ugyanezekkel a kódolási beállításokkal kell dekódolni, különben az eredmény nem egyezik meg az eredetivel.
Ha a useHttpServerUtilityUrlTokenEncode kódoláshoz és a useHttpServerUtilityUrlTokenDecode dekódoláshoz használt paraméterek értéke true-ra van állítva, akkor a base64Encode úgy viselkedik, mint a HttpServerUtility.UrlTokenEncode, és a base64Decode úgy viselkedik, mint a HttpServerUtility.UrlTokenDecode.
Figyelmeztetés
Ha base64Encode kulcsértékek előállítására szolgál, useHttpServerUtilityUrlTokenEncode igaz értékre kell állítani. Kulcsértékekhez csak AZ URL-cím biztonságos base64 kódolása használható. A kulcsértékekben szereplő karakterekre vonatkozó korlátozások teljes készletét lásd Az elnevezési szabályok alatt.
A Azure AI Keresés .NET kódtárai feltételezik a teljes .NET-keretrendszert, amely beépített kódolást biztosít. A useHttpServerUtilityUrlTokenEncode és useHttpServerUtilityUrlTokenDecode beállítások alkalmazzák ezt a beépített funkciót. Ha .NET Core-t vagy más keretrendszert használ, javasoljuk, hogy állítsa ezeket a beállításokat false értékre, és közvetlenül használja a keretrendszer kódolási és dekódolási függvényeit.
Az alábbi táblázat a sztring 00>00?00különböző base64-kódolásait hasonlítja össze. A base64-függvényekhez szükséges feldolgozás (ha van ilyen) meghatározásához alkalmazza a kódtár kódoló függvényét a sztringre 00>00?00 , és hasonlítsa össze a kimenetet a várt kimenettel MDA-MDA_MDA.
| Encoding | Base64 kódolt kimenet | További feldolgozás a kódtár kódolása után | További feldolgozás a kódtár dekódolása előtt |
|---|---|---|---|
| Base64 párnázással | MDA+MDA/MDA= |
Használjon URL-barát karaktereket, és távolítsa el a kitöltést | Standard base64 karakterek használata és padding hozzáadása |
| Base64 pótlás nélkül | MDA+MDA/MDA |
URL-címben biztonságos karakterek használata | Standard alap64 karakter használata |
| URL-biztonságos base64 párnázással | MDA-MDA_MDA= |
Padding eltávolítása | Padding hozzáadása |
| URL-biztonságos base64 párnázás nélkül | MDA-MDA_MDA |
Nincs | Nincs |
extractTokenAtPosition függvény
Feloszt egy karakterlánc mezőt a megadott elválasztójellel, és kiválasztja az elemet az eredményül kapott felosztás megadott helyén.
Ez a függvény a következő paramétereket használja:
-
delimiter: a bemeneti sztring felosztásakor elválasztóként használni kívánt sztring. -
position: a bemeneti sztring felosztása után az a token, amelyet nullától kezdődő egész számként meghatározott pozíción kell kiválasztani.
Ha például a bemenet Jane Doe, az delimiter is " "(szóköz) és a position 0, az eredmény Jane; ha az position 1, akkor az eredmény Doe. Ha a pozíció nem létező jogkivonatra hivatkozik, a függvény hibát ad vissza.
Példa – név kinyerés
Az adatforrás tartalmaz egy PersonName mezőt, és azt két különálló mezőként, FirstName és LastName, szeretné indexelni. Ezzel a függvénnyel feloszthatja a bemenetet a szóköz karaktert határolóként használva.
"fieldMappings" : [
  {
    "sourceFieldName" : "PersonName",
    "targetFieldName" : "FirstName",
    "mappingFunction" : { "name" : "extractTokenAtPosition", "parameters" : { "delimiter" : " ", "position" : 0 } }
  },
  {
    "sourceFieldName" : "PersonName",
    "targetFieldName" : "LastName",
    "mappingFunction" : { "name" : "extractTokenAtPosition", "parameters" : { "delimiter" : " ", "position" : 1 } }
  }]
jsonArrayToStringCollection függvény
Sztringek JSON-tömbjeként formázott sztringeket alakít át egy sztringtömbbe, amely az index egy Collection(Edm.String) mezőjének kitöltésére használható.
Ha például a bemeneti sztring az ["red", "white", "blue"], akkor a típus Collection(Edm.String) célmezője a három értékkel redlesz feltöltve, whiteés blue. JSON-sztringtömbként nem elemezhető bemeneti értékek esetén a rendszer hibát ad vissza.
Példa – gyűjtemény feltöltése relációs adatokból
Azure SQL Database nem rendelkezik olyan beépített adattípussal, amely természetesen az Collection(Edm.String) mezőkre képez le Azure AI keresésben. A sztringgyűjtemény mezőinek feltöltéséhez a forrásadatokat JSON-karakterlánctömbként is feldolgozhatja, majd használhatja a leképezési jsonArrayToStringCollection függvényt.
"fieldMappings" : [
  {
    "sourceFieldName" : "tags",
    "mappingFunction" : { "name" : "jsonArrayToStringCollection" }
  }]
urlEncode függvény
Ez a függvény sztringek kódolására használható úgy, hogy az "URL-cím biztonságos legyen". Ha olyan sztringet használ, amely url-címben nem engedélyezett karaktereket tartalmaz, ez a függvény ezeket a "nem biztonságos" karaktereket karakter-entitás megfelelőivé alakítja. Ez a függvény az UTF-8 kódolási formátumot használja.
Példa – dokumentumkulcs-keresés
urlEncode alternatívájaként használható, ha csak a base64Encode függvény URL-cím nem biztonságos karakterei konvertálhatók, miközben a többi karakter változatlan marad.
Tegyük fel, hogy a bemeneti sztring <hello> - akkor a (Edm.String) típusú célmezőt a %3chello%3e értékkel töltjük fel.
A kódolt kulcs kereséskor történő lekérése után a urlDecode függvény segítségével lekérheti az eredeti kulcs értékét, és ezzel lekérheti a forrásdokumentumot.
"fieldMappings" : [
  {
    "sourceFieldName" : "SourceKey",
    "targetFieldName" : "IndexKey",
    "mappingFunction" : {
      "name" : "urlEncode"
    }
  }
]
urlDecode függvény
Ez a függvény egy URL-kódolású sztringet UTF-8 kódolási formátummal dekódolt sztringgé alakít át.
Példa – blob metaadatainak dekódolás
Egyes Azure tárolóügyfelek automatikusan URL-kódolású blob-metaadatokat tartalmaznak, ha nem ASCII-karaktereket tartalmaznak. Ha azonban az ilyen metaadatokat kereshetővé szeretné tenni (egyszerű szövegként), a urlDecode függvény használatával a kódolt adatokat visszakapcsolhatja normál sztringekké a keresési index feltöltésekor.
"fieldMappings" : [
  {
    "sourceFieldName" : "UrlEncodedMetadata",
    "targetFieldName" : "SearchableMetadata",
    "mappingFunction" : {
      "name" : "urlDecode"
    }
  }
]
fixedLengthEncode függvény
Ez a függvény bármilyen hosszúságú karakterláncot rögzített hosszúságú karakterlánccá alakít át.
Példa – túl hosszú dokumentumkulcsok leképezése
Ha a dokumentumkulcs 1024 karakternél hosszabb hosszával kapcsolatos hibák lépnek fel, ez a függvény a dokumentumkulcs hosszának csökkentésére alkalmazható.
"fieldMappings" : [
 {
   "sourceFieldName" : "metadata_storage_path",
   "targetFieldName" : "your key field",
   "mappingFunction" : {
     "name" : "fixedLengthEncode"
   }
 }
]
toJson függvény
Ez a függvény formázott JSON-objektummá konvertál egy sztringet. Ez olyan helyzetekben használható, ahol az adatforrás (például a Azure SQL) nem támogatja natív módon az összetett vagy hierarchikus adattípusokat, majd összetett mezőkre képezheti le.
Példa – szövegtartalom leképezése összetett mezőre
Tegyük fel, hogy van egy JSON-sztringgel rendelkező SQL-sor, amelyet le kell képezni az index egy (megfelelően definiált) összetett mezőjére, a toJson függvény ennek eléréséhez használható. Ha például az index egy összetett mezőjét a következő adatokkal kell kitölteni:
{
    "id": "5",
    "info": {
        "name": "Jane",
        "surname": "Smith",
        "skills": [
            "SQL",
            "C#",
            "Azure"
        ],
        "dob": "2005-11-04T12:00:00"
    }
}
Ez a toJson leképezési függvény használatával érhető el egy SQL-sor JSON-sztringoszlopán, amely így néz ki: {"id": 5, "info": {"name": "Jane", "surname": "Smith", "skills": ["SQL", "C#", "Azure"]}, "dob": "2005-11-04T12:00:00"}.
A mezőleképezést az alább látható módon kell megadni.
"fieldMappings" : [
  {
    "sourceFieldName" : "content",
    "targetFieldName" : "complexField",
    "mappingFunction" : {
      "name" : "toJson"
    }
  }
]
Speciális mezőleképezési forgatókönyvek
Azokban az esetekben, amikor "eggyel több" dokumentumkapcsolatokkal rendelkezik, például adattömbökre bontás vagy szeletelés esetén, kövesse az alábbi irányelveket a szülődokumentumok mezőinek "gyermek" dokumentumokra (adattömbökre) való leképezéséhez.
1. A szülődokumentum indexelésének kihagyása
Ha kihagyja a szülődokumentumok indexelését a készségkészletben a projectionMode beállításával skipIndexingParentDocumentsindexProjections, használja az indexvetületeket a szülődokumentumok mezőinek "gyermek" dokumentumokra való leképezéséhez.
2. Szülő- és gyermekdokumentumok indexelése
Ha a szülődokumentumokat és a "gyermek" dokumentumokat is indexeli:
- Használja a mezőleképezéseket arra, hogy mezőket leképezzen a szülődokumentumokra.
- Az index-előrejelzések használatával mezőket képezhet le a "gyermek" dokumentumokhoz.
3. Függvényátalakítású értékek leképezése szülő- és/vagy "gyermek" dokumentumokba
Ha a szülődokumentum egy mezője átalakítást igényel, amelyhez leképezési függvényekre, például kódolásra van szükség, és le kell képezni a szülői vagy/vagy gyermek dokumentumokra:
- Alkalmazza az átalakítást a mezők leképezésének függvényeivel az indexelőben.
- A képességkészletben index-előrejelzések használatával képezze le az átalakított mezőt a "gyermek" dokumentumokra.
Lásd még:
Támogatott adattípusok a Azure AI Keresés - SQL-adattípus-leképezés