Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Megjegyzés
Azure AI Keresés a Azure portálon, REST API-kon és Azure SDK-k keresztül érhető el. Emellett a Foundry IQ-t is támogatja, amely a vállalati tartalmakat újrafelhasználható, engedélytudatos tudásbázisokká alakítja át az Microsoft Foundry portálon található ügynökök számára.
Ebben a cikkben megismerheti a keresési index sémájának meghatározásának és egy keresési szolgáltatásba való leküldésének lépéseit. Az index létrehozása létrehozza a keresési szolgáltatás fizikai adatstruktúráit. Ha az index létezik, töltse be az indexet külön feladatként.
Előfeltételek
Egy Azure-előfizetés. Hozzon létre egyet ingyen.
Egy Azure AI Keresés szolgáltatás, bármely régió és szint, de a szerepköralapú hozzáféréshez számlázható (alapszintű vagy magasabb) szintnek kell lennie.
Index létrehozásához szükséges engedélyek: Keresési szolgáltatás közreműködői szerepköre vagy rendszergazdai API-kulcs kulcsalapú hitelesítéshez.
A forrásadatok egyedi mezője, amely az index dokumentumkulcsaként használható.
Az adatséma ismerete. A mezők kereshetővé, lekérthetővé, szűrhetővé, facetable-sá és rendezhetővé tételével kapcsolatos tervezési útmutatót a séma ellenőrzőlistájában talál.
Index létrehozása
Ha készen áll az index létrehozására, használjon egy keresési ügyfelet, amely elküldheti a kérést. Az Azure Portalt vagy a REST API-kat használhatja a korai fejlesztéshez és a megvalósíthatósági vizsgálathoz, ellenkező esetben gyakran használják az Azure SDK-kat.
A fejlesztés során tervezze meg a gyakori újraépítéseket. Mivel a fizikai struktúrák a szolgáltatásban jönnek létre, az indexek elvetése és újbóli létrehozása számos módosításhoz szükséges. Érdemes lehet az adatok egy részhalmazával dolgozni, hogy az újraépítések gyorsabbak legyenek.
Az Azure Portalon keresztüli indextervezés bizonyos adattípusokra vonatkozó követelményeket és sémaszabályokat kényszerít ki, például letiltja a teljes szöveges keresési képességeket a numerikus mezőkön.
Nyissa meg a keresési szolgáltatást az Azure Portalon.
Ellenőrizze a helyet. A keresési szolgáltatásokra az indexek maximális száma vonatkozik, amely tarifacsomagonként változik. Győződjön meg arról, hogy van helye egy második indexnek.
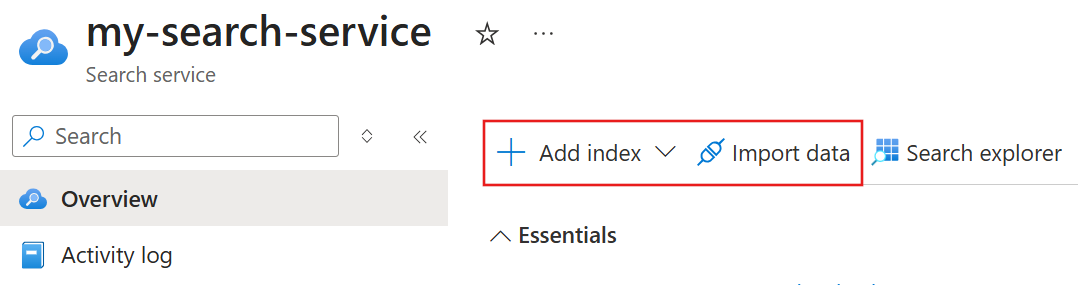
A keresési szolgáltatás áttekintési lapján válasszon az alábbi lehetőségek közül:
- Index hozzáadása: Beágyazott szerkesztő egy indexséma megadásához.
- Adatok importálása: Adatforrást, indexelőt és befejezett indexet létrehozó varázsló. A varázsló az adatokat is betölti. Ha nincs szüksége a végpontok közötti munkafolyamatra, használja inkább az Index hozzáadása lehetőséget.
Tipp
Miután létrehozott egy indexet az Azure Portalon, átmásolhatja a JSON-reprezentációt, és hozzáadhatja az alkalmazás kódjához.
Index létrehozásának ellenőrzése
Miután létrehozott egy indexet, ellenőrizze, hogy létezik-e, ha felsorolja az indexeket a keresési szolgáltatásban.
Az Azure Portalon nyissa meg a keresési szolgáltatást.
A bal oldali panelen válassza a Kereséskezelési>indexek lehetőséget.
Győződjön meg arról, hogy az új index megjelenik a listában. Ha nem látja, frissítse a lapot.
Dokumentum kulcsok
A keresési index létrehozásának két követelménye van: az indexnek egyedi névvel kell rendelkeznie a keresési szolgáltatásban, és rendelkeznie kell egy dokumentumkulcstal. Egy mező logikai key attribútuma igaz értékre állítható, amely jelzi, hogy melyik mező biztosítja a dokumentumkulcsot.
A dokumentumkulcs a keresési dokumentum egyedi azonosítója, a keresődokumentum pedig olyan mezők gyűjteménye, amelyek teljesen leírnak valamit. Ha például egy filmadatkészletet indexel, a keresődokumentum egy film címét, műfaját és időtartamát tartalmazza. A filmnevek egyediek ebben az adatkészletben, ezért a film nevét használhatja dokumentumkulcsként.
Az Azure AI Keresésben a dokumentumkulcs egy sztring, amely az indexelendő tartalmat biztosító adatforrás egyedi értékeiből származik. A keresési szolgáltatás általában nem hoz létre kulcsértékeket, de bizonyos esetekben (például az Azure-tábla indexelője) szintetizálja a meglévő értékeket, hogy egyedi kulcsot hozzon létre az indexelt dokumentumokhoz. Egy másik forgatókönyv az egy-a-többhöz indexelés a darabolt vagy particionált adatok esetében, amely esetben minden egyes darabhoz dokumentumkulcsokat hoznak létre.
A növekményes indexelés során, ahol új és frissített tartalom indexelődik, a rendszer új kulcsokkal rendelkező bejövő dokumentumokat ad hozzá, míg a meglévő kulcsokkal rendelkező bejövő dokumentumokat egyesítik vagy felülírják attól függően, hogy az indexmezők null értékűek vagy fel vannak-e töltve.
A dokumentumkulcsokkal kapcsolatos fontos szempontok a következők:
- Egy kulcsmező értékeinek maximális hossza 1024 karakter.
- Minden indexben pontosan egy legfelső szintű mezőt kell kiválasztani kulcsmezőként, és típusának
Edm.Stringkell lennie. - Az attribútum alapértelmezése
keyaz egyszerű mezők esetében hamis, az összetett mezők esetében null.
A kulcsmezők a dokumentumok közvetlen keresésére és adott dokumentumok frissítésére vagy törlésére használhatók. A kulcsmezők értékei kis- és nagybetű-érzékenyek, amikor dokumentumokat keresünk vagy indexelünk. A részletekért lásd a GET Dokumentum (REST) és az Indexdokumentumok (REST) című témakört.
Séma ellenőrzőlista
Ezzel az ellenőrzőlistával segítheti a keresési indexével kapcsolatos tervezési döntéseit.
Tekintse át az elnevezési konvenciókat, hogy az index- és mezőnevek megfeleljenek az elnevezési szabályoknak.
Nézze át a támogatott adattípusokat. Az adattípus befolyásolja a mező használatának módját. A numerikus tartalom például szűrhető, de teljes szöveges tartalomként nem kereshető. A leggyakoribb adattípus kereshető szöveg esetén a
Edm.String, amelynek tokenizálása és lekérdezése a teljes szöveges keresőmotor használatával történik. A vektormezők leggyakoribb adattípusa az,Edm.Singlede más típusokat is használhat.Adja meg az index leírását, legfeljebb 4000 karaktert. Ez az ember által olvasható szöveg felbecsülhetetlen értékű, ha egy rendszernek több indexhez kell hozzáférnie, és a leírás alapján döntést kell hoznia. Fontolja meg a Model Context Protocol (MCP) kiszolgálót, amely futásidőben a megfelelő indexet kell kiválasztania. A döntés a leíráson alapulhat, és nem csak az index neve alapján.
Azonosítson egy dokumentumkulcsot. A dokumentumkulcs indexkövetelmény. Egyetlen sztringmező, amely egyedi értékeket tartalmazó forrásadatmezőből van kitöltve. Ha például a Blob Storage-ból indexel, a metaadattár elérési útja gyakran használatos dokumentumkulcsként, mert egyedileg azonosít a tárolóban lévő minden egyes blobot.
Azonosítsa az adatforrás azon mezőit, amelyek kereshető tartalommal járulnak hozzá az indexben.
A kereshető nem-vektoriális tartalom rövid vagy hosszú karakterláncokat tartalmaz, amelyeket a teljes szöveges keresőmotorral kérdeznek le. Ha a tartalom részletes (kis kifejezések vagy nagyobb adattömbök), kísérletezzen különböző elemzőkkel, hogy lássa, hogyan történik a szöveg tokenizálása.
A kereshető vektortartalmak lehetnek képek vagy szövegek (bármilyen nyelven), amelyek matematikai ábrázolásként léteznek. A vektormezők kicsinyítéséhez keskeny adattípusokat vagy vektortömörítést használhat.
A mezőkön beállított attribútumok ( például
retrievablevagyfilterable) meghatározzák a keresési viselkedést és az index fizikai megjelenítését a keresési szolgáltatásban. A mezők attribútumainak meghatározása sok fejlesztő számára iteratív folyamat. Az iterációk felgyorsítása érdekében kezdjen mintaadatokkal, hogy könnyen eldobhassa és újraépíthesse azokat.Határozza meg, hogy mely forrásmezők használhatók szűrőkként. A numerikus tartalom és a rövid szövegmezők, különösen az ismétlődő értékekkel rendelkezők jó választást jelentenek. Szűrők használatakor ne feledje:
Szűrők vektoros és nem vektoros lekérdezésekben is használhatók, de maga a szűrő az index emberi olvasásra alkalmas (nem vektoros) mezőkre lesz alkalmazva.
Szűrhető mezők opcionálisan használhatók a szűrőalapú navigációban.
A szűrhető mezők tetszőleges sorrendben jelennek meg, és nem kerülnek relevancia szerinti pontozásba, ezért érdemes lehet őket is rendezhetővé tenni.
Vektormezők esetén adja meg a vektorkeresés konfigurációját, valamint a navigációs útvonalak létrehozásához és a beágyazási terület kitöltéséhez használt algoritmusokat. További információ: Vektormezők hozzáadása.
A vektormezők olyan extra tulajdonságokkal rendelkeznek, amelyekkel a nem vektormezők nem rendelkeznek, például hogy mely algoritmusokat kell használni és a vektortömörítés.
A vektormezők kihagyják azokat az attribútumokat, amelyek nem hasznosak a vektoradatok esetén, például a rendezést, a szűrést és a facettázást.
A nem vektorterek esetében döntse el, hogy az alapértelmezett elemzőt (
"analyzer": null) vagy egy másik elemzőt használja-e. Az elemzők a szövegmezők tokenizálására szolgálnak az indexelés és a lekérdezés-végrehajtás során.Többnyelvű sztringek esetén fontolja meg a nyelvelemző használatát.
Kötőjeles sztringek vagy speciális karakterek esetén fontolja meg a speciális elemzőket. Ilyen például a kulcsszó , amely egy mező teljes tartalmát egyetlen jogkivonatként kezeli. Ez a viselkedés olyan adatok esetében hasznos, mint az irányítószámok, az azonosítók és néhány terméknév. További információért lásd: Részleges kifejezéskeresés és minták speciális karakterekkel.
Megjegyzés
A teljes szöveges keresés az indexelés során tokenizált kifejezéseken keresztül történik. Ha a lekérdezések nem ják vissza a várt eredményeket, tesztelje a tokenizálást annak ellenőrzéséhez, hogy a keresett sztring valóban létezik-e. A sztringeken különböző elemzőket próbálhat ki, hogy lássa, hogyan jönnek létre a tokenek a különböző elemzők esetében.
Meződefiníciók konfigurálása
A mezők gyűjteménye határozza meg a keresési dokumentum struktúráját. Minden mező rendelkezik névvel, adattípussal és attribútumokkal.
Ha egy mezőt kereshető, szűrhető, rendezhető vagy facetable típusúként állít be, az hatással van az index méretére és a lekérdezési teljesítményre. Ne állítsa be ezeket az attribútumokat olyan mezőkre, amelyekre nem kíván hivatkozni a lekérdezési kifejezésekben.
Ha egy mező nincs beállítva kereshető, szűrhető, rendezhető vagy facetable értékűre, akkor a mező nem hivatkozható egyetlen lekérdezési kifejezésben sem. Ez a lekérdezésekben nem használt, de a keresési eredményekben szükséges mezők esetében kívánatos.
A REST API-k alapértelmezett hozzárendeléssel rendelkeznek az adattípusok alapján, amelyet az Adatok importálása varázsló is használ az Azure Portalon. Az Azure SDK-k nem rendelkeznek alapértelmezett értékekkel, de olyan mező-alosztályokkal rendelkeznek, amelyek tulajdonságokat és viselkedéseket tartalmaznak, például a sztringek kereshető mezője és a SimpleField a primitívek számára.
A REST API-k alapértelmezett mező-hozzárendeléseit az alábbi táblázat foglalja össze.
| Adattípus | Kereshető | Lekérhető | Szűrhető | Csoportosítható | Rendezhető | Tárolt |
|---|---|---|---|---|---|---|
Edm.String |
✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
Collection(Edm.String) |
✅ | ✅ | ✅ | ✅ | ❌ | ✅ |
Edm.Boolean |
❌ | ✅ | ✅ | ✅ | ✅ | ✅ |
| \ |
❌ | ✅ | ✅ | ✅ | ✅ | ✅ |
Edm.DateTimeOffset |
❌ | ✅ | ✅ | ✅ | ✅ | ✅ |
Edm.GeographyPoint |
✅ | ✅ | ✅ | ❌ | ✅ | ✅ |
Edm.ComplexType |
✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
Collection(Edm.Single) és minden más vektormezőtípus |
✅ | ✅ vagy ❌ | ❌ | ❌ | ❌ | ✅ |
A sztringmezők opcionálisan társíthatók elemzőkkel és szinonimatérképekkel is. A szűrhető, rendezhető vagy facetable típusú Edm.String mezők hossza legfeljebb 32 kilobájt lehet. Ennek az az oka, hogy az ilyen mezők értékei egyetlen keresési kifejezésként vannak kezelve, és az Azure AI Keresésben egy kifejezés maximális hossza 32 kilobájt. Ha ennél több szöveget kell tárolnia egyetlen sztringmezőben, az indexdefinícióban explicit módon false értékre kell beállítania a szűrhetőséget, rendezhetőséget és a facetable tulajdonságot.
A vektormezőket dimenziókkal és vektorprofilokkal kell társítani. A visszakereshető érték alapértelmezés szerint igaz, ha a vektormezőt az Adatok importálása varázslóval adja hozzá az Azure portálon. Ha a REST API-t használja, az hamis.
A mezőattribútumokat az alábbi táblázat ismerteti.
| Attribútum | Ismertetés |
|---|---|
| név | Szükséges. Beállítja a mező nevét, amelynek egyedinek kell lennie az index vagy a szülőmező mezőgyűjteményében. |
| típus | Szükséges. Beállítja a mező adattípusát. A mezők lehetnek egyszerűek vagy összetettek. Az egyszerű mezők primitív típusúak, például Edm.String szöveghez vagy Edm.Int32 egész számokhoz.
Az összetett mezők lehetnek olyan almezők, amelyek maguk is egyszerűek vagy összetettek. Ez lehetővé teszi objektumok és objektumtömbök modellezését, így a legtöbb JSON-objektumstruktúrát feltöltheti az indexbe. A támogatott típusok teljes listáját a Támogatott adattípusok című témakörben találja. |
| kulcs | Szükséges. Állítsa ezt az attribútumot igaz értékre annak meghatározásához, hogy egy mező értékei egyedileg azonosítják az indexben lévő dokumentumokat. A részletekért tekintse meg a cikkben szereplő dokumentumkulcsokat . |
| visszaszerezhető | Azt jelzi, hogy a mező visszaadható-e a keresési eredményben. Állítsa be ezt az attribútumot false arra az esetre, ha szűrő, rendezési vagy pontozási mechanizmusként szeretne mezőt használni, de nem szeretné, hogy a mező látható legyen a végfelhasználó számára. Ennek az attribútumnak true kulcsmezőkhöz, összetett mezőkhöz kell lennie null . Ez az attribútum a meglévő mezőkön módosítható. A beolvasható érték true beállítása nem okoz növekedést az indextárolási követelményekben. Az alapértelmezett érték az true egyszerű mezők és null az összetett mezők esetében. |
| kereshető | Azt jelzi, hogy a mező kereshető-e teljes szöveges formátumban, és hivatkozható-e rá a keresési lekérdezésekben. Ez azt jelenti, hogy lexikális elemzésen megy keresztül, mint például szótörés az indexelés során. Ha egy kereshető mezőt olyan értékre állít be, mint a "Napos nap", a rendszer belsőleg a "napos" és a "nap" egyedi tokenekre normalizálja. Ez lehetővé teszi a kifejezések teljes szöveges keresését. A típusmezők Edm.StringCollection(Edm.String) alapértelmezés szerint kereshetők. Ennek az attribútumnak más nem összevonásos adattípusok egyszerű mezőihez kell lennie false , és összetett mezőkhöz kell lennie null .
A kereshető mezők extra helyet foglalnak el az indexben, mivel az Azure AI Keresés feldolgozza ezeknek a mezőknek a tartalmát, és kiegészítő adatstruktúrákba rendezi őket az elvégzett kereséshez. Ha helyet szeretne menteni az indexben, és nincs szüksége olyan mezőre, amely szerepel a keresésekben, állítsa be a kereshető értéket false. A részletekért tekintse meg a teljes szöveges keresés működését az Azure AI Keresésben . |
| szűrhető | Azt jelzi, hogy engedélyezi-e a mező hivatkozását a lekérdezésekben $filter . Az, hogy hogyan kezelik a sztringeket, különbözik a szűrhető és a kereshető esetében. A típus típusú Edm.String vagy Collection(Edm.String) szűrhető mezők nem esnek át lexikális elemzésen, ezért az összehasonlítások csak a pontos egyezésekre használhatók. Ha például egy ilyen mezőt f "Napos nap" értékre állít be, $filter=f eq 'sunny' akkor nem talál egyezést, de $filter=f eq 'Sunny day' igen. Ennek az attribútumnak összetett mezőkhöz kell lennie null . Az alapértelmezett érték az true egyszerű mezők és null az összetett mezők esetében. Az index méretének csökkentéséhez állítsa ezt az attribútumot false olyan mezőkre, amelyekre nem fog szűrni. |
| rendezhető | Megadja, hogy a mező engedélyezve van-e a $orderby kifejezésekben való hivatkozásokhoz. Az Azure AI Keresés alapértelmezés szerint pontszám szerint rendezi az eredményeket, de sok esetben a felhasználók a dokumentumok mezői szerint szeretnének rendezni. Egy egyszerű mező csak akkor rendezhető, ha egyértékű (egyetlen értékkel rendelkezik a szülődokumentum hatókörében).
Az egyszerű gyűjteménymezők nem rendezhetők, mivel többértékűek. Az összetett gyűjtemények egyszerű almezői szintén többértékűek, ezért nem rendezhetők. Ez igaz, akár közvetlen szülőmezőről, akár ősmezőről van szó, ez az összetett gyűjtemény. Az összetett mezők nem rendezhetők, és a rendezhető attribútumnak az ilyen mezőkhöz kell lennie null . A rendezhető alapértelmezés true az egyértékű egyszerű mezőkre, false a többértékű egyszerű mezőkre és null az összetett mezőkre vonatkozik. |
| tényezők szerint csoportosítható | Azt jelzi, hogy engedélyezi-e a mező hivatkozását az aspektusos lekérdezésekben. A találatok kategóriánkénti számát (például digitális kamerák keresését és a találatok márka, megapixel, ár stb. alapján történő megtekintését) tartalmazó találatok bemutatójában általában használják. Ennek az attribútumnak összetett mezőkhöz kell lennie null . A(z) Edm.GeographyPoint vagy Collection(Edm.GeographyPoint) típusú mezők nem tehetők facettálhatóvá. Az alapértelmezett érték az true minden más egyszerű mezőhöz. Az index méretének csökkentéséhez állítsa ezt az attribútumot false olyan mezőkre, amelyeken nem fog szembe nézni. |
| elemző | Beállítja a lexikális elemzőt a sztringek tokenizálásához az indexelési és lekérdezési műveletek során. A tulajdonság érvényes értékei közé tartoznak a nyelvelemzők, a beépített elemzők és az egyéni elemzők. Az alapértelmezett érték standard.lucene. Ez az attribútum csak kereshető sztringmezőkkel használható, és nem állítható be sem a searchAnalyzer, sem az indexAnalyzer együtt. Miután kiválasztotta az elemzőt, és a mező létrejött az indexben, a mező nem módosítható. Összetett mezőkhöz nullkell lennie. |
| keresőelemző | Állítsa be ezt a tulajdonságot az indexAnalyzerrel együtt, hogy különböző lexikális elemzőket adjon meg az indexeléshez és a lekérdezésekhez. Ha ezt a tulajdonságot használja, állítsa be az elemzőt null , és győződjön meg arról, hogy az indexAnalyzer értéke engedélyezett. A tulajdonság érvényes értékei közé tartoznak a beépített elemzők és az egyéni elemzők. Ez az attribútum csak kereshető mezőkkel használható. A keresési elemző frissíthető egy meglévő mezőn, mivel csak lekérdezési időpontban használható. Kell, hogy null legyen az összetett mezőkhöz. |
| indexElemző | Állítsa be ezt a tulajdonságot a searchAnalyzerrel együtt, hogy különböző lexikális elemzőket adjon meg az indexeléshez és a lekérdezésekhez. Ha ezt a tulajdonságot használja, állítsa be az elemzőt null-ra, és győződjön meg arról, hogy a keresési elemző értéke engedélyezett. A tulajdonság érvényes értékei közé tartoznak a beépített elemzők és az egyéni elemzők. Ez az attribútum csak kereshető mezőkkel használható. Az indexelemző kiválasztása után a mező nem módosítható. Kell, hogy null legyen az összetett mezőkhöz. |
| synonymMaps | A mezőhöz társítandó szinonimatérképek nevének listája. Ez az attribútum csak kereshető mezőkkel használható. Jelenleg mezőnként csak egy szinonimatérkép támogatott. A szinonimatérkép mezőhöz való hozzárendelése biztosítja azt a folyamatot, hogy a mezőre vonatkozó lekérdezési kifejezések lekérdezési időben kibővítve legyenek a szinonimatérkép szabályai alapján. Ez az attribútum a meglévő mezőkön módosítható. Összetett mezők esetében null kell lennie, vagy üres gyűjteménynek. |
| Mezők | Almezők listája, ha ez egy típusmező Edm.ComplexType vagy Collection(Edm.ComplexType). Egyszerű mezők esetén null vagy üres értéket kell tartalmaznia.
Az Azure AI Keresés összetett adattípusainak modellezése című témakörben találhatók további információk arról, hogy hogyan és mikor kell használni az almezőket. |
Meglévő indexek engedélyezett frissítései
Az Index létrehozása létrehozza a fizikai adatstruktúrákat (fájlokat és fordított indexeket) a keresési szolgáltatásban. Az index létrehozása után az Index létrehozása vagy frissítése funkcióval végrehajtott módosítások attól függenek, hogy a módosítások érvénytelenítenék-e ezeket a fizikai struktúrákat. A legtöbb mezőattribútum nem módosítható, ha a mező létrejött az indexben.
Az alkalmazáskódban a változás minimalizálása érdekében létrehozhat egy index aliast, amely stabil hivatkozásként szolgál a keresési indexre. A kód indexnevekkel való frissítése helyett frissítheti az index aliasát, hogy az újabb indexverziókra mutasson.
A tervezési folyamat során a változás minimalizálása érdekében az alábbi táblázat ismerteti, hogy mely elemek rögzítettek és rugalmasak a sémában. A rögzített elemek módosítása index-újraépítést igényel, míg a rugalmas elemek bármikor módosíthatók a fizikai megvalósítás befolyásolása nélkül. További információ: Index frissítése vagy újraépítése.
| Elem | Frissíthető? |
|---|---|
| Név | Nem |
| Kulcs | Nem |
| Mezőnevek és -típusok | Nem |
| Mezőattribútumok (kereshető, szűrhető, kategorizálható, rendezhető) | Nem |
| Mezőattribútum (visszakereshető) | Igen |
| Tárolt (vektorokra vonatkozik) | Nem |
| Elemző | Egyéni elemzőket adhat hozzá és módosíthat az indexben. Az elemző hozzárendeléseket sztring mezőknél csak a searchAnalyzer-et módosíthatja. Minden más hozzárendeléshez és módosításhoz újra kell építeni. |
| Pontozási profilok | Igen, létrehozhat és szerkeszthet pontozási profilokat újraépítés nélkül. |
| Javaslattevők | Nem |
| forrásközi erőforrás-megosztás (CORS) | Igen |
| Titkosítás | Igen, frissítheti egy meglévő titkosítási definíció összes részét. |
| Szinonimák térképei | Igen, szinonimatérképeket hozhat létre és szerkeszthet újraépítés nélkül. |
| Szemantikai konfiguráció | Igen, létrehozhat és szerkeszthet szemantikai konfigurációkat újraépítés nélkül. |
Forrásközi lekérdezések beállítása corsOptions
Az indexsémák egy szakaszt tartalmaznak a corsOptions beállításához. Alapértelmezés szerint az ügyféloldali JavaScript nem tud api-kat meghívni, mert a böngészők megakadályozzák az összes forrásközi kérést. Ha engedélyezni szeretné a forrásközi lekérdezéseket az indexen keresztül, engedélyezze a CORS-t (forrásközi erőforrás-megosztást) a corsOptions attribútum beállításával. Biztonsági okokból csak a lekérdezési API-k támogatják a CORS-t.
"corsOptions": {
  "allowedOrigins": [
    "*"
  ],
  "maxAgeInSeconds": 300
A CORS esetében a következő tulajdonságok állíthatók be:
allowedOrigins (kötelező): Ez az indexhez hozzáféréssel rendelkező eredetek listája. Az ilyen forrásból kiszolgált JavaScript-kód lekérdezheti az indexet (feltéve, hogy a hívó érvényes kulcsot biztosít vagy rendelkezik engedélyekkel). Az egyes eredetek általában a
protocol://<fully-qualified-domain-name>:<port>formájúak, bár a<port>gyakran elmarad. További információ: Forrásközi erőforrás-megosztás (Wikipédia).Ha engedélyezni szeretné az összes forráshoz való hozzáférést, az engedélyezettOrigins tömbben egyetlen elemként szerepeljen
*. Ez nem ajánlott eljárás éles keresési szolgáltatásokhoz , de gyakran hasznos a fejlesztéshez és a hibakereséshez.maxAgeInSeconds (nem kötelező): A böngészők ezt az értéket használják a CORS elővizsgálati válaszok gyorsítótárazási időtartamának (másodpercben) meghatározásához. Ennek nem negatív egész számnak kell lennie. A hosszabb gyorsítótárazási időszak jobb teljesítményt nyújt, de meghosszabbítja azt az időt, amely szükséges ahhoz, hogy a CORS-szabályzat érvénybe lépjen. Ha ez az érték nincs beállítva, a rendszer az alapértelmezett öt perces időtartamot használja.
Következő lépések
Az alábbi hivatkozásokon megismerheti az indexhez hozzáadható speciális funkciókat:
- Vektormezők és vektorprofilok hozzáadása
- Pontozási profilok hozzáadása
- Szemantikai rangsorolás hozzáadása
- Javaslattevők hozzáadása
- Szinonimatérképek hozzáadása
- Elemzők hozzáadása
- Titkosítás hozzáadása
Index betöltéséhez vagy frissítéséhez használja az alábbi hivatkozásokat: