メモ
Azure AI 検索は、Azure ポータル、REST API、およびAzure SDKから使用できます。 また、Foundry IQ は、エンタープライズ コンテンツを、Microsoft Foundry ポータルのエージェントの再利用可能なアクセス許可に対応したナレッジ ベースに変換するマネージド ナレッジ レイヤーです。
この記事では、インクリメンタル インデックスを使用して、スキーマの変更またはコンテンツの変更を使用して、Azure AI 検索の既存のインデックスを更新する方法について説明します。
ヒント
ドキュメントをすぐに更新するには、「 コンテンツの更新」に進みます。 スキーマの変更については、 インデックス スキーマの更新に関する記事を参照してください。
前提 条件
ドキュメントを含む既存の検索インデックス。 この記事では、インデックスを 既に作成 し、 ドキュメントを読み込んでいるものとします。
インデックスを更新または再構築するためのアクセス許可:
- キーベースの認証: 検索サービスの 管理 API キー 。
- ロールベースの認証: インデックス データ共同作成者 ロールを検索してドキュメントを更新するか、 Search Service Contributor でスキーマを変更します。
SDK 開発の場合は、Azure Search クライアント ライブラリをインストールします。
- Python: azure-search-documents
- .NET: Azure。Search.Documents
- JavaScript: @azure/search-documents
- Java: azure-search-documents
ヒント
アクティブな開発中は、インデックスデザインを反復処理するときにインデックスを削除して再構築するのが一般的です。 インデックスの再作成が高速化されるように、データの代表的な小さなサンプルを操作します。 運用スキーマの変更の場合は、新しいインデックスを並べて作成してテストし、アプリケーション コードを変更せずに インデックスエイリアス を使用してインデックスをスワップします。
コンテンツを更新する
ソース データの変更に対するインデックスの増分インデックス作成と同期は、ほとんどの検索アプリケーションの基礎となります。 このセクションでは、REST API を使用して検索インデックスのコンテンツを追加、削除、または上書きするワークフローについて説明しますが、Azure SDKは同等の機能を提供します。
要求の本文には、インデックスを作成する 1 つ以上のドキュメントが含まれています。 要求内では、インデックス内の各ドキュメントは次のようになります。
- 大文字と小文字を区別する一意のキーによって識別されます。
- アクション "upload"、"delete"、"merge"、または "mergeOrUpload" に関連付けられます。
- 追加または更新する各フィールドの名前と値のペアのセットが設定されます。
{
  "value": [
    {
      "@search.action": "upload (default) | merge | mergeOrUpload | delete",
      "key_field_name": "unique_key_of_document", (key/value pair for key field from index schema)
      "field_name": field_value (name/value pairs matching index schema)
        ...
    },
    ...
  ]
}
リファレンス:ドキュメント - インデックス
最初に、Documents - Index (REST) などのドキュメントを読み込むための API、またはAzure SDK内の同等の API を使用します。 インデックス作成手法の詳細については、「 ドキュメントの読み込み」を参照してください。
大規模な更新では、バッチ処理 (バッチあたり最大 1,000 ドキュメント、またはバッチあたり約 16 MB、どちらか早い方) が推奨され、インデックス作成のパフォーマンスが大幅に向上します。
API に
@search.actionパラメーターを設定して、既存のドキュメントへの影響を判断します。mergeOrUploadは増分更新(最も一般的)、deleteはドキュメントを削除するため、または既存のドキュメントの部分的なフィールド更新にはmergeを使用してください。アクション 効果 削除する インデックスからドキュメント全体を削除します。 個々のフィールドを削除する場合は、代わりにマージを使用し、対象のフィールドを null に設定します。 削除されたドキュメントとフィールドは、インデックス内の領域をすぐに解放しません。 数分ごとに、バックグラウンド プロセスによって物理的な削除が実行されます。 Azure ポータルまたは API を使用してインデックス統計を返す場合でも、Azure ポータルと API を使用して削除が反映されるまでに少しの遅延が発生する可能性があります。 詳細については、「 検索インデックス内のドキュメントを削除する」を参照してください。 マージ 既に存在するドキュメントを更新し、見つからないドキュメントはエラーになります。 マージによって既存の値が置き換えられます。 このため、 Collection(Edm.String)型のフィールドなど、複数の値を含むコレクション フィールドを確認してください。 たとえば、tagsフィールドが["budget"]の値で始まり、["economy", "pool"]とのマージを実行した場合、tagsフィールドの最終的な値は["economy", "pool"]。["budget", "economy", "pool"]されません。
複雑なコレクションにも同じ動作が適用されます。 値が[{ "Type": "Budget Room", "BaseRate": 75.0 }]の Rooms という名前の複合コレクション フィールドがドキュメントに含まれており、値が[{ "Type": "Standard Room" }, { "Type": "Budget Room", "BaseRate": 60.5 }]のマージを実行すると、Rooms フィールドの最終的な値が[{ "Type": "Standard Room" }, { "Type": "Budget Room", "BaseRate": 60.5 }]されます。 新しい値と既存の値は追加またはマージされません。マージまたはアップロード ドキュメントが存在する場合はマージと同様に動作し、ドキュメントが新しい場合はアップロードします。 これは、増分更新の最も一般的なアクションです。 アップロード ドキュメントが新しい場合は挿入され、存在する場合は更新または置き換えられる "upsert" と同様です。 ドキュメントにインデックスに必要な値がない場合、ドキュメント フィールドの値は null に設定されます。
クエリはインデックス作成中も引き続き実行されますが、既存のフィールドを更新または削除する場合は、混合結果と調整の発生率が高くなる可能性があります。
メモ
要求本文で最初に実行されるアクションの順序付け保証はありません。 1 つの要求本文で、同じドキュメントに複数の "マージ" アクションを関連付けすることはお勧めしません。 同じドキュメントに複数の "マージ" アクションが必要な場合は、検索インデックス内のドキュメントを更新する前に、マージ クライアント側を実行します。
応答
正常に応答するために状態コード 200 が返されます。つまり、すべての項目が永続的に格納され、インデックスが作成され始めます。 インデックス作成はバックグラウンドで実行され、インデックス作成操作が完了してから数秒後に新しいドキュメントを使用できるようになります (つまり、クエリ可能で検索可能)。 特定の遅延は、サービスの負荷によって異なります。
インデックス作成が成功すると、すべてのアイテムに対して status プロパティが true に設定され、 statusCode プロパティは 201 (新しくアップロードされたドキュメントの場合) または 200 (マージまたは削除されたドキュメントの場合) に設定されます。
{
  "value": [
    {
      "key": "unique_key_of_new_document",
      "status": true,
      "errorMessage": null,
      "statusCode": 201
    },
    {
      "key": "unique_key_of_merged_document",
      "status": true,
      "errorMessage": null,
      "statusCode": 200
    },
    {
      "key": "unique_key_of_deleted_document",
      "status": true,
      "errorMessage": null,
      "statusCode": 200
    }
  ]
}
少なくとも 1 つの項目のインデックスが正常に作成されなかった場合、状態コード 207 が返されます。 インデックスが作成されていないアイテムには、状態フィールドが false に設定されています。
errorMessageプロパティとstatusCode プロパティは、インデックス作成エラーの理由を示します。
{
  "value": [
    {
      "key": "unique_key_of_document_1",
      "status": false,
      "errorMessage": "The search service is too busy to process this document. Please try again later.",
      "statusCode": 503
    },
    {
      "key": "unique_key_of_document_2",
      "status": false,
      "errorMessage": "Document not found.",
      "statusCode": 404
    },
    {
      "key": "unique_key_of_document_3",
      "status": false,
      "errorMessage": "Index is temporarily unavailable because it was updated with the 'allowIndexDowntime' flag set to 'true'. Please try again later.",
      "statusCode": 422
    }
  ]
}
errorMessage プロパティは、可能であればインデックス作成エラーの理由を示します。
次の表では、応答で返すことができるドキュメントごとのさまざまな状態コードについて説明します。 一部の状態コードは要求自体の問題を示し、他の状態は一時的なエラー状態を示します。 後者は、遅延後に再試行する必要があります。
| 状態コード | 意味 | 再試行可能 | ノート |
|---|---|---|---|
| 200 | ドキュメントが正常に変更または削除されました。 | N/a | 削除操作はべき等です。 つまり、ドキュメント キーがインデックスに存在しない場合でも、そのキーを使用して削除操作を試みると、状態コードが 200 になります。 |
| 201 | ドキュメントが正常に作成されました。 | N/a | |
| 400 | ドキュメントに、インデックスの作成を妨げるエラーが発生しました。 | いいえ | 応答のエラー メッセージは、ドキュメントの問題を示します。 |
| 404 | 指定されたキーがインデックスに存在しないため、ドキュメントをマージできませんでした。 | いいえ | このエラーは新しいドキュメントを作成するため、アップロードでは発生しません。また、削除は冪等性があるため、発生しません。 |
| 409 | ドキュメントのインデックスを作成しようとしたときに、バージョンの競合が検出されました。 | はい | これは、同じドキュメントのインデックスを複数回同時に作成しようとすると発生する可能性があります。 |
| 422 | インデックスは、'allowIndexDowntime' フラグが 'true' に設定されて更新されたため、一時的に使用できません。 | はい | |
| 429 | 要求が多すぎます | はい | インデックス作成中にこのエラー コードが表示される場合は、通常、ストレージが不足していることを意味します。 ストレージの制限に近付くと、一部のドキュメントを削除するまでサービスは追加または更新できない状態になります。 詳細については、「容量を 計画して管理 する」を参照するか、ドキュメントを削除して容量を解放してください。 |
| 503 | 検索サービスは、負荷が高いため、一時的に使用できません。 | はい | コードは、この場合に再試行する前に待機する必要があります。さもなければ、サービスの利用不可が長引く危険性があります。 |
クライアント コードで 207 応答が頻繁に発生する場合、考えられる理由の 1 つは、システムが負荷がかかっているということです。 これを確認するには、statusCode プロパティで 503 を確認します。 statusCode が 503 の場合は、インデックス作成要求を調整することをお勧めします。 それ以外の場合、トラフィックのインデックス作成が沈静化しない場合、システムは 503 エラーですべての要求の拒否を開始する可能性があります。
状態コード 429 は、インデックスあたりのドキュメント数のクォータを超えたことを示します。 容量制限を高くするためにアップグレードするか、新しいインデックスを作成する必要があります。
メモ
タイム ゾーン情報を含む DateTimeOffset 値をインデックスにアップロードすると、これらの値Azure AI 検索 UTC に正規化されます。 たとえば、2024-01-13T14:03:00-08:00 は 2024-01-13T22:03:00Z として格納されます。 タイム ゾーン情報を格納する必要がある場合は、このデータ ポイントのインデックスに列を追加します。
増分インデックス作成のヒント
インデクサーは増分インデックス作成を自動化します。 インデクサーを使用でき、データ ソースが変更の追跡をサポートしている場合は、定期的なスケジュールでインデクサーを実行して、検索可能なコンテンツを追加、更新、または上書きして、外部データと同期させることができます。
プッシュ API を介してインデックス呼び出しを直接行う場合は、検索アクションとして
mergeOrUploadを使用します。ペイロードには、追加、更新、または削除するすべてのドキュメントのキーまたは識別子が含まれている必要があります。
インデックスにベクター フィールドが含まれており、
storedプロパティを false に設定する場合は、値が変更されていない場合でも、部分的なドキュメント更新でベクターを指定してください。storedを false に設定すると、インデックス再作成操作でベクターが削除されるという副作用があります。 ドキュメント ペイロードにベクターを指定すると、このようなことが起こらないようにします。複合型の単純フィールドとサブフィールドの内容を更新するには、変更するフィールドのみを一覧表示します。 たとえば、説明フィールドのみを更新する必要がある場合、ペイロードはドキュメント キーと変更された説明で構成されている必要があります。 他のフィールドを省略すると、既存の値が保持されます。
インライン変更を文字列コレクションにマージするには、値全体を指定します。 前のセクションの
tagsフィールドの例を思い出してください。 新しい値は、フィールド全体の古い値を上書きします。フィールドの内容内にマージはありません。
これらのヒントを示す REST API の例 を次に示します。
### Get Stay-Kay City Hotel by ID
GET  {{baseUrl}}/indexes/hotels-vector-quickstart/docs('1')?api-version=2026-04-01  HTTP/1.1
    Content-Type: application/json
    api-key: {{apiKey}}

### Change the description, city, and tags for Stay-Kay City Hotel
POST {{baseUrl}}/indexes/hotels-vector-quickstart/docs/search.index?api-version=2026-04-01  HTTP/1.1
  Content-Type: application/json
  api-key: {{apiKey}}

    {
        "value": [
            {
            "@search.action": "mergeOrUpload",
            "HotelId": "1",
            "Description": "I'm overwriting the description for Stay-Kay City Hotel.",
            "Tags": ["my old item", "my new item"],
            "Address": {
                "City": "Gotham City"
                }
            }
        ]
    }

### Retrieve the same document, confirm the overwrites and retention of all other values
GET  {{baseUrl}}/indexes/hotels-vector-quickstart/docs('1')?api-version=2026-04-01  HTTP/1.1
    Content-Type: application/json
    api-key: {{apiKey}}
リファレンス:ドキュメント - インデックス、 参照ドキュメント
SDK の例
次の例では、Azure SDKを使用してドキュメントを更新する方法を示します。
from azure.core.credentials import AzureKeyCredential
from azure.search.documents import SearchClient

# Set up the client
service_name = "<your-search-service-name>"
index_name = "hotels-sample"
api_key = "<your-admin-api-key>"

endpoint = f"https://{service_name}.search.windows.net"
credential = AzureKeyCredential(api_key)
client = SearchClient(endpoint=endpoint, index_name=index_name, credential=credential)

# Update documents using merge_or_upload
documents = [
    {
        "HotelId": "1",
        "Description": "Updated description for the hotel.",
        "Tags": ["updated", "renovated"]
    }
]

result = client.merge_or_upload_documents(documents=documents)
print(f"Updated {len(result)} document(s)")
Reference:SearchClient、 merge_or_upload_documents
インデックス スキーマを更新する
インデックス スキーマは、検索サービスで作成された物理データ構造を定義するため、完全な再構築を行わずに行うことができるスキーマの変更はあまりありません。
リビルドなしの更新プログラム
次の一覧は、既存のインデックスにシームレスに導入できるスキーマの変更を列挙したものです。 一般に、一覧には、クエリの実行中に使用される新しいフィールドと機能が含まれています。
- インデックスの説明を追加する
- 新しいフィールドを追加する
- 既存のフィールドに
retrievable属性を設定する -
searchAnalyzerを既存のindexAnalyzerを持つフィールド上で更新する - インデックスに新しい アナライザー定義 を追加する (新しいフィールドに適用できます)
- スコアリング プロファイルの追加、更新、または削除
- シノニム マップの追加、更新、または削除
- セマンティック構成の追加、更新、または削除
- CORS 設定の追加、更新、または削除
操作の順序は次のとおりです。
前の一覧の更新内容を使用してスキーマを修正します。
検索サービスのインデックス スキーマを更新します。
新しいフィールドを追加した場合は、変更したスキーマに合わせてインデックスの内容を更新します。 その他のすべての変更では、既存のインデックス付きコンテンツが as-is使用されます。
新しいフィールドを含むようにインデックス スキーマを更新すると、インデックス内の既存のドキュメントには、そのフィールドの null 値が与えられます。 次のインデックス作成ジョブでは、外部ソース データの値によって、Azure AI 検索によって追加された null が置き換えられます。
更新中にクエリが中断されることはありませんが、更新が有効になるとクエリの結果が異なります。
リビルドが必要な更新プログラム
一部の変更では、インデックスの削除と再構築が必要であり、現在のインデックスを新しいインデックスに置き換える必要があります。
| アクション | 説明 |
|---|---|
| フィールドを削除する | フィールドのすべてのトレースを物理的に削除するには、インデックスを再構築する必要があります。 即時再構築が実用的でない場合は、古いフィールドからアクセスをリダイレクトするようにアプリケーション コードを変更するか 、searchFields を使用してクエリ パラメーター を選択 して、検索して返されるフィールドを選択できます。 物理的には、フィールドの定義と内容は、問題のフィールドを省略するスキーマを適用するときに、次の再構築までインデックスに残ります。 |
| フィールド定義を変更する | フィールド名、データ型、または特定の インデックス属性 (検索可能、フィルター可能、並べ替え可能、ファセット可能) の変更には、完全な再構築が必要です。 |
| フィールドにアナライザーを割り当てる | アナライザー はインデックスで定義され、フィールドに割り当てられ、インデックス作成中に呼び出され、トークンの作成方法が通知されます。 新しいアナライザー定義はいつでもインデックスに追加できますが、アナライザーはフィールドの作成時にのみ 割り当てることができます 。 これは、 アナライザー プロパティと indexAnalyzer プロパティの両方に当てはまります。 searchAnalyzer プロパティは例外です (このプロパティを既存のフィールドに割り当てることができます)。 |
| インデックス内のアナライザー定義を更新または削除する | インデックス全体を再構築しない限り、インデックス内の既存のアナライザー構成 (アナライザー、トークナイザー、トークン フィルター、または文字フィルター) を削除または変更することはできません。 |
| suggester にフィールドを追加する | フィールドが既に存在し、 Suggesters コンストラクトに追加する場合は、インデックスを再構築します。 |
| サービスまたはレベルをアップグレードする | さらに容量が必要な場合は、 サービスをアップグレード できるか、 より高い価格レベルに切り替えることができるか確認してください。 そうでない場合は、新しいサービスを作成し、インデックスを最初から再構築する必要があります。 このプロセスを自動化するために、インデックスを一連の JSON ファイルにバックアップするコード サンプルを使用できます。 その後、指定した検索サービスでインデックスを再作成できます。 |
操作の順序は次のとおりです。
将来参照する必要がある場合や、新しいバージョンの基礎として使用する場合に備えて、インデックス定義を取得します。
バックアップと復元のソリューションを使用して、インデックス コンテンツのコピーを保持することを検討してください。 C# および Python にソリューションがあります。 Pythonバージョンは最新のものであるため、お勧めします。
検索サービスの容量がある場合は、新しいインデックスの作成とテスト中に既存のインデックスを保持します。
既存のインデックスを削除します。 インデックスを対象とするクエリはすぐに削除されます。 インデックスの削除は元に戻せないので、フィールド コレクションやその他のコンストラクトの物理ストレージは破棄されます。
変更されたインデックスを投稿します。要求の本文には、変更または変更されたフィールドの定義と構成が含まれます。
外部ソースからドキュメントを含むインデックスを読み込みます。 ドキュメントは、新しいスキーマのフィールド定義と構成を使用してインデックスが作成されます。
インデックスを作成すると、物理ストレージがインデックス スキーマ内の各フィールドに割り当てられ、検索可能なフィールドごとに反転インデックスが作成され、各ベクター フィールドに対してベクター インデックスが作成されます。 検索できないフィールドはフィルターや式で使用できますが、逆インデックスがなく、フルテキスト検索やあいまい検索はできません。 インデックスの再構築では、これらの逆インデックスとベクター インデックスが削除され、指定したインデックス スキーマに基づいて再作成されます。
アプリケーション コードの中断を最小限に抑えるには、 インデックスエイリアスを作成することを検討してください。 アプリケーション コードはエイリアスを参照しますが、エイリアスが指すインデックスの名前を更新できます。
インデックスの説明を追加する
インデックスには description プロパティがあり、システムが複数のインデックスにアクセスし、説明に基づいて決定する必要がある場合に使用できます。 実行時に適切なインデックスを選択する必要があるモデル コンテキスト プロトコル (MCP) サーバーについて考えてみましょう。 決定は、インデックス名だけでではなく、説明に基づいて行うことができます。
インデックスの説明はスキーマの更新であり、インデックス全体を再構築しなくても追加できます。
- 文字列の長さは最大 4,000 文字です。
- Unicode では、コンテンツは人間が判読できる必要があります。 ユース ケースで、使用する言語を決定する必要があります。
Azure ポータル、最新の安定した REST API、または機能を提供するAzure SDK パッケージを使用して、インデックスの説明を追加できます。
Azure ポータルでは、最新のプレビュー API がサポートされています。
Azure ポータルで検索サービスに移動します。
[ 検索の管理>インデックス] で、インデックスを選択します。
[ JSON の編集] を選択します。
"description"を挿入し、その後に説明を挿入します。 値は 4,000 文字未満で、Unicode で指定する必要があります。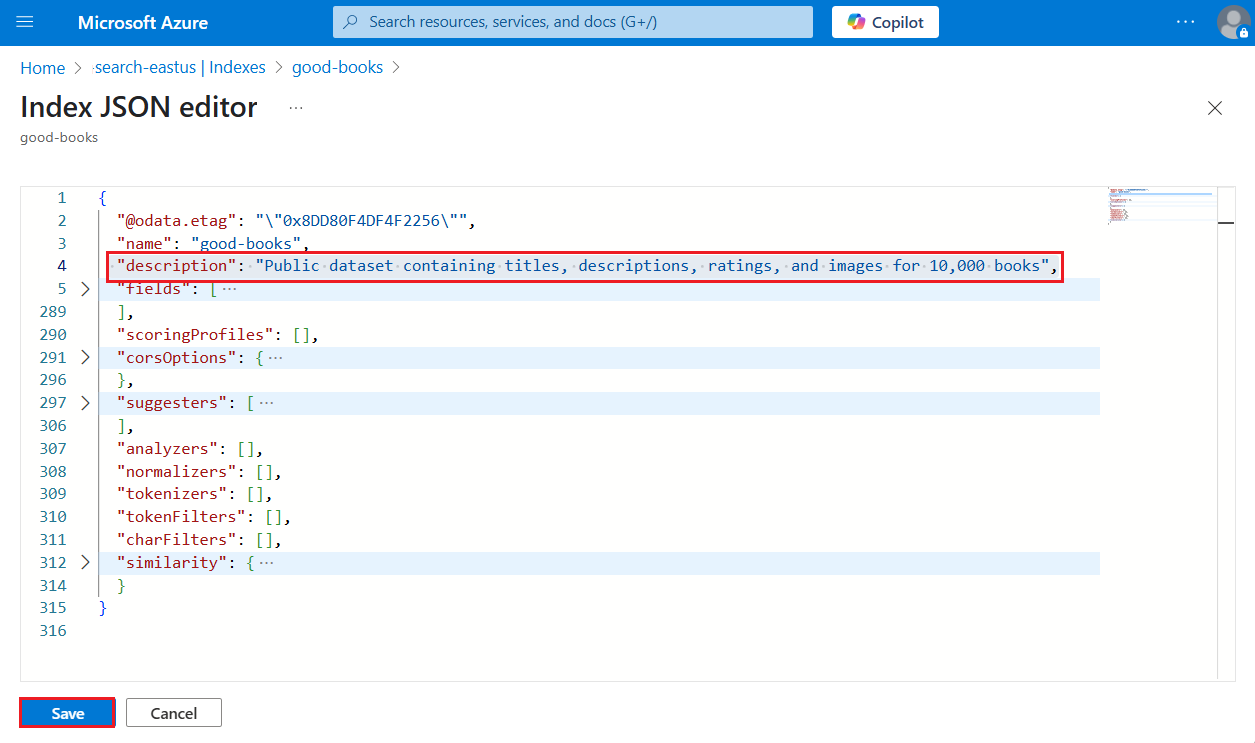
インデックスを保存します。
ワークロードの分散
インデックス作成はバックグラウンドでは実行されませんが、検索サービスはインデックス作成ジョブと進行中のクエリのバランスを取ります。 インデックス作成中に、Azure ポータルでクエリ要求を<>監視して、クエリがタイムリーに完了するようにすることができます。
インデックス作成ワークロードで許容できないレベルのクエリ待機時間が発生する場合は、 パフォーマンス分析 を実施し、潜在的な軽減策についてこれらの パフォーマンスのヒント を確認してください。
更新プログラムを確認する
最初のドキュメントが読み込まれたらすぐにインデックスのクエリを開始できます。 ドキュメントの ID がわかっている場合、 Lookup Document REST API は特定のドキュメントを返します。 より広範なテストでは、インデックスが完全に読み込まれるまで待ってから、クエリを使用して、表示されるコンテキストを確認する必要があります。
Search Explorer または REST クライアントを使用して、更新されたコンテンツを確認できます。
フィールドを追加または名前変更した場合は、 select を使用してそのフィールドを返します。
"search": "*",
"select": "document-id, my-new-field, some-old-field",
"count": true
Azure ポータルには、インデックス サイズとベクター インデックス サイズが用意されています。 これらの値はインデックスの更新後に確認できますが、サービスが変更を処理し、ポータルの更新レートを考慮するため、少しの遅延が予想されることを忘れないでください。これは数分です。
インデックス再作成のトラブルシューティング
次の表に、インデックスを更新または再構築するときの一般的な問題とその解決方法を示します。
| 問題 | 原因 | 解決方法 |
|---|---|---|
| 混合結果を含む 207 応答 | 成功したドキュメントもあれば失敗したドキュメントもあります。 | 応答する各ドキュメントの statusCode を確認します。 503 の場合は、要求を制限して再試行します。 |
| 409 バージョンの競合 | 同じドキュメントに対する同時更新。 | 更新プログラムを同じドキュメントにシリアル化するか、指数バックオフを使用して再試行を実装します。 |
| 429 要求が多すぎます | ストレージ クォータが超過したか、同時要求が多すぎます。 | ドキュメントを削除して空き領域を増やすか、サービス レベルをアップグレードして容量を増やします。 |
| 503 サービスを利用できない | 負荷が高いサービス。 | 指数バックオフを使用して待機して再試行します。 バッチ サイズを小さくすることを検討してください。 |
| 削除後にドキュメント数が変更されない | 削除は非同期です。 | バックグラウンド プロセスが物理的な削除を完了するまで 2 ~ 3 分待ちます。 |
| 新しいフィールドが null を返す | スキーマに追加されたフィールドですが、ドキュメントのインデックスは再作成されません。 | インデクサーを実行するか、更新されたドキュメントをプッシュして新しいフィールドを設定します。 |
| スキーマの変更が拒否されました | 互換性のない変更が試行されました (名前の変更、型の変更)。 | インデックスを削除して再構築します。 ダウンタイムを最小限に抑えるには、インデックスエイリアスを使用します。 |