メモ
Azure AI 検索は、Azure ポータル、REST API、およびAzure SDKから使用できます。 また、Foundry IQ は、エンタープライズ コンテンツを、Microsoft Foundry ポータルのエージェントの再利用可能なアクセス許可に対応したナレッジ ベースに変換するマネージド ナレッジ レイヤーです。
Azure AI 検索には、容量を異なる方法で処理する 2 つの価格モデルが用意されています。
専用: レプリカとパーティションのサイズを設定し、サービス レベルを選択して容量を計画します。
- レプリカとパーティションを使用して容量を直接事前プロビジョニングします。
- 必要なストレージ (パーティション) と必要なスループット (レプリカ) を見積もります。
- 予想されるピーク需要に基づいて必要な容量をプロビジョニングするサービス レベルを選択します。
- 容量を事前に構成したら、使用量に関係なく、検索ユニット (SU) によって測定された時間単位の料金を支払います。
サーバーレス (プレビュー):サービスは、使用量とサービスの制限に基づいて容量を自動的に管理します。 容量を事前にプロビジョニングする必要はありません。 代わりに、ワークロードの効率を最適化してコストを管理します。
- 容量は需要に応じて自動的にスケーリングされます (アイドル時にはゼロにスケーリングできます)。
- コンピューティング ユニット (CU) とストレージによって測定された実際の使用量に基づいて課金されます。
- 計画では、インフラストラクチャではなく、クエリ パターン、インデックスのサイズと増加、データ インジェスト パターンなどのコスト 要因に重点を置いています。 サーバーレス モデルのコストの最適化を参照してください。
| ディメンション | Dedicated | Serverless |
|---|---|---|
| 容量モデル | 割り当て済み (レプリカ × パーティション) | 従量課金型 |
| Scaling | 手動 | 自動 |
| ユーザー コントロール | 明示的 (レプリカとパーティションの構成) | 間接(ワークロードの特性の影響を受ける) |
| Billing | 検索ユニットあたりの固定時間単価 (SU) | コンピューティング ユニット (CU) とストレージに対する従量課金ベースの支払い |
| 遊休コスト | 常に発生する料金(最小プロビジョニング容量) | アイドル時にゼロにスケーリング |
| 最適化の重点 | インフラストラクチャのサイズ設定 | ワークロードの効率 |
| 最適な用途 | 予測可能で安定したワークロード | エージェント駆動型のシナリオを含む、可変ワークロード、バーストワークロード、マルチテナント ワークロード |
| 容量計画のアプローチ | インフラストラクチャのサイズとスケール (レプリカとパーティション) | ワークロードの効率と使用パターンを最適化する |
| 非効率性への影響 | レイテンシとスケーリングのプレッシャー | 直接コストの増加 |
Important
サーバーレス開発者レベルは現在プレビュー段階です。 このプレビュー版はサービス レベル アグリーメントなしで提供されています。運用環境のワークロードに使用することはお勧めできません。 特定の機能がサポートされていないか、機能が制限されている可能性があります。 詳細については、「 Microsoft Azure プレビューの追加使用条件」を参照してください。
サーバーレス開発者レベルの課金は、2026 年 9 月 13 日に開始されました。 その日以降の使用量の料金は、Azure請求書に表示されます。 2026 年 9 月 13 日より前の使用には課金されません。
サーバーレス開発者レベルでは、他の価格レベルとの間の移行はサポートされていません。また、他のレベルで使用できる一部の機能は、パブリック プレビュー中はサポートされていません。 サービスの制限、サポートされている機能、および価格の詳細は、一般公開前に変更される可能性があります。
プレビュー期間中、サーバーレス価格モデルは 特定のリージョンでのみサポートされます。
詳細については、次の方法を参照してください。
専用モデルの容量を計画する
専用モデルでは、 検索ユニット (SU) を使用して容量をプロビジョニングします。
- 検索ユニット (SU) = パーティション×レプリカ
- レプリカ: 検索エンジンのコピー。 クエリのスループットと高可用性を提供します。
- パーティション: ストレージの単位。 ストレージとインデックス作成のスループットを提供します。
各サービスは、1 つのレプリカ × 1 つのパーティション (1 SU) で開始されます。 変動するワークロードに対応するために、レプリカとパーティションを個別に追加または削除できます。 容量を追加すると、検索サービスを実行するコストが増加します。
| 概念 | 定義 |
|---|---|
| 検索単位 | 使用可能な合計容量の 1 つの増分。 サービスを実行するには、少なくとも 1 つの検索ユニットが必要です。 価格レベルに応じて、最大の範囲は 1 から 36 ユニットです。 検索単位の数は、レプリカの数にパーティションの数 (R × P = SU) を掛けた値と等しくなります。 各サービスは、1 つのレプリカと 1 つのパーティションから始まり、1 つのユニット (1 × 1 = 1) を消費します。 2 つ目のレプリカを追加すると、2 × 1 = 2 という 2 つのユニットが消費されます。 検索単位は、検索サービスの課金単位でもあります。 |
| [レプリカ] | 主にクエリ操作の負荷分散に使用される Search サービスのインスタンスです。 各レプリカは、インデックスの 1 つのコピーをホストします。 3 つのレプリカを割り当てると、クエリ要求のサービスに使用できるインデックスのコピーが 3 つ作成されます。 |
| "パーティション" | 読み取り/書き込み操作 (たとえば、インデックスを再構築または更新する場合など) のための物理ストレージと I/O。 各パーティションにインデックス全体のスライスがあります。 3 つのパーティションを割り当てると、インデックスは 3 つに分割されます。 |
パーティションとレプリカのテーブルで、36 ユニットの制限を超えない可能性のある組み合わせを確認します。
処理速度やディスク IO など、レプリカとパーティションの物理的な特性は、 サービス レベルによって異なります。 標準の検索サービスでは、レプリカとパーティションは基本サービスにあるものよりも高速で大きくなります。
専用モデルの容量を追加するタイミング
次の場合は、レプリカまたはパーティションを追加することを検討してください。
- クエリのレイテンシが増加する、またはサービス レベル アグリーメントの基準が満たされない。
- HTTP 503 (サービス利用不可) エラーの頻度が増加します。
- HTTP 429(リクエストが多すぎます)エラーの発生頻度が増加しており、リクエストのスロットリングが行われていることを示しています。
- 大規模なクエリ ボリュームが必要です。
- インデックス作成ジョブの処理が遅いか、追いついていません。
- ストレージまたはインデックス作成のスループットが不十分です。
スケーリングガイダンス:
- レプリカを追加して、クエリのスループットと可用性を向上させます。
- パーティションを追加して、ストレージとインデックス作成のパフォーマンスを向上させます。
- クエリ負荷の高いワークロードでは、通常、より多くのレプリカが必要です。
- 大規模なインデックスでは、パフォーマンスを維持するために追加のレプリカが必要になる場合があります。
Important
スケーリング操作の完了とコストの増加には時間がかかる場合があります。 パフォーマンス テストと価格の見積もりを使用して、常に変更を検証します。
選択するサービス レベルによって、パーティションのサイズと速度が決まります。 各層は、さまざまなシナリオに適合する一連の特性に合わせて最適化されています。 ハイエンド レベルを選択した場合は、S1 を使用する場合よりもパーティション数を減らす必要がある場合があります。 セルフダイレクト テストを通じて回答する必要がある質問の 1 つは、より大きくコストの高いパーティションの方が、下位レベルでプロビジョニングされたサービスで 2 つの安価なパーティションよりもパフォーマンスが向上するかどうかです。
1 つのサービスに、すべてのワークロード (インデックスおよびクエリ) を処理するための十分なリソースが必要です。 どちらのワークロードもバックグラウンドで実行されません。 クエリ要求の頻度が自然に低い時間にインデックス作成をスケジュールできますが、それ以外の場合、サービスは 1 つのタスクに優先順位を付けることはできません。 さらに、ある程度の冗長性により、サービスまたはノードが内部的に更新されるときのクエリのパフォーマンスの問題を解決します。
一般的な規則として、検索アプリケーションでは、パーティションよりもレプリカの方が多く必要となる傾向があります。特に、サービス操作でクエリ ワークロードの比重が高い場合は、その傾向が強まります。 各レプリカはインデックスのコピーであるため、サービスは複数のコピーに対して要求を負荷分散できます。 Azure AI 検索は、インデックスのすべての負荷分散とレプリケーションを管理します。 サービスに割り当てられたレプリカの数はいつでも変更できます。 Standard Search サービスでは最大 12 個、Basic Search サービスでは最大 3 個のレプリカを割り当てることができます。 レプリカの割り当ては、Azure ポータルまたはプログラムのいずれかのオプションから行うことができます。
追加のパーティションは、集中的なインデックス作成ワークロードに役立ちます。 追加のパーティションにより、読み取り操作と書き込み操作が多数のコンピューティング リソースに分散されます。
最後に、インデックスが大きくなると、クエリの実行に時間がかかります。 そのため、パーティションで段階的に増加すれば、レプリカでも小規模ながら比例して増加するべきであると考えるかもしれません。 クエリの内容とその量の複雑さが、どれほど速くクエリが処理されるかに影響を与えます。
サービスの制限と有効なスケーリング範囲については、次を参照してください。
メモ
レプリカやパーティションを追加すると、サービスの実行コストが増加し、結果の並べ替え方法が少し変化する可能性があります。 ノードを追加した場合の課金の影響を理解するには、料金計算ツール を必ず確認してください。 パーティションとレプリカの組み合わせテーブルは、特定の構成に必要な検索単位の数を相互参照するのに役立ちます。 追加のレプリカがクエリ処理に与える影響の詳細については、「 結果の順序付け」を参照してください。
容量を管理および調整する方法
容量の変更は瞬時には行われません。 データ量と操作の種類によっては、スケーリングに数分から数時間かかる場合があります。
検索サービスをスケーリングする場合は、次のツールと方法で選択できます。
メモ
検索サービスが 2024 年 4 月または 5 月より前に作成された場合、追加コストなしでパーティション サイズが大きい新しいインフラストラクチャへの 1 回限りアップグレードの対象になる可能性があります。 このアップグレードにより、パーティションごとに使用可能なストレージを増やし、ワークロードに必要なパーティションの数を減らすことができます。 詳細については、「 検索サービスのアップグレード」を参照してください。
サービスの容量を増減するには、次の 2 つのオプションがあります。
パーティションとレプリカを追加または削除する
Azure ポータルで検索サービスに移動します。
左側のペインで [設定]>[スケール] を選択します。
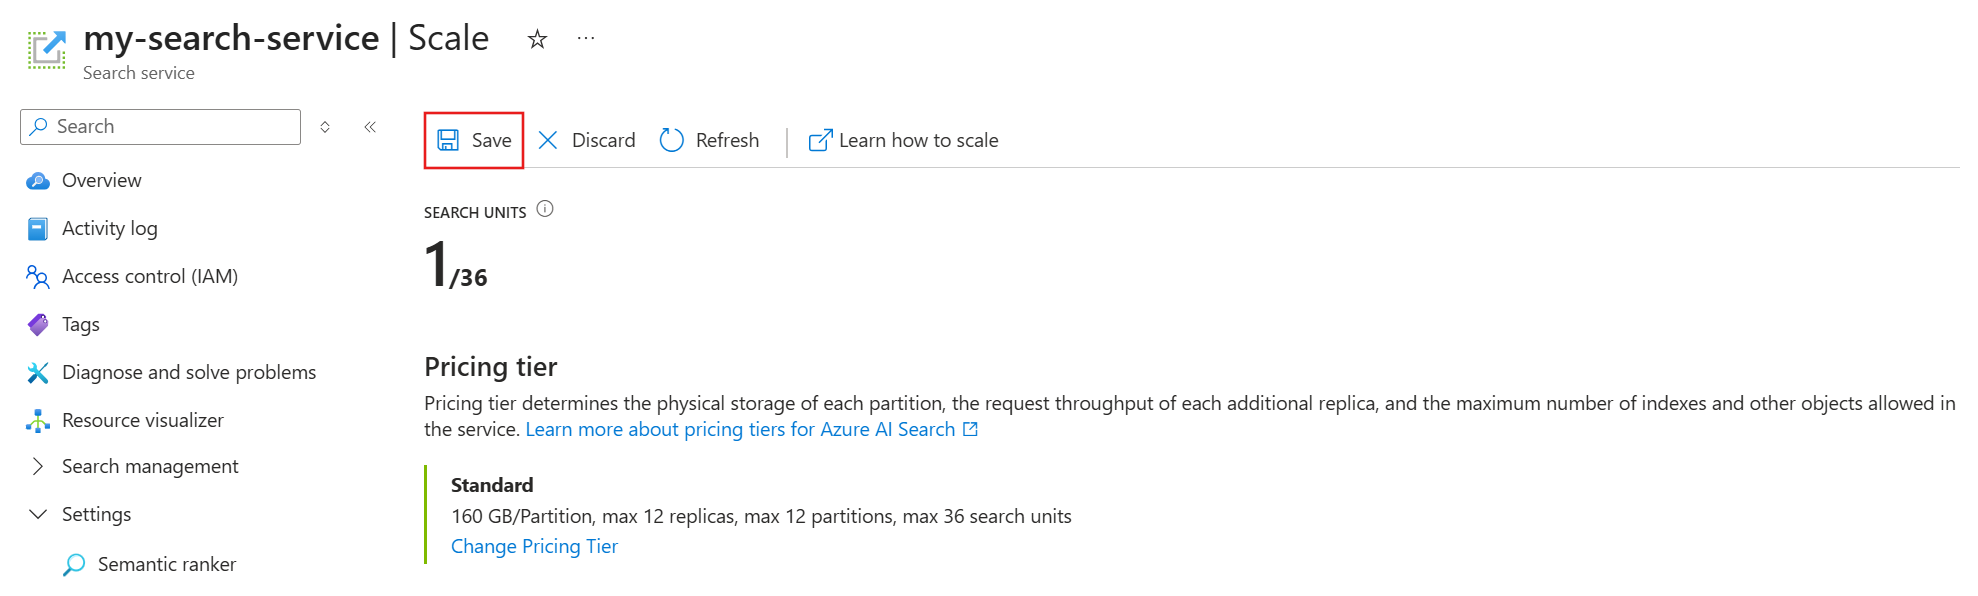
次のスクリーンショットは、1 つのレプリカとパーティションでプロビジョニングされる Standard サービスを示しています。 下部の式は、使用される検索ユニットの数 (1) を示しています。 ユニットの価格が 100 ドル (実際の価格ではありません) の場合、このサービスを実行するための毎月のコストは平均 100 ドルになります。
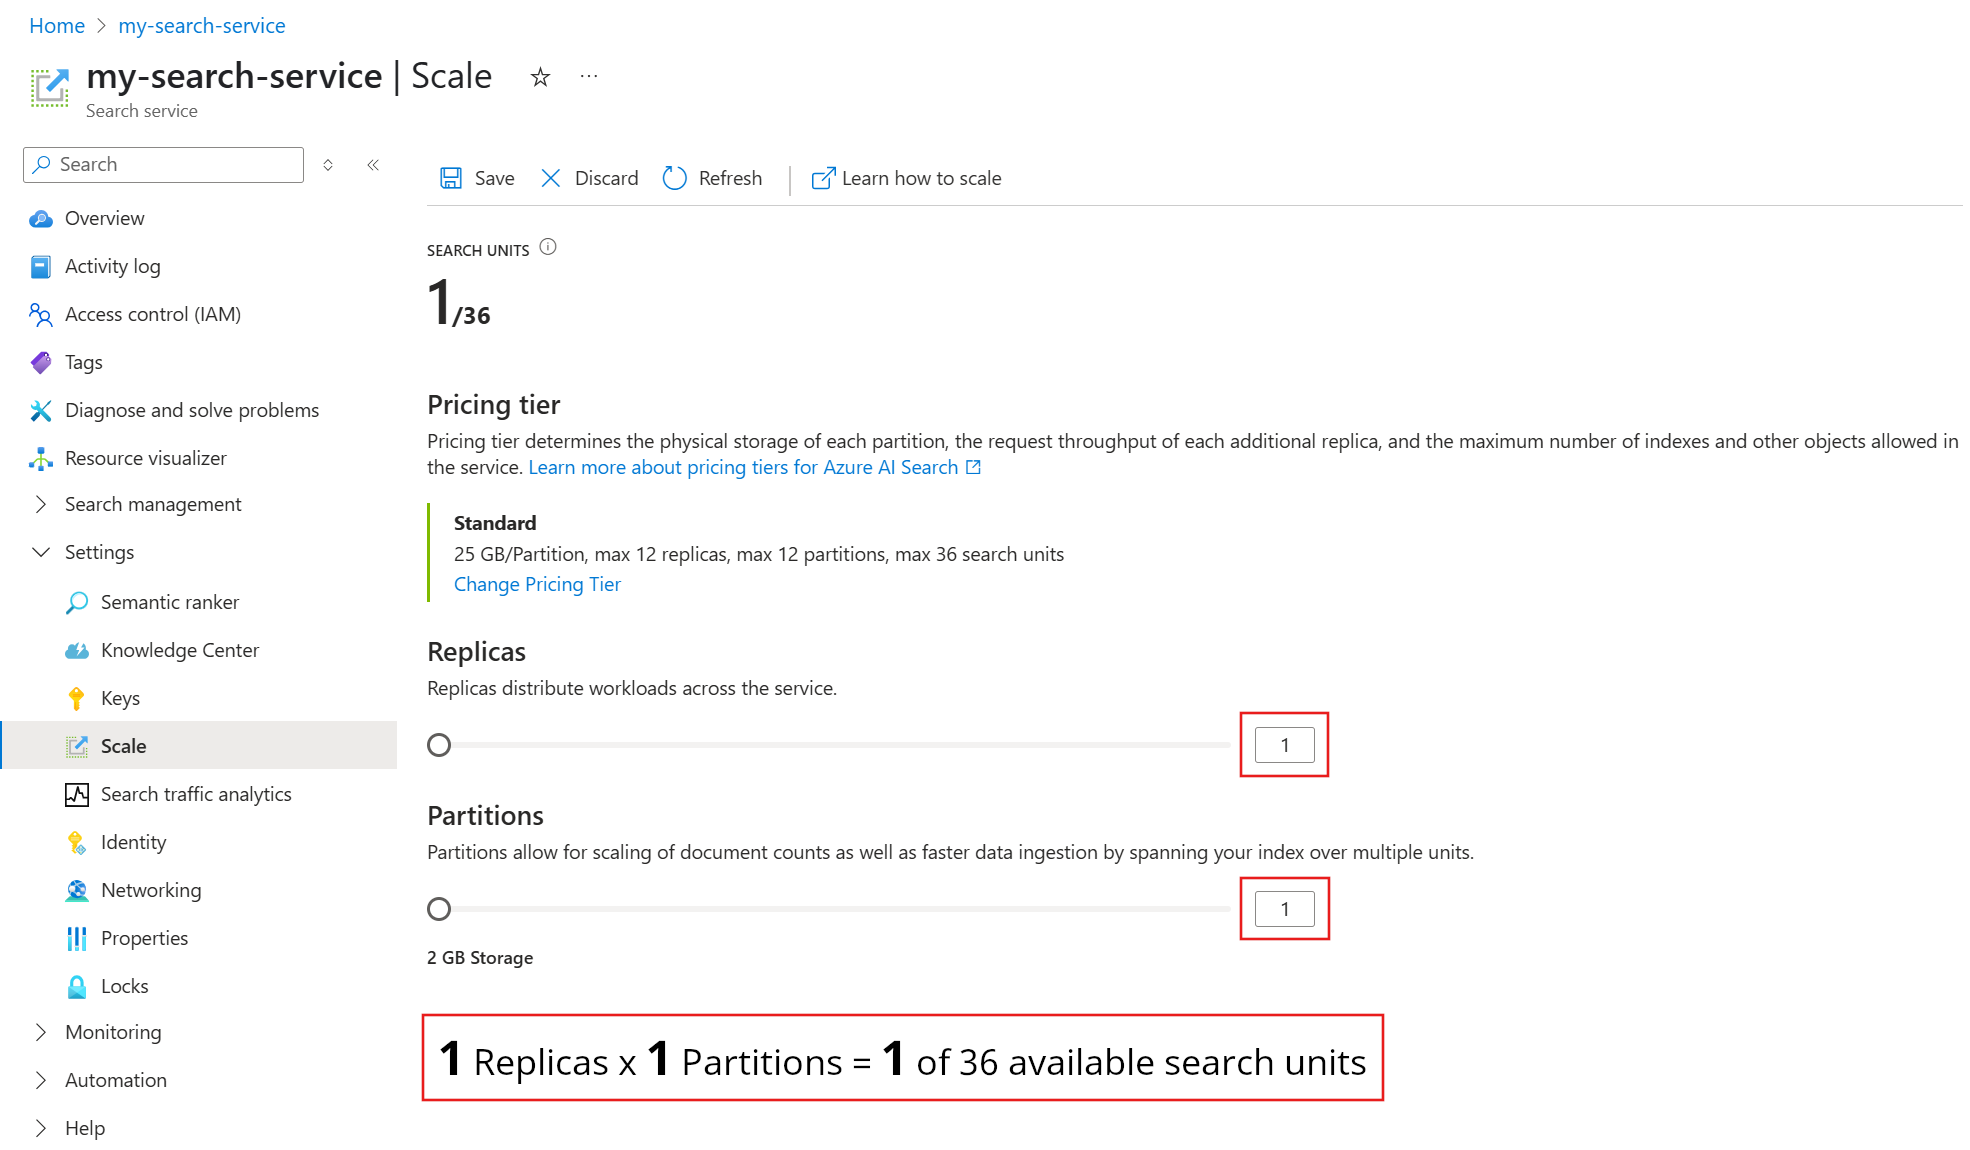
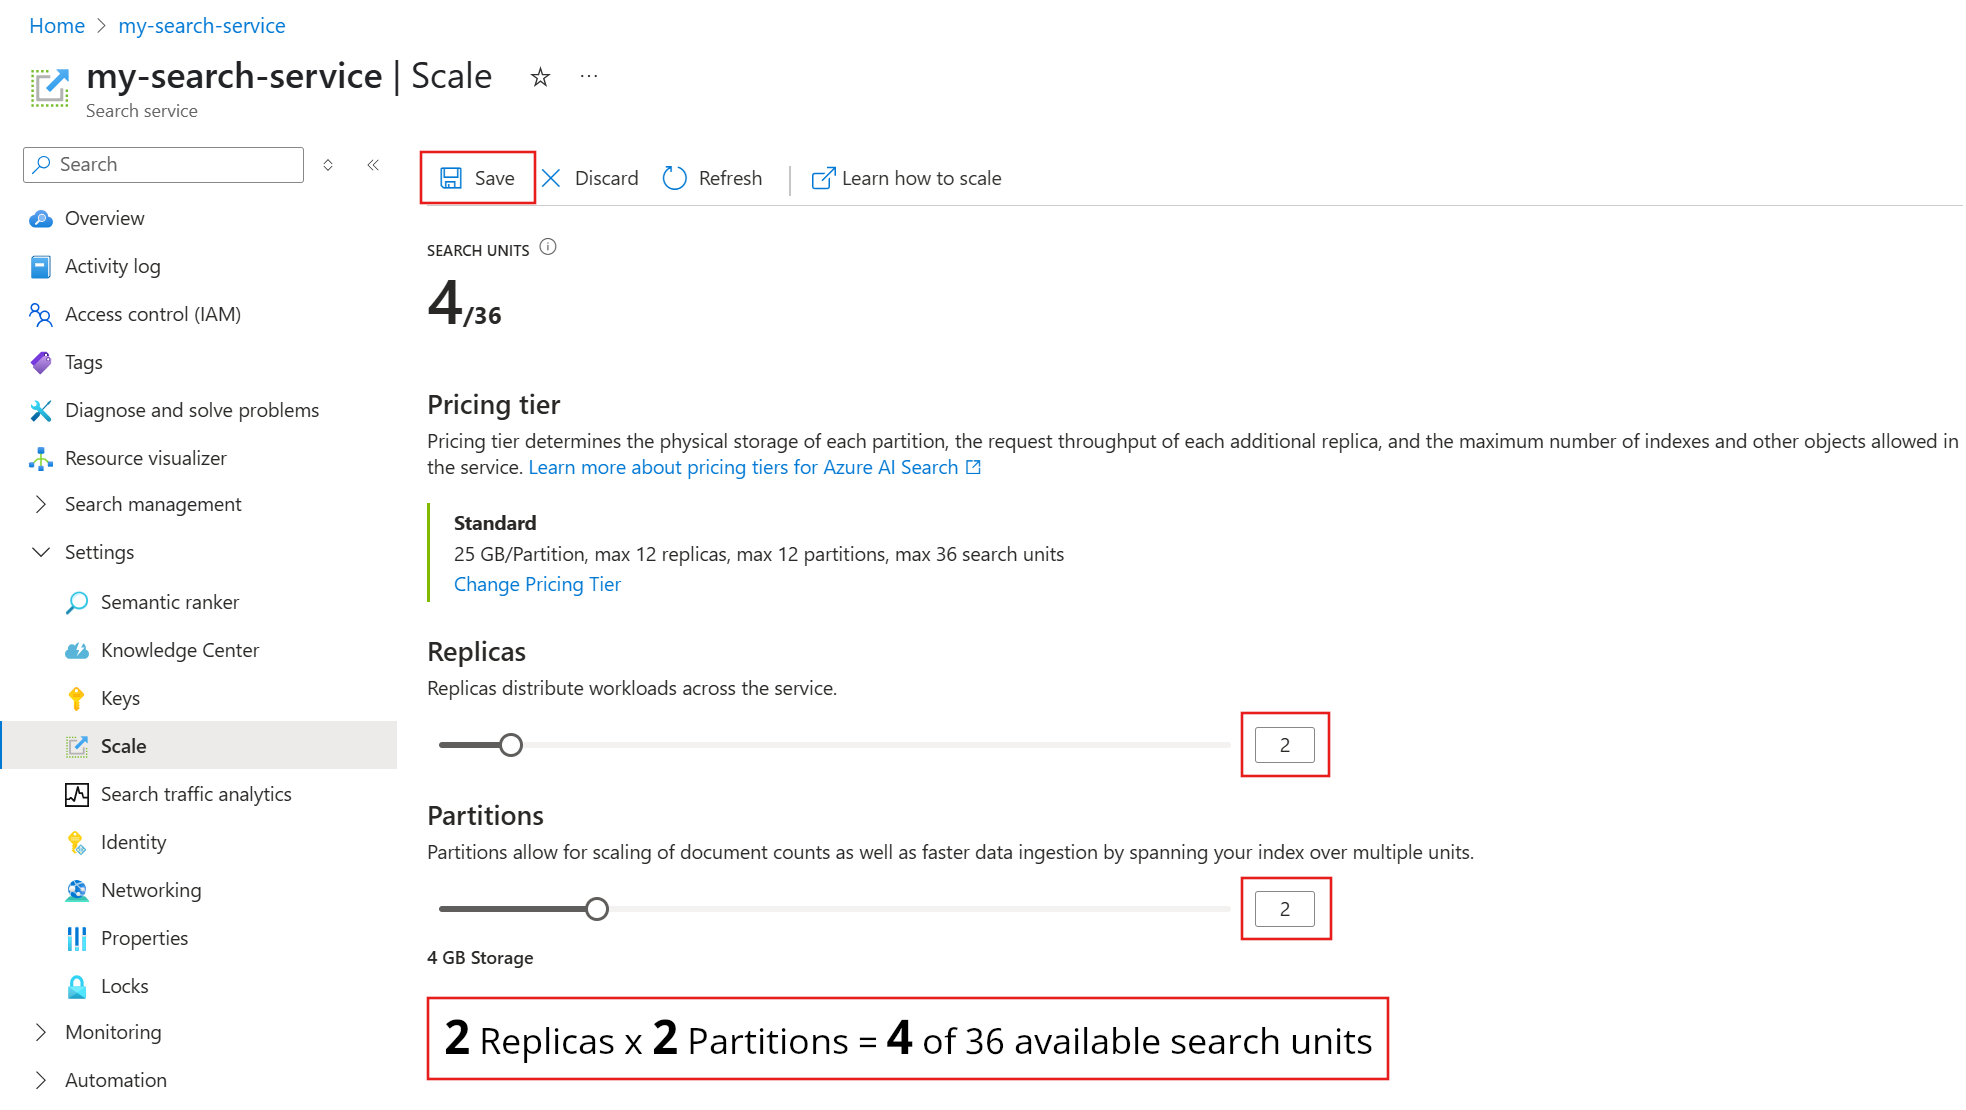
スライダーを使用してパーティションの数を増減し、[保存] を選択します。
この例では、2 つ目のレプリカおよびパーティションを追加します。 請求の計算式では、レプリカ数とパーティション数が乗算されるため (2 x 2)、検索ユニット数が 4 になっていることに注意してください。 容量を 2 倍にすると、サービスを実行するためのコストが 2 倍以上になります。 検索ユニットのコストが 100 ドルの場合、新しい毎月の請求額は 400 ドルになります。
各レベルの現在のユニットあたりのコストについては、 価格ページを参照してください。
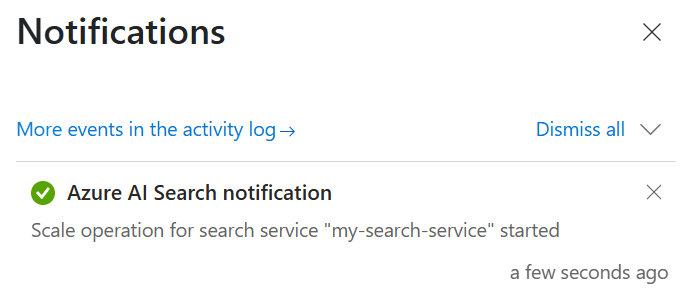
通知を確認して、操作が開始されたことを確認します。
この操作の完了には数時間かかることがあります。 これはバックグラウンドで発生するため、検索サービスは引き続き完全に動作し、読み取りおよび書き込み操作に使用できます。
操作を取り消したり、進行状況を監視したりすることはできません。 ただし、変更中は次のメッセージが表示されます。
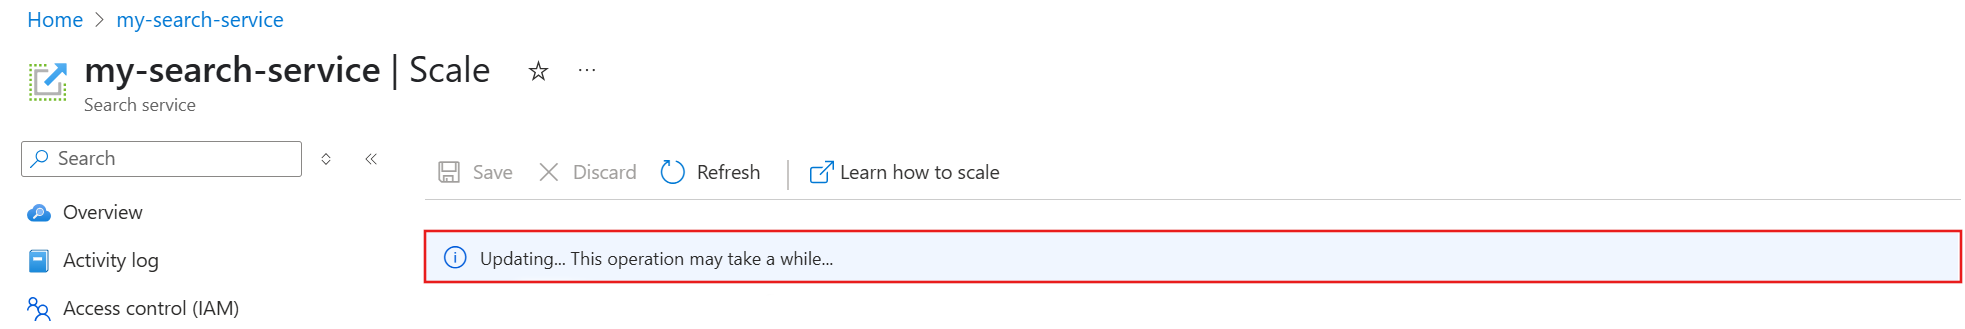
価格レベルを変更する
メモ
Azure ポータルと Services - Update (REST API) では、Basic レベルと Standard (S1、S2、S3) レベルの間の変更がサポートされます。 現在のサービス構成がターゲット レベルの制限を超えていない場合は、レベルをアップグレードまたはダウングレードできます。 また、お客様のリージョンでは、ターゲット レベルに容量の制約を設定することもできません。
価格レベルによって、専用価格モデルの検索サービスの最大ストレージが決まります。 容量を増減する必要がある場合は、ストレージのニーズに合わせて別の価格レベルに切り替えることができます。 (これは専用価格モデルレベルにのみ適用されます。サーバーレス モデルの開発者層は、一度選択した後は変更できません)。
容量に加えて、価格レベルによって、インデックス、インデクサー、その他の検索オブジェクトの制限が決まります。 続行する前に、現在のレベルのサービス制限と目的のレベルを比較してください。 一般に、より高いレベルに切り替えると、ストレージの制限とベクターの制限が増加し、要求スループットが増加し、待機時間が減少しますが、下位レベルに切り替えると、それと反対の効果があります。
より高い価格レベルに切り替えると、検索サービスを実行するコストも増加します。 詳細については、 価格に関するページを参照してください。
価格レベルを変更するには:
Azure ポータルで検索サービスに移動します。
左側のペインで [設定]>[スケール] を選択します。
現在のレベルで、[ 価格レベルの変更] を選択します。
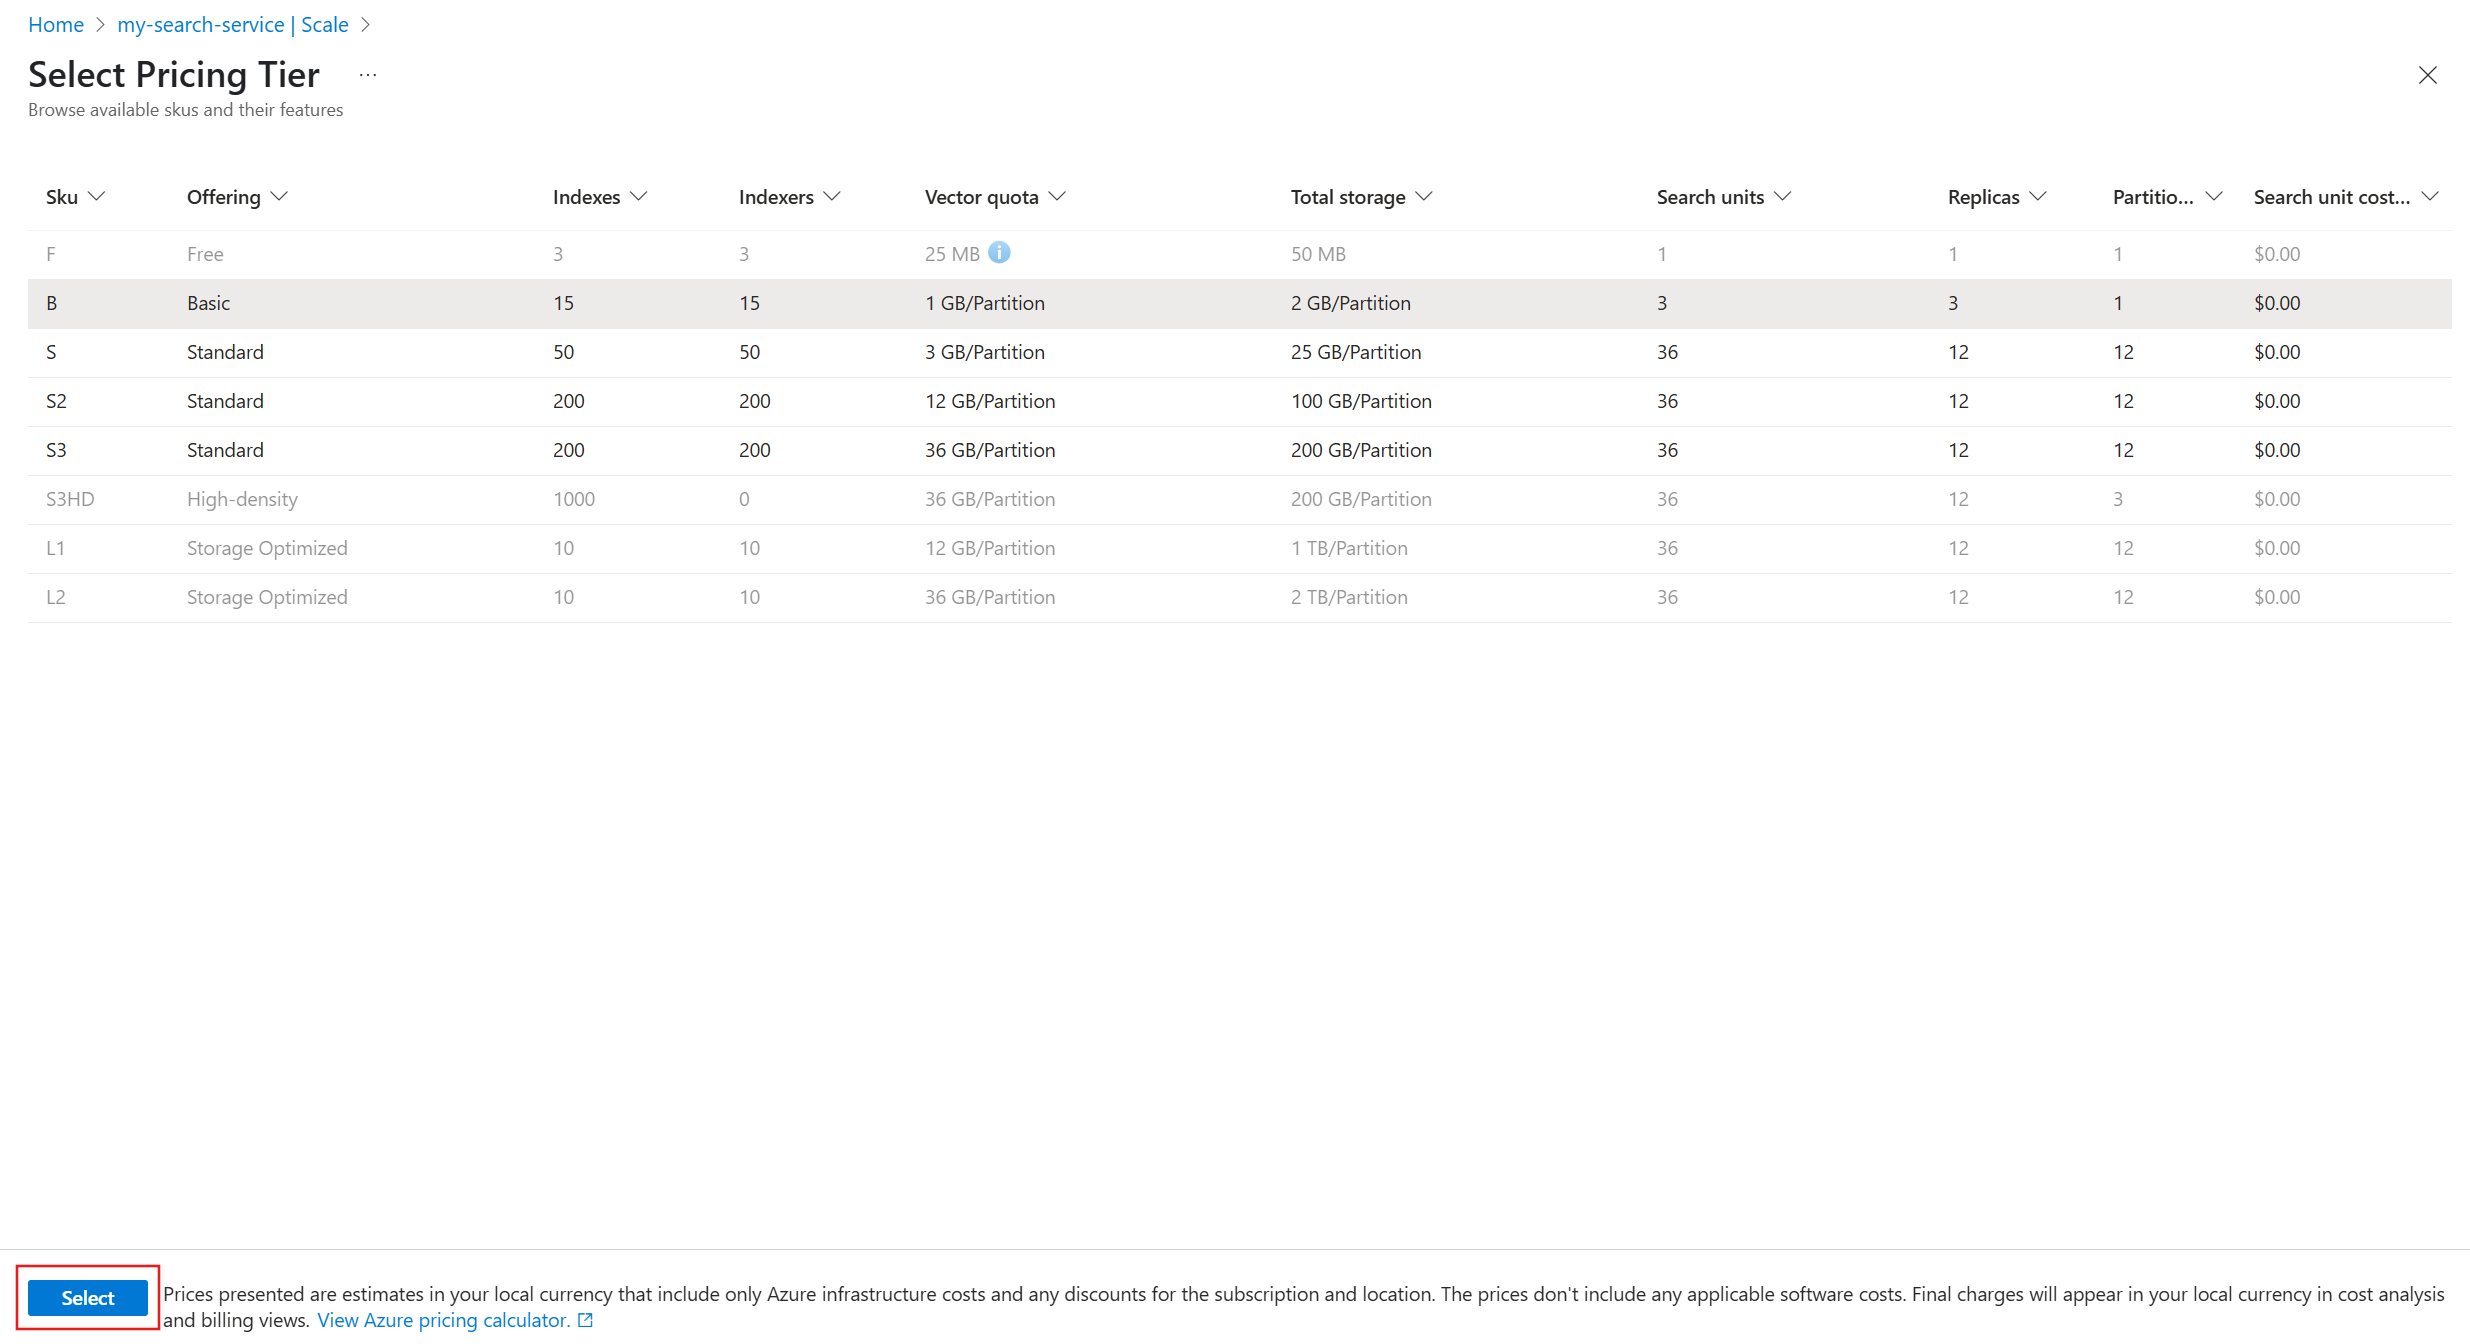
Azure portal の [価格レベルの変更] ボタンのスクリーンショット [価格レベルの選択] ページで、一覧から別のレベルを選択します。
Basic、S1、S2、S3 を切り替えることができますが、Free、S3HD、L1、または L2 に切り替えることはできません。 これらのレベルは選択できず、淡色表示されます。
スケーリング操作を開始するには、[保存] を選択します。
この操作の完了には数時間かかることがあります。 これはバックグラウンドで発生するため、検索サービスは引き続き完全に動作し、読み取りおよび書き込み操作に使用できます。
操作を取り消したり、進行状況を監視したりすることはできません。 ただし、変更中は次のメッセージが表示されます。
専用モデルに対するスケール要求の処理方法
検索サービスがスケール要求を受け取ると、次のようになります。
- 要求が有効であるかどうかを確認します。
- データとシステム情報のバックアップを開始します。
- サービスが既にプロビジョニング状態になっているかどうかを確認します (現在、レプリカまたはパーティションの追加または削除を実行中)。
- プロビジョニングを開始します。
サービスのサイズと要求のスコープによっては、サービスのスケーリングには数分から数時間かかることがあります。 バックアップ期間も、データの量とパーティションとレプリカの数によって異なります。
スケール要求を処理する手順は、完全に連続しているわけではありません。 たとえば、システムでは、安全に行えるようになったときに、プロビジョニングを開始します。それは、バックアップが終わり近づいているときかもしれません。
スケーリング中のエラー
次の表に、スケーリング操作中に発生する可能性があるエラーの原因と解決策の一覧を示します。
| エラーメッセージ | 原因 | 解決策 |
|---|---|---|
| "以前の要求を処理しているため、サービス更新操作は現在許可されていません。" | 別のスケーリング操作が処理中です。 | Azure ポータルで Overview ページを確認するか、Search Management REST API、Azure PowerShell、または Azure CLI を使用して検索サービスの状態を取得します。 状態が "プロビジョニング" の場合は、"成功" または "失敗" になるまで待ってからやり直してください。 1, 2 |
| "検索サービス servicename のスケーリングに失敗しました。 エラー: オブジェクト数 ActualCount が許容される制限 MaximumCount を超えています。" | 現在のサービス構成がターゲット価格レベルの制限を超えています。 | ストレージ使用、ベクター使用、インデックス、インデクサー、その他のオブジェクトが、下位レベルのサービス制限内に収まることを確認してください。 たとえば、Basic レベルでは最大で 15 個のインデックスがサポートされるため、16 個のインデックスがある場合は S1 から Basic に切り替えることはできません。 もう一度試す前に、リソースを調整してください。 |
1 バックアップの状態がありません。これは内部操作であり、スケーリング操作を妨げる可能性は低いです。
2 検索サービスがプロビジョニングの状態でストールしているように見える場合は、クエリ ボリュームがゼロでインデックスの更新がない、使用できない孤立したインデックスがないかどうかを確認します。 使用できないインデックスがある場合、サービス容量の変更がブロックされることがあります。 特に、キーが無効になった CMK で暗号化されたインデックスを探します。 インデックスを削除するか、キーを復元してインデックスをオンラインに戻し、スケーリング操作のブロックを解除します。
パーティションとレプリカの組み合わせ
次のグラフは、Standard レベル以上に適用されます。 パーティションとレプリカのすべての可能な組み合わせが表示されます。サービスごとに最大 36 個の検索ユニットが適用されます。
| 1 個のパーティション | 2 個のパーティション | 3 個のパーティション | 4 個のパーティション | 6 個のパーティション | 12 個のパーティション | |
|---|---|---|---|---|---|---|
| 1 つのレプリカ | 1 SU | 2 スー | 3 SU | 4 SU | 6 SU | 12 SU |
| 2 つのレプリカ | 2 スー | 4 SU | 6 SU | 8 SU | 12 SU | 24 SU |
| 3 つのレプリカ | 3 SU | 6 SU | 9 SU | 12 SU | 18 SU | 36 SU |
| 4 つのレプリカ | 4 SU | 8 SU | 12 SU | 16 ストレージユニット (SU) | 24 SU | 該当なし |
| 5 つのレプリカ | 5 SU | 10 SU | 15 SU | 20 SU | 30 SU | 該当なし |
| 6 つのレプリカ | 6 SU | 12 SU | 18 SU | 24 SU | 36 SU | 該当なし |
| 12 レプリカ | 12 SU | 24 SU | 36 SU | 該当なし | 該当なし | 該当なし |
Basic 検索サービスでは、検索ユニット数が少なくなります。
2024 年 4 月 3 日より前に作成された検索サービスでは、Basic サービスはパーティションを 1 つだけ持ち、最大 3 つのレプリカを 3 つの SU に制限できます。 調整可能なリソースはレプリカだけです。 ただし、 サービスをアップグレードすることで、パーティション数を増やすことができる場合があります。
サポートされているリージョンで 2024 年 4 月 3 日以降に作成された検索サービスでは、Basic サービスには最大 3 つのパーティションと 3 つのレプリカを含めることができます。 パーティションとレプリカを完全にサポートするために、SU の上限は 9 です。
作成日に関係なく、どの課金対象レベルの検索サービスでも、クエリの高可用性を実現するには少なくとも 2 つのレプリカが必要です。
レベルと通貨ごとの課金レートについては、Azure AI 検索価格に関するページを参照してください。
専用価格モデル レベルを使用して容量を見積もる
ストレージのニーズは、ビルドするインデックスのサイズによって異なります。 見積もりに役立つ強固なヒューリスティックや一般的なガイドラインはありません。 インデックスのサイズを決定する唯一の方法は、インデックスを 作成することです。 そのサイズは、トークン化と埋め込み、サジェスター、フィルター処理、並べ替えを有効にするか、 ベクター圧縮を利用できるかによって異なります。
Basic 以上の課金対象レベルで容量を見積もります。 Free レベルは、複数の顧客が共有する物理リソースで実行され、制御を超える要因の対象となります。 課金対象の検索サービスの専用のリソースでのみ、より長いサンプリングと処理時間に対応でき、開発段階でのインデックスの数量、サイズ、クエリ量についてより現実的な見積もりを求めることができます。
各レベルのサービス制限を確認して、より低いレベルで、必要なインデックス数に対応できるかどうかを判断してください。 アクティブな開発、テスト、運用のためにインデックスの複数のコピーが必要かどうかを検討します。
検索サービスには、オブジェクトの制限 (インデックス、インデクサー、スキルセットの最大数など) とストレージの制限が適用されます。 最初に達した制限が、有効な制限になります。
課金対象レベルでサービスを作成します。 レベルは、特定のワークロード向けに最適化されています。 たとえば、Storage Optimized レベルでは、少数の大きなインデックスをサポートするように設計されているため、インデックスは 10 個に制限されています。
予想される負荷がわからない場合は、Basic または S1 の低いレベルで始めます。
テストに大規模なインデックス作成とクエリの負荷が含まれている場合は、S2 または S3 の高レベルから始めます。
社内のビジネス アプリケーションのように、インデックスを付けるデータの量が多く、クエリの負荷が比較的低い場合は、Storage Optimized (L1 または L2) から始めます。
最初のインデックスを構築して、ソース データがどのようにインデックスに変換されるかを特定します。 これは、インデックスのサイズを推測する唯一の方法です。 フィールド定義の属性は、物理ストレージの要件に影響します。
キーワード検索の場合、フィールドをフィルター可能および並べ替え可能としてマークすると、インデックス サイズが大きくなります。
ベクトル検索の場合は、ベクトル サイズを小さくするようにパラメーターを設定できます。
Azure ポータルでストレージ、サービス制限、クエリボリューム、待機時間を監視する。 Azure ポータルには、1 秒あたりのクエリ数、調整されたクエリ、検索待ち時間が表示されます。 これらの値は、適切なレベルを選択したかどうかを判断するのに役立ちます。
可用性を高めたり、クエリのパフォーマンス低下を軽減したりするためにレプリカを追加します。
クエリの負荷に対応するために必要なレプリカの数に関するガイドラインはありません。 クエリのパフォーマンスは、クエリおよび競合するワークロードの複雑さによって異なります。 レプリカを追加するとパフォーマンスが向上しますが、厳密に線形に向上するわけではありません。3 つのレプリカを追加しても、スループットが 3 倍になるとは限りません。 ソリューションの QPS の見積もりのガイダンスについては、「 パフォーマンスの分析 と クエリの監視」を参照してください。
転置インデックスのサイズと複雑性はコンテンツによって決まり、必ずしもそれにフィードするデータ量によって決まるものではありません。 冗長性の高い大規模なデータ ソースは、変動の多いコンテンツを含む小さいデータセットよりも、インデックスのサイズが小さくなることがあります。 そのため、元のデータ セットのサイズに基づいてインデックスのサイズを推測できることはほとんどありません。
検索しないデータを含める場合は、ストレージ要件を増やすことができます。 ドキュメントには、検索機能に必要なデータのみが含まれていることが理想的な状態です。
サービス レベル契約に関する考慮事項
サービス レベル アグリーメント (SLA) には 、Free レベルとプレビュー機能は含まれません。 課金対象のすべてのレベルで、SLA が有効になるのは、サービスにとって十分な冗長性がプロビジョニングされるときです。
2 つ以上のレプリカがクエリ (読み取り) の SLA を満たしている。
3 つ以上のレプリカがクエリとインデックス作成 (読み取り/書き込み) の SLA を満たしている。
パーティションの数は、SLA に影響しません。
サーバーレス モデルのコストを最適化する
サーバーレス価格モデルでは、次の手順を実行します。
- サービスは容量を自動的に管理します。
- レプリカ、パーティション、または検索単位を構成する必要はありません。
- コンピューティングはワークロード (クエリとインデックス作成の需要) に基づいて動的にスケーリングされ、アイドル時にはゼロにスケーリングできます。
サーバーレス モデルの制限の詳細については、「 サービスの制限」を参照してください。
課金は、次の 2 つのディメンションに基づいています。
- コンピューティング使用量 (CU): クエリ操作とインデックス作成操作に基づいて課金されます。
- インデックス付きストレージ: 1 か月あたり GB ごとに課金されます。
課金は従量課金ベースであるため、コストは使用量に直接関連付けられます。
- 複雑なクエリは、より多くのコンピューティングを消費します。
- 非効率的なスキーマ設計では、インデックス作成とクエリのコストの両方が増加します。
- インデックスが大きい、または頻繁に更新されるクエリ パターンが不適切な場合は、ストレージとコンピューティングの使用量が増加します。
ワークロードの効率を最適化する
サーバーレス モデルでは非効率性がコストとして表示されるため、ワークロード対応の設計を実践しない場合は、同じ作業に対してより多くの料金が発生します。 サーバーレス支出を制御する最善の方法は、インデックスとクエリを最初から効率的に設計することです。
サーバーレス価格モデルを使用するときに効率を高めるためにワークロードを設計するには、次の点を考慮してください。
インデックスの設計
- クエリで使用されるフィールドのみを含めます。
- 可能な限りベクトル次元を減らします。
- 不必要なフィルター、ソート、またはファセット機能の対象となる属性は避けてください。
クエリ パターン
-
$selectを使用して、返されるフィールドを制限します。 - フィルターを早期に適用して結果セットを減らします。
- 深いページング (
$skip) は避けてください。 - 広範なフルテキスト クエリよりも対象のクエリを優先します。
- コンピューティング コストが高いため、ハイブリッド検索は慎重に使用してください。
Monitoring
- CU 消費量を監視して、コストの高いクエリを特定します。
- ストレージの増加を追跡し、未使用のデータを削除します。
サーバーレスでは、パフォーマンスの向上 (より高速で対象となるクエリ) が通常、コストを削減します。
詳細については、 Azure AI 検索 のサーバーレス価格モデルを使用してコストを最適化する方法に関するページを参照してください。
リージョンの容量に関する考慮事項
容量と可用性は、 サポートされているリージョンによって異なる場合があります。 一部のリージョンでは、新しいサービスのプロビジョニングや既存のサービスのスケーリングに制約がある場合があります。
メモ
パブリック プレビュー期間中、サーバーレス価格モデルは 特定のリージョンでのみ使用できます。
容量の制約のために優先Azure AI 検索リージョンが使用できない場合は、「