Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Nota
Azure AI Search è disponibile tramite il portale di Azure, le API REST e Azure SDK. È inoltre alla base di Foundry IQ, il livello di conoscenza gestito che trasforma il contenuto aziendale in knowledge base riutilizzabili e con riconoscimento delle autorizzazioni per gli agenti nel portale di Microsoft Foundry.
Questo articolo illustra come aggiornare un indice esistente in Azure AI Search con modifiche dello schema o modifiche al contenuto tramite l'indicizzazione incrementale.
Suggerimento
Per aggiornare immediatamente i documenti, passare a Aggiorna contenuto. Per le modifiche dello schema, vedere Aggiornare uno schema di indice.
Prerequisiti
Un servizio Azure AI Search (qualsiasi livello). Creare un servizio o finirne uno esistente.
Indice di ricerca esistente con documenti. In questo articolo si presuppone che sia già stato creato un indice e siano stati caricati documenti.
Autorizzazioni per aggiornare o ricompilare gli indici:
- Autenticazione basata su chiave: chiave API amministratore per il servizio di ricerca.
- Autenticazione basata su ruoli: ruolo Collaboratore ai dati dell'indice di ricerca per gli aggiornamenti dei documenti o Collaboratore del servizio di ricerca per le modifiche dello schema.
Per lo sviluppo di SDK, installare la libreria client di ricerca Azure:
- Python: azure-search-documents
- .NET: Azure. Search.Documents
- JavaScript: @azure/search-documents
- Java: azure-search-documents
Suggerimento
Durante lo sviluppo attivo, è comune eliminare e ricompilare gli indici durante l'iterazione della progettazione dell'indice. Usare un piccolo campione rappresentativo di dati in modo che la reindicizzazione diventi più veloce. Per le modifiche dello schema di produzione, creare e testare un nuovo indice affiancato, quindi usare un alias di indice per scambiare gli indici senza modificare il codice dell'applicazione.
Aggiornare il contenuto
L'indicizzazione incrementale e la sincronizzazione di un indice rispetto alle modifiche apportate ai dati di origine sono fondamentali per la maggior parte delle applicazioni di ricerca. Questa sezione illustra il flusso di lavoro per l'aggiunta, la rimozione o la sovrascrittura del contenuto di un indice di ricerca tramite l'API REST, ma l'Azure SDK fornisce funzionalità equivalenti.
Il corpo della richiesta contiene uno o più documenti da indicizzare. All'interno della richiesta, ogni documento nell'indice è:
- Identificato da una chiave univoca con distinzione tra maiuscole e minuscole.
- Associata a un'azione: "upload", "delete", "merge" o "mergeOrUpload".
- Popolato con un set di coppie nome/valore per ogni campo che aggiungi o aggiorni.
{
  "value": [
    {
      "@search.action": "upload (default) | merge | mergeOrUpload | delete",
      "key_field_name": "unique_key_of_document", (key/value pair for key field from index schema)
      "field_name": field_value (name/value pairs matching index schema)
        ...
    },
    ...
  ]
}
Reference:Documents - Index
Usare prima di tutto le API per caricare documenti, ad esempio Documents - Index (REST) o un'API equivalente nel Azure SDK. Per altre informazioni sulle tecniche di indicizzazione, vedere Caricare documenti.
Per un aggiornamento di grandi dimensioni, l'invio in batch (fino a 1.000 documenti per batch o circa 16 MB per batch, a seconda del limite previsto) è consigliato e migliora significativamente le prestazioni di indicizzazione.
Impostare il
@search.actionparametro nell'API per determinare l'effetto sui documenti esistenti. UsaremergeOrUploadper gli aggiornamenti incrementali (più comuni),deleteper rimuovere i documenti omergeper gli aggiornamenti parziali dei campi nei documenti esistenti.Azione Effetto Elimina Rimuove l'intero documento dall'indice. Se si desidera rimuovere un singolo campo, usare unisci, impostando invece il campo in questione su Null. I documenti e i campi eliminati non liberano immediatamente spazio nell'indice. Ogni pochi minuti, un processo in background esegue l'eliminazione fisica. Indipendentemente dal fatto che si usi il portale di Azure o un'API per restituire le statistiche sugli indici, è possibile prevedere un piccolo ritardo prima che l'eliminazione venga riflessa nel portale di Azure e tramite le API. Per altre informazioni, vedere Eliminare documenti in un indice di ricerca. Fusione Aggiorna un documento già esistente e segnala un errore se non è possibile trovare un documento. Merge sostituisce i valori esistenti. Per questo motivo, assicurarsi di verificare la presenza di campi di raccolta contenenti più valori, ad esempio campi di tipo Collection(Edm.String). Ad esempio, se il campotagsinizia con un valore["budget"]e si esegue un'unione con["economy", "pool"], il valore finale del campotagsè["economy", "pool"]. Non sarà["budget", "economy", "pool"].
Lo stesso comportamento si applica alle raccolte complesse. Se il documento contiene un campo di raccolta complesso denominato Rooms con un valore[{ "Type": "Budget Room", "BaseRate": 75.0 }]e si esegue un merge con un valore pari[{ "Type": "Standard Room" }, { "Type": "Budget Room", "BaseRate": 60.5 }]a , il valore finale del campo Rooms sarà[{ "Type": "Standard Room" }, { "Type": "Budget Room", "BaseRate": 60.5 }]. Non aggiungerà o unisce valori nuovi ed esistenti.unireOCaricare Si comporta come una fusione se il documento esiste e come un caricamento se il documento è nuovo. Questa è l'azione più comune per gli aggiornamenti incrementali. Caricamento Simile a un'operazione "upsert", in cui il documento viene inserito se è nuovo, aggiornato se esiste già, o sostituito se necessario. Se il documento non contiene valori richiesti dall'indice, il valore del campo del documento viene impostato su Null.
Le query continuano a essere eseguite durante l'indicizzazione, ma se si aggiornano o si rimuovono campi esistenti, ci si può aspettare risultati misti e una maggiore incidenza della limitazione.
Nota
Non esistono garanzie relative all'ordine di esecuzione per quale azione nel corpo della richiesta viene eseguita per prima. Non è consigliabile avere più azioni di "merge" associate allo stesso documento in un singolo corpo della richiesta. Se sono necessarie più azioni di "merge" per lo stesso documento, eseguire l'unione lato client prima di aggiornare il documento nell'indice di ricerca.
Risposte
Il codice di stato 200 viene restituito per una risposta con esito positivo, ovvero tutti gli elementi sono stati archiviati in modo permanente e inizieranno a essere indicizzati. L'indicizzazione viene eseguita in background e rende disponibili nuovi documenti( ovvero queryable e ricercabili) pochi secondi dopo il completamento dell'operazione di indicizzazione. Il ritardo specifico dipende dal carico del servizio.
L'indicizzazione riuscita è indicata dalla proprietà status impostata su true per tutti gli elementi, nonché la statusCode proprietà impostata su 201 (per i documenti appena caricati) o 200 (per i documenti uniti o eliminati):
{
  "value": [
    {
      "key": "unique_key_of_new_document",
      "status": true,
      "errorMessage": null,
      "statusCode": 201
    },
    {
      "key": "unique_key_of_merged_document",
      "status": true,
      "errorMessage": null,
      "statusCode": 200
    },
    {
      "key": "unique_key_of_deleted_document",
      "status": true,
      "errorMessage": null,
      "statusCode": 200
    }
  ]
}
Il codice di stato 207 viene restituito quando almeno un elemento non è stato indicizzato correttamente. Gli elementi che non sono stati indicizzati hanno il campo di stato impostato su false. Le errorMessage proprietà e statusCode indicano il motivo dell'errore di indicizzazione:
{
  "value": [
    {
      "key": "unique_key_of_document_1",
      "status": false,
      "errorMessage": "The search service is too busy to process this document. Please try again later.",
      "statusCode": 503
    },
    {
      "key": "unique_key_of_document_2",
      "status": false,
      "errorMessage": "Document not found.",
      "statusCode": 404
    },
    {
      "key": "unique_key_of_document_3",
      "status": false,
      "errorMessage": "Index is temporarily unavailable because it was updated with the 'allowIndexDowntime' flag set to 'true'. Please try again later.",
      "statusCode": 422
    }
  ]
}
La errorMessage proprietà indica il motivo dell'errore di indicizzazione, se possibile.
Nella tabella seguente vengono illustrati i vari codici di stato per documento che possono essere restituiti nella risposta. Alcuni codici di stato indicano problemi con la richiesta stessa, mentre altri indicano condizioni di errore temporanee. Quest'ultimo è necessario riprovare dopo un ritardo.
| Codice di stato | Significato | Non irreversibile | Note |
|---|---|---|---|
| 200 | Il documento è stato modificato o eliminato correttamente. | n/a | Le operazioni di eliminazione sono idempotenti. Ovvero, anche se non esiste una chiave del documento nell'indice, il tentativo di un'operazione di eliminazione con tale chiave genera un codice di stato 200. |
| 201 | Il documento è stato creato correttamente. | n/a | |
| 400 | Errore nel documento che impediva l'indicizzazione. | No | Il messaggio di errore nella risposta indica l'errore del documento. |
| 404 | Impossibile unire il documento perché la chiave specificata non esiste nell'indice. | No | Questo errore non si verifica per i caricamenti perché creano nuovi documenti e non si verifica per le eliminazioni perché sono idempotenti. |
| 409 | È stato rilevato un conflitto di versione durante il tentativo di indicizzare un documento. | Sì | Ciò può verificarsi quando si tenta di indicizzare lo stesso documento più volte contemporaneamente. |
| 422 | L'indice non è temporaneamente disponibile perché è stato aggiornato con il flag 'allowIndexDowntime' impostato su 'true'. | Sì | |
| 429 | Troppe richieste | Sì | Se viene visualizzato questo codice di errore durante l'indicizzazione, in genere significa che l'archiviazione è insufficiente. Quando si avvicinano i limiti di archiviazione, il servizio può entrare in uno stato in cui non è possibile aggiungere o aggiornare fino a quando non si eliminano alcuni documenti. Per altre informazioni, vedere Pianificare e gestire la capacità se si vuole più spazio di archiviazione o liberare spazio eliminando i documenti. |
| 503 | Il servizio di ricerca non è temporaneamente disponibile, probabilmente a causa di un carico elevato. | Sì | In questo caso, il codice deve attendere prima di riprovare o si rischia di prolungare la non disponibilità del servizio. |
Se il codice client rileva spesso una risposta 207, un possibile motivo è che il sistema è sotto carico. Per confermarlo, controllare che la proprietà statusCode sia 503. Se statusCode è 503, è consigliabile limitare le richieste di indicizzazione. Altrimenti, se il traffico di indicizzazione non diminuisce, il sistema potrebbe iniziare a rifiutare tutte le richieste con errori 503.
Il codice di stato 429 indica che è stata superata la quota per il numero di documenti per indice. È necessario eseguire l'aggiornamento per i limiti di capacità più elevati o creare un nuovo indice.
Nota
Quando si caricano valori DateTimeOffset con informazioni sul fuso orario nell'indice, Azure AI Search normalizza questi valori in formato UTC. Ad esempio, 2024-01-13T14:03:00-08:00 viene archiviato come 2024-01-13T22:03:00Z. Se è necessario archiviare le informazioni sul fuso orario, aggiungere una colonna aggiuntiva all'indice per questo punto dati.
Suggerimenti per l'indicizzazione incrementale
Gli indicizzatori automatizzano l'indicizzazione incrementale. Se è possibile usare un indicizzatore e se l'origine dati supporta il rilevamento delle modifiche, è possibile eseguire l'indicizzatore in base a una pianificazione ricorrente per aggiungere, aggiornare o sovrascrivere il contenuto ricercabile in modo che venga sincronizzato con i dati esterni.
Se si effettuano chiamate di indice direttamente tramite l'API push, usare
mergeOrUploadcome azione di ricerca.Il payload deve includere le chiavi o gli identificatori di ogni documento da aggiungere, aggiornare o eliminare.
Se l'indice include campi vettoriali e si imposta la
storedproprietà su false, assicurarsi di fornire il vettore nell'aggiornamento parziale del documento, anche se il valore è invariato. Un effetto collaterale dell'impostazionestoredsu false è che i vettori vengono eliminati in un'operazione di reindicizzazione. Se si specifica il vettore nel payload dei documenti, si impedisce che ciò accada.Per aggiornare il contenuto di campi semplici e campi secondari in tipi complessi, elencare solo i campi da modificare. Ad esempio, se è sufficiente aggiornare un campo di descrizione, il payload deve essere costituito dalla chiave del documento e dalla descrizione modificata. L'omissione di altri campi mantiene i valori esistenti.
Per unire le modifiche inline nella raccolta di stringhe, specificare l'intero valore. Richiama l'esempio del campo
tagsdalla sezione precedente. I nuovi valori sovrascrivono i valori precedenti per un intero campo e non esiste un'unione all'interno del contenuto di un campo.
Ecco un esempio di API REST che illustra questi suggerimenti:
### Get Stay-Kay City Hotel by ID
GET  {{baseUrl}}/indexes/hotels-vector-quickstart/docs('1')?api-version=2026-04-01  HTTP/1.1
    Content-Type: application/json
    api-key: {{apiKey}}

### Change the description, city, and tags for Stay-Kay City Hotel
POST {{baseUrl}}/indexes/hotels-vector-quickstart/docs/search.index?api-version=2026-04-01  HTTP/1.1
  Content-Type: application/json
  api-key: {{apiKey}}

    {
        "value": [
            {
            "@search.action": "mergeOrUpload",
            "HotelId": "1",
            "Description": "I'm overwriting the description for Stay-Kay City Hotel.",
            "Tags": ["my old item", "my new item"],
            "Address": {
                "City": "Gotham City"
                }
            }
        ]
    }

### Retrieve the same document, confirm the overwrites and retention of all other values
GET  {{baseUrl}}/indexes/hotels-vector-quickstart/docs('1')?api-version=2026-04-01  HTTP/1.1
    Content-Type: application/json
    api-key: {{apiKey}}
Reference:Documents - Index, Lookup Document
Esempi di SDK
Negli esempi seguenti viene illustrato come aggiornare i documenti usando il Azure SDK.
from azure.core.credentials import AzureKeyCredential
from azure.search.documents import SearchClient

# Set up the client
service_name = "<your-search-service-name>"
index_name = "hotels-sample"
api_key = "<your-admin-api-key>"

endpoint = f"https://{service_name}.search.windows.net"
credential = AzureKeyCredential(api_key)
client = SearchClient(endpoint=endpoint, index_name=index_name, credential=credential)

# Update documents using merge_or_upload
documents = [
    {
        "HotelId": "1",
        "Description": "Updated description for the hotel.",
        "Tags": ["updated", "renovated"]
    }
]

result = client.merge_or_upload_documents(documents=documents)
print(f"Updated {len(result)} document(s)")
Riferimento:SearchClient, merge_or_upload_documents
Aggiornare uno schema di indice
Lo schema dell'indice definisce le strutture di dati fisiche create nel servizio di ricerca, pertanto non sono presenti molte modifiche allo schema che è possibile apportare senza incorrere in una ricompilazione completa.
Aggiornamenti senza ricompilazione
Nell'elenco seguente vengono enumerate le modifiche dello schema che possono essere introdotte facilmente in un indice esistente. In genere, l'elenco include nuovi campi e funzionalità usati durante l'esecuzione della query.
- Aggiungere una descrizione dell'indice
- Aggiungere un nuovo campo
- Impostare l'attributo
retrievablein un campo esistente - Aggiornare
searchAnalyzerin un campo con un oggetto esistenteindexAnalyzer - Aggiungere una nuova definizione dell'analizzatore in un indice (che può essere applicato ai nuovi campi)
- Aggiungere, aggiornare o eliminare profili di punteggio
- Aggiungere, aggiornare o eliminare mappe sinonimi
- Aggiungere, aggiornare o eliminare configurazioni semantiche
- Aggiungere, aggiornare o eliminare le impostazioni CORS
L'ordine delle operazioni è:
Rivedere lo schema con gli aggiornamenti dell'elenco precedente.
Aggiornare lo schema dell'indice nel servizio di ricerca.
Aggiornare il contenuto dell'indice in modo che corrisponda allo schema modificato se è stato aggiunto un nuovo campo. Per tutte le altre modifiche, il contenuto indicizzato esistente viene usato as-is.
Quando si aggiorna uno schema di indice per includere un nuovo campo, ai documenti esistenti nell'indice viene assegnato un valore Null per tale campo. Nel processo di indicizzazione successivo i valori dei dati di origine esterna sostituiscono i valori Null aggiunti da Azure AI Search.
Non dovrebbero verificarsi interruzioni delle query durante gli aggiornamenti, ma i risultati delle query variano in base all'effetto degli aggiornamenti.
Aggiornamenti che richiedono una ricompilazione
Alcune modifiche richiedono un'eliminazione e la ricompilazione dell'indice, sostituendo un indice corrente con uno nuovo.
| Azione | Descrizione |
|---|---|
| Eliminare un campo | Per rimuovere fisicamente tutte le tracce di un campo, è necessario ricompilare l'indice. Quando una ricompilazione immediata non è pratica, è possibile modificare il codice dell'applicazione per reindirizzare l'accesso da un campo obsoleto o usare i campi searchFields e selezionare i parametri di query per scegliere quali campi vengono cercati e restituiti. Fisicamente, la definizione e il contenuto del campo rimangono nell'indice fino alla ricompilazione successiva, quando si applica uno schema che omette il campo in questione. |
| Modificare una definizione di campo | Le revisioni di un nome di campo, un tipo di dati o attributi di indice specifici (ricercabile, filtrabile, ordinabile, facetable) richiedono una ricompilazione completa. |
| Assegnare un analizzatore a un campo | Gli analizzatori vengono definiti in un indice, assegnati ai campi e quindi richiamati durante l'indicizzazione per informare come vengono creati i token. È possibile aggiungere una nuova definizione dell'analizzatore a un indice in qualsiasi momento, ma è possibile assegnare un analizzatore solo quando viene creato il campo. Questo vale sia per le proprietà analyzer che indexAnalyzer . La proprietà searchAnalyzer è un'eccezione (è possibile assegnare questa proprietà a un campo esistente). |
| Aggiornare o eliminare una definizione dell'analizzatore in un indice | Non è possibile eliminare o modificare una configurazione dell'analizzatore esistente (analizzatore, tokenizer, filtro token o filtro char) nell'indice a meno che non si ricompila l'intero indice. |
| Aggiungere un campo a un suggerimento | Se un campo esiste già e si vuole aggiungerlo a un costrutto Suggesters, è necessario ricompilare l'indice. |
| Aggiornare il servizio o il livello | Se è necessaria una maggiore capacità, verificare se è possibile aggiornare il servizio o passare a un piano tariffario superiore. In caso contrario, è necessario creare un nuovo servizio e ricompilare gli indici da zero. Per automatizzare questo processo, è possibile usare un esempio di codice che esegue il backup dell'indice in una serie di file JSON. È quindi possibile ricreare l'indice in un servizio di ricerca specificato. |
L'ordine delle operazioni è:
Ottenere una definizione di indice nel caso in cui sia necessario per riferimento futuro o usare come base per una nuova versione.
Prendere in considerazione l'uso di una soluzione di backup e ripristino per mantenere una copia del contenuto dell'indice. Esistono soluzioni in C# e in Python. È consigliabile usare la versione Python perché è più aggiornata.
Se hai capacità nel tuo servizio di ricerca, mantieni l'indice esistente durante la creazione e il test di quello nuovo.
Eliminare l'indice esistente. Le query destinate all'indice vengono eliminate immediatamente. Tenere presente che l'eliminazione di un indice è irreversibile, eliminando l'archiviazione fisica per la raccolta di campi e altri costrutti.
Pubblicare un indice modificato, in cui il corpo della richiesta include definizioni e configurazioni di campo modificate.
Caricare l'indice con i documenti da un'origine esterna. I documenti vengono indicizzati usando le definizioni dei campi e le configurazioni del nuovo schema.
Quando si crea l'indice, l'archiviazione fisica viene allocata per ogni campo nello schema dell'indice, con un indice invertito creato per ogni campo ricercabile e un indice vettoriale creato per ogni campo vettoriale. I campi che non sono ricercabili possono essere usati nei filtri o nelle espressioni, ma non hanno indici invertiti e non sono ricercabili per il testo completo o in modo approssimativo. In una ricompilazione dell'indice, questi indici invertiti e gli indici vettoriali vengono eliminati e ricreati in base allo schema di indice specificato.
Per ridurre al minimo l'interruzione del codice dell'applicazione, è consigliabile creare un alias di indice. Il codice dell'applicazione fa riferimento all'alias, ma è possibile aggiornare il nome dell'indice a cui punta l'alias.
Aggiungere una descrizione dell'indice
Un indice ha una description proprietà che è possibile specificare e usare quando un sistema deve accedere a più indici e prendere una decisione in base alla descrizione. Si consideri un server MCP (Model Context Protocol) che deve selezionare l'indice corretto in fase di esecuzione. La decisione può essere basata sulla descrizione anziché solo sul nome dell'indice.
Una descrizione dell'indice è un aggiornamento dello schema ed è possibile aggiungerla senza dover ricompilare l'intero indice.
- La lunghezza della stringa è massima di 4.000 caratteri.
- Il contenuto deve essere leggibile, in Unicode. Il caso d'uso deve determinare quale lingua usare.
È possibile aggiungere una descrizione dell'indice tramite il portale di Azure, l'API REST stabile più recente o un pacchetto Azure SDK che fornisce la funzionalità.
Il portale di Azure supporta l'API di anteprima più recente.
Passare al servizio di ricerca nel portale Azure.
In Indici di gestione della ricerca> selezionare un indice.
Selezionare Modifica JSON.
Inserire
"description", seguito dalla descrizione. Il valore deve essere minore di 4.000 caratteri e in Unicode.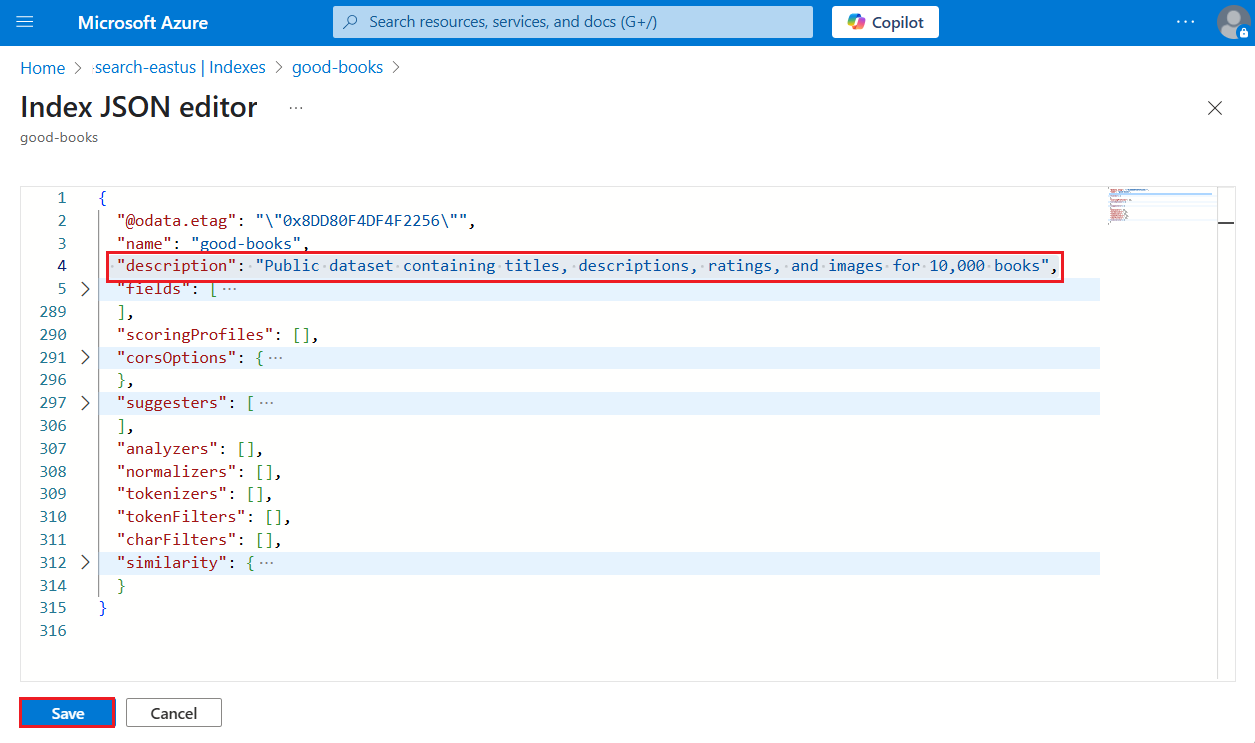
Salvare l'indice.
Bilanciamento dei carichi di lavoro
L'indicizzazione non viene eseguita in background, ma il servizio di ricerca bilancia tutti i processi di indicizzazione rispetto alle query in corso. Durante l'indicizzazione, è possibile monitorare le richieste di query nel portale di Azure per assicurarsi che le query vengano completate in modo tempestivo.
Se l'indicizzazione dei carichi di lavoro introduce livelli inaccettabili di latenza delle query, eseguire l'analisi delle prestazioni ed esaminare questi suggerimenti sulle prestazioni per una potenziale mitigazione.
Verificare la disponibilità di aggiornamenti
È possibile iniziare a eseguire query su un indice non appena viene caricato il primo documento. Se si conosce l'ID di un documento, l'API REST Ricerca documento restituisce il documento specifico. Per un test più ampio, è necessario attendere fino a quando l'indice non viene caricato completamente e quindi usare le query per verificare il contesto previsto.
È possibile usare Esplora ricerche o un client REST per verificare la disponibilità di contenuto aggiornato.
Se è stato aggiunto o rinominato un campo, usare select per restituire il campo:
"search": "*",
"select": "document-id, my-new-field, some-old-field",
"count": true
Il portale di Azure fornisce le dimensioni dell'indice e le dimensioni dell'indice vettoriale. È possibile controllare questi valori dopo l'aggiornamento di un indice, ma ricordarsi di aspettarsi un piccolo ritardo durante l'elaborazione della modifica e per tenere conto delle frequenze di aggiornamento del portale, che possono essere pochi minuti.
Risolvere i problemi di reindicizzazione
Nella tabella seguente sono elencati i problemi comuni durante l'aggiornamento o la ricompilazione degli indici e come risolverli.
| Problema | Causa | Risoluzione |
|---|---|---|
| Risposta 207 con risultati misti | Alcuni documenti hanno avuto esito positivo, altri non sono riusciti. | Verificare statusCode per ogni documento in risposta. In caso di errore 503, limitare le richieste e riprovare. |
| 409 Conflitto di versione | Aggiornamenti simultanei allo stesso documento. | Serializzare gli aggiornamenti nello stesso documento o implementare un nuovo tentativo con backoff esponenziale. |
| 429 Troppe richieste | Quota di archiviazione superata o troppe richieste simultanee. | Eliminare documenti per liberare spazio o aggiornare il livello di servizio per una maggiore capacità. |
| 503 Servizio non disponibile | Servizio sottoposto a carico elevato. | Attendere e riprovare con backoff esponenziale. Valutare la possibilità di ridurre le dimensioni del batch. |
| Numero di documenti invariato dopo l'eliminazione | L'eliminazione è asincrona. | Attendere 2-3 minuti prima che il processo in background completi l'eliminazione fisica. |
| Il nuovo campo restituisce Null | Campo aggiunto allo schema, ma non reindicizzazione dei documenti. | Esegui l'indicizzatore o effettua il push dei documenti aggiornati per popolare il nuovo campo. |
| Modifica dello schema rifiutata | Tentativo di modifica non compatibile (ridenominazione, modifica del tipo). | Eliminare e ricreare l'indice. Usare l'alias di indice per ridurre al minimo i tempi di inattività. |
Vedere anche
- Panoramica dell'indicizzatore
- Eliminare documenti da un indice di ricerca
- Indicizzare set di dati di grandi dimensioni su larga scala
- Indicizzazione nel portale di Azure
- database SQL di Azure indicizzatore
- Azure Cosmos DB per NoSQL indicizzatore
- Indicizzatore di BLOB di Azure
- indicizzatore di tabelle Azure
- Dati, privacy e protezioni predefinite