Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Note
Azure AI Keresés a Azure portálon, REST API-kon és Azure SDK-k keresztül érhető el. Emellett a Foundry IQ-t is támogatja, amely a vállalati tartalmakat újrafelhasználható, engedélytudatos tudásbázisokká alakítja át az Microsoft Foundry portálon található ügynökök számára.
Fontos
Ezek a funkciók és szolgáltatások támogatják a más Microsoft-szolgáltatásokhoz és harmadik féltől származó szolgáltatásokhoz való kapcsolódást. Ezeknek a szolgáltatásoknak a használatára a vonatkozó feltételek vonatkoznak, és a Azure megfelelőségi határán kívüli adatfeldolgozást vagy tárolást, valamint a Azure megfelelőségi határba történő adatáramlást eredményezhetnek.
Az Ön felelőssége annak kezelése, hogy az adatok a szervezet megfelelőségi és földrajzi határain kívülre áramlanak-e, valamint hogy a megfelelő engedélyek, határok és jóváhagyások ki vannak-e építve.
Ön a felelős azért, hogy gondosan áttekintse és tesztelje azokat az alkalmazásokat, amelyeket az adott használati esetek kontextusában hoz létre, és minden megfelelő döntést és testreszabást meghoz. Ez magában foglalja a saját, felelős mesterségesintelligencia-csökkentő megoldások, például metapromptok, tartalomszűrők vagy egyéb biztonsági rendszerek implementálását, valamint annak biztosítását, hogy az alkalmazások megfeleljenek a megfelelő minőségi, megbízhatósági, biztonsági és megbízhatósági szabványoknak. További információ: Azure AI Keresés Átláthatósági megjegyzés.
A OneLake fájlok indexelője tartalmat és metaadatokat importál egy Microsoft OneLake-belitóházból, és kereshetővé teszi a tartalmat Azure AI Keresés.
Az indexelő konfigurálásához és futtatásához a következőt használhatja:
- Adatforrás REST APIIndexelő REST API-val
- A szolgáltatást biztosító Azure SDK csomag
- Adatok importálása varázsló a Azure portálon.
Ez a cikk a REST API-kat használja az egyes lépések szemléltetésére.
Előfeltételek
Egy "Fabric" munkaterület. Ezt az oktatóanyagot követve Fabric munkaterületet hozhat létre.
Egy tóház egy Fabric munkaterületen. Kövesse ezt az oktatóanyagot egy tóház létrehozásához.
Szöveges adatok. Ha bináris adatokkal rendelkezik, AI-bővítő képelemzéssel kinyerheti a szöveget, vagy képek leírását hozhatja létre. A fájltartalom nem haladhatja meg a keresési szolgáltatási szint indexelőkorlátait .
A forrásfájl-feldolgozás és az AI-bővítés külön korlátozásokkal rendelkezik. Egy alsóbb rétegbeli képesség vagy külső szolgáltatás kevesebb adatot fogad el, mint amennyit az indexelő kinyer, ezért tekintse át a referenciacikket a készségkészlet minden egyes képességéhez .
Strukturálatlan tartalom a Fájlok helyén a lakehouse-ban. Az adatokat a következővel adhatja hozzá:
- Feltöltés közvetlenül egy tóházba
- Adatfolyamok használata Microsoft Fabric
- Adjon hozzá billentyűparancsokat külső adatforrásokból, például az Amazon S3-ból vagy a Google Cloud Storage-ból.
Egy Azure AI Keresés szolgáltatás, alapszintű tarifacsomag vagy magasabb, rendszer által felügyelt identitáshoz vagy felhasználó által hozzárendelt felügyelt identitáshoz konfigurálva. A Azure AI Keresés szolgáltatásnak ugyanabban a bérlőben kell lennie, mint a Microsoft Fabric munkaterület.
Rendszergazdai vagy közreműködői szerepkör-hozzárendelés azon Microsoft Fabric munkaterületen, ahol a lakehouse található. A lépéseket a cikk Engedélyek megadása szakasza ismerteti.
hozzáférés engedélyezése a OneLake-adatokhoz a Fabric környezeten kívüli alkalmazásokból.
REST-ügyfél, amely a jelen cikkben bemutatottakhoz hasonló REST-hívásokat hoz létre.
Korlátozások
A parquet -fájltípusok (beleértve a delta parquetet) jelenleg nem támogatottak.
Az Amazon S3 és a Google Cloud Storage billentyűparancsai nem támogatják a fájlok törlését.
Ez az indexelő nem támogatja a OneLake-munkaterület táblahelyének tartalmát.
Ez az indexelő nem támogatja az SQL-lekérdezéseket. Az
queryadatforrás konfigurációjában szereplő paraméter csak egy választható mappát vagy indexelési parancsikont ad meg.A OneLake-ben nem támogatott fájlok betöltése a Saját munkaterület munkaterületről, mivel ez egy felhasználónkénti személyes adattár.
A Fabric bizalmassági címkékkel rendelkező elemek, mint például a lakehouse-ok fájljainak indexelése, nem támogatott. Ha azonban a bizalmassági címkéket közvetlenül az egyes dokumentumokra alkalmazza, a védett tartalom és a társított címkék betöltése támogatott. Ezekben az esetekben Azure AI Keresés kinyerheti és tiszteletben tarthatja a bizalmassági címkéket és a címkézett dokumentumok tartalmát a Purview-ba (előzetes verzió) való integrációval.
A Microsoft OneLake munkaterületi szerepköralapú engedélyei hatással lehetnek az indexelő fájlokhoz való hozzáférésére. Győződjön meg arról, hogy a Azure AI Keresés szolgáltatásnév (felügyelt identitás) rendelkezik megfelelő engedélyekkel a cél Microsoft Fabric munkaterületen elérni kívánt fájlokhoz.
Támogatott tevékenységek
Ezt az indexelőt a következő feladatokhoz használhatja:
- Adatindexelés és növekményes indexelés: Az indexelő képes indexelni a fájlokat és a kapcsolódó metaadatokat egy tóházban lévő adatútvonalakból. Az új és frissített fájlokat és metaadatokat a beépített változásészlelés segítségével észleli. Az adatfrissítést ütemezés szerint vagy igény szerint konfigurálhatja.
- Törlésészlelés: Az indexelő a legtöbb fájl és parancsikon egyéni metaadataival képes észlelni a törléseket . Ehhez metaadatokat kell hozzáadni a fájlokhoz, hogy jelezzék, hogy "helyreállíthatóan törölték" őket, ami lehetővé teszi az eltávolításukat a keresési indexből. Jelenleg nem lehet észlelni a törléseket a Google Cloud Storage-ban vagy az Amazon S3-n, mert ezek az adatforrások nem támogatják az egyedi metaadatokat.
- A készségkészleteken keresztül alkalmazott AI-bővítés:A készségkészleteket teljes mértékben támogatja a OneLake-fájlok indexelője. Ide tartoznak az olyan kulcsfontosságú funkciók, mint az integrált vektorizálás , amely adattömböket és beágyazási lépéseket ad hozzá.
- Elemzési módok: Az indexelő támogatja a JSON-elemzési módokat , ha JSON-tömböket vagy sorokat szeretne elemezni az egyes keresési dokumentumokban. Támogatja a Markdown-elemzési módot is.
- Kompatibilitás más funkciókkal: A OneLake indexelőt úgy tervezték, hogy zökkenőmentesen működjön más indexelő funkciókkal, például hibakeresési munkamenetekkel, indexelő gyorsítótárral növekményes bővítésekhez (előzetes verzió) és tudástárhoz.
Támogatott dokumentumformátumok
A OneLake-fájlok indexelője a következő dokumentumformátumokból tud szöveget kinyerni:
- CSV (lásd : CSV-blobok indexelése)
- EML
- EPUB
- GZ
- HTML
- JSON (lásd : JSON-blobok indexelése)
- KML (XML földrajzi ábrázolásokhoz)
- Markdown
- Microsoft Office formátumok: DOCX/DOC/DOCM, XLSX/XLS/XLSM, PPTX/PPT/PPTM, MSG (Outlook e-mailek), XML (2003 és 2006 WORD XML)
- Dokumentumformátumok megnyitása: ODT, ODS, ODP
- Egyszerű szöveges fájlok (lásd még : Egyszerű szöveg indexelése)
- RTF
- XML
- ZIP
Támogatott billentyűparancsok
A OneLake-fájlok indexelője a következő OneLake-parancsikonokat támogatja:
OneLake parancsikon (egy másik OneLake-példányra mutató parancsikon)
Fontos
Ha nem teljesíti valamelyik előfeltételt, vagy a dokumentált korlátozások hatálya alá tartozó művelet megkísérlése hibát okoz a lakehouse-elemek felsorolásakor.
Adatok előkészítése indexelésre
Az indexelés beállítása előtt tekintse át a forrásadatokat annak megállapításához, hogy szükség van-e a lakehouse-ban tárolt adatok módosítására. Az indexelők egyszerre egyetlen tárolóból (a lakehouse-ból) indexelhetik a tartalmat. Alapértelmezés szerint az indexelő feldolgozza az összes fájlt a lakehouse-ban. A fájlok szelektívebb feldolgozásához vegye figyelembe az alábbi lehetőségeket:
Fájlok elhelyezése virtuális mappába. Az indexelő adatforrásdefiníciója tartalmaz egy "lekérdezési" paramétert, amely lehet egy lakehouse almappája vagy parancsikonja. Ha ez az érték meg van adva, a rendszer csak az almappában vagy a lakehouse-ban lévő parancsikonban lévő fájlokat indexeli.
Fájlok belefoglalása vagy kizárása fájltípus szerint. A támogatott dokumentumformátumok listája segíthet meghatározni, hogy mely fájlokat zárja ki. Előfordulhat például, hogy ki szeretné zárni azokat a kép- vagy hangfájlokat, amelyek nem nyújtanak kereshető szöveget. Ezt a képességet az indexelő konfigurációs beállításai vezérlik.
Tetszőleges fájlok belefoglalása vagy kizárása. Ha valamilyen okból ki szeretne hagyni egy adott fájlt, metaadat-tulajdonságokat és értékeket adhat hozzá a lakehouse-ban lévő fájlokhoz. Amikor egy indexelő találkozik ezzel a tulajdonságmal, kihagyja a fájlt vagy annak tartalmát az indexelési futtatás során.
A fájlbefoglalást és a kizárást az indexelő konfigurációs lépése ismerteti. Ha nem állít be feltételeket, az indexelő hibaként jelent egy nem jogosult fájlt, és továbblép. Ha elegendő hiba történik, a feldolgozás leállhat. Az indexelő konfigurációs beállításaiban megadhatja a hibatűrést.
Az indexelők általában fájlonként egy keresési dokumentumot hoznak létre, ahol a szöveges tartalom és a metaadatok kereshető mezőkként vannak rögzítve egy indexben. Ha a fájlok teljes fájlok, akkor azokat több keresési dokumentumba is feldolgozhatja. Elemezheti például egy CSV-fájl sorait, hogy soronként egy keresési dokumentumot hozzon létre. Ha egyetlen dokumentumot kisebb részekre kell bontania az adatok vektorizálásához, fontolja meg az integrált vektorizáció használatát.
Fájl metaadatainak indexelése
A fájl metaadatai indexelhetők is, és ez akkor hasznos, ha úgy gondolja, hogy a standard vagy egyéni metaadat-tulajdonságok bármelyike hasznos a szűrőkben és a lekérdezésekben.
A rendszer szó szerint kinyeri a felhasználó által megadott metaadat-tulajdonságokat. Az értékek fogadásához meg kell határoznia a típus keresési indexében Edm.Stringlévő mezőt, amelynek neve megegyezik a blob metaadatkulcsával. Például, ha egy blob metaadat-kulcsa Priority, értéke pedig High, akkor meg kell határoznia, hogy a keresési indexben szerepeljen egy Priority nevű mező, amelyet az érték High-vel tölt fel.
A standard fájl metaadat-tulajdonságai az alábbi módon kinyerhetők hasonlóan elnevezett és beírt mezőkbe. A OneLake-fájlok indexelője automatikusan belső mezőleképezéseket hoz létre ezekhez a metaadat-tulajdonságokhoz, és az eredeti kötőjeles nevet ("metadata-storage-name") egy alászúrt egyenértékű névvé ("metadata_storage_name") konvertálja.
Továbbra is hozzá kell adnia az aláhúzott mezőket az indexdefinícióhoz, de kihagyhatja az indexelő mezőleképezést, mert az indexelő automatikusan elvégzi a társítást.
metadata_storage_name (
Edm.String) – a fájl neve. Ha például van egy fájlja /mydatalake/my-folder/subfolder/resume.pdf, akkor ennek a mezőnek az értékeresume.pdf.metadata_storage_path (
Edm.String) – a blob teljes URI-ja, beleértve a tárfiókot is. Például:https://myaccount.blob.core.windows.net/my-container/my-folder/subfolder/resume.pdfmetadata_storage_content_type (
Edm.String) – a blob feltöltéséhez használt kód által megadott tartalomtípus. Például:application/octet-stream.metadata_storage_last_modified (
Edm.DateTimeOffset) – a blob utolsó módosított időbélyege. Azure AI Keresés ezzel az időbélyegzővel azonosítja a módosított blobokat, hogy elkerülje a kezdeti indexelés utáni újraindexelést.metadata_storage_size (
Edm.Int64) – blobméret bájtban.metadata_storage_content_md5 (
Edm.String) – A blobtartalom MD5 kivonata, ha elérhető.
Végül az indexelt fájlok dokumentumformátumára vonatkozó metaadat-tulajdonságok is megjeleníthetők az indexsémában. A tartalomspecifikus metaadatokról további információt a Tartalom metaadatainak tulajdonságai című témakörben talál.
Fontos kiemelni, hogy nem kell mezőket definiálnia a keresési indexben szereplő összes fenti tulajdonsághoz – csak rögzítse az alkalmazáshoz szükséges tulajdonságokat.
Engedélyek megadása
A OneLake indexelő jogkivonat-hitelesítést és szerepköralapú hozzáférést használ a OneLake-hez való kapcsolatokhoz. Az engedélyek a OneLake-ben vannak hozzárendelve. A parancsikonok mögött álló fizikai adattárakra nem vonatkoznak engedélykövetelmények. Ha például az AWS-ből indexel, nem kell keresési szolgáltatási engedélyeket adnia az AWS-ben.
A keresési szolgáltatás identitásának minimális szerepkör-hozzárendelése a 'Hozzájáruló' szerepkör.
Konfiguráljon egy rendszert vagy felhasználó által felügyelt identitást a Azure AI Keresés szolgáltatáshoz.
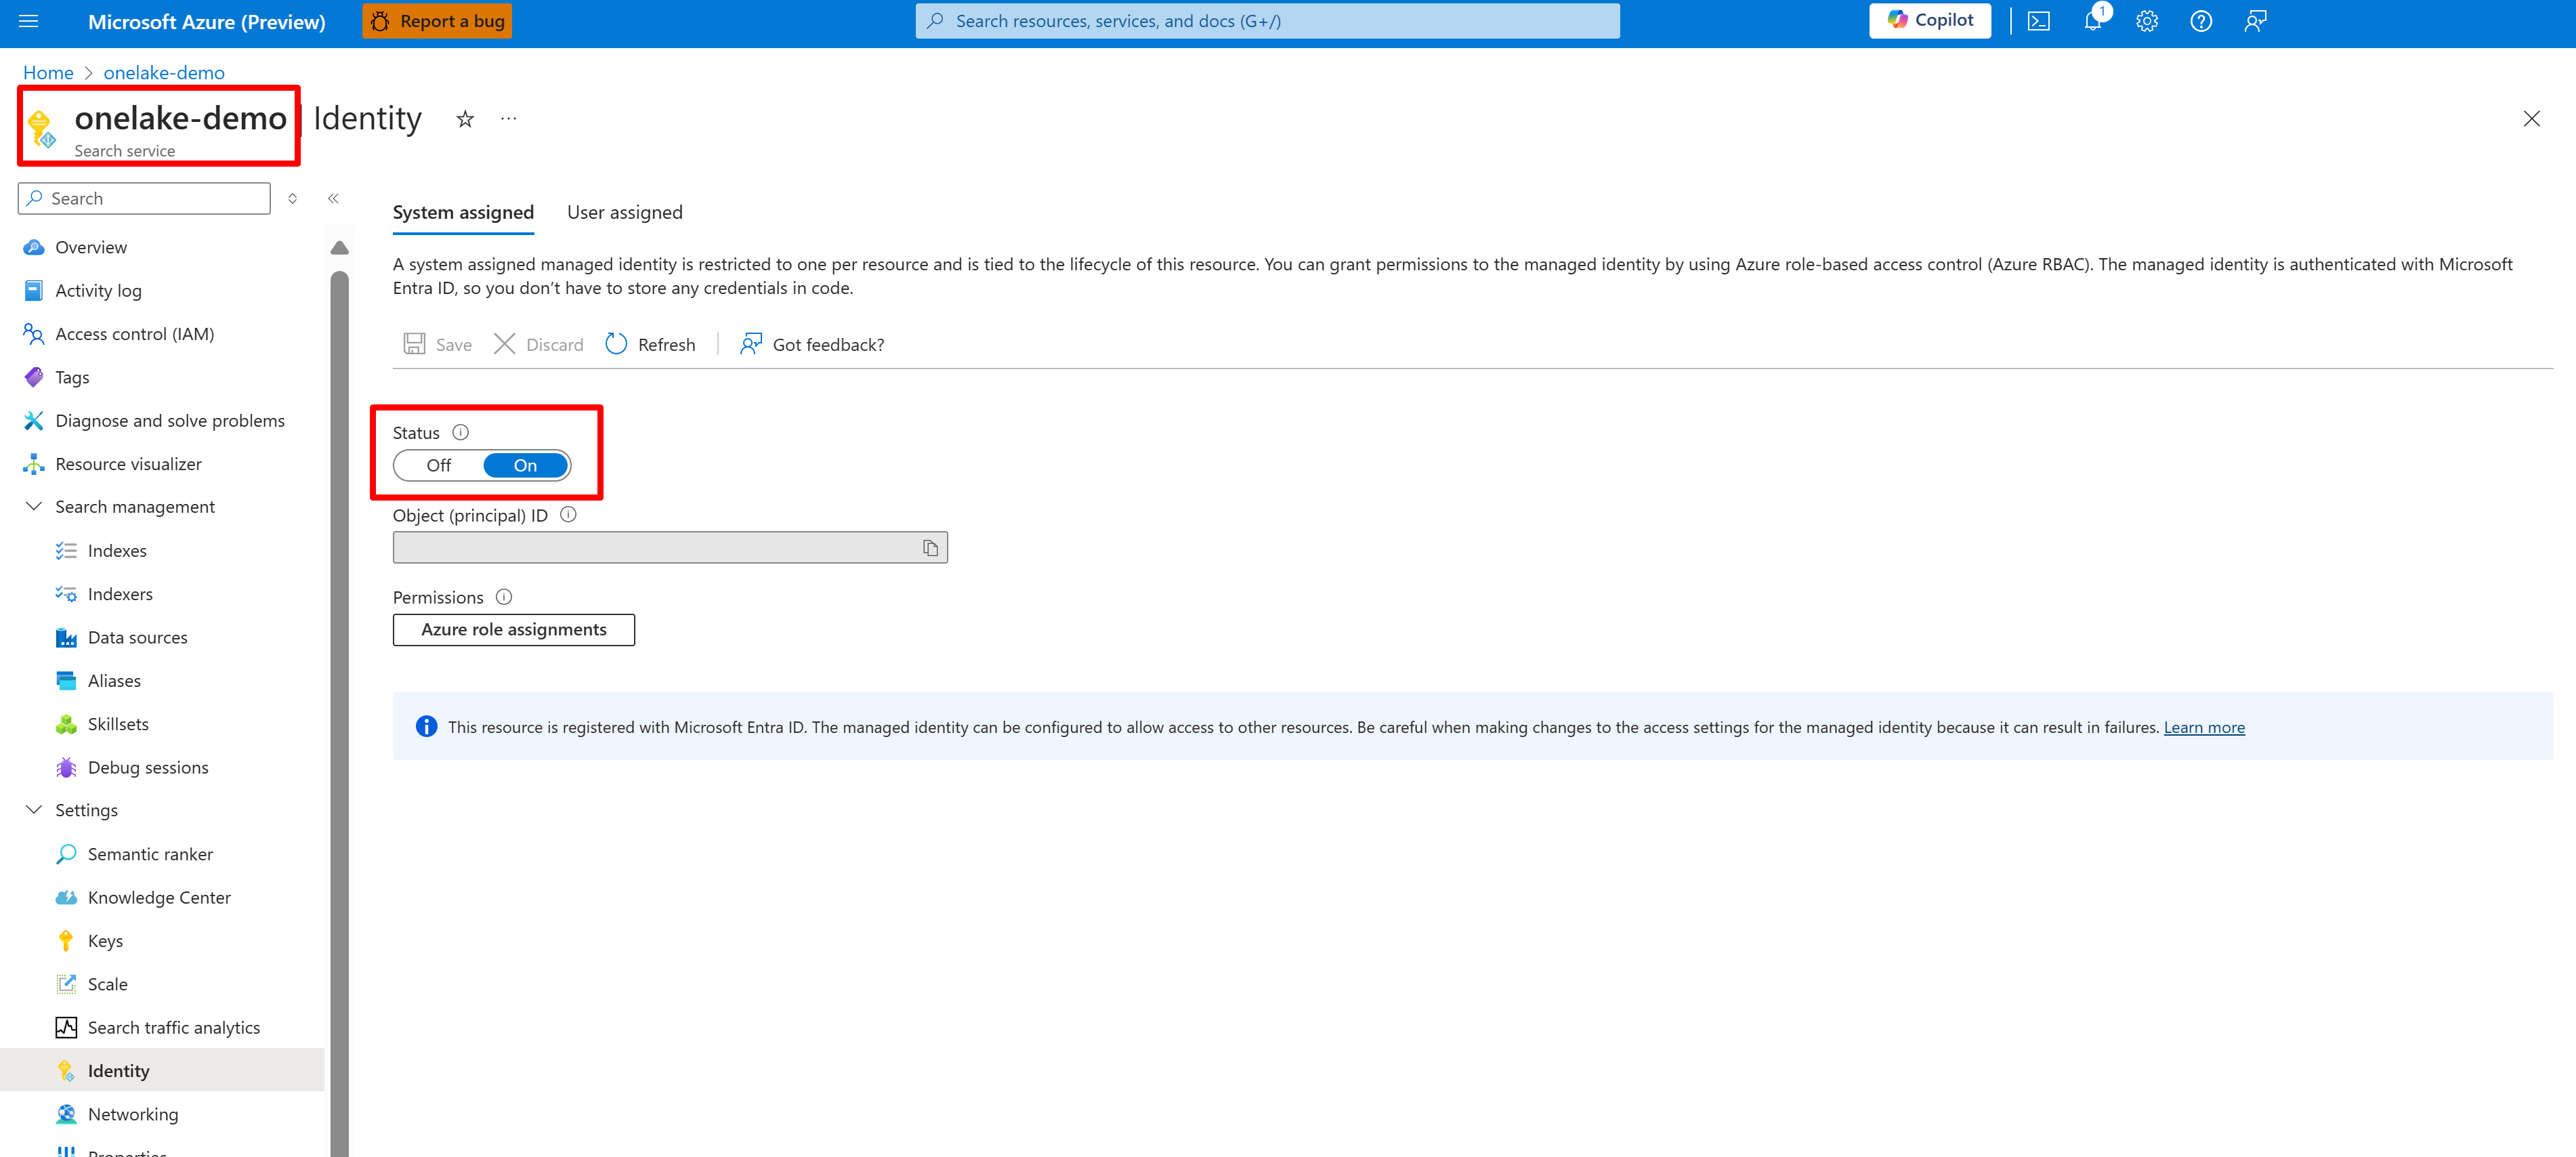
Az alábbi képernyőképen egy rendszer által felügyelt identitás látható egy "onelake-demo" nevű keresési szolgáltatáshoz.
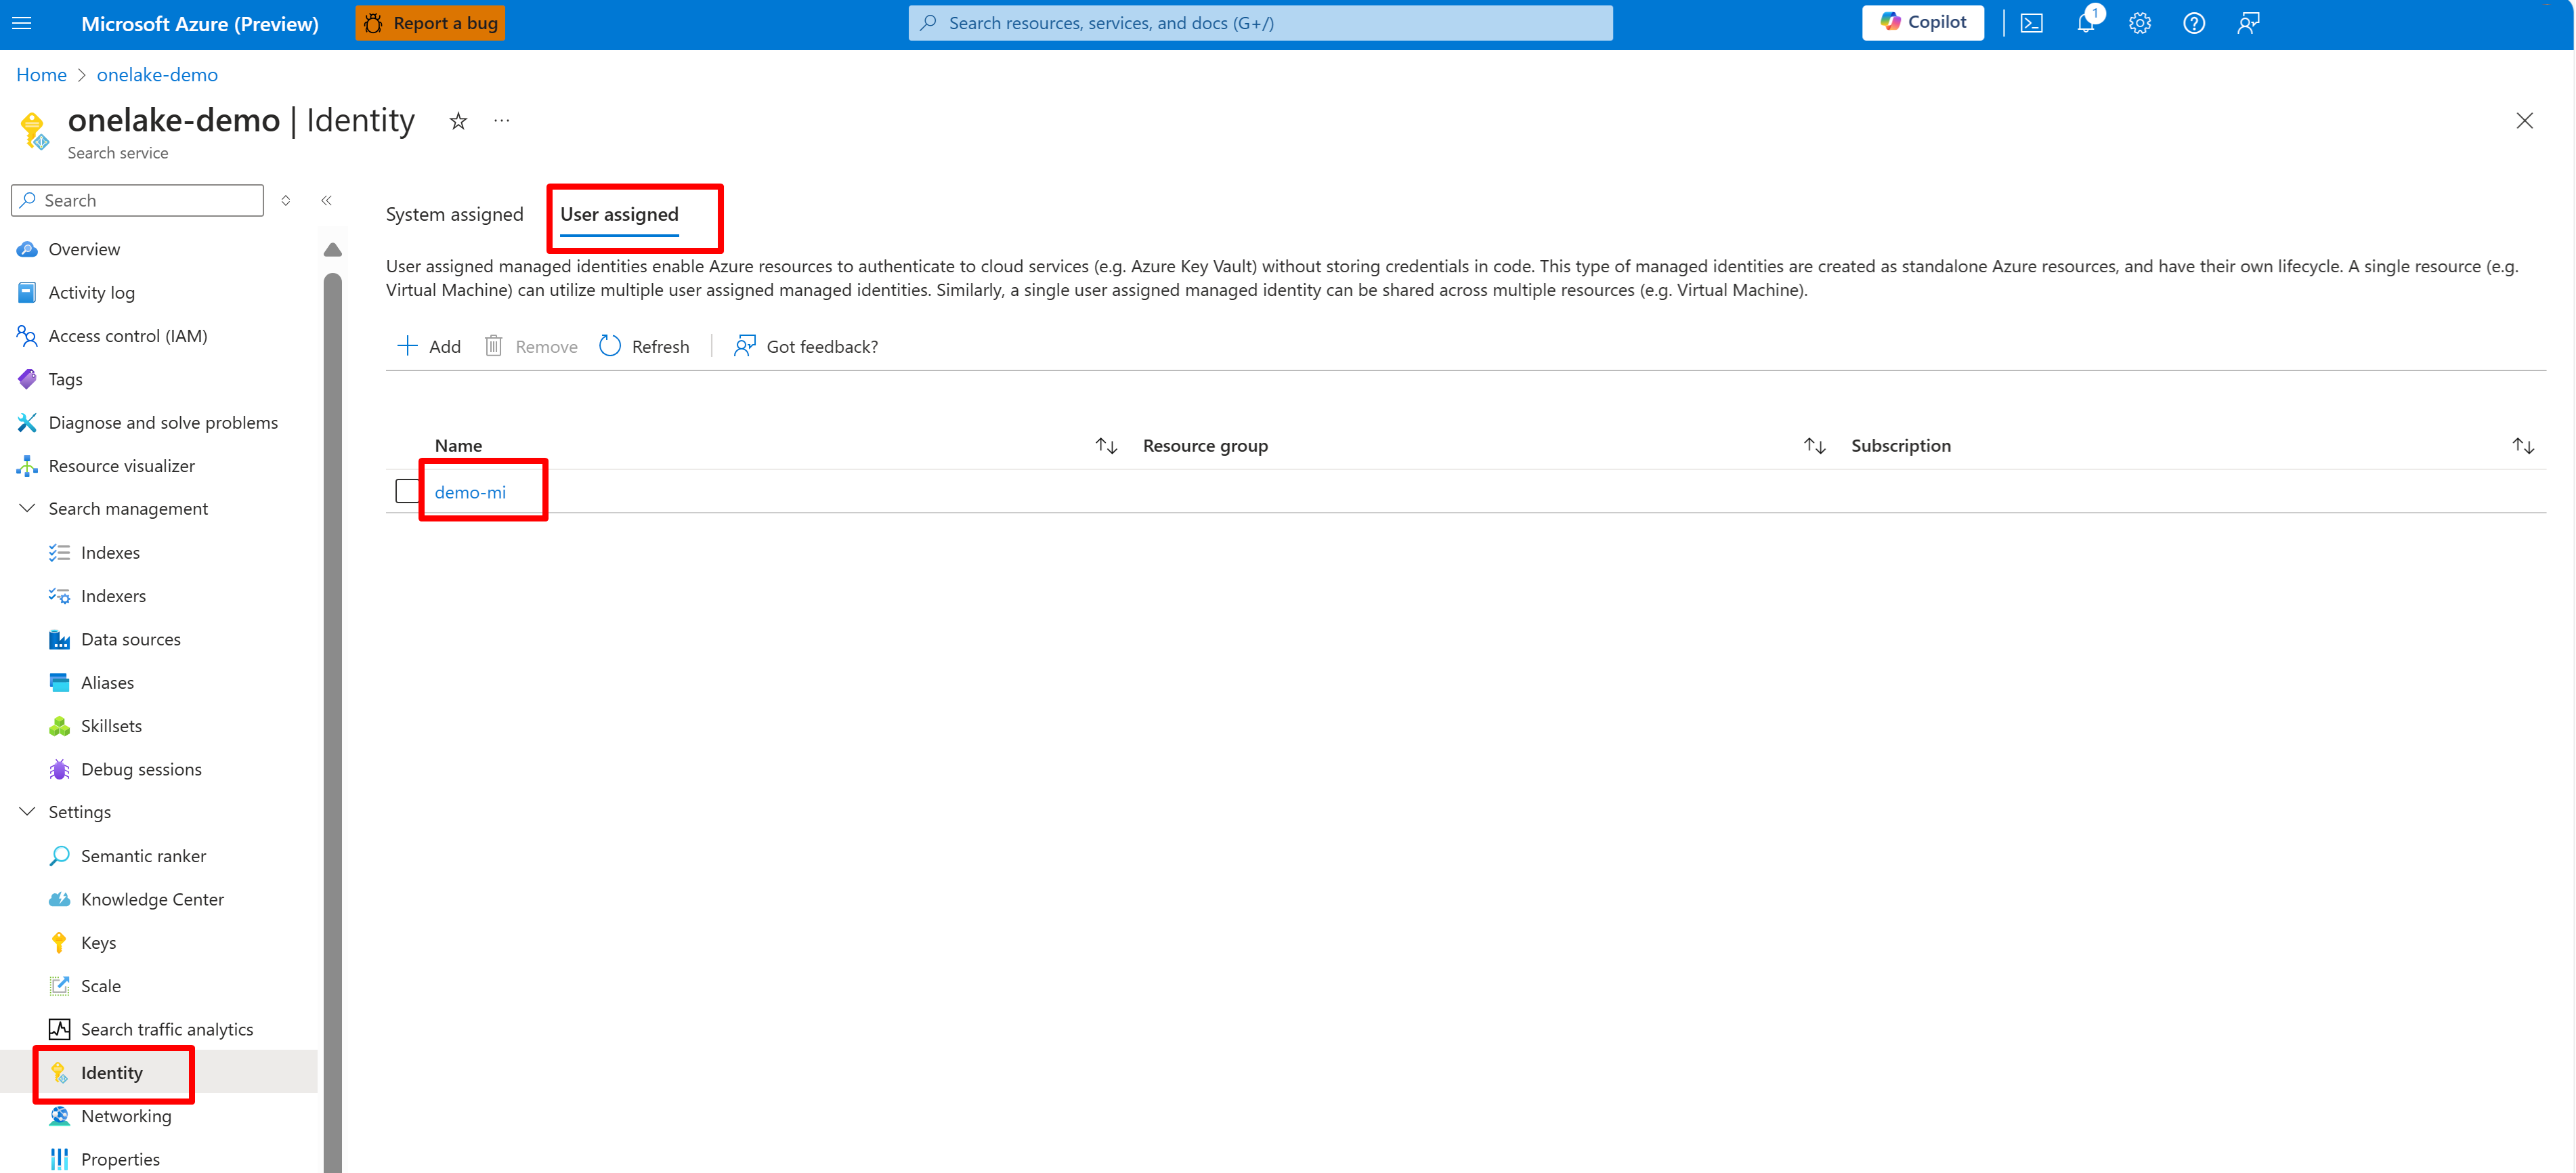
Ez a képernyőkép egy felhasználó által felügyelt identitást jelenít meg ugyanahhoz a keresési szolgáltatáshoz.
Adjon engedélyt a keresési szolgáltatás eléréséhez a Fabric munkaterületen. A keresési szolgáltatás az indexelő nevében hozza létre a kapcsolatot.
Ha rendszer által hozzárendelt felügyelt identitást használ, keresse meg a Azure AI Keresés szolgáltatás nevét. Felhasználó által hozzárendelt felügyelt identitás esetén keresse meg az identitáserőforrás nevét.
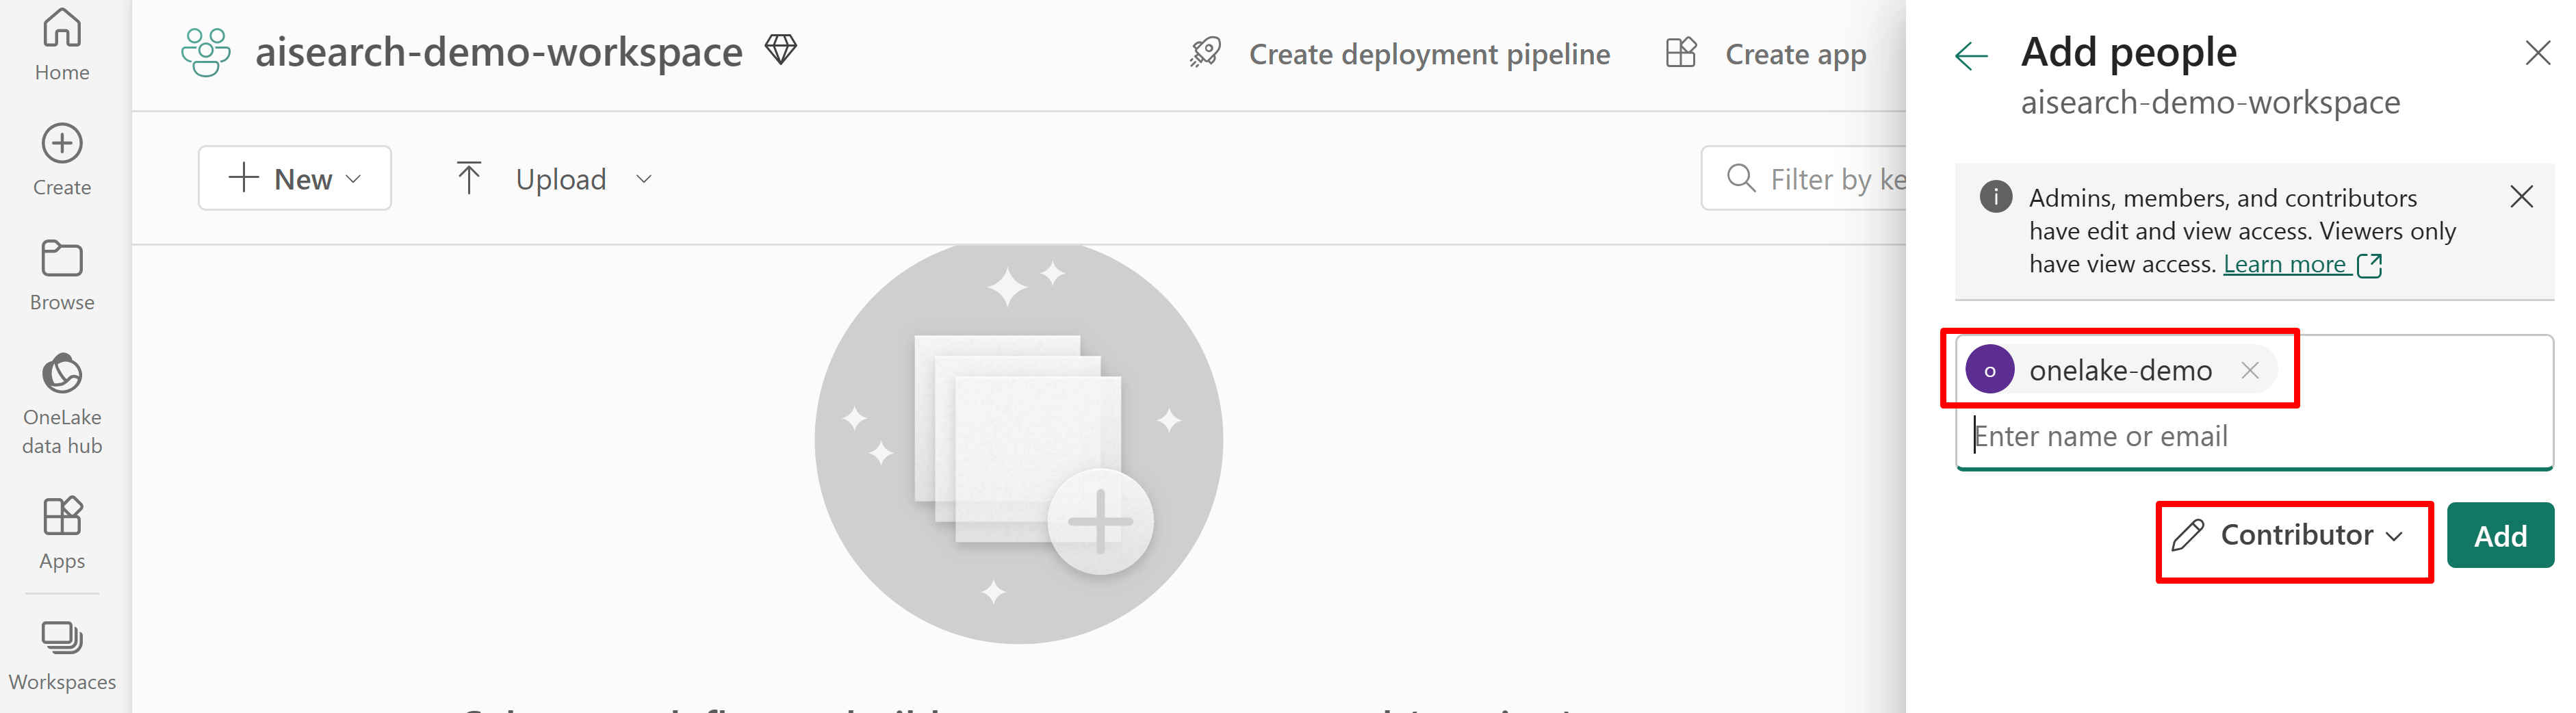
Az alábbi képernyőképen egy közreműködői szerepkör hozzárendelése látható egy rendszer által felügyelt identitás használatával.
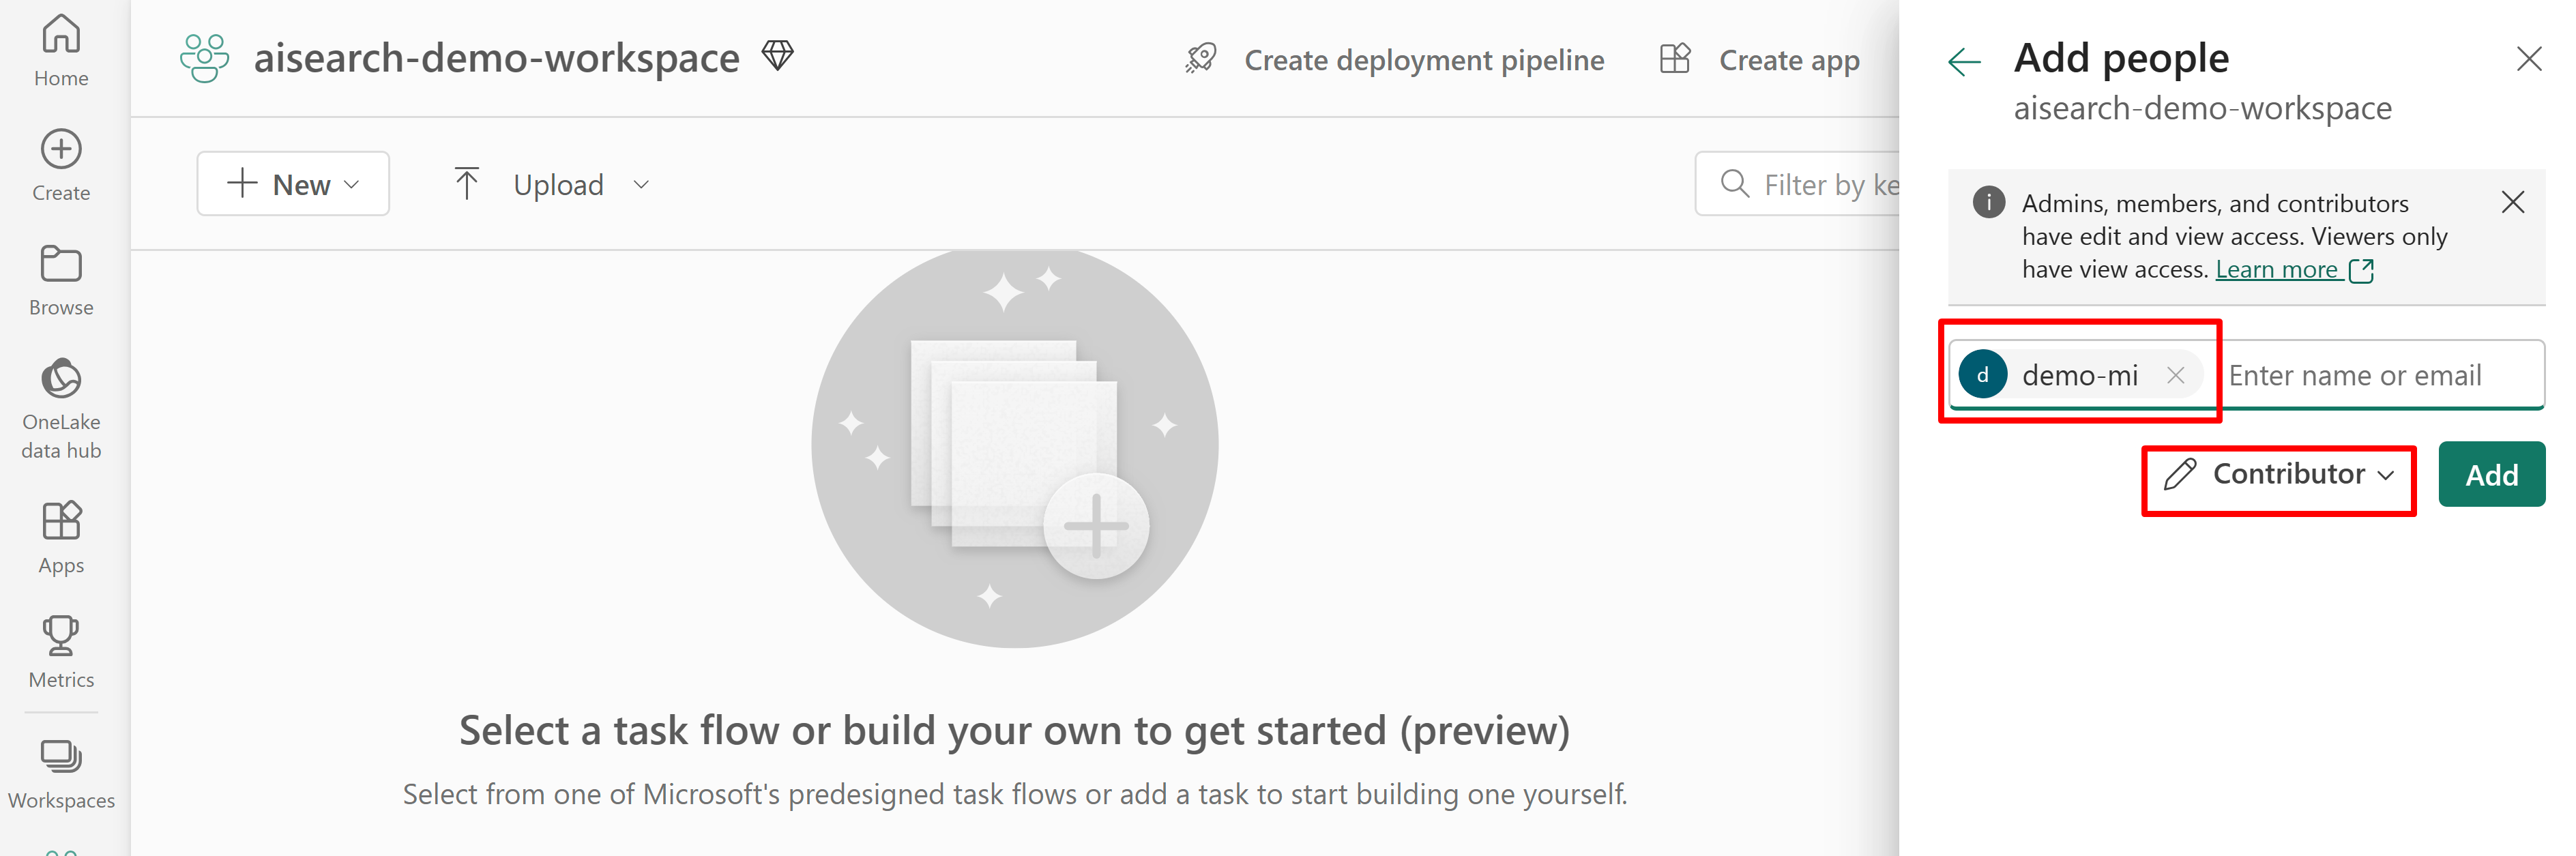
Ez a képernyőkép egy közreműködői szerepkör-hozzárendelést jelenít meg egy felhasználó által hozzárendelt felügyelt identitás használatával:
Megosztott privát kapcsolat konfigurálása (Fabric munkaterületszintű privát hivatkozás használata esetén szükséges)
Ha a Fabric-munkaterületet egy private-hivatkozás védi, Azure AI Keresés nem fog tudni hozzáférni a lakehouse-adatokhoz a nyilvános interneten keresztül, és nem fogja tudni konfigurálni az indexelőt vagy annak szükséges függőségeit, például az adatforrást. A hozzáférés engedélyezéséhez konfigurálnia kell egy osztott privát kapcsolatot a Azure AI Keresés és a Fabric-munkaterület között.
Az adatforrás meghatározása
Egy adatforrás független erőforrásként van definiálva, így több indexelő is használhatja.
A definíció beállításához használja az adatforrás REST API-jának létrehozását vagy frissítését . Ezek a definíció legfontosabb lépései.
Állítsa be a (kötelező) értéket
"type""onelake".Kérje le a Microsoft Fabric munkaterület GUID-azonosítót és a lakehouse GUID azonosítót:
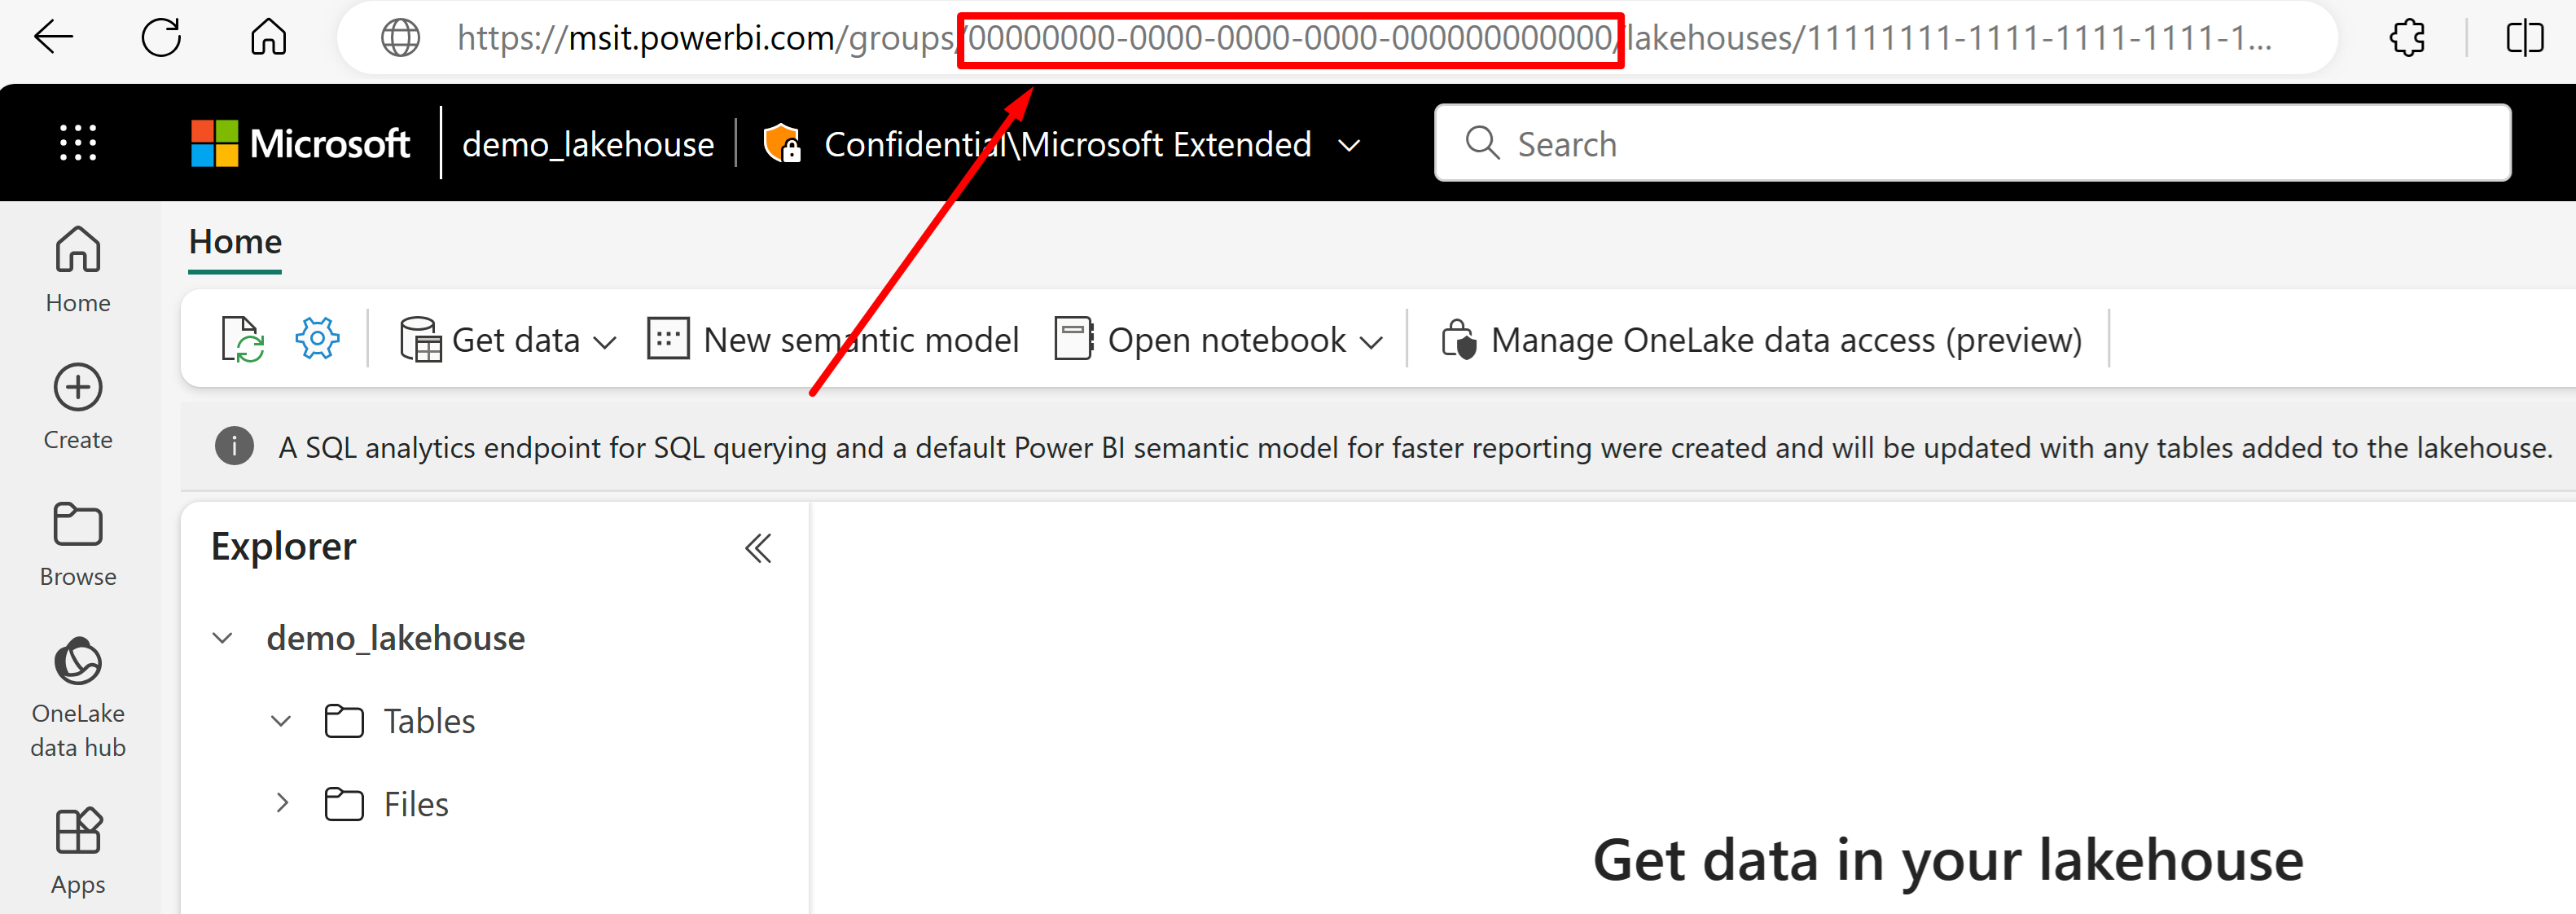
A Power BI nyissa meg azt a tóházat, amelyből adatokat szeretne importálni. Figyelje meg a lakehouse URL-címét a böngészőben. Ennek a példához hasonlóan kell kinéznie: "https://msit.powerbi.com/groups/00000000-0000-0000-0000-000000000000/lakehouses/11111111-1111-1111-1111-111111111111". Az URL-cím tartalmazza a munkaterület GUID-címét és a lakehouse GUID azonosítót is. Ha a Fabric munkaterületet privát hivatkozás védi, az URL-cím a következővel kezdődik: "https://{FabricWorkspaceGuid}.z{xy}.blob.fabric. microsoft.com".
Másolja ki a munkaterület GUID azonosítóját, amely az URL-cím "csoportok" jobb oldalán található. Ebben a példában 00000000-0000-0000-0000-000000000000. A REST-fájlban hozzon létre egy környezeti változót
{FabricWorkspaceGuid}, és állítsa be a munkaterület GUID-jához. Ha a munkaterület privát hivatkozást használ, a munkaterület GUID azonosítója az URL-cím egy másik helyén jelenik meg. Ügyeljen arra, hogy a beállítás alapján hivatkozzon az URL-cím megfelelő részére.
Másolja ki a lakehouse GUID azonosítót, amely közvetlenül a "lakehouses" után szerepel az URL-címben. Ebben a példában a következő lenne: 111111111-1111-1111-1111-11111111111. A REST-fájlban hozzon létre egy környezeti változót
{LakehouseGuid}, és állítsa be a lakehouse GUID-ra.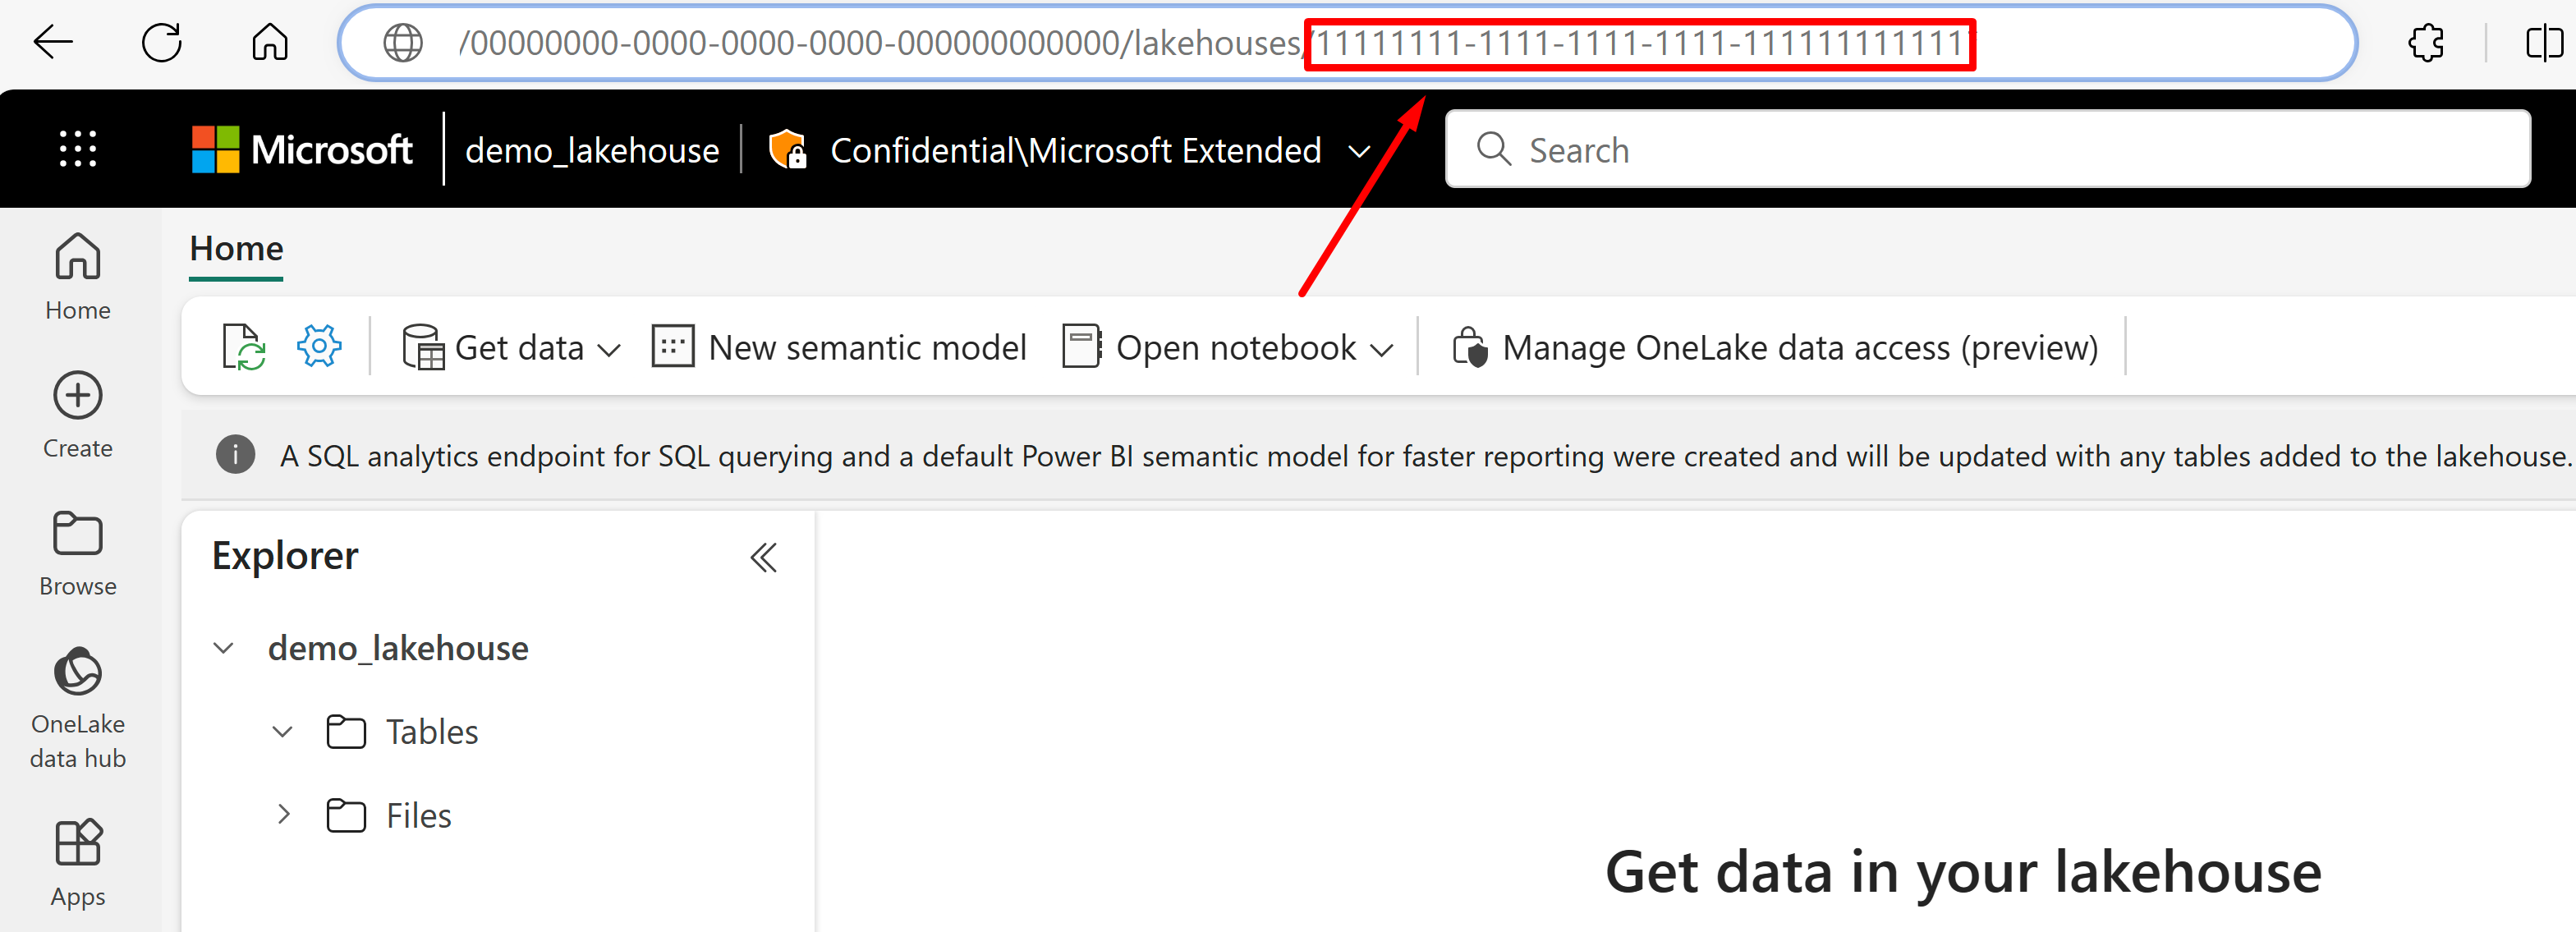
Állítsa be a
"credentials"a Microsoft Fabric munkaterület GUID azonosítónak, úgy hogy a{FabricWorkspaceGuid}helyébe az előző lépésben másolt értéket másolja. Ez a OneLake, amelyhez a későbbiekben ebben az útmutatóban beállított felügyelt identitással fogsz hozzáférni."credentials": { "connectionString": "ResourceId={FabricWorkspaceGuid}" }
A megosztott privát kapcsolaton keresztüli beállításhoz a felügyelt identitások beállításához használja az alábbi kapcsolat karakterláncot, amely eltér az interneten keresztül történő kommunikáció beállításától. Vegye figyelembe, hogy nem csak az URL-cím különbözik, hanem a WorkspaceEndpoint-t használják a ResourceId helyett is. Ezt vegye figyelembe a rendszer által felügyelt identitás vagy a felhasználó által felügyelt identitásbeállítások konfigurálásakor.
 "credentials": {
 "connectionString": "WorkspaceEndpoint=https://{FabricWorkspaceGuid}.z{xy}.blob.fabric.microsoft.com"
 }
Állítsa be a
"container.name"címkét a lakehouse GUID-ra, majd cserélje le a{LakehouseGuid}a korábban kimásolt értékre. A"query"segítségével lehet megadni egy Lakehouse almappát vagy parancsikont."container": { "name": "{LakehouseGuid}", "query": "{optionalLakehouseFolderOrShortcut}" }Állítsa be a hitelesítési módszert a felhasználó által hozzárendelt felügyelt identitással, vagy ugorjon a rendszer által felügyelt identitás következő lépésére.
{
  "name": "{dataSourceName}",
  "description": "description",
  "type": "onelake",
  "credentials": {
    "connectionString": "ResourceId={FabricWorkspaceGuid}"
  },
  "container": {
    "name": "{LakehouseGuid}",
    "query": "{optionalLakehouseFolderOrShortcut}"
  },
  "identity": {
    "@odata.type": "Microsoft.Azure.Search.DataUserAssignedIdentity",
    "userAssignedIdentity": "{userAssignedManagedIdentity}"
  }
}
Az
userAssignedIdentityérték az erőforráshoz való hozzáféréskor található meg, a{userAssignedManagedIdentity}tulajdonságok lapján, és a neveId.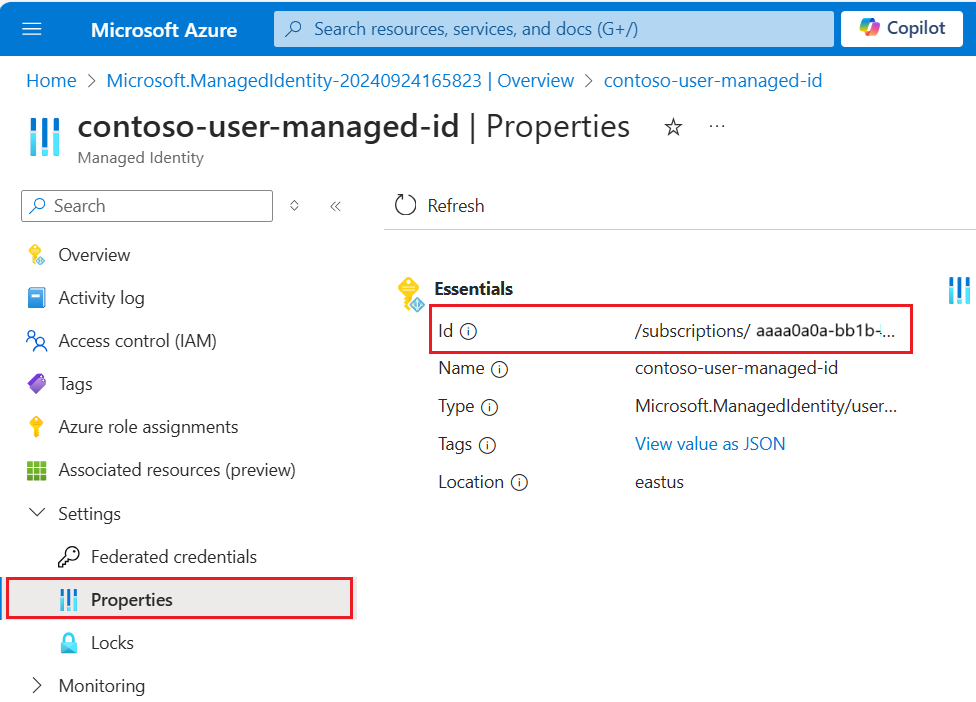
Példa:
{
  "name": "mydatasource",
  "description": "description",
  "type": "onelake",
  "credentials": {
    "connectionString": "ResourceId=a0a0a0a0-bbbb-cccc-dddd-e1e1e1e1e1e1"
  },
  "container": {
    "name": "11111111-1111-1111-1111-111111111111",
    "query": "folder_name"
  },
  "identity": {
    "@odata.type": "Microsoft.Azure.Search.DataUserAssignedIdentity",
    "userAssignedIdentity": "/subscriptions/333333-3333-3333-3333-33333333/resourcegroups/myresourcegroup/providers/Microsoft.ManagedIdentity/userAssignedIdentities/demo-mi"
  }
}
Ha szeretné, használjon inkább rendszer által hozzárendelt felügyelt identitást. Ha rendszer által hozzárendelt felügyelt identitást használ, az "identitás" el lesz távolítva a definícióból.
{
  "name": "{dataSourceName}",
  "description": "description",
  "type": "onelake",
  "credentials": {
    "connectionString": "ResourceId={FabricWorkspaceGuid}"
  },
  "container": {
    "name": "{LakehouseGuid}",
    "query": "{optionalLakehouseFolderOrShortcut}"
  }
}
Példa:
{
  "name": "mydatasource",
  "description": "description",
  "type": "onelake",
  "credentials": {
    "connectionString": "ResourceId=a0a0a0a0-bbbb-cccc-dddd-e1e1e1e1e1e1"
  },
  "container": {
    "name": "11111111-1111-1111-1111-111111111111",
    "query": "folder_name"
  }
}
Törlések észlelése egyéni metaadatokkal
A OneLake files indexelő adatforrásdefiníciója helyreállítható törlési szabályzatot is tartalmazhat, ha azt szeretné, hogy az indexelő töröljön egy keresési dokumentumot, amikor a forrásdokumentumot törlésre jelölik meg.
Az automatikus fájltörlés engedélyezéséhez egyéni metaadatokkal jelezze, hogy el kell-e távolítani egy keresési dokumentumot az indexből.
A munkafolyamat három külön műveletet igényel:
- A fájl puha törlése a OneLake-ban
- Az indexelő törli a keresési dokumentumot az indexben
- A fájl "kemény törlése" a OneLake-ben
A "puha törlés" arra utasítja az indexelőt, mi a feladata (törölje a keresési dokumentumot). Ha először törli a fizikai fájlt a OneLake-ben, az indexelőnek nincs mit olvasnia, és az indexben lévő megfelelő keresési dokumentum árva lesz.
A OneLake-ben és a Azure AI Keresés is követendő lépések vannak, de nincsenek más funkciófüggőségek.
A lakehouse-fájlban adjon hozzá egy egyéni metaadatkulcs-érték párot a fájlhoz, amely jelzi, hogy a fájl törlésre van megjelölve. Elnevezheti például az "IsDeleted" tulajdonságot, és állítsa "false" értékre. Ha törölni szeretné a fájlt, állítsa az értékét igazra.
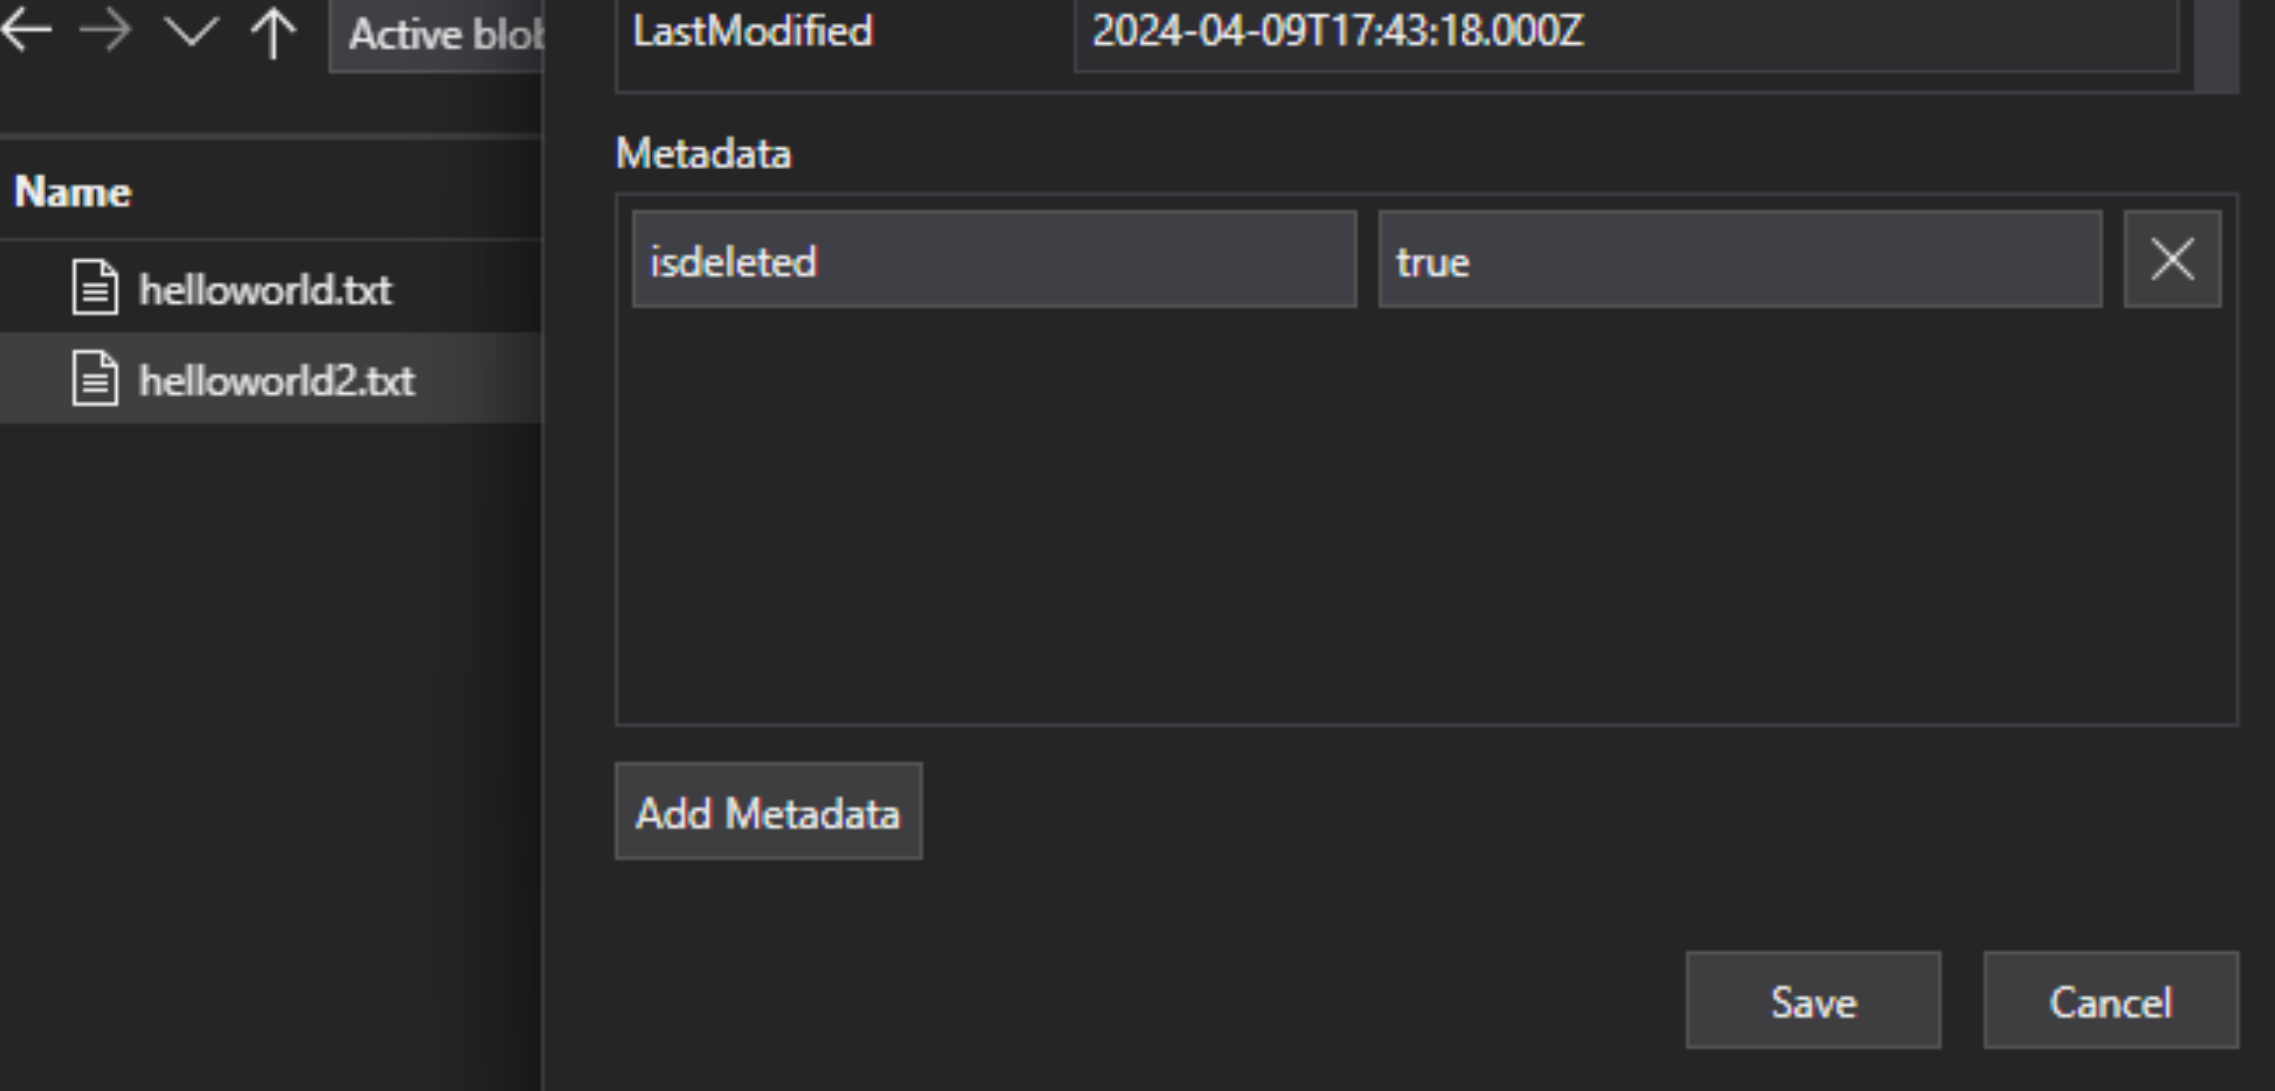
A Azure AI Keresés szerkessze az adatforrás definícióját úgy, hogy az tartalmazza a "dataDeletionDetectionPolicy" tulajdonságot. Az alábbi szabályzat például úgy véli, hogy egy fájl törölve van, ha az "IsDeleted" metaadat-tulajdonsága igaz:
PUT https://[service name].search.windows.net/datasources/file-datasource?api-version=2026-04-01
{
    "name" : "onelake-datasource",
    "type" : "onelake",
     "credentials": {
        "connectionString": "ResourceId={FabricWorkspaceGuid}"
    },
    "container": {
        "name": "{LakehouseGuid}",
        "query": "{optionalLakehouseFolderOrShortcut}"
    },
    "dataDeletionDetectionPolicy" : {
        "@odata.type" :"#Microsoft.Azure.Search.SoftDeleteColumnDeletionDetectionPolicy",
        "softDeleteColumnName" : "IsDeleted",
        "softDeleteMarkerValue" : "true"
    }
}
Miután az indexelő futtatta és törölte a dokumentumot a keresési indexből, törölheti a fizikai fájlt a data lake-ben.
Néhány fontos pont a következők:
Az indexelő futtatásának ütemezése segít automatizálni ezt a folyamatot. Az összes növekményes indexelési forgatókönyv ütemezését javasoljuk.
Ha a törlésészlelési szabályzat nem lett beállítva az első indexelő futtatásakor, alaphelyzetbe kell állítania az indexelőt , hogy beolvassa a frissített konfigurációt.
Ne feledje, hogy a törlésészlelés nem támogatott az Amazon S3 és a Google Cloud Storage billentyűparancsai esetében az egyéni metaadatoktól való függőség miatt.
Keresési mezők hozzáadása indexhez
Egy keresési indexben adjon hozzá mezőket a OneLake data lake-fájlok tartalmának és metaadatainak elfogadásához.
Hozzon létre vagy frissítsen egy indexet a fájltartalmakat és metaadatokat tároló keresési mezők definiálásához:
{
    "name" : "my-search-index",
    "fields": [
        { "name": "ID", "type": "Edm.String", "key": true, "searchable": false },
        { "name": "content", "type": "Edm.String", "searchable": true, "filterable": false },
        { "name": "metadata_storage_name", "type": "Edm.String", "searchable": false, "filterable": true, "sortable": true  },
        { "name": "metadata_storage_size", "type": "Edm.Int64", "searchable": false, "filterable": true, "sortable": true  },
        { "name": "metadata_storage_content_type", "type": "Edm.String", "searchable": false, "filterable": true, "sortable": true }
    ]
}
Hozzon létre egy dokumentumkulcsmezőt ("key": true). A fájltartalmak esetében a legjobb jelöltek a metaadat-tulajdonságok.
metadata_storage_path(alapértelmezett) az objektum vagy fájl teljes elérési útja. A kulcsmező ("Azonosító" ebben a példában) metadata_storage_path értékeivel van feltöltve, mert ez az alapértelmezett érték.metadata_storage_name, csak akkor használható, ha a nevek egyediek. Ha ezt a mezőt szeretné kulcsként használni, lépjen"key": trueerre a meződefinícióra.A fájlokhoz hozzáadott egyéni metaadat-tulajdonság. Ehhez a beállításhoz a fájlfeltöltési folyamatnak hozzá kell adnia ezt a metaadat-tulajdonságot az összes blobhoz. Mivel a kulcs egy kötelező tulajdonság, az érték nélküli fájlok indexelése sikertelen. Ha egyéni metaadat-tulajdonságot használ kulcsként, ne módosítsa a tulajdonságot. Az indexelők duplikált dokumentumokat adnak hozzá ugyanahhoz a fájlhoz, ha a kulcstulajdonság megváltozik.
A metaadat-tulajdonságok gyakran tartalmaznak olyan karaktereket, például
/és-, amelyek érvénytelenek a dokumentumkulcsokhoz. Mivel az indexelő rendelkezik egy "base64EncodeKeys" tulajdonsággal (alapértelmezés szerint igaz), automatikusan kódolja a metaadat-tulajdonságot, konfiguráció vagy mezőleképezés nélkül.Adjon hozzá egy "content" mezőt az egyes fájlokból kinyert szöveg tárolásához a fájl "content" tulajdonságán keresztül. Ezt a nevet nem kell használnia, de így kihasználhatja az implicit mezőleképezések előnyeit.
Adjon hozzá mezőket a szabványos metaadat-tulajdonságokhoz. Az indexelő elolvashatja az egyéni metaadat-tulajdonságokat, a szabványos metaadat-tulajdonságokat és a tartalomspecifikus metaadat-tulajdonságokat .
A OneLake-fájlok indexelőjének konfigurálása és futtatása
Az index és az adatforrás létrehozása után készen áll az indexelő létrehozására. Az indexelő konfigurációja meghatározza a futási idő viselkedését vezérlő bemeneteket, paramétereket és tulajdonságokat. Megadhatja azt is, hogy a blob mely részeit indexelje.
Hozzon létre vagy frissítsen egy indexelőt úgy, hogy megad neki egy nevet, és hivatkozik az adatforrásra és a célindexre:
{
  "name" : "my-onelake-indexer",
  "dataSourceName" : "my-onelake-datasource",
  "targetIndexName" : "my-search-index",
  "parameters": {
      "batchSize": null,
      "maxFailedItems": null,
      "maxFailedItemsPerBatch": null,
      "base64EncodeKeys": null,
      "configuration": {
          "indexedFileNameExtensions" : ".pdf,.docx",
          "excludedFileNameExtensions" : ".png,.jpeg",
          "dataToExtract": "contentAndMetadata",
          "parsingMode": "default"
      }
  },
  "schedule" : { },
  "fieldMappings" : [ ]
}
Állítsa be a "batchSize" értéket, ha az alapértelmezett (10 dokumentum) a rendelkezésre álló erőforrások kihasználása vagy túlterhelése alatt áll. Az alapértelmezett kötegméretek adatforrás-specifikusak. A fájlindexelés a kötegméretet 10 dokumentumra állítja a nagyobb átlagos dokumentumméret elismeréseként.
A "konfiguráció" alatt szabályozhatja, hogy mely fájlok legyenek indexelve a fájltípus alapján, vagy hagyja meg nem határozottul az összes fájl lekéréséhez.
Ehhez
"indexedFileNameExtensions"adja meg a fájlkiterjesztések vesszővel tagolt listáját (vezető ponttal). Ugyanezzel"excludedFileNameExtensions"a módszerrel jelezheti, hogy mely bővítményeket kell kihagyni. Ha ugyanaz a bővítmény mindkét listában szerepel, akkor az indexelésből ki lesz zárva.A "konfiguráció" területen állítsa be a "dataToExtract" értéket a fájlok indexelt részeinek szabályozásához:
A "contentAndMetadata" az alapértelmezett érték. Megadja, hogy a fájlból kinyert összes metaadat és szöveges tartalom indexelve legyen.
A "storageMetadata" azt határozza meg, hogy csak a szabványos fájltulajdonságok és a felhasználó által megadott metaadatok legyenek indexelve. Bár a tulajdonságok Azure blobokhoz vannak dokumentálva, a fájltulajdonságok megegyeznek a OneLake esetében, kivéve az SAS-hez kapcsolódó metaadatokat.
Az "allMetadata" azt határozza meg, hogy a rendszer kinyeri és indexeli a szabványos fájltulajdonságokat és a talált tartalomtípusok metaadatait .
A "konfiguráció" területen állítsa be a "parsingMode" értéket, ha a fájlokat több keresési dokumentumra kell leképezni, vagy ha egyszerű szövegből, JSON-dokumentumokból vagy CSV-fájlokból állnak.
Mezőleképezéseket adhat meg , ha a mezőnév vagy a típus eltérést mutat, vagy ha egy forrásmező több verziójára van szüksége a keresési indexben.
A fájlindexelés során gyakran kihagyhatja a mezőleképezéseket, mert az indexelő beépített támogatással rendelkezik a "tartalom" és a metaadat tulajdonságainak az index hasonló nevű és begépelt mezőihez való leképezéséhez. Metaadat-tulajdonságok esetén az indexelő automatikusan lecseréli a kötőjeleket
-aláhúzásjelekre a keresési indexben.
További információ az egyéb tulajdonságokról: Indexelő létrehozása. A paraméterleírások teljes listáját lásd: Indexelő létrehozása (REST) a REST API-ban. A paraméterek megegyeznek Microsoft OneLake esetében.
Alapértelmezés szerint az indexelő automatikusan fut a létrehozásakor. Ezt a viselkedést úgy módosíthatja, hogy a "letiltva" értéket igazra állítja. Ha letiltott állapotban hoz létre egy indexelőt, igény szerint futtasson egy indexelőt, amikor készen áll annak használatára, vagy ütemezze.
Indexelő állapotának ellenőrzése
Itt több módszert is megismerhet az indexelőzmények állapotának és végrehajtási előzményeinek monitorozásához.
Hibák kezelése
Az indexelés során gyakran előforduló hibák közé tartoznak a nem támogatott tartalomtípusok, hiányzó tartalmak vagy túlméretezett fájlok. Alapértelmezés szerint a OneLake-fájlok indexelője leáll, amint nem támogatott tartalomtípusú fájlba ütközik. Előfordulhat azonban, hogy azt szeretné, hogy az indexelés akkor is folytatódjon, ha hibák történnek, majd később hibakeresést végezzen az egyes dokumentumokban.
A több platformot és terméket érintő megoldások esetében gyakoriak az átmeneti hibák. Ha azonban ütemezve tartja az indexelőt (például 5 percenként), az indexelőnek képesnek kell lennie a hibák helyreállítására a következő futtatás során.
Öt indexelőtulajdonság vezérli az indexelő válaszát hibák esetén.
{
  "parameters" : {
    "maxFailedItems" : 10,
    "maxFailedItemsPerBatch" : 10,
    "configuration" : {
        "failOnUnsupportedContentType" : false,
        "failOnUnprocessableDocument" : false,
        "indexStorageMetadataOnlyForOversizedDocuments": false
    }
  }
}
| Paraméter | Érvényes értékek | Leírás |
|---|---|---|
| maximális hibás elemek száma | -1, null vagy 0, pozitív egész szám | Folytassa az indexelést, ha hibák történnek a feldolgozás bármely pontján, akár blobok elemzésekor, akár dokumentumok indexhez való hozzáadásakor. Állítsa be ezeket a tulajdonságokat az elfogadható hibák számának megfelelően. Egy -1 értéke lehetővé teszi a feldolgozást, függetlenül attól, hány hiba fordul elő. Ellenkező esetben az érték pozitív egész szám. |
| MaximálisHibásElemekTételenként | -1, null vagy 0, pozitív egész szám | Ugyanaz, mint a fenti, de batch indexeléshez használatos. |
| "hibaNemTámogatottTartalomTípusEsetén" | igaz vagy hamis | Ha az indexelő nem tudja meghatározni a tartalomtípust, adja meg, hogy folytatja-e a feladatot, vagy nem. |
| "hibaNemFeldolgozhatóDokumentumEsetén" | igaz vagy hamis | Ha az indexelő nem tud feldolgozni egy egyébként támogatott tartalomtípusú dokumentumot, adja meg, hogy folytatja-e a feladatot, vagy nem. |
| "indexTárhelyMetaadatCsakTúlméretezettDokumentumokhoz" | igaz vagy hamis | A túlméretezett blobokat alapértelmezés szerint hibaként kezeli a rendszer. Ha igaz értékre állítja ezt a paramétert, az indexelő akkor is megpróbálja indexelni a metaadatait, ha a tartalom nem indexelhető. A blob méretére vonatkozó korlátozásokért tekintse meg a szolgáltatás korlátait. |
Következő lépések
Ismerje meg az