Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Nota
Búsqueda de Azure AI está disponible a través del portal de Azure, las API REST y los SDK de Azure. También respalda Foundry IQ, la capa de conocimiento administrada que transforma el contenido empresarial en bases de conocimiento reutilizables y compatibles con permisos para agentes en el portal de Microsoft Foundry.
En este artículo se explica cómo actualizar un índice existente en Búsqueda de Azure AI con cambios de esquema o cambios de contenido a través de la indexación incremental.
Sugerencia
Para actualizar los documentos inmediatamente, vaya a Actualizar contenido. Para ver los cambios de esquema, consulte Actualización de un esquema de índice.
Requisitos previos
Un servicio Búsqueda de Azure AI (cualquier nivel). Crear un servicio o finar uno existente.
Índice de búsqueda existente con documentos. En este artículo se da por supuesto que ya ha creado un índice y cargado documentos.
Permisos para actualizar o recompilar índices:
- Autenticación basada en claves: una clave de API de administración para el servicio de búsqueda.
- Autenticación basada en roles: Colaborador de datos del índice de búsqueda para actualizaciones de documentos, o Colaborador del servicio de búsqueda para cambios de esquema.
Para el desarrollo del SDK, instale la biblioteca cliente de Azure Search:
- Python: azure-search-documents
- .NET: Azure. Search.Documents
- JavaScript: @azure/search-documents
- Java: azure-search-documents
Sugerencia
Durante el desarrollo activo, es habitual eliminar y volver a generar índices al iterar sobre el diseño de los mismos. Trabaje con una pequeña muestra representativa de datos para que la reindexación sea más rápida. Para los cambios en el esquema de producción, cree y pruebe un nuevo índice en paralelo, use un alias de índice para intercambiar índices sin cambiar el código de la aplicación.
Actualizar contenido
La indexación incremental y la sincronización de un índice con los cambios en los datos de origen es fundamental para la mayoría de las aplicaciones de búsqueda. En esta sección se explica el flujo de trabajo para agregar, quitar o sobrescribir el contenido de un índice de búsqueda a través de la API REST, pero los SDKs de Azure proporcionan una funcionalidad equivalente.
El cuerpo de la solicitud contiene uno o varios documentos que se van a indexar. Dentro de la solicitud, cada documento del índice es:
- Identificado por una clave única que distingue mayúsculas de minúsculas.
- Asociado a una acción: "upload", "delete", "merge" o "mergeOrUpload".
- Rellenado con un conjunto de pares nombre-valor para cada campo que va a agregar o actualizar.
{
  "value": [
    {
      "@search.action": "upload (default) | merge | mergeOrUpload | delete",
      "key_field_name": "unique_key_of_document", (key/value pair for key field from index schema)
      "field_name": field_value (name/value pairs matching index schema)
        ...
    },
    ...
  ]
}
Reference:Documents - Index
En primer lugar, use las API para cargar documentos, como Documents - Index (REST) o una API equivalente en el SDK de Azure. Para obtener más información sobre las técnicas de indexación, consulte Carga de documentos.
Para una actualización grande, se recomienda el procesamiento por lotes (hasta 1000 documentos por lote, o aproximadamente 16 MB por lote, lo que ocurra primero) y mejora significativamente el rendimiento de la indexación.
Establezca el
@search.actionparámetro en la API para determinar el efecto en los documentos existentes. UsemergeOrUploadpara actualizaciones incrementales (más comunes),deletepara quitar documentos omergepara actualizaciones parciales de campos en documentos existentes.Acción Efecto eliminar Quita todo el documento del índice. Si desea quitar un campo individual, use merge en su lugar, estableciendo el campo en cuestión en null. Los documentos y campos eliminados no liberan espacio inmediatamente en el índice. Cada pocos minutos, un proceso en segundo plano realiza la eliminación física. Tanto si usa el portal de Azure como una API para devolver estadísticas de índice, puede esperar un pequeño retraso antes de que la eliminación se refleje en el portal de Azure y a través de las API. Para obtener más información, vea Eliminar documentos en un índice de búsqueda. fusionar Actualiza un documento que ya existe y falla cuando no puede encontrar un documento. La combinación reemplaza los valores existentes. Por este motivo, asegúrese de comprobar si hay campos de colección que contienen varios valores, como campos de tipo Collection(Edm.String). Por ejemplo, si untagscampo comienza con un valor de["budget"]y ejecuta una combinación con["economy", "pool"], el valor final deltagscampo es["economy", "pool"]. No será["budget", "economy", "pool"].
El mismo comportamiento se aplica a colecciones complejas. Si el documento contiene un campo de colección complejo denominado Rooms con un valor de[{ "Type": "Budget Room", "BaseRate": 75.0 }]y ejecuta una combinación con un valor de[{ "Type": "Standard Room" }, { "Type": "Budget Room", "BaseRate": 60.5 }], el valor final del campo Salas será[{ "Type": "Standard Room" }, { "Type": "Budget Room", "BaseRate": 60.5 }]. No anexará ni combinará valores nuevos y existentes.mergeOrUpload Se comporta como merge si el documento existe, y como upload si el documento es nuevo. Esta es la acción más común para las actualizaciones incrementales. subir Similar a una operación "upsert", donde se inserta el documento si es nuevo, y se actualiza o reemplaza si ya existe. Si faltan valores que requiere el índice, el valor del campo del documento se establece en NULL.
Las consultas continúan ejecutándose durante la indexación, pero si va a actualizar o quitar campos existentes, puede esperar resultados mixtos y una mayor incidencia de limitación.
Nota
No hay garantías de ordenación para las que se ejecuta primero la acción en el cuerpo de la solicitud. No se recomienda tener varias acciones de "combinación" asociadas al mismo documento en un único cuerpo de solicitud. Si hay varias acciones de "combinación" necesarias para el mismo documento, realice la combinación del lado cliente antes de actualizar el documento en el índice de búsqueda.
Respuestas
El código de estado 200 se devuelve para una respuesta correcta, lo que significa que todos los elementos se han almacenado de forma duradera y empezarán a indexarse. La indexación se ejecuta en segundo plano y hace que los nuevos documentos estén disponibles (es decir, consultables y buscables) unos segundos después de que se complete la operación de indexación. El retraso específico depende de la carga del servicio.
La indexación correcta se indica mediante la propiedad status que se establece en true para todos los elementos, así como la statusCode propiedad que se establece en 201 (para documentos recién cargados) o 200 (para documentos combinados o eliminados):
{
  "value": [
    {
      "key": "unique_key_of_new_document",
      "status": true,
      "errorMessage": null,
      "statusCode": 201
    },
    {
      "key": "unique_key_of_merged_document",
      "status": true,
      "errorMessage": null,
      "statusCode": 200
    },
    {
      "key": "unique_key_of_deleted_document",
      "status": true,
      "errorMessage": null,
      "statusCode": 200
    }
  ]
}
El código de estado 207 se devuelve cuando al menos un elemento no se indizara correctamente. Los elementos que no se han indexado tienen el campo de estado establecido en false. Las errorMessage propiedades y statusCode indican el motivo del error de indexación:
{
  "value": [
    {
      "key": "unique_key_of_document_1",
      "status": false,
      "errorMessage": "The search service is too busy to process this document. Please try again later.",
      "statusCode": 503
    },
    {
      "key": "unique_key_of_document_2",
      "status": false,
      "errorMessage": "Document not found.",
      "statusCode": 404
    },
    {
      "key": "unique_key_of_document_3",
      "status": false,
      "errorMessage": "Index is temporarily unavailable because it was updated with the 'allowIndexDowntime' flag set to 'true'. Please try again later.",
      "statusCode": 422
    }
  ]
}
La errorMessage propiedad indica el motivo del error de indexación si es posible.
En la tabla siguiente se explican los distintos códigos de estado por documento que se pueden devolver en la respuesta. Algunos códigos de estado indican problemas con la propia solicitud, mientras que otros indican condiciones de error temporales. Debería volver a intentar esto último después de un retraso.
| Código de estado | Significado | Reintentable | Notas |
|---|---|---|---|
| 200 | El documento fue modificado o eliminado exitosamente. | n/a | Las operaciones de eliminación son idempotentes. Es decir, aunque no exista una clave de documento en el índice, al intentar una operación de eliminación con esa clave se producirá un código de estado 200. |
| 201 | El documento se creó correctamente. | n/a | |
| 400 | Se produjo un error en el documento que impedía que se indizara. | No | El mensaje de error de la respuesta indica lo que está mal con el documento. |
| 404 | No se pudo combinar el documento porque la clave especificada no existe en el índice. | No | Este error no se produce para las cargas, ya que crean nuevos documentos y no se produce para las eliminaciones porque son idempotentes. |
| 409 | Se detectó un conflicto de versión al intentar indexar un documento. | Sí | Esto puede ocurrir cuando intenta indexar el mismo documento más de una vez simultáneamente. |
| 422 | El índice no está disponible temporalmente porque se actualizó con la bandera "allowIndexDowntime" establecida en "true". | Sí | |
| 429 | Demasiadas solicitudes | Sí | Si obtiene este código de error durante la indexación, normalmente significa que tiene poco espacio de almacenamiento. A medida que se acercan a los límites de almacenamiento, el servicio puede especificar un estado en el que no se puede agregar ni actualizar hasta que se eliminen algunos documentos. Para obtener más información, consulte Planear y administrar la capacidad si desea más almacenamiento o liberar espacio mediante la eliminación de documentos. |
| 503 | El servicio de búsqueda no está disponible temporalmente, posiblemente debido a una gran carga. | Sí | En este caso, el código debe esperar antes de reintentar ya que, de lo contrario, se arriesga a prolongar la no disponibilidad del servicio. |
Si el código de cliente encuentra con frecuencia una respuesta 207, una posible razón es que el sistema está bajo carga. Puede confirmarlo verificando que la propiedad statusCode sea 503. Si statusCode es 503, se recomienda limitar las solicitudes de indexación. De lo contrario, si el tráfico de indexación no disminuye, el sistema podría empezar a rechazar todas las solicitudes con errores 503.
El código de estado 429 indica que ha superado la cuota en el número de documentos por índice. Debe hacer una actualización para aumentar los límites de capacidad o crear un nuevo índice.
Nota
Al cargar valores DateTimeOffset con información de zona horaria en el índice, Búsqueda de Azure AI normaliza estos valores a UTC. Por ejemplo, 2024-01-13T14:03:00-08:00 se almacena como 2024-01-13T22:03:00Z. Si necesita almacenar información de zona horaria, agregue una columna adicional al índice para este punto de datos.
Sugerencias para la indexación incremental
Los indexadores automatizan la indexación incremental. Si puede usar un indexador y, si el origen de datos admite el seguimiento de cambios, puede ejecutar el indexador en una programación periódica para agregar, actualizar o sobrescribir contenido que se puede buscar para que se sincronice con los datos externos.
Si realiza llamadas de índice directamente a través de la API de inserción, use
mergeOrUploadcomo acción de búsqueda.La carga debe incluir las claves o identificadores de todos los documentos que desea agregar, actualizar o eliminar.
Si el índice incluye campos vectoriales y establece la
storedpropiedad en false, asegúrese de proporcionar el vector en la actualización parcial del documento, incluso si el valor no cambia. Un efecto secundario de configurarstoreden false es que los vectores se eliminan durante una operación de reindexación. Proporcionar el vector en la carga de documentos impide que esto suceda.Para actualizar el contenido de campos simples y subcampos en tipos complejos, enumere solo los campos que desea cambiar. Por ejemplo, si solo necesita actualizar un campo de descripción, la carga debe constar de la clave del documento y la descripción modificada. Si se omiten otros campos, se conservan sus valores existentes.
Para combinar los cambios insertados en la colección de cadenas, proporciona todo el valor. Recuerde el ejemplo del campo
tagsde la sección anterior. Los nuevos valores sobrescriben los valores antiguos para un campo completo y no hay ninguna combinación dentro del contenido de un campo.
Este es un ejemplo de LA API REST que muestra estas sugerencias:
### Get Stay-Kay City Hotel by ID
GET  {{baseUrl}}/indexes/hotels-vector-quickstart/docs('1')?api-version=2026-04-01  HTTP/1.1
    Content-Type: application/json
    api-key: {{apiKey}}

### Change the description, city, and tags for Stay-Kay City Hotel
POST {{baseUrl}}/indexes/hotels-vector-quickstart/docs/search.index?api-version=2026-04-01  HTTP/1.1
  Content-Type: application/json
  api-key: {{apiKey}}

    {
        "value": [
            {
            "@search.action": "mergeOrUpload",
            "HotelId": "1",
            "Description": "I'm overwriting the description for Stay-Kay City Hotel.",
            "Tags": ["my old item", "my new item"],
            "Address": {
                "City": "Gotham City"
                }
            }
        ]
    }

### Retrieve the same document, confirm the overwrites and retention of all other values
GET  {{baseUrl}}/indexes/hotels-vector-quickstart/docs('1')?api-version=2026-04-01  HTTP/1.1
    Content-Type: application/json
    api-key: {{apiKey}}
Reference:Documents - Index, Lookup Document
Ejemplos del SDK
En los ejemplos siguientes se muestra cómo actualizar documentos mediante el SDK de Azure.
from azure.core.credentials import AzureKeyCredential
from azure.search.documents import SearchClient

# Set up the client
service_name = "<your-search-service-name>"
index_name = "hotels-sample"
api_key = "<your-admin-api-key>"

endpoint = f"https://{service_name}.search.windows.net"
credential = AzureKeyCredential(api_key)
client = SearchClient(endpoint=endpoint, index_name=index_name, credential=credential)

# Update documents using merge_or_upload
documents = [
    {
        "HotelId": "1",
        "Description": "Updated description for the hotel.",
        "Tags": ["updated", "renovated"]
    }
]

result = client.merge_or_upload_documents(documents=documents)
print(f"Updated {len(result)} document(s)")
Referencia:SearchClient, merge_or_upload_documents
Actualización de un esquema de índice
El esquema de índice define las estructuras de datos físicas creadas en el servicio de búsqueda, por lo que no hay muchos cambios de esquema que puede realizar sin incurrir en una recompilación completa.
Actualizaciones sin recompilación
En la lista siguiente se enumeran los cambios de esquema que se pueden introducir sin problemas en un índice existente. Por lo general, la lista incluye nuevos campos y funcionalidades que se usan durante la ejecución de la consulta.
- Adición de una descripción del índice
- Agregar un nuevo campo
- Establecer el
retrievableatributo en un campo existente - Actualizar
searchAnalyzeren un campo que ya tiene unindexAnalyzerexistente - Agregar una nueva definición de analizador en un índice (que se puede aplicar a nuevos campos)
- Agregar, actualizar o eliminar perfiles de puntuación
- Agregar, actualizar o eliminar mapas de sinónimos
- Agregar, actualizar o eliminar configuraciones semánticas
- Agregar, actualizar o eliminar la configuración de CORS
El orden de las operaciones es:
Revisar el esquema con actualizaciones de la lista anterior.
Actualice el esquema de índice en el servicio de búsqueda.
Actualice el contenido del índice para que coincida con el esquema revisado si ha agregado un nuevo campo. Para todos los demás cambios, se usa el contenido indizado existente as-is.
Al actualizar un esquema de índice para incluir un nuevo campo, los documentos existentes del índice reciben un valor NULL para ese campo. En el siguiente trabajo de indexación, los valores de los datos de origen externo reemplazan los valores NULL agregados por Búsqueda de Azure AI.
No debe haber interrupciones en las consultas durante las actualizaciones, pero los resultados de la consulta variarán a medida que las actualizaciones surtan efecto.
Actualizaciones que requieren una recompilación
Algunas modificaciones requieren una eliminación y recompilación de índices, reemplazando un índice actual por uno nuevo.
| Acción | Descripción |
|---|---|
| Eliminar un campo | Para quitar físicamente todos los rastros de un campo, tendrá que recompilar el índice. Cuando una recompilación inmediata no es práctica, puede modificar el código de aplicación para redirigir el acceso fuera de un campo obsoleto o usar searchFields y seleccionar parámetros de consulta para elegir qué campos se buscan y devuelven. Físicamente, la definición de campo y el contenido permanecen en el índice hasta la siguiente recompilación, cuando se aplica un esquema que omite el campo en cuestión. |
| Cambiar una definición de campo | Las revisiones a un nombre de campo, un tipo de datos o atributos de índice específicos (que se pueden buscar, filtrar, ordenar, facetable) requieren una recompilación completa. |
| Asignación de un analizador a un campo | Los analizadores se definen en un índice, se asignan a campos y, a continuación, se invocan durante la indexación para informar sobre cómo se crean los tokens. Puede agregar una nueva definición de analizador a un índice en cualquier momento, pero solo puede asignar un analizador cuando se crea el campo. Esto se aplica tanto a las propiedades analyzer como indexAnalyzer . La propiedad searchAnalyzer es una excepción (puede asignar esta propiedad a un campo existente). |
| Actualizar o eliminar una definición de analizador en un índice | No puede eliminar ni cambiar una configuración de analizador existente (analizador, tokenizador, filtro de tokens o filtro char) en el índice a menos que vuelva a generar todo el índice. |
| Agregar un campo a un sugeridor | Si ya existe un campo y desea agregarlo a una construcción Suggesters , vuelva a generar el índice. |
| Actualización del servicio o nivel | Si necesita más capacidad, compruebe si puede actualizar el servicio o cambiar a un plan de tarifa superior. Si no es así, debe crear un nuevo servicio y recompilar los índices desde cero. Para ayudar a automatizar este proceso, puede usar un ejemplo de código que realiza una copia de seguridad del índice en una serie de archivos JSON. A continuación, puede volver a crear el índice en un servicio de búsqueda que especifique. |
El orden de las operaciones es:
Obtenga una definición de índice en caso de que la necesite para una referencia futura o para usarla como base para una nueva versión.
Considere la posibilidad de usar una solución de copia de seguridad y restauración para conservar una copia del contenido del índice. Hay soluciones en C# y en Python. Se recomienda la versión de Python porque está más actualizada.
Si tiene capacidad en el servicio de búsqueda, mantenga el índice existente al crear y probar el nuevo.
Elimine el índice existente. Las consultas destinadas al índice se descartan inmediatamente. Recuerde que eliminar un índice es irreversible, lo que destruye el almacenamiento físico de la colección de campos y otras construcciones.
Publique un índice revisado, donde el cuerpo de la solicitud incluye definiciones de campo cambiadas o configuraciones modificadas.
Cargue el índice con documentos de un origen externo. Los documentos se indexan mediante las definiciones de campo y las configuraciones del nuevo esquema.
Al crear el índice, se asigna almacenamiento físico para cada campo del esquema de índice, con un índice invertido creado para cada campo que se puede buscar y un índice vectorial creado para cada campo vectorial. Los campos que no se pueden buscar se pueden usar en filtros o expresiones, pero no tienen índices invertidos y no son de texto completo o de búsqueda aproximada. En una recompilación de índices, estos índices invertidos e índices vectoriales se eliminan y se vuelven a crear en función del esquema de índice que proporcione.
Para minimizar la interrupción del código de la aplicación, considere la posibilidad de crear un alias de índice. El código de aplicación hace referencia al alias, pero puede actualizar el nombre del índice al que apunta el alias.
Adición de una descripción del índice
Un índice tiene una description propiedad que puede especificar y usar cuando un sistema debe tener acceso a varios índices y tomar una decisión basada en la descripción. Considere un servidor de Protocolo de contexto de modelo (MCP) que debe elegir el índice correcto en tiempo de ejecución. La decisión puede basarse en la descripción en lugar de en el nombre del índice solo.
Una descripción de índice es una actualización de esquema y puede agregarla sin tener que recompilar todo el índice.
- La longitud de cadena es de 4000 caracteres como máximo.
- El contenido debe ser legible para personas, en Unicode. El caso de uso debe determinar qué idioma se va a usar.
Puede agregar una descripción de índice a través del portal de Azure, la API REST estable más reciente o un paquete de SDK de Azure que proporcione la característica.
El portal de Azure admite la API de versión preliminar más reciente.
Vaya al servicio de búsqueda en el portal Azure.
En Administración de búsqueda>Índices, seleccione un índice.
Seleccione Editar JSON.
Inserte
"description", seguido de la descripción. El valor debe tener menos de 4000 caracteres y en Unicode.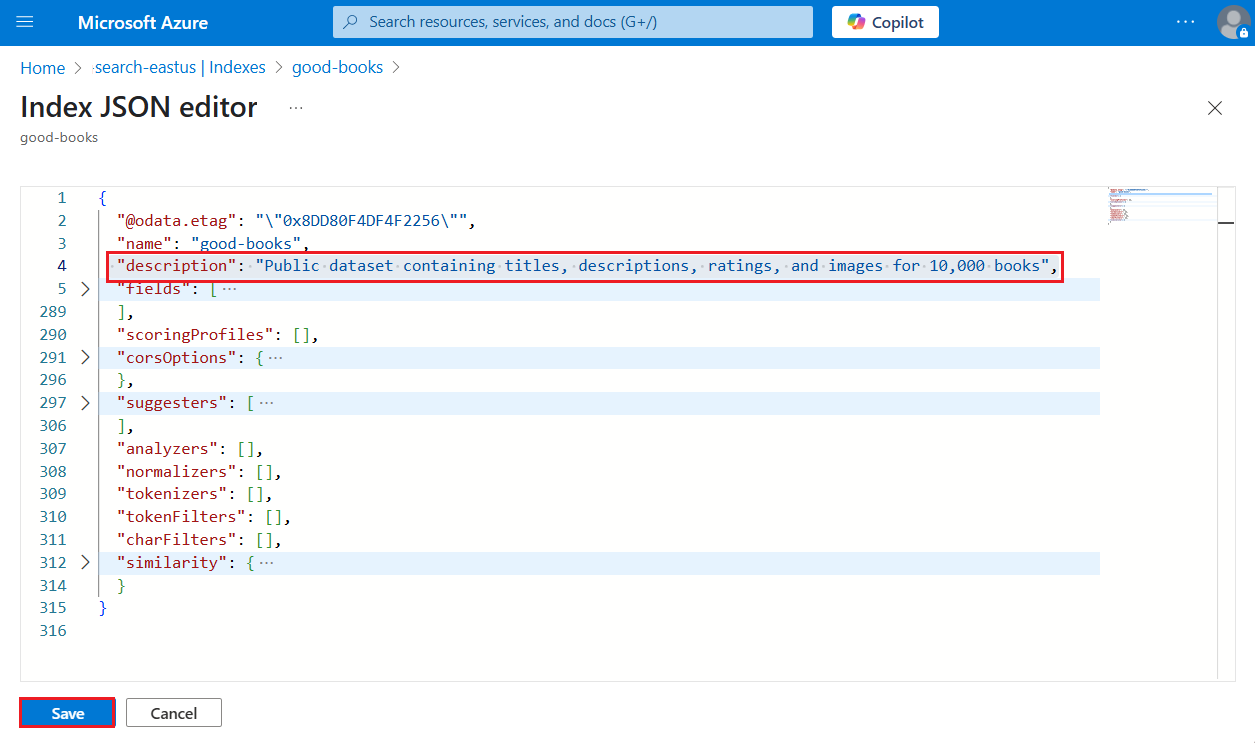
Guarde el índice.
Equilibrio de cargas de trabajo
La indexación no se ejecuta en segundo plano, pero el servicio de búsqueda equilibrará los trabajos de indexación en las consultas en curso. Durante la indexación, puede monitor query requests en el portal de Azure para asegurarse de que las consultas se completan de forma oportuna.
Si las cargas de trabajo de indexación presentan niveles inaceptables de latencia de consulta, realice el análisis de rendimiento y revise estas sugerencias de rendimiento para la posible mitigación.
Buscar actualizaciones
Puede empezar a consultar un índice tan pronto como se cargue el primer documento. Si conoce el identificador de un documento, la API REST buscar documento devuelve el documento específico. Para realizar pruebas más amplias, debe esperar hasta que el índice esté totalmente cargado y, a continuación, usar consultas para comprobar el contexto que espera ver.
Puede usar el Explorador de búsqueda o un cliente REST para comprobar si hay contenido actualizado.
Si ha agregado o cambiado el nombre de un campo, use select para devolver ese campo:
"search": "*",
"select": "document-id, my-new-field, some-old-field",
"count": true
El portal de Azure proporciona el tamaño del índice y el tamaño del índice vectorial. Puede comprobar estos valores después de actualizar un índice, pero recuerde esperar un pequeño retraso a medida que el servicio procesa el cambio y para tener en cuenta las tarifas de actualización del portal, lo que puede ser de unos minutos.
Solución de problemas de reindexación
En la tabla siguiente se enumeran los problemas comunes al actualizar o volver a generar índices y a resolverlos.
| Problema | Causa | Resolución |
|---|---|---|
| Respuesta 207 con resultados mixtos | Algunos documentos tuvieron éxito, otros fallaron. | Compruebe statusCode para cada documento en respuesta. Si es 503, limite las solicitudes y vuelva a intentarlo. |
| Conflicto de versión 409 | Actualizaciones simultáneas en el mismo documento. | Serialice las actualizaciones en el mismo documento o implemente el reintento con retroceso exponencial. |
| 429 Demasiadas solicitudes | La cuota de almacenamiento superada o demasiadas solicitudes simultáneas. | Elimine documentos para liberar espacio o actualice el nivel de servicio para obtener más capacidad. |
| 503 Servicio no disponible | Servicio bajo carga pesada. | Espere y vuelva a intentarlo con retroceso exponencial. Considere la posibilidad de reducir el tamaño del lote. |
| Recuento de documentos sin cambios después de eliminar | La eliminación es asincrónica. | Espere entre 2 y 3 minutos para que el proceso en segundo plano complete la eliminación física. |
| El nuevo campo devuelve null | Campo agregado al esquema, pero los documentos no se vuelven a indexar. | Ejecute el indexador o inserte documentos actualizados para rellenar el nuevo campo. |
| Cambio de esquema rechazado | Se ha intentado un cambio incompatible (cambiar nombre, cambiar tipo). | Quite y vuelva a generar el índice. Use el alias de índice para minimizar el tiempo de inactividad. |
Consulte también
- Introducción al indexador
- Eliminar documentos de un índice de búsqueda
- Indexar conjuntos de datos grandes a escala
- Indexing en el portal de Azure
- Azure SQL Database indexador
- Azure Cosmos DB para el indexador de NoSQL
- Azure indexador de blobs
- indexador de tablas Azure
- Datos, privacidad y protecciones integradas