Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Hinweis
Foundry IQ (Azure KI-Suche) bietet direkte Indizierungs- und Abfrage-APIs zusammen mit Wissensquellen- und Knowledge Base-APIs auf höherer Ebene für den verwalteten Abruf. Verwenden Sie das Azure Portal, REST-APIs oder Azure SDKs, um diese Funktionen zu konfigurieren, oder verbinden Sie Agents mit Wissensdatenbanken im Microsoft Foundry-Portal.
In Foundry IQ (Azure KI-Suche) können Sie einen Indexer auf verschiedene Arten ausführen:
- Sofort nach der Indexerstellung ausführen. Diese Option ist die Standardeinstellung, es sei denn, Sie erstellen den Indexer in einem deaktivierten Zustand.
- Führen Sie einen Zeitplan aus, um die Ausführung in regelmäßigen Abständen aufzurufen. Wenn ein geplanter Indexer nicht mehr ausgelöst wird, finden Sie unter FAQ zum Planungsverhalten Schritte zur Wiederherstellung.
- Bei Bedarf mit oder ohne Reset ausführen.
Dieser Artikel erläutert das Ausführen von Indexern bei Bedarf, mit und ohne Zurücksetzen. Außerdem werden die Ausführung des Indexierers, die Dauer und die Parallelität beschrieben.
Herstellen einer Verbindung zwischen Indexern und Azure Ressourcen
Indexer sind eines der wenigen Subsysteme, die ausgehende Anrufe an andere Azure Ressourcen tätigen. Abhängig von der externen Datenquelle können Sie Schlüssel oder Rollen verwenden, um die Verbindung zu authentifizieren.
In Bezug auf Azure Rollen haben Indexer keine separaten Identitäten: Eine Verbindung von der Suchmaschine zu einer anderen Azure Ressource verwendet das System oder die vom Benutzer zugewiesene verwaltete Identität eines Foundry IQ-Diensts sowie eine Rollenzuweisung für das Ziel Azure Ressource. Verwaltete Identität authentifiziert die Verbindung; der Netzwerkpfad wird nicht isoliert. Überprüfen Sie bei einem netzwerkgeschützten Ziel die Berechtigung für freigegebene private Links und die unterstützten Zugriffsoptionen des Ziels. S3 HD und Serverless unterstützen keine ausgehenden freigegebenen privaten Links.
Hinweis
Indexer arbeiten mit Berechtigungen auf Dienstebene und nicht mit Benutzerberechtigungen. Ein Indexer kann in einen beliebigen Index für den Foundry IQ-Dienst schreiben, auch wenn Sie Rollen zugewiesen haben, um den Zugriff auf bestimmte Indizes einzuschränken. Weitere Informationen finden Sie unter "Scope und Indexeroperationen pro Index".
Ausführung des Indexers
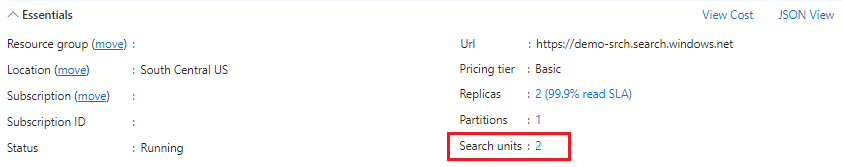
Für private Ausführung auf berechtigten dedizierten Diensten führt ein Foundry IQ-Dienst einen Indexerauftrag pro Sucheinheit aus. Jede neue Partition oder jedes Replikat erhöht die Sucheinheiten Ihres Diensts. Sie können die Anzahl der Sucheinheiten im Abschnitt "Essential" des Azure Portals auf der Seite Overview überprüfen. Indexer teilen sich Dienstressourcen, sodass sie möglicherweise mehr Abfragedrosselung als üblich erleben, wenn der Dienst unter Druck steht.
S3 HD- und Serverless-Indexer werden nur in der Multitenant-Umgebung ausgeführt. Sie teilen 48 kumulierte Laufzeitstunden pro Dienst in jedem 24-Stunden-UTC-Fenster mit einem separaten Grenzwert von zwei Stunden pro Laufzeit. Die Parallelität der Sucheinheit ist nicht deren Kapazitätsmodell. Siehe Indexerausführung auf Serverless und S3 HD und Kumulative Laufzeit überwachen.
Der folgende Screenshot zeigt die Anzahl der Sucheinheiten, die für die private Ausführungsparallelität auf berechtigten dedizierten Diensten verwendet werden.
Nachdem die Indizierungsausführung gestartet wurde, können Sie sie nicht anhalten oder beenden. Die Indizierungsausführung wird beendet, wenn keine Dokumente geladen oder aktualisiert werden müssen, oder wenn die maximale Laufzeitgrenze erreicht ist.
Sie können mehrere Indexer gleichzeitig ausführen, wobei ausreichend Kapazität vorausgesetzt wird, aber jeder Indexer selbst ist eine Einzelinstanz. Das Starten einer neuen Instanz, während der Indexer bereits ausgeführt wird, führt zu diesem Fehler: "Failed to run indexer "<indexer name>" error: "Another indexer invocation is currently in progress; concurrent invocations are not allowed."
Indexerausführungsumgebung
Ein Indexerauftrag wird in einer verwalteten Ausführungsumgebung ausgeführt. Derzeit gibt es zwei Umgebungen:
Eine private Ausführungsumgebung wird auf Suchclustern ausgeführt, die für Ihren Foundry IQ-Dienst spezifisch sind.
Eine mehrinstanzenfähige Umgebung verfügt über Inhaltsprozessoren, die Microsoft verwaltet und sichert. In dieser Umgebung werden rechenintensive Verarbeitungen ausgelagert, sodass dienstspezifische Ressourcen für Routinevorgänge verfügbar bleiben. Die meisten Skillsets werden nach Möglichkeit in der Mehrinstanzenumgebung ausgeführt. Diese Umgebung ist die Standardeinstellung. Bei berechtigten kostenpflichtigen Serverless-Diensten fällt Compute Unit-Nutzung für die Indexerausführung an; die gemeinsame Ausführung verursacht diese Gebühr bei dedizierten oder kostenlosen Diensten nicht.
Rechenintensive Verarbeitung bezieht sich auf Skillsets, die auf Inhaltsprozessoren und Indexeraufträgen ausgeführt werden, die eine große Menge von Dokumenten oder Dokumenten einer großen Größe verarbeiten. Heuristiken und Systeminformationen bestimmen die Verarbeitung ohne spezifische Fähigkeiten auf den mehrmandantenfähigen Inhaltsverarbeitern, was nicht der Kontrolle des Kunden unterliegt.
Sie können die Verwendung der mehrinstanzenfähigen Umgebung für berechtigte Standard2- oder höhere dedizierte Dienste, mit Ausnahme von S3 HD, verhindern, indem Sie eine Indexer- und Skillset-Verarbeitung ausschließlich an Ihre Suchcluster anheften.
Legen Sie den executionEnvironment Parameter in der Indexerdefinition fest, um immer einen Indexer in der privaten Ausführungsumgebung auszuführen.
IP-Firewalls blockieren die Multitenant-Umgebung. Wenn Sie also über eine Firewall verfügen, erstellen Sie eine Regel, die Verbindungen zum Multitenant-Prozessor zulässt.
Die Indizierungsgrenzwerte variieren für jede Umgebung:
| Arbeitsauslastung | Maximale Dauer | Maximale Anzahl von Aufträgen | Ausführungsumgebung |
|---|---|---|---|
| Private Ausführung | 24 Stunden | Ein Indexerauftrag pro Sucheinheit1. | Die Indizierung wird nicht im Hintergrund ausgeführt. Stattdessen gleicht der Foundry IQ-Dienst alle Indizierungsaufträge mit laufenden Abfragen und Objektverwaltungsaktionen (z. B. Erstellen oder Aktualisieren von Indizes) ab. Beim Ausführen von Indexern mit großem Indizierungsvolumen muss mit einer gewissen Wartezeit bei Abfragen gerechnet werden. |
| Multitenant | 2 Stunden 2 | Unbestimmt 3 | Da der Inhaltsverarbeitungscluster multitenant ist, fügt das System Inhaltsprozessoren hinzu, um die Nachfrage zu erfüllen. Wenn bei Bedarf oder geplanter Ausführung eine Verzögerung auftritt, liegt es wahrscheinlich daran, dass das System entweder Prozessoren hinzufügt oder darauf wartet, dass ein Prozessor verfügbar wird. |
1 Sucheinheiten können flexible Kombinationen aus Partitionen und Replikaten sein, aber Indexeraufträge sind weder an das eine noch an das andere gebunden. Anders ausgedrückt: Wenn Sie über 12 Einheiten verfügen, können Sie 12 Indexeraufträge gleichzeitig in privater Ausführung ausführen, unabhängig davon, wie die Sucheinheiten bereitgestellt werden.
2 Wenn mehr als zwei Stunden erforderlich sind, um alle Daten zu verarbeiten, aktivieren Sie die Änderungserkennung , und planen Sie die Ausführung des Indexers in 5-Minuten-Intervallen, um die Indizierung schnell fortzusetzen, wenn sie aufgrund eines Timeouts beendet wird. Weitere Strategien finden Sie unter "Indizieren eines großen Datasets ".
3 "Unbestimmt" bedeutet, dass der Grenzwert nicht durch die Anzahl der Jobs quantifiziert wird. Einige Workloads, z. B. die Verarbeitung von Skillset, können parallel ausgeführt werden, was zu vielen Aufträgen führen kann, obwohl nur ein Indexer beteiligt ist. Obwohl die Umgebung keine Einschränkungen erzwingt, gelten die Indexergrenzwerte für Ihren Foundry IQ-Dienst weiterhin.
Ausführen ohne Zurücksetzen
Ein Run Indexer-Vorgang erkennt und verarbeitet nur das, was er zum Synchronisieren des Suchindex mit Änderungen in der zugrunde liegenden Datenquelle benötigt. Die inkrementelle Indizierung beginnt damit, eine interne High-Water-Marke zu ermitteln, um das zuletzt aktualisierte Suchdokument zu finden. Dieses Dokument wird zum Ausgangspunkt für die Ausführung des Indexers für neue und aktualisierte Dokumente in der Datenquelle.
Die Änderungserkennung ist unerlässlich, um festzustellen, was in der Datenquelle neu ist oder aktualisiert wurde. Indexer verwenden die Änderungserkennungsfunktionen der zugrunde liegenden Datenquelle, um zu bestimmen, was in der Datenquelle neu oder aktualisiert wird.
Azure Storage verfügt über die integrierte Änderungserkennung über die LastModified-Eigenschaft.
Andere Datenquellen, z. B. Azure SQL oder Azure Cosmos DB, erfordern eine Konfiguration für die Änderungserkennung, bevor der Indexer neue und aktualisierte Zeilen lesen kann.
Wenn der zugrunde liegende Inhalt unverändert ist, hat ein Ausführungsvorgang keine Auswirkung. In diesem Fall gibt der Indexerausführungsverlauf dokumente 0\0 an, die verarbeitet wurden.
Um alle Dokumente erneut zu verarbeiten, müssen Sie den Indexer zurücksetzen.
Zurücksetzen von Indexern
Nach der ersten Ausführung verfolgt ein Indexer, welche Suchdokumente über einen internen Schwellenwert indiziert werden. Die Markierung ist nicht zugänglich, aber intern weiß der Indexer, wo er zuletzt aufgehört hat.
Um den gesamten oder einen Teil eines Indexes neu zu erstellen, verwenden Sie reset-APIs, die auf niedrigeren Ebenen in der Objekthierarchie verfügbar sind:
- Das Zurücksetzen von Indexern löscht die Höchstmarke und führt eine vollständige Neuindizierung aller Dokumente durch.
- Resync Indexers aktualisiert Berechtigungsfelder ohne erneute Verarbeitung von Dokumentinhalten.
- Dokumente zurücksetzen (Vorschau) reindiziert ein bestimmtes Dokument oder eine Liste von Dokumenten.
- Reset Skills (Vorschau) ruft die Skillverarbeitung für einen bestimmten Skill auf.
Folgen Sie nach dem Zurücksetzen dem Befehl "Ausführen", um neue und vorhandene Dokumente erneut zu verarbeiten. Sie können verwaiste Suchdokumente, die kein Gegenstück in der Datenquelle haben, nicht durch Zurücksetzen und erneutes Ausführen entfernen. Informationen zum Löschen bestimmter Dokumente finden Sie unter "Löschen von Dokumenten in einem Suchindex " oder " Dokumente – Index".
Hinweis
Tabellen können nicht leer sein. Wenn Sie mit TRUNCATE TABLE Zeilen löschen, werden die zugehörigen Suchdokumente durch ein Zurücksetzen und erneutes Ausführen des Indexers nicht entfernt. Um verwaiste Suchdokumente zu entfernen, müssen Sie sie mit einer Löschaktion indizieren.
Wie man Indexer zurücksetzt und ausführt
Zurücksetzen löscht den Höchstwert. Alle Dokumente im Suchindex werden zur vollständigen Überschreibung gekennzeichnet, ohne Inline-Aktualisierungen oder Zusammenführung in vorhandene Inhalte. Bei Indexern mit einem Skillset und einer Anreicherungszwischenspeicherung (Vorschau) wird durch das Zurücksetzen des Index auch das Skillset implizit zurückgesetzt.
Die eigentliche Arbeit beginnt erst, wenn Sie nach dem Zurücksetzen einen Ausführungsbefehl ausführen:
- Alle neuen Dokumente, die die zugrunde liegende Quelle gefunden haben, werden dem Suchindex hinzugefügt.
- Alle Dokumente, die sowohl in der Datenquelle als auch im Suchindex vorhanden sind, werden im Suchindex überschrieben.
- Alle aus Skillsets erstellten erweiterten Inhalte werden neu erstellt. Der Anreicherungscache( sofern aktiviert) wird aktualisiert.
Wie bereits erwähnt, ist das Zurücksetzen ein passiver Vorgang: Sie müssen einer Run-Anforderung folgen, um den Index neu zu erstellen.
Zurücksetzungs-/Ausführungsvorgänge gelten für einen Suchindex oder einen Wissensspeicher, für bestimmte Dokumente oder Projektionen und für zwischengespeicherte Anreicherungen, wenn eine Zurücksetzung explizit oder implizit Skills enthält.
Das Zurücksetzen gilt auch für Erstellungs- und Aktualisierungsvorgänge. Das Löschen oder Bereinigen verwaister Dokumente im Suchindex wird nicht ausgelöst. Weitere Informationen zum Löschen von Dokumenten finden Sie unter "Dokumente – Index".
Das Zurücksetzen kann nicht rückgängig gemacht werden.
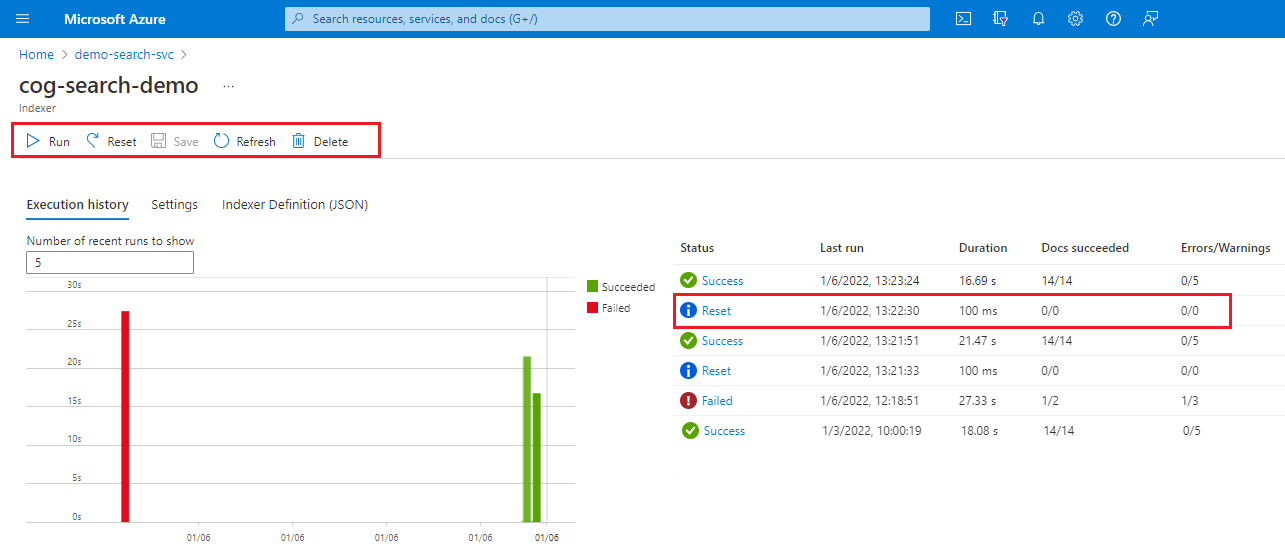
Wechseln Sie im Azure Portal zu Ihrem Foundry IQ Service.
Wählen Sie auf der Seite "Übersicht " die Registerkarte " Indexer" aus .
Wählen Sie einen Indexer aus.
Wählen Sie den Befehl 'Zurücksetzen' und dann 'Ja ' aus, um die Aktion zu bestätigen.
Aktualisieren Sie die Seite, um den Status anzuzeigen. Sie können das Element auswählen, um seine Details anzuzeigen.
Wählen Sie "Ausführen" aus, um die Indizierungsverarbeitung zu starten, oder warten Sie auf die nächste geplante Ausführung.
So setzen Sie Kompetenzen zurück (Vorschau)
Die Anforderung zum Zurücksetzen von Skills bewirkt, dass beim nächsten Indexerdurchlauf gezielt ein oder mehrere Skills verarbeitet werden. Für Indexer, die über Skillsets verfügen, können Sie individuelle Skills zurücksetzen, um die Verarbeitung dieses und aller nachgelagerten Skills zu erzwingen, die von der Ausgabe abhängen. Wenn Sie den Anreicherungscache aktiviert haben, wird er durch die Anfrage ebenfalls aktualisiert.
Für Indexer, die das Zwischenspeichern aktiviert haben, können Sie explizit die Verarbeitung für Qualifikationsupdates anfordern, die der Indexer nicht erkennen kann. Wenn Sie beispielsweise externe Änderungen vornehmen, z. B. Überarbeitungen an einer benutzerdefinierten Fähigkeit, verwenden Sie diese API, um die Fähigkeit erneut auszuführen. Der Prozess aktualisiert Ausgaben, z. B. einen Wissensspeicher oder Suchindex, indem wiederverwendbare Daten aus dem Cache und neue Inhalte pro aktualisierter Fähigkeit verwendet werden.
Verwenden Sie die neueste Vorschau-API.
POST /skillsets/[skillset name]/resetskills?api-version=2026-11-01-preview
{
    "skillNames" : [
        "#1",
        "#5",
        "#6"
    ]
}
Sie können einzelne Fähigkeiten angeben, wie im vorherigen Beispiel gezeigt, aber wenn eines dieser Fähigkeiten ausgaben von nicht aufgelisteten Fähigkeiten (#2 bis #4) erfordert, führt der Prozess nicht aufgelistete Fähigkeiten aus, es sei denn, der Cache kann die erforderlichen Informationen bereitstellen. Damit diese Bedingung erfüllt ist, dürfen zwischengespeicherte Anreicherungen für Skills #2 bis #4 nicht von #1 abhängen (zum Zurücksetzen aufgeführt).
Wenn Sie keine Fähigkeiten angeben, führt der Prozess das gesamte Skillset aus und aktualisiert, wenn die Zwischenspeicherung aktiviert ist, auch den Cache.
Denken Sie daran, die Nachverfolgung mit Run Indexer durchzuführen, um die tatsächliche Verarbeitung aufzurufen.
Dokumente zurücksetzen (Vorschau)
Die Indexer - Reset Docs (Preview) -API akzeptiert eine Liste von Dokumentschlüsseln, damit Sie bestimmte Dokumente aktualisieren können. Wenn Sie die Zurücksetzungsparameter angeben, bestimmen sie nur, was verarbeitet wird, unabhängig von anderen Änderungen in den zugrunde liegenden Daten. Wenn beispielsweise 20 Blobs seit der letzten Indizierungsausführung hinzugefügt oder aktualisiert wurden, Sie jedoch nur ein Dokument zurücksetzen, verarbeitet der Indexer nur dieses Dokument.
Auf Dokumentbasis aktualisiert der Indexer alle Felder im Suchdokument mit Werten und Metadaten aus der Datenquelle. Sie können nicht auswählen, welche Felder aktualisiert werden sollen.
Wenn die Datenquelle Azure Data Lake Storage (ADLS) Gen2 ist und die Blobs Berechtigungsmetadaten zugeordnet sind, erfasst der Indexer diese Berechtigungen im Suchindex erneut, wenn sich Berechtigungen in den zugrunde liegenden Daten ändern. Weitere Informationen finden Sie unter Erneutes Indizieren von ACL- und RBAC-Bereich mit ADLS Gen2-Indexern.
Wenn Sie das Dokument durch ein Skillset erweitern und über zwischengespeicherte Daten verfügen, ruft der Indexer das Skillset für nur die angegebenen Dokumente auf und aktualisiert den Cache für die neu verarbeiteten Dokumente.
Wenn Sie diese API zum ersten Mal testen, können Sie die folgenden APIs beim Überprüfen und Testen der Verhaltensweisen unterstützen. Verwenden Sie die neueste Vorschau-API.
Rufen Sie Indexer – Status abrufen mit einer Vorschau-API-Version auf, um den Reset-Status und den Ausführungsstatus zu überprüfen. Informationen zur Zurücksetzungsanforderung finden Sie am Ende der Statusantwort.
Rufen Sie Indexers - Docs zurücksetzen mit einer Vorschau-API-Version auf, um die zu verarbeitenden Dokumente festzulegen.
POST https://[service name].search.windows.net/indexers/[indexer name]/resetdocs?api-version=2026-11-01-preview
{
    "documentKeys" : [
        "1001",
        "4452"
    ]
}
Die API akzeptiert zwei Arten von Dokumentbezeichnern als Eingabe: Dokumentschlüssel, die Dokumente in einem Suchindex eindeutig identifizieren, sowie Dokumentbezeichner für Datenquellen, die Dokumente in einer Datenquelle eindeutig identifizieren. Der Textkörper sollte entweder eine Liste von Dokumentschlüsseln oder eine Liste von Datenquellendokumentbezeichnern enthalten, nach denen der Indexer in der Datenquelle sucht. Durch Aufrufen der API werden die Dokumentschlüssel oder Datenquellendokumentbezeichner hinzugefügt, um sie auf die Indizierermetadaten zurückzusetzen. Bei der nächsten geplanten oder bei Bedarf erfolgenden Ausführung des Indexers verarbeitet der Indexer nur noch die zurückgesetzten Dokumente.
Wenn Sie Dokumentschlüssel zum Zurücksetzen von Dokumenten verwenden und auf Ihre Dokumentschlüssel in einer Indexerfeldzuordnung verwiesen wird, verwendet der Indexer die Feldzuordnung, um das entsprechende Feld in der zugrunde liegenden Datenquelle zu finden.
Die dokumentschlüssel, die Sie in der Anforderung angeben, sind Werte aus dem Suchindex, die sich von den entsprechenden Feldern in der Datenquelle unterscheiden können. Wenn Sie sich nicht sicher sind, ob der Schlüsselwert vorhanden ist, senden Sie eine Abfrage , um den Wert zurückzugeben. Sie können
selectverwenden, um nur das Dokumentschlüsselfeld zurückzugeben.Für Blobs, die der Indizierer in mehrere Suchdokumente parst (wobei
parsingModeauf jsonLines oder jsonArrays oder delimitedText festgelegt ist), generiert der Indizierer den Dokumentschlüssel, und dieser ist Ihnen möglicherweise nicht bekannt. In diesem Szenario gibt eine Abfrage für den Dokumentschlüssel den richtigen Wert zurück.Wenn der Indexer nicht mehr versuchen soll, Reset-Dokumente zu verarbeiten, setzen Sie
"documentKeys"oder"datasourceDocumentIds"auf eine leere Liste[]. Diese Aktion führt dazu, dass der Indexer die reguläre Indizierung basierend auf dem Wasserzeichen fortsetzen kann. Ungültige Dokumentschlüssel oder Dokumentschlüssel, die nicht vorhanden sind, werden ignoriert.
Rufen Sie "Run Indexer " (beliebige API-Version) auf, um die von Ihnen angegebenen Dokumente zu verarbeiten. Der Indexer indiziert nur die spezifischen Dokumente.
Rufen Sie "Run Indexer" ein zweites Mal auf, um die Verarbeitung ab dem letzten Stand fortzusetzen.
Rufen Sie "Dokumente durchsuchen" auf, um nach aktualisierten Werten zu suchen und um Dokumentschlüssel zurückzugeben, wenn Sie sich nicht sicher über den Wert sind. Verwenden Sie
"select": "<field names>", um einzuschränken, welche Felder in der Antwort angezeigt werden.
Überschreiben Sie die Liste der Dokumentschlüssel
Wenn Sie die API zum Zurücksetzen von Dokumenten mehrmals mit unterschiedlichen Schlüsseln aufrufen, werden die neuen Schlüssel zur Liste der Zurücksetzungsschlüssel hinzugefügt. Wenn Sie die API aufrufen, wobei der overwrite Parameter auf "true" festgelegt ist, wird die aktuelle Liste durch das neue ersetzt:
POST https://[service name].search.windows.net/indexers/[indexer name]/resetdocs?api-version=2026-11-01-preview
{
    "documentKeys" : [
        "200",
        "630"
    ],
    "overwrite": true
}
Erneute Synchronisierung von Indexern
Resync Indexers unterstützt die Nur-Berechtigungen-Neusynchronisierung in der REST-API 2026-10-01. Das folgende Verfahren gilt für die ADLS Gen2-Berechtigungsaufnahme. Überprüfen Sie für andere Quellen die quellspezifischen Support- und Aktualisierungsanforderungen.
Ein Indexer wird als mit seiner Datenquelle synchronisiert, wenn bestimmte Felder aller Dokumente im Zielindex mit den Daten in der Datenquelle konsistent sind. In der Regel erreicht ein Indexer die Synchronisierung nach einer erfolgreichen ersten Ausführung. Wenn Sie ein Dokument aus der Datenquelle löschen, bleibt der Indexer gemäß dieser Definition synchronisiert. Während der nächsten Indizierung wird das entsprechende Dokument im Zielindex jedoch entfernt, wenn die Löschnachverfolgung aktiviert ist.
Wenn Sie ein Dokument in der Datenquelle ändern, wird der Indexer nicht synchronisiert. Im Allgemeinen synchronisieren Änderungsverfolgungsmechanismen den Indexer bei der nächsten Ausführung neu. In Azure Storage wird beispielsweise beim Ändern eines Blobs dessen letzte Änderungszeit aktualisiert, sodass der Indexer es beim nächsten Indexerlauf neu indizieren kann, weil die aktualisierte Zeit die von der vorherigen Ausführung festgelegte Höchstmarke überschreitet.
Wenn Sie die ACL einer ADLS Gen2-Datei oder eines Verzeichnisses ändern, ändert sich die Uhrzeit der letzten Änderung der Datei nicht.
refreshAllAcls ist standardmäßig aktiviert und behandelt diese Änderungen bei geeigneten regulären Ausführungen ungefähr täglich, nicht bei jeder geplanten Ausführung. Informationen zu den Auswirkungen auf den Bereich, die Häufigkeit und die Folgen des Opt-outs finden Sie unter „Automatische ACL-Aktualisierung“.
Verwenden Sie permissions resync für die quellenweite ACL-Abstimmung, ohne auf den automatischen Durchlauf zu warten. Reset und reset-docs dienen einem anderen Zweck: Sie verarbeiten Inhalte neu und können die Anreicherung erneut ausführen. Reset-docs bleibt ein separater Vorschauvorgang.
Die Resync-Anforderung stellt die Berechtigungsverarbeitung für die nächste manuelle oder geplante Ausführung in die Warteschlange; die Annahme bedeutet nicht, dass die Synchronisierung abgeschlossen ist. Resync aktualisiert Berechtigungsfelder für vorhandene Datensätze und ordnungsgemäß zugeordnete projizierte Blöcke, ohne Inhalte oder Einbettungen neu zu generieren. Es füllt fehlenden Quellpfadkontext nicht aus, entfernt keine veralteten Dokumentschlüssel und erzwingt keine Aktualisierung von Abfrageautorisierungscaches.
Erneute Synchronisierung und Ausführen von Indexern
Vergewissern Sie sich, dass die Berechtigungsaufnahme für die Datenquelle aktiviert ist und dass der Index und die Projektionen die erforderlichen Quell- und Berechtigungsfelder enthalten.
Warten Sie, bis der Indexer im Leerlauf ist. Eine Anforderung zur erneuten Synchronisierung steht in Konflikt mit einem aktiven Lauf.
Rufen Sie Indexers - Resync mit
options: ["permissions"]auf.POST https://[service name].search.windows.net/indexers/[indexer name]/resync?api-version=2026-10-01 Authorization: Bearer <search-service-token> Content-Type: application/json { "options" : [ "permissions" ] }- Das
optionsFeld ist erforderlich. Derzeit istpermissionsdie einzige unterstützte Option . Das heißt, nur Berechtigungsfilterfelder im Zielindex werden aktualisiert.
- Das
Rufen Sie Run Indexer auf, oder warten Sie auf die nächste geplante Ausführung.
Überwachen Sie Indexerstatus abrufen, bis die Resync-Ausführung abgeschlossen ist. Überprüfen von Fehlern und Warnungen; nach teilweisen Fehlern können einige Dokumente weiterhin über ältere Berechtigungen verfügen. Beheben Sie die Ursache, und wiederholen Sie die unterstützte Aktualisierung.
Überprüfen Sie beispielhafte zugelassene und verweigerte Benutzer anhand von Dokumenten und projizierten Blöcken. Siehe Überwachen und Überprüfen der Synchronisierung.
Führen Sie den Indexer erneut aus, oder warten Sie bis zum nächsten planmäßigen Lauf, um die Nachverfolgung normaler Inhaltsänderungen von der letzten Wassermarke fortzusetzen.
Überprüfen des Zurücksetzungsstatus „currentState“
Führen Sie die folgenden Schritte aus, um den Zurücksetzungsstatus zu überprüfen und zu sehen, welche Dokumentschlüssel zur Verarbeitung in der Warteschlange stehen:
Rufen Sie Get Indexer Status mithilfe einer Vorschau-API auf.
Die Vorschau-API gibt den
currentStateAbschnitt zurück, der am Ende der Antwort gefunden wurde."currentState": { "mode": "indexingResetDocs", "allDocsInitialTrackingState": "{\"LastFullEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"LastAttemptedEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"NameHighWaterMark\":null}", "allDocsFinalTrackingState": "{\"LastFullEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"LastAttemptedEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"NameHighWaterMark\":null}", "resetDocsInitialTrackingState": null, "resetDocsFinalTrackingState": null, "resyncInitialTrackingState": null, "resyncFinalTrackingState": null, "resetDocumentKeys": [ "200", "630" ] }Überprüfen Sie den "Modus":
Legen Sie für Reset Skills „mode“ auf
indexingAllDocsfest, da potenziell alle Dokumente betroffen sind, hinsichtlich der Felder, die durch die KI-Anreicherung aufgefüllt werden.Legen Sie für Resync Indexers "mode" auf
indexingResync. Der Indexer überprüft alle Dokumente und konzentriert sich auf interessierte Daten in der Datenquelle und interessierte Felder im Zielindex.Setzen Sie für „Reset Documents“ „mode“ auf
indexingResetDocs. Der Indexer behält diesen Status bei, bis er alle Dokumentschlüssel verarbeitet hat, die im Aufruf von „reset documents“ angegeben wurden. Während dieser Zeit werden keine anderen Indizierungseinzelvorgänge ausgeführt, solange der Vorgang läuft. Zum Auffinden aller Dokumente in der Liste der Dokumentschlüssel ist es erforderlich, jedes Dokument zu knacken, um nach dem Schlüssel zu suchen und abzugleichen. Dieser Vorgang kann eine Weile dauern, wenn der Datensatz groß ist. Wenn ein Blobcontainer Hunderte von Blobs enthält und die Dokumente, die Sie zurücksetzen möchten, am Ende liegen, findet der Indexer die übereinstimmenden Blobs erst, wenn alle anderen zuerst überprüft werden.Nachdem der Indexer die Dokumente erneut verarbeitet hat, führen Sie „Get Indexer Status“ erneut aus. Der Indexer kehrt in den
indexingAllDocsModus zurück und verarbeitet alle neuen oder aktualisierten Dokumente bei der nächsten Ausführung.
Überprüfen des Indexerlaufzeitkontingents für S3 HD- und Serverless Foundry IQ-Dienste
Bei Diensten vom Typ Standard 3 High Density (S3 HD) und Serverless Foundry IQ stehen allen Indexern pro Dienst in jedem 24-Stunden-Fenster (UTC) insgesamt 48 Laufzeitstunden gemeinsam zur Verfügung. Jede einzelne Ausführung hat ein separates zweistündiges Maximum.
Informationen zum 2026-10-01 Status- und Dienststatistikworkflow finden Sie unter Überwachen der kumulativen Laufzeit. In diesem Leitfaden werden die pro Indexer und dienstweite Verwendung, die freigegebene verbleibende Laufzeit und die Behandlung optionaler oder NULL-Werte erläutert. Zur Kontingentausschöpfung und -planung siehe Indexerausführung auf Serverless und S3 HD.
Nächste Schritte
Reset-APIs werden verwendet, um den Umfang der nächsten Indexerausführung festzulegen. Zur eigentlichen Verarbeitung müssen Sie eine bedarfsgesteuerte Indiziererausführung aufrufen oder einen geplanten Einzelvorgang zum Abschließen der Arbeit zulassen. Nach Abschluss des Durchlaufs kehrt der Indexer zur normalen Verarbeitung zurück, sei es zeitgesteuerte oder bedarfsorientierte Verarbeitung.
Nachdem Sie Indexeraufträge zurückgesetzt und erneut ausgeführt haben, können Sie den Status des Foundry IQ-Diensts überwachen oder detaillierte Informationen über die Ressourcenprotokollierung abrufen.