Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Note
Foundry IQ (Azure KI-Suche) bietet direkte Indizierungs- und Abfrage-APIs zusammen mit Wissensquellen- und Knowledge Base-APIs auf höherer Ebene für den verwalteten Abruf. Verwenden Sie das Azure Portal, REST-APIs oder Azure SDKs, um diese Funktionen zu konfigurieren, oder verbinden Sie Agents mit Wissensdatenbanken im Microsoft Foundry-Portal.
Wichtig
Die Anreicherungszwischenspeicherung befindet sich in der öffentlichen Vorschau und unterliegt den ergänzenden Nutzungsbedingungen für Microsoft Azure Previews.
Die für dieses Feature geltenden Vorschaubedingungen finden Sie unter Previewfunktionalität.
In diesem Artikel wird erläutert, wie Sie einer Skillset-Pipeline Zwischenspeicherung hinzufügen, damit Sie nachgelagerte Anreicherungsschritte ändern können, ohne jedes Mal vollständig neu zu erstellen. Die Anreicherungszwischenspeicherung (Vorschauversion) erfordert eine Vorschau-REST-API. Standardmäßig ist ein Skillset zustandslos, und eine Änderung eines beliebigen Teils seiner Komposition erfordert eine vollständige erneute Ausführung des Indexers. Mit einem Anreicherungscache bestimmt der Indexer, welche Teile der Dokumentstruktur basierend auf Änderungen der Fähigkeiten oder Indexerdefinition aktualisiert werden müssen. Der Indexer behält vorhandene verarbeitete Ausgabe bei, sofern möglich, und verwendet sie wieder.
Sie platzieren zwischengespeicherte Inhalte in Azure Storage mithilfe einer von Ihnen bereitgestellten Verbindungszeichenfolge. Der Indexer erstellt diese Objekte, wenn er ausgeführt wird. Erwägen Sie den Anreicherungscache einer internen Komponente, die von Ihrem Foundry IQ (Azure KI-Suche)-Dienst verwaltet wird, den Sie nicht ändern dürfen.
Wichtig
Ein Anreicherungscache ist keine Sicherung von Skillset-Ausgaben, Indexerstatus oder indizierten Dokumenten. Es wird nicht nachverfolgt, welche Dokumente die Verarbeitung abgeschlossen haben. Überprüfen Sie für große Datenquellen den Abschnitt "Einschränkungen" , bevor Sie die Zwischenspeicherung aktivieren.
- Ein Container mit dem Namen
ms-az-search-indexercache-<alpha-numeric-string> - Tabellen mit dem Namen
MsAzSearchIndexerCacheIndex<alpha-numeric-string>
Voraussetzungen
Azure Storage zum Speichern zwischengespeicherter Anreicherungen. Das Speicherkonto muss General Purpose v2 sein.
Nur für die Blobindizierung: Wenn Sie beim Löschen von Blobs aus Ihrer Datenquelle eine synchronisierte Dokumententfernung aus Cache und Index benötigen, aktivieren Sie im Indexer eine Löschrichtlinie. Ohne diese Richtlinie wird das Löschen von Dokumenten aus dem Cache nicht unterstützt.
Sie sollten mit der Einrichtung von Indexern und Skillsets vertraut sein. Beginnen Sie mit der Indexer-Übersicht und fahren Sie dann mit skillsets fort, um mehr über Anreicherungspipelines zu erfahren.
Einschränkungen
Vorsicht
Wenn Sie den SharePoint Indexer verwenden, vermeiden Sie inkrementelle Anreicherung. Unter bestimmten Umständen wird der Cache ungültig. Um sie neu zu laden, führen Sie ein Zurücksetzen des Indexers und eine vollständige Neuindizierung durch.
Große Datenquellen haben eine zusätzliche Cachebeschränkung.
Vorsicht
Bei großen Datenquellen kann ein Anreicherungscache die gesamte Neuverarbeitung erhöhen, wenn lange laufende Fähigkeiten, wiederholte Unterbrechungen oder häufige Fähigkeitsfehler auftreten. Der Indexer priorisiert die Korrektheit gegenüber der Minimierung der Neuverarbeitung, sodass ein Cache-Backlog von wiederholten Unterbrechungen das Wiederholungsverhalten verstärkt. Dieses Verhalten wird erwartet, kein Fehler.
Um aus einem wachsenden Cache-Backlog wiederherzustellen, partitionieren Sie die Datenquelle in kleinere Container oder virtuelle Ordner. Verwenden Sie dann parallele Indexer , die auf denselben Index zeigen. Wenn Sie die Zuordnung des Caches aufheben möchten, legen Sie die cache Eigenschaft auf NULL für den Indexer fest. Anleitungen zum Partitionierungsmuster finden Sie unter "Große Datensätze indizieren ".
Berechtigungen
Eine Foundry IQ Identity benötigt Schreibzugriff auf Azure Storage:
- Mitwirkender an Speicherblobdaten
- Mitwirkender für Speichertabellendaten
Die syntax Verbindungszeichenfolge bestimmt, ob eine vom System zugewiesene oder vom Benutzer zugewiesene Identität verwendet wird. Weitere Informationen finden Sie unter Connect to Azure Storage using a managed identity.
Festlegen der Cacheeigenschaft
Verwenden Sie dieses Verfahren sowohl für neue als auch für vorhandene Indexer.
Definieren Sie in der Indexerdefinition cache mit Folgendem:
- (Erforderlich)
storageConnectionStringauf eine Azure Storage Verbindungszeichenfolge festgelegt. - (Optional)
enableReprocessing(truestandardmäßig). Stellen Sie es auffalse, um die inkrementelle Anreicherung vorübergehend anzuhalten, und stellen Sie es später wieder auftrueum.
Wählen Sie auf der linken Seite die Option "Indexer" aus.
Wählen Sie "Indexer hinzufügen" aus, um einen neuen Indexer zu erstellen, oder öffnen Sie eine vorhandene im JSON-Bearbeitungsmodus.
Aktivieren Sie die inkrementelle Anreicherung, legen Sie das Speicherkonto für die Anreicherung fest, und speichern Sie den Indexer.
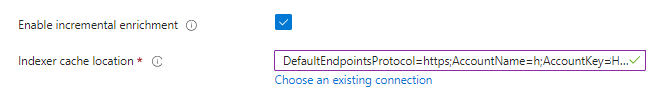
Setzen Sie den Indexer zurück, wenn er bereits vorhanden ist.
Führen Sie den Indexer aus. Dieser einmalige vollständige Neuaufbau initialisiert den Cache. Nach dem Laden gilt die inkrementelle Wiederverwertung für nachfolgende Durchläufe.