Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Note
Foundry IQ (Azure KI-Suche) bietet direkte Indizierungs- und Abfrage-APIs zusammen mit Wissensquellen- und Knowledge Base-APIs auf höherer Ebene für den verwalteten Abruf. Verwenden Sie das Azure Portal, REST-APIs oder Azure SDKs, um diese Funktionen zu konfigurieren, oder verbinden Sie Agents mit Wissensdatenbanken im Microsoft Foundry-Portal.
In diesem Artikel werden die Tools, Verhaltensweisen und Ansätze zur Analyse der Abfrage- und Indizierungsleistung in Foundry IQ (Azure KI-Suche) beschrieben.
Dieser Artikel bezieht sich nur auf klassische Suchszenarien, Volltextsuchszenarien.
Entwickeln von Baselinewerten
In jeder großen Implementierung ist es wichtig, einen Leistungs-Benchmarking-Test Ihres Foundry IQ-Diensts durchzuführen, bevor Sie ihn in die Produktion integrieren. Sie sollten sowohl die erwartete Auslastung der Suchabfrage als auch die erwarteten Datenerfassungsworkloads testen (führen Sie beide Workloads nach Möglichkeit gleichzeitig aus). Benchmarkzahlen helfen dabei, die richtige Suchebene, die Dienstkonfiguration und die erwartete Abfragelatenz zu ermitteln.
Testen Sie die Dienstkonfigurationen eines Replikats und einer Partition, um die Auswirkungen einer verteilten Dienstarchitektur zu isolieren.
Note
Für die Tarife vom Typ „Storage Optimized“ (L1 und L2) sollten Sie einen geringeren Abfragedurchsatz und eine höhere Latenz als für die Tarife vom Typ „Standard“ erwarten.
Verwenden der Ressourcenprotokollierung
Das wichtigste Diagnosetool, das einem Administrator zur Verfügung steht, ist die Ressourcenprotokollierung. Die Ressourcenprotokollierung ist die Sammlung von Betriebsdaten und Metriken zu Ihrem Foundry IQ-Dienst. Die Diagnoseprotokollierung wird über Azure Monitor aktiviert. Mit der Verwendung von Azure Monitor und dem Speichern von Daten sind Kosten verbunden. Wenn Sie sie aber für Ihren Dienst aktivieren, kann dies bei der Untersuchung von Leistungsproblemen äußerst nützlich sein.
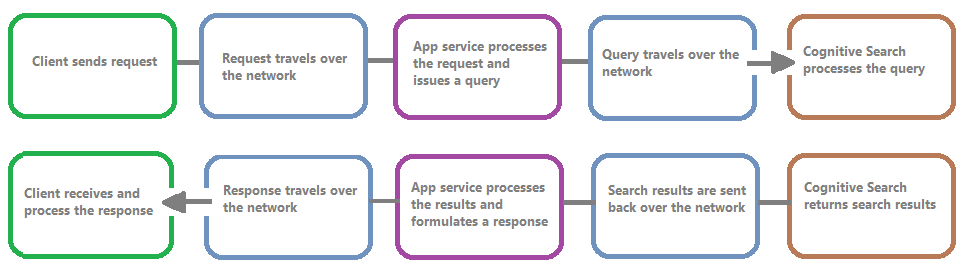
Die folgende Abbildung zeigt die Ereigniskette in einer Abfrageanforderung und -antwort. Latenz kann bei einem beliebigen dieser Schritte auftreten, unabhängig davon, ob sie während einer Netzwerkübertragung, der Verarbeitung von Inhalten in der App-Dienstebene oder in einem Foundry IQ-Dienst auftritt. Ein wichtiger Vorteil der Ressourcenprotokollierung besteht darin, dass Aktivitäten aus der Sicht des Foundry IQ-Diensts protokolliert werden, was bedeutet, dass das Protokoll Ihnen helfen kann, festzustellen, ob das Leistungsproblem auf Probleme mit der Abfrage oder indizierung oder auf einen anderen Fehlerpunkt zurückzuführen ist.
Die Ressourcenprotokollierung bietet Ihnen Optionen zum Speichern protokollierter Informationen. Es wird empfohlen, Log Analytics zu verwenden, damit Sie erweiterte Kusto-Abfragen für die Daten ausführen können, um viele Fragen zur Nutzung und Leistung zu beantworten.
Auf Ihren Portalseiten des Findry IQ-Dienstportals können Sie die Protokollierung über Diagnoseeinstellungen aktivieren und dann Kusto-Abfragen für Log Analytics ausstellen, indem Sie Protokolle auswählen. Informationen zum Senden von Ressourcenprotokollen an einen Log Analytics-Arbeitsbereich, in dem Sie sie mit Protokollabfragen analysieren können, finden Sie unter Sammeln und Analysieren von Ressourcenprotokollen aus einer Azure-Ressource.
Drosselungsverhalten
Drosselung tritt auf, wenn der Foundry IQ-Dienst in der Kapazität ist. Zu einer Drosselung kann es während einer Abfrage oder einer Indizierung kommen. Auf Clientseite führt ein API-Aufruf zu einer 503-HTTP-Antwort, wenn er gedrosselt wurde. Während der Indizierung besteht auch die Möglichkeit, eine 207-HTTP-Antwort zu erhalten, die angibt, dass mindestens ein Element nicht indiziert werden konnte. Dieser Fehler ist ein Indikator dafür, dass der Foundry IQ-Dienst in der Nähe der Kapazität ist.
Versuchen Sie als Faustregel, die Menge der Drosselung und aller Muster zu quantifizieren. Wenn beispielsweise eine von 500.000 Suchabfragen gedrosselt wird, erfordert dies möglicherweise keine weitere Untersuchung. Wenn jedoch ein großer Prozentsatz der Abfragen über einen bestimmten Zeitraum gedrosselt wird, ist dies ein ernstes Problem. Die Betrachtung der Drosselung über einen bestimmten Zeitraum hilft auch dabei, Zeiträume zu identifizieren, in denen eine Drosselung wahrscheinlicher ist. Zudem können Sie so entscheiden, wie Sie diese am besten berücksichtigen.
Eine einfache Lösung für die meisten Drosselungsprobleme besteht darin, mehr Ressourcen im Foundry IQ-Dienst auszuwerfen (in der Regel Replikate für abfragebasierte Drosselung oder Partitionen für die indizierungsbasierte Drosselung). Das Erhöhen von Replikaten oder Partitionen verursacht jedoch zusätzliche Kosten, weshalb es wichtig ist, den Grund zu kennen, warum die Drosselung überhaupt auftritt. Die Untersuchung der Ursachen für eine Drosselung wird in den nächsten Abschnitten erläutert.
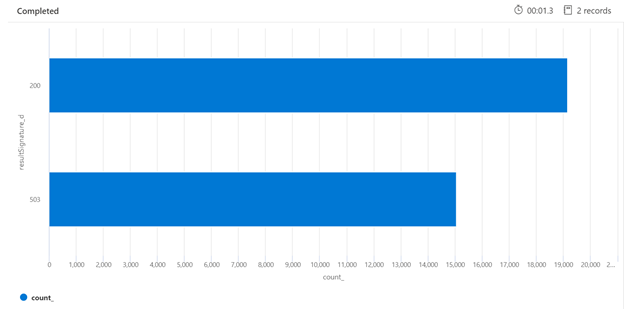
Nachfolgend finden Sie ein Beispiel für eine Kusto-Abfrage, die die Aufschlüsselung von HTTP-Antworten aus dem Foundry IQ-Dienst identifizieren kann, der unter Last stand. Über einen Zeitraum von 7 Tagen zeigt das gerenderte Balkendiagramm an, dass ein relativ großer Prozentsatz der Suchabfragen gedrosselt wurde, im Vergleich zur Anzahl der erfolgreichen (200) Antworten.
AzureDiagnostics
| where TimeGenerated > ago(7d)
| summarize count() by resultSignature_d
| render barchart
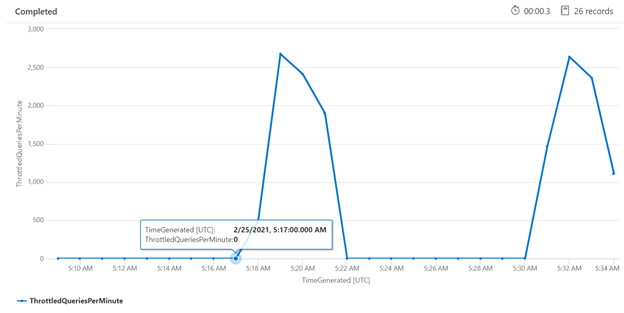
Durch die Untersuchung der Drosselung über einen bestimmten Zeitraum lassen sich die Zeiten ermitteln, in denen die Drosselung möglicherweise häufiger auftritt. Im folgenden Beispiel wird ein Zeitreihendiagramm verwendet, um die Anzahl der gedrosselten Abfragen darzustellen, die innerhalb eines festgelegten Zeitraums aufgetreten sind. In diesem Fall entsprachen die gedrosselten Abfragen den Zeiten, in denen das Leistungsbenchmarking durchgeführt wurde.
let ['_startTime']=datetime('2024-02-25T20:45:07Z');
let ['_endTime']=datetime('2024-03-03T20:45:07Z');
let intervalsize = 1m;
AzureDiagnostics
| where TimeGenerated > ago(7d)
| where resultSignature_d != 403 and resultSignature_d != 404 and OperationName in ("Query.Search", "Query.Suggest", "Query.Lookup", "Query.Autocomplete")
| summarize
  ThrottledQueriesPerMinute=bin(countif(OperationName in ("Query.Search", "Query.Suggest", "Query.Lookup", "Query.Autocomplete") and resultSignature_d == 503)/(intervalsize/1m), 0.01)
  by bin(TimeGenerated, intervalsize)
| render timechart
Messen einzelner Abfragen
In einigen Fällen kann es hilfreich sein, die Leistung einzelner Abfragen zu testen. Dazu ist es wichtig zu sehen, wie lange der Foundry IQ Service dauert, um die Arbeit abzuschließen, und wie lange die Anfrage für den Hin- und Rückweg vom Client zum Dienst und zurück zum Client benötigt. Die Diagnoseprotokolle könnten verwendet werden, um einzelne Vorgänge nachzuschlagen, aber es wäre vielleicht einfacher, dies alles über einen REST-Client zu tun.
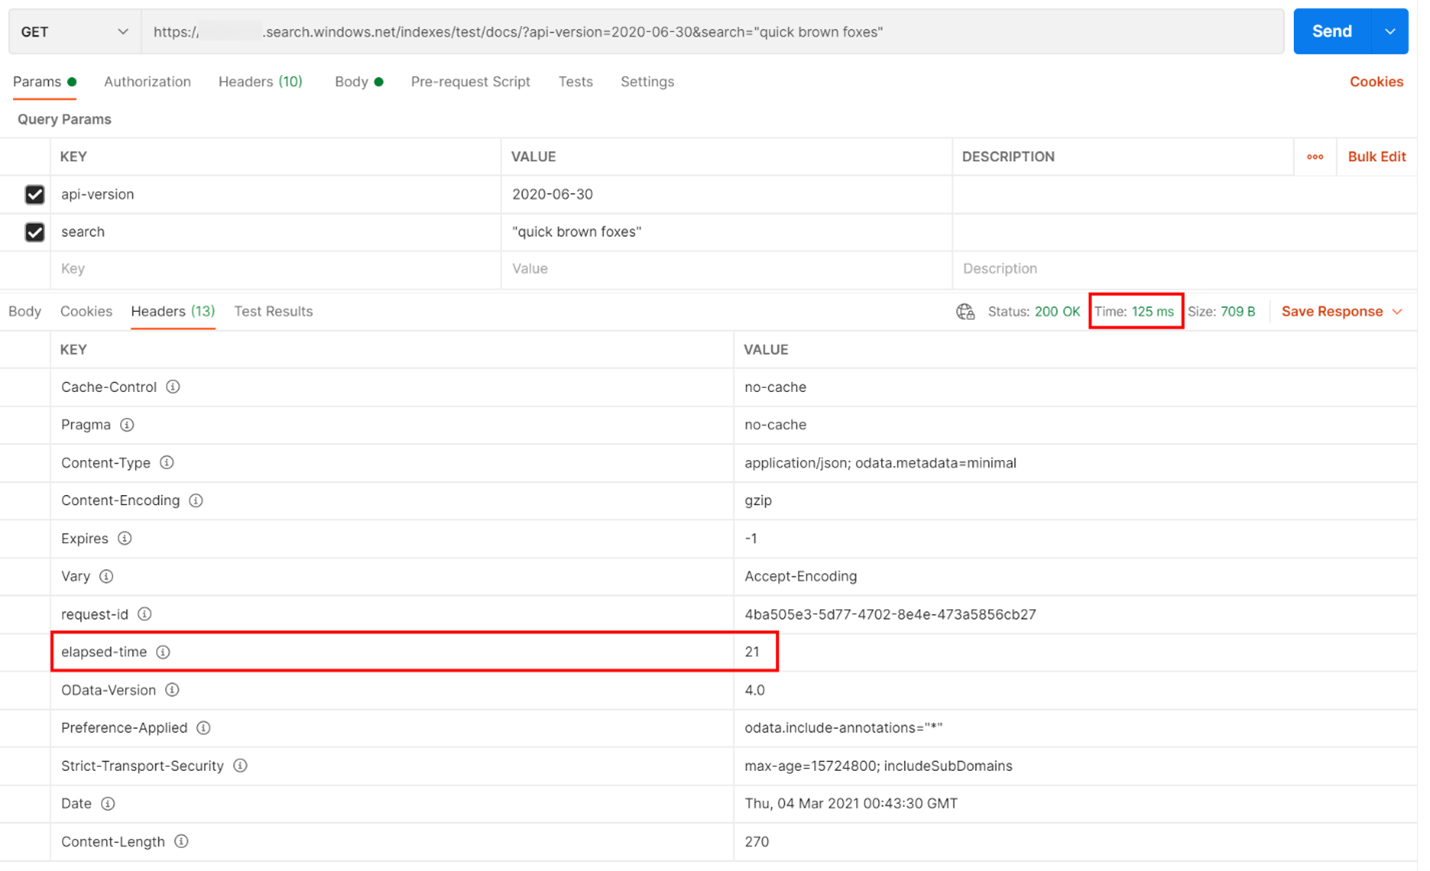
Im folgenden Beispiel wurde eine REST-basierte Suchabfrage ausgeführt. Foundry IQ enthält in jeder Antwort die Anzahl der Millisekunden, die zum Abschließen der Abfrage benötigt werden und die auf der Registerkarte „Headers“ unter „elapsed-time“ sichtbar ist. Neben dem Status oben in der Antwort finden Sie die Roundtripdauer, in diesem Fall 125 Millisekunden (ms). Im Ergebnisabschnitt wurde die Registerkarte „Header“ ausgewählt. Bei Verwendung dieser beiden Werte, hervorgehoben mit einem roten Feld in der abbildung unten, sehen wir, dass der Foundry IQ-Dienst 21 ms benötigt hat, um die Suchabfrage abzuschließen, und die gesamte Client-Roundtrip-Anforderung dauerte 125 ms. Durch Subtrahieren dieser beiden Zahlen können wir feststellen, dass es 104 ms zusätzliche Zeit benötigt hat, um die Suchabfrage an den Foundry IQ-Dienst zu übertragen und die Suchergebnisse zurück an den Client zu übertragen.
Diese Technik hilft Ihnen, Netzwerklatenzen von anderen Faktoren zu isolieren, die sich auf die Abfrageleistung auswirken.
Abfrageraten
Ein potenzieller Grund dafür, dass Ihr Foundry IQ-Dienst Anfragen drosselt, ist die schiere Anzahl der Abfragen, die ausgeführt werden, wobei das Volumen als Abfragen pro Sekunde (QPS) oder Abfragen pro Minute (QPM) erfasst wird. Wenn Ihr Foundry IQ-Dienst mehr QPS empfängt, dauert es in der Regel länger und länger, um auf diese Abfragen zu antworten, bis er nicht mehr auf dem Laufenden bleiben kann, da er eine Drosselung von 503 HTTP-Antwort zurückgibt.
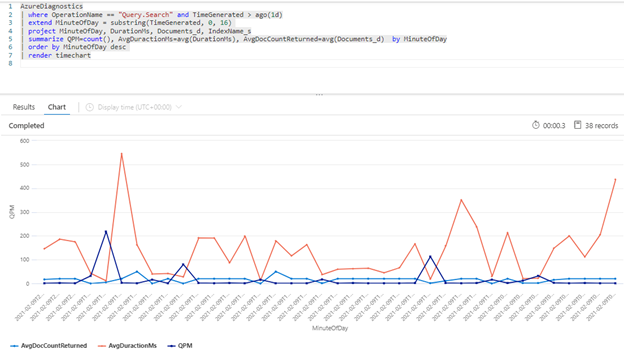
Die folgende Kusto-Abfrage zeigt die in QPM gemessene Abfragemenge zusammen mit der durchschnittlichen Dauer einer Abfrage in Millisekunden (AvgDurationMS) und der durchschnittlichen Anzahl von Dokumenten (AvgDocCountReturned), die jeweils zurückgegeben werden.
AzureDiagnostics
| where OperationName == "Query.Search" and TimeGenerated > ago(1d)
| extend MinuteOfDay = substring(TimeGenerated, 0, 16)
| project MinuteOfDay, DurationMs, Documents_d, IndexName_s
| summarize QPM=count(), AvgDuractionMs=avg(DurationMs), AvgDocCountReturned=avg(Documents_d)  by MinuteOfDay
| order by MinuteOfDay desc
| render timechart
Tip
Um die Daten hinter diesem Diagramm anzuzeigen, entfernen Sie die Zeile | render timechart, und starten Sie dann die Abfrage erneut.
Auswirkungen der Indizierung auf Abfragen
Ein wichtiger Faktor, der bei der Betrachtung der Leistung zu berücksichtigen ist, besteht darin, dass die Indizierung dieselben Ressourcen verwendet wie die Suchabfragen. Wenn Sie eine große Menge an Inhalten indizieren, können Sie davon ausgehen, dass die Latenz steigt, wenn der Dienst versucht, beide Workloads zu bewältigen.
Wenn Abfragen langsamer ausgeführt werden, sehen Sie sich den Zeitpunkt der Indizierungsaktivität an, um zu sehen, ob er mit der Verschlechterung der Abfrageleistung zusammenfällt. Zum Beispiel könnte ein Indexer einen täglichen oder stündlichen Auftrag ausführen, der mit der verminderten Leistung der Suchabfragen korreliert.
Dieser Abschnitt enthält eine Reihe von Abfragen, mit denen Sie die Such- und Indizierungsraten visualisieren können. In diesen Beispielen wird der Zeitbereich in der Abfrage festgelegt. Achten Sie beim Ausführen der Abfragen in Azure-Portal auf In Abfrage festlegen.
Durchschnittliche Abfragelatenz
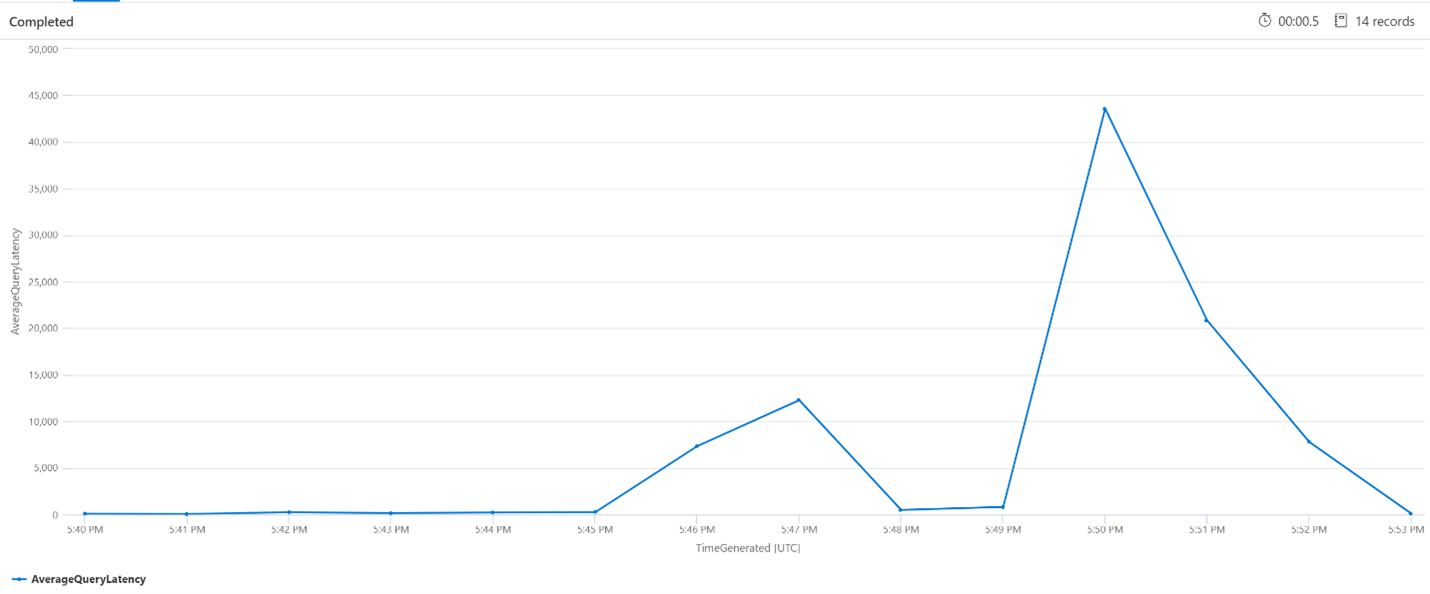
In der folgenden Abfrage wird eine Intervallgröße von 1 Minute verwendet, um die durchschnittliche Latenz bei Suchabfragen anzuzeigen. Im Diagramm sehen Sie, dass die durchschnittliche Latenz bis 17:45 Uhr niedrig war und bis 17:53 Uhr gedauert hat.
let intervalsize = 1m;
let _startTime = datetime('2024-02-23 17:40');
let _endTime = datetime('2024-02-23 18:00');
AzureDiagnostics
| where TimeGenerated between(['_startTime']..['_endTime']) // Time range filtering
| summarize AverageQueryLatency = avgif(DurationMs, OperationName in ("Query.Search", "Query.Suggest", "Query.Lookup", "Query.Autocomplete"))
    by bin(TimeGenerated, intervalsize)
| render timechart
Durchschnittliche Abfragen pro Minute (QPM)
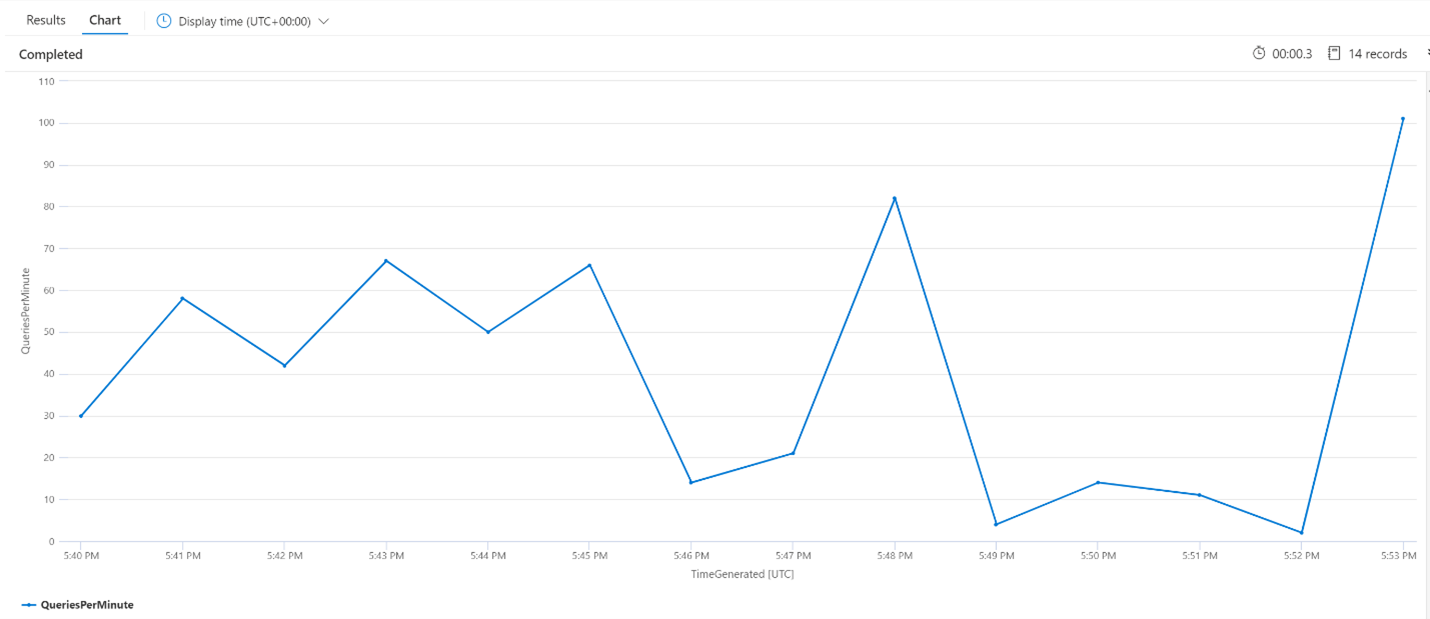
Die folgende Abfrage untersucht die durchschnittliche Anzahl von Abfragen pro Minute, um sicherzustellen, dass es keine Spitzenzahl bei Suchanforderungen gab, die möglicherweise die Latenz beeinflusst haben. Aus dem Diagramm ist ersichtlich, dass es eine gewisse Varianz gibt, aber Nichts, was auf eine Spitze bei der Anforderungsanzahl hindeutet.
let intervalsize = 1m;
let _startTime = datetime('2024-02-23 17:40');
let _endTime = datetime('2024-02-23 18:00');
AzureDiagnostics
| where TimeGenerated between(['_startTime'] .. ['_endTime']) // Time range filtering
| summarize QueriesPerMinute=bin(countif(OperationName in ("Query.Search", "Query.Suggest", "Query.Lookup", "Query.Autocomplete"))/(intervalsize/1m), 0.01)
  by bin(TimeGenerated, intervalsize)
| render timechart
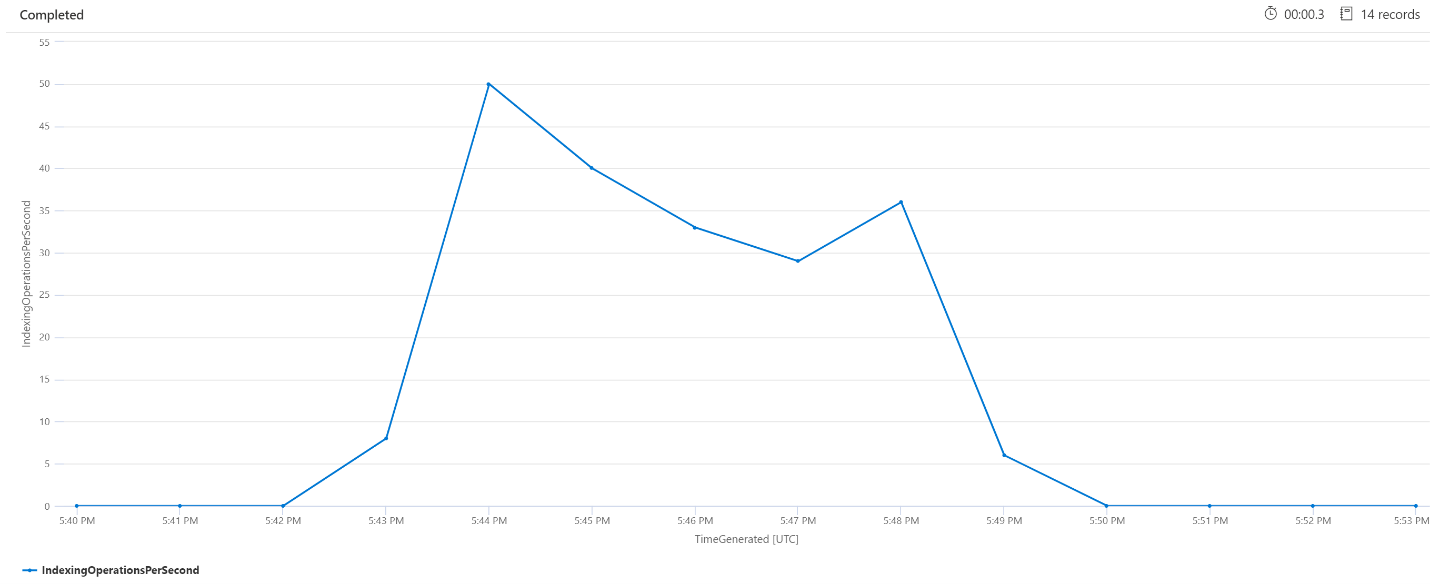
Indizierungsvorgänge pro Minute (OPM)
Hier sehen wir uns die Anzahl der Indizierungsvorgänge pro Minute an. Das Diagramm zeigt, dass die Indizierung einer großen Datenmenge um 17:42 Uhr begann und um 17:50 Uhr endete. Diese Indizierung begann 3 Minuten, bevor es Latenzen bei den Suchabfragen gab, und endete 3 Minuten, bevor die Suchabfragen keine Latenzen mehr aufwiesen.
Aus dieser Erkenntnis können wir sehen, dass es etwa 3 Minuten dauerte, bis der Foundry IQ-Dienst ausreichend ausgelastet war, sodass sich die Indizierung auf die Abfragelatenz auswirkte. Wir können auch sehen, dass es nach abschluss der Indizierung weitere 3 Minuten dauerte, bis der Foundry IQ-Dienst alle Arbeiten aus dem neu indizierten Inhalt abgeschlossen hat und dass die Abfragelatenz aufgelöst werden konnte.
let intervalsize = 1m;
let _startTime = datetime('2024-02-23 17:40');
let _endTime = datetime('2024-02-23 18:00');
AzureDiagnostics
| where TimeGenerated between(['_startTime'] .. ['_endTime']) // Time range filtering
| summarize IndexingOperationsPerSecond=bin(countif(OperationName == "Indexing.Index")/ (intervalsize/1m), 0.01)
  by bin(TimeGenerated, intervalsize)
| render timechart
Hintergrunddienstverarbeitung
Es ist üblich, gelegentlich Spitzen bei der Abfrage- oder Indizierungslatenz zu sehen. Spitzen können als Reaktion auf die Indizierung oder hohe Abfrageraten auftreten, aber auch während Zusammenführungsvorgängen. Suchindizes werden in Blöcken Shards gespeichert. In regelmäßigen Abständen führt das System kleinere Shards zu großen Shards zusammen, um die Leistung des Diensts zu optimieren. Bei dieser Zusammenführung werden auch Dokumente bereinigt, die zuvor zum Löschen aus dem Index markiert wurden, wodurch wieder mehr Speicherplatz zur Verfügung steht.
Das Zusammenführen von Shards ist zwar schnell, aber auch ressourcenintensiv. Daher kann dadurch die Leistung des Diensts beeinträchtigt werden. Wenn Sie kurze Brüche der Abfragelatenz feststellen und diese Brüche mit den letzten Änderungen an indizierten Inhalten übereinstimmen, können Sie davon ausgehen, dass die Latenz auf Shard-Zusammenführungsvorgänge zurückzuführen ist.
Nächste Schritte
Die folgenden Artikel enthalten Informationen zur Analyse der Leistung des Diensts.