Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Hinweis
Foundry IQ (Azure KI-Suche) bietet direkte Indizierungs- und Abfrage-APIs zusammen mit Wissensquellen- und Knowledge Base-APIs auf höherer Ebene für den verwalteten Abruf. Verwenden Sie das Azure Portal, REST-APIs oder Azure SDKs, um diese Funktionen zu konfigurieren, oder verbinden Sie Agents mit Wissensdatenbanken im Microsoft Foundry-Portal.
Foundry IQ (Azure KI-Suche) ist ein vollständig verwalteter, in der Cloud gehosteter Dienst, der Ihre Daten mit KI verbindet. Es bietet ergänzende API-Ebenen für Erfassung und Abruf, von der direkten Ressourcenkonfiguration bis hin zu Wissens-APIs auf höherer Ebene. Agents und große Sprachmodelle (LLMs) verwenden Unternehmens- und Webinhalte, um faktenbasierte Antworten zu erzeugen.
Für eine von Ihnen verwaltete Ingestionspipeline konfigurieren Sie unterstützte Index-, Indexer-, Skillset- und Vektorisierungseinstellungen direkt. Verwenden Sie Wissensquellen- und Knowledge Base-APIs auf höherer Ebene, um Inhaltsverbindungen und Abrufverhalten zu verwalten.
Je nach Quelltyp stellen Wissensquellen Ingestionsressourcen bereit, verweisen auf einen vorhandenen Index oder rufen Remoteinhalte ohne lokale Ingestion ab. Befolgen Sie die Konfigurationsanleitungen für Ihren Wissensquelltyp, anstatt direkt generierte Ingestionsressourcen zu bearbeiten, die festen Vorlagen folgen.
Foundry IQ unterstützt klassische Suche und abrufgestützte Generierung (RAG). Wissensbasen bieten agentisches Retrieval, das abfragezeitbasierte Abrufe koordiniert und basierende Inhalte oder synthetisierte Antworten je nach Konfiguration zurückgeben. Diese Abfragezeit-Orchestrierung unterscheidet sich von der Ingestion.
Informationen dazu, wie Agenten Wissensdatenbanken und Wissensquellen verwenden, finden Sie unter Wissensabruf-APIs in Foundry IQ.
Wenn Sie einen Foundry IQ-Dienst erstellen, sind die folgenden Funktionen enthalten:
- APIs auf verschiedenen Abstraktionsebenen: Klassische Suche nach direkten Abfragen für einen Index- und agentischen Abruf für eine übergeordnete Orchestrierung über Wissensquellen hinweg über eine Wissensbasis.
- Volltext-, Vektor-, Hybrid- und multimodale Abfragen über lokale (indizierte) und Remoteinhalte.
- KI-Anreicherung, um Inhalte zu segmentieren, zu vektorisieren und zugänglich für die Suche zu machen.
- Relevanzoptimierung zur Verbesserung der Absichtsabgleichs- und Ergebnisqualität.
- Azure Skalierung, Sicherheit, Überwachung und Compliance.
- Azure Integrationen mit unterstützten Datenplattformen, Azure OpenAI und Microsoft Foundry.
Warum Foundry IQ verwenden?
Basieren Sie Agents und Chatbots auf proprietären, Unternehmens- oder Webdaten, um genaue, kontextbezogene Antworten zu erzeugen.
Zugreifen auf Daten aus Azure Blob Storage, Azure Cosmos DB, Microsoft SharePoint, Microsoft OneLake und anderen unterstützten Datenquellen. Wählen Sie den indizierten oder Remotezugriff basierend auf Ihren Aktualitäts-, Latenz- und Complianceanforderungen aus.
Anreicherung und Strukturierung von Inhalten zur Zeit der Indizierung oder Abfrage mit Funktionen, die Blockbildung, Einbettungen und LLM-unterstützte Transformationen ausführen.
Kombinieren Sie die Volltextsuche mit der Vektorsuche (Hybridsuche), um Präzision und Rückruf auszugleichen.
Abfragen von Inhalten, die Sowohl Text als auch Bilder in einer einzigen multimodalen Pipeline enthalten.
Implementieren Sie problemlos suchbezogene Features: Relevanzoptimierung, Faceted Navigation, Filter (einschließlich geo-räumlicher Suche), Synonymzuordnung und AutoVervollständigen.
Bieten Sie Unternehmenssicherheit, Zugriffssteuerung und Compliance über Microsoft Entra ID, Azure Private Link, Zugriffssteuerung auf Dokumentebene und rollenbasierten Zugriff.
Skalieren und arbeiten Sie in der Produktion mit Azure Zuverlässigkeit, Überwachung und Diagnose (Protokolle, Metriken und Warnungen) und REST-API oder SDK-Tools für die Automatisierung.
Weitere Informationen zu bestimmten Funktionen finden Sie unter Features von Foundry IQ.
Was ist die klassische Suche?
Bei der klassischen Suche handelt es sich um ein Index-first-Abrufmodell für vorhersagbare Abfragen mit geringer Latenz. Jede Abfrage zielt auf einen einzelnen vordefinierten Suchindex ab und gibt bewertete Dokumente in einem Anforderungsantwortzyklus zurück. Während des Abrufs erfolgt keine LLM-unterstützte Planung, Iteration oder Synthese.
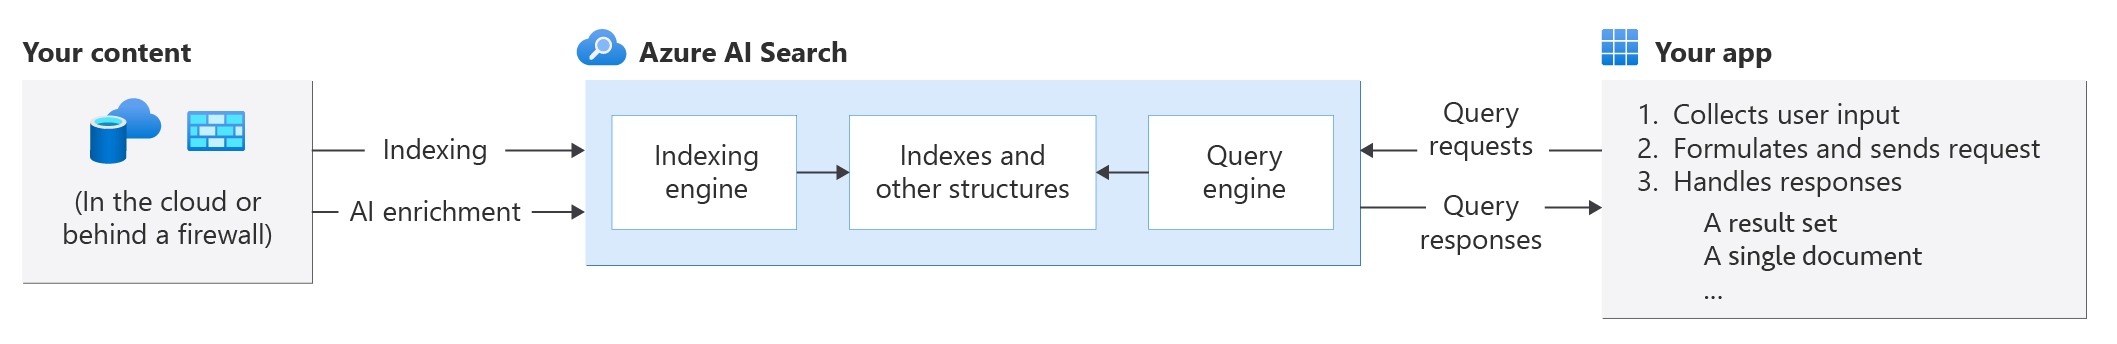
In dieser Architektur befindet sich Ihr Foundry IQ-Dienst zwischen den Datenspeichern, die Ihre unverarbeiteten Inhalte enthalten, und Ihrer Client-App. Die App ist für das Senden von Abfrageanforderungen an Ihren Foundry IQ-Dienst und die Behandlung der Antwort verantwortlich.
Diese Architektur verfügt über zwei primäre Workloads:
Durch die Indizierung werden Inhalte in einen Index geladen und durchsuchbar gemacht. Intern wird eingehender Text tokenisiert und in umgekehrten Indizes gespeichert, während eingehende Vektoren in Vektorindizes gespeichert werden. Foundry IQ kann nur JSON-Dokumente indizieren. Sie können die Pushmethode verwenden, um JSON-Dokumente direkt oder die Pullmethode (Indexer oder Logik-App-Workflow) hochzuladen, um Daten in JSON abzurufen und zu serialisieren.
Während der Indizierung können Sie KI-Anreicherung verwenden, um Text zu blöcken, Vektoren zu generieren und andere Transformationen anzuwenden, die Struktur und Inhalt erstellen. Foundry IQ serialisiert dann die angereicherte Ausgabe in JSON-Dokumente und nimmt sie in den Index auf.
Hinweis
Dieses Diagramm trennt die Indizierungs- und Abfragemodule zur Übersichtlichkeit, aber in Foundry IQ sind sie dieselbe Komponente, die im Lese-/Schreib- und im Nur-Lese-Modus ausgeführt wird.
Was ist agentic retrieval?
Agentic Retrieval ist eine Multi-Query-Pipeline, die für komplexe Agent-zu-Agent-Workflows konzipiert ist. Jede Abfrage zielt auf eine Wissensbasis ab, die eine vollständige Wissensdomäne darstellt. Ihr Agent verweist auf die Wissensbasis für worauf begründet werden soll, während die Wissensbasis übernimmt, wie das Begründen durchgeführt wird.
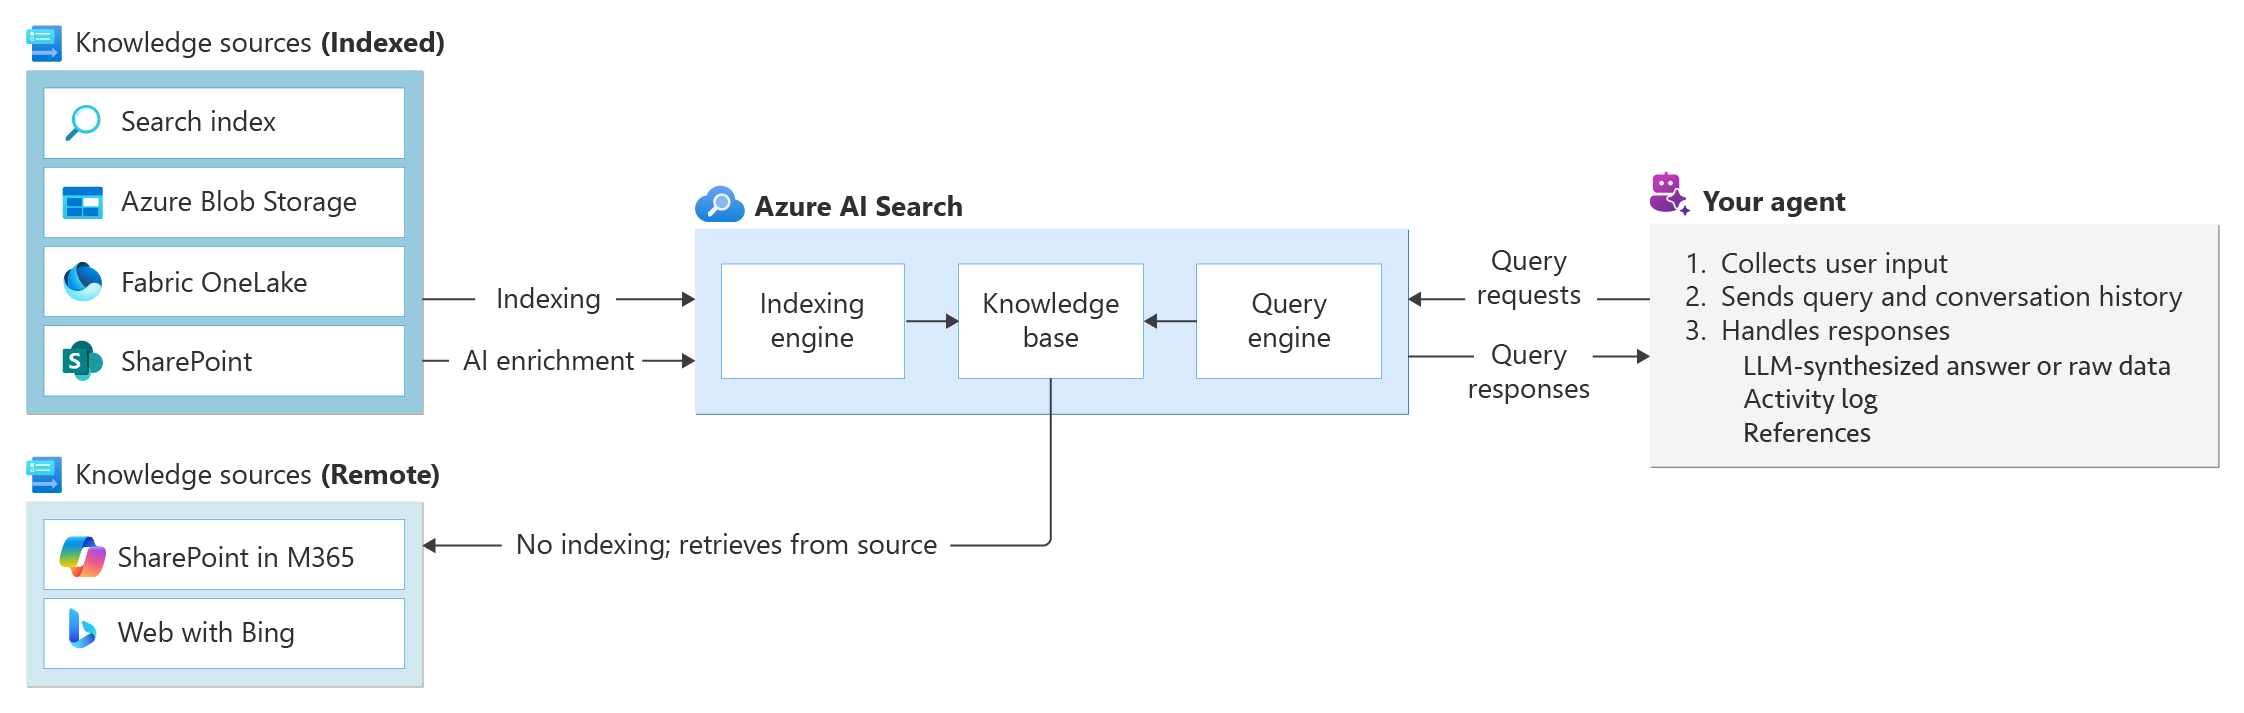
Eine Wissensbasis besteht aus einer oder mehreren Wissensquellen, einer optionalen LLM für die Abfrageplanung und Antwortsynthese und Parameter, die das Abrufverhalten steuern. Jede Abfrage durchläuft Planung, Analyse in fokussierte Unterabfragen, paralleles Abrufen von Wissensquellen, semantisches Neuranking und Zusammenführen von Ergebnissen. Der dreifache Ansatz für Antworten wurde für die Nutzung durch Agents optimiert.
Unter der Haube baut der agentische Abruf auf der klassischen Sucharchitektur auf, indem eine Kontextebene (Knowledge Base) hinzugefügt wird, die den Abruf von mehreren Quellen koordiniert. Wissensquellen können indiziert oder remote sein: Indizierte Quellen verwenden dieselben Indizierungs- und Abfragemodule wie die klassische Suche, während Remotequellen die Indizierung umgehen und live abgefragt werden.
Der Vergleich
Klassische Suche und agentischer Abruf bieten unterschiedliche API-Ebenen und Abruffunktionen in Foundry IQ. Beide unterstützen Volltext-, Vektor-, Hybrid- und multimodale Suche. Sie unterscheiden sich jedoch darin, wie Inhalte aufgenommen und abgefragt werden. In der folgenden Tabelle sind die wichtigsten Unterschiede zusammengefasst.
| Aspekt | Klassische Suche | Agentenbasiertes Abrufen |
|---|---|---|
| Korpus durchsuchen | Suchindex | Wissensquelle |
| Suchziel | Ein durch ein Schema definierter Index | Eine Wissensbasis, die auf eine oder mehrere Wissensquellen verweist |
| Abfrageplan | Kein Plan, nur eine Anforderung | LLM-unterstützter oder vom Benutzer bereitgestellter Plan |
| Abfrageanforderung | Durchsuchen von Dokumenten in einem Index | Abruf von Wissensquellen |
| Antwort | Flache Suchergebnisse basierend auf dem Schema | LLM-formulierte Antwort- oder Rohdaten, Aktivitätsprotokoll, Referenzen |
| Regionseinschränkungen | Nein | Ja |
| Status | Allgemein verfügbar | Allgemein verfügbar, mit einigen Funktionen im Vorschau-Modus. |
| Dedizierte Preismodellunterstützung | Ja | Ja |
| Serverlose Preismodellunterstützung | Ja | Ja |
Erste Schritte
Sie können über das Azure Portal, REST-APIs und Azure SDKs für .NET, Java, JavaScript und Python auf Foundry IQ zugreifen.
Das Portal ist nützlich für die Dienstverwaltung und die Inhaltsverwaltung mit Tools für die Prototyperstellung Ihrer Wissensdatenbanken, Wissensquellen, Indizes, Indexer, Skillsets und Datenquellen. REST-APIs und SDKs sind für die Produktionsautomatisierung nützlich.
Wählen Sie Ihren Pfad aus.
Bevor Sie beginnen, verwenden Sie diese Checkliste, um wichtige Entscheidungen zu treffen:
Wählen Sie ein Preismodell aus: Wählen Sie zwischen dem dedizierten Preismodell oder dem serverlosen Preismodell aus. Hilfe zum Auswählen des Modells, das Ihren Anforderungen am besten entspricht, finden Sie unter Auswählen eines Preismodells und einer Serviceebene .
Wählen Sie aus, wie Daten abgerufen werden sollen: Sie können direkt aus einem Suchindex nach vorhersagbaren Ergebnissen mit geringer Latenz abfragen oder agentische Abrufe verwenden, um mehrere Indizes über eine Wissensbasis abzufragen. Wenn Sie eine herkömmliche App ohne Agent oder Chatbot erstellen, können Direkte Indexabfragen die meisten Anforderungen mit niedrigeren Kosten und Komplexität erfüllen. Wenn Sie über mehrere Wissensquellen hinweg arbeiten oder komplexere Szenarien unterstützen möchten, sollten Sie den agentischen Abruf mit minimalem Aufwand in Betracht ziehen.
Wählen Sie eine Region aus: Wenn Sie den agentischen Abruf verwenden, wählen Sie eine unterstützte Region aus. Wählen Sie für die klassische Suche eine Region aus, die die benötigten Features und Kapazität bietet.
Wählen Sie eine Aufnahmemethode für indexgebundene Inhalte aus: Wenn sich Der Inhalt in einer unterstützten Datenquelle befindet, verwenden Sie die Pullmethode , um Daten in JSON abzurufen und zu serialisieren. Wenn Sie nicht über eine unterstützte Datenquelle verfügen oder Wenn Ihre Inhalte und Der Index in Echtzeit synchronisiert werden müssen, ist die Pushmethode Ihre einzige Option.
Benötigen Sie Vektoren? LLMs und Agents erfordern keine Vektoren. Verwenden Sie sie nur, wenn Sie eine Ähnlichkeitssuche benötigen oder Inhalte haben, die in Vektoren homogenisiert werden können. Foundry IQ bietet integrierte Vektorisierung für diese Aufgabe.
Wählen Sie einen Zugriffssteuerungsansatz aus: Native Berechtigungsaufnahme und Abfragefilterung sind in der Regel für unterstützte Blob-, ADLS Gen2- und indizierte SharePoint Szenarien in REST-API
2026-10-01verfügbar. Remote-SharePoint- und OneLake-Berechtigungserhaltung behalten ihre separaten Vorschauanforderungen bei. Überprüfen Sie die quellspezifischen Berechtigungsmodelle. Verwenden Sie für ein benutzerdefiniertes Identitätssystem Sicherheitsfilter.
Auswählen Ihrer Lernressourcen
Diese Schnellstarts und Beispiele helfen Ihnen beim Einstieg.
- Schnellstart: Agentischer Abruf (Portal oder programmgesteuert)
- Schnellstart: Volltextsuche (Portal oder programmgesteuert)
- Schnellstart: Vektorsuche (Portal oder programmgesteuert)
Tipp
Um Hilfe bei komplexen oder benutzerdefinierten Lösungen zu erhalten, wenden Sie sich an einen Partner mit fundiertem Know-how in Foundry IQ.