Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Hinweis
Foundry IQ (Azure KI-Suche) bietet direkte Indizierungs- und Abfrage-APIs zusammen mit Wissensquellen- und Knowledge Base-APIs auf höherer Ebene für den verwalteten Abruf. Verwenden Sie das Azure Portal, REST-APIs oder Azure SDKs, um diese Funktionen zu konfigurieren, oder verbinden Sie Agents mit Wissensdatenbanken im Microsoft Foundry-Portal.
Important
Features oder Funktionen, die in diesem Artikel als "Vorschau" gekennzeichnet sind, befinden sich in der öffentlichen Vorschau und unterliegen den ergänzenden Nutzungsbedingungen für Microsoft Azure Previews.
Vorschaubegriffe speziell für Foundry IQ (Azure KI-Suche) finden Sie unter Vorschaufunktionen.
In Foundry IQ (Azure KI-Suche) ist der agentische Abruf eine Multiabfragepipeline, die für komplexe Fragen konzipiert ist, die von Benutzern oder Agenten in Chat- und Copilot-Apps gestellt werden. Es ist für RAG-Muster (Retrieval Augmented Generation ) und Agent-zu-Agent-Workflows vorgesehen.
So funktioniert der agentische Abruf:
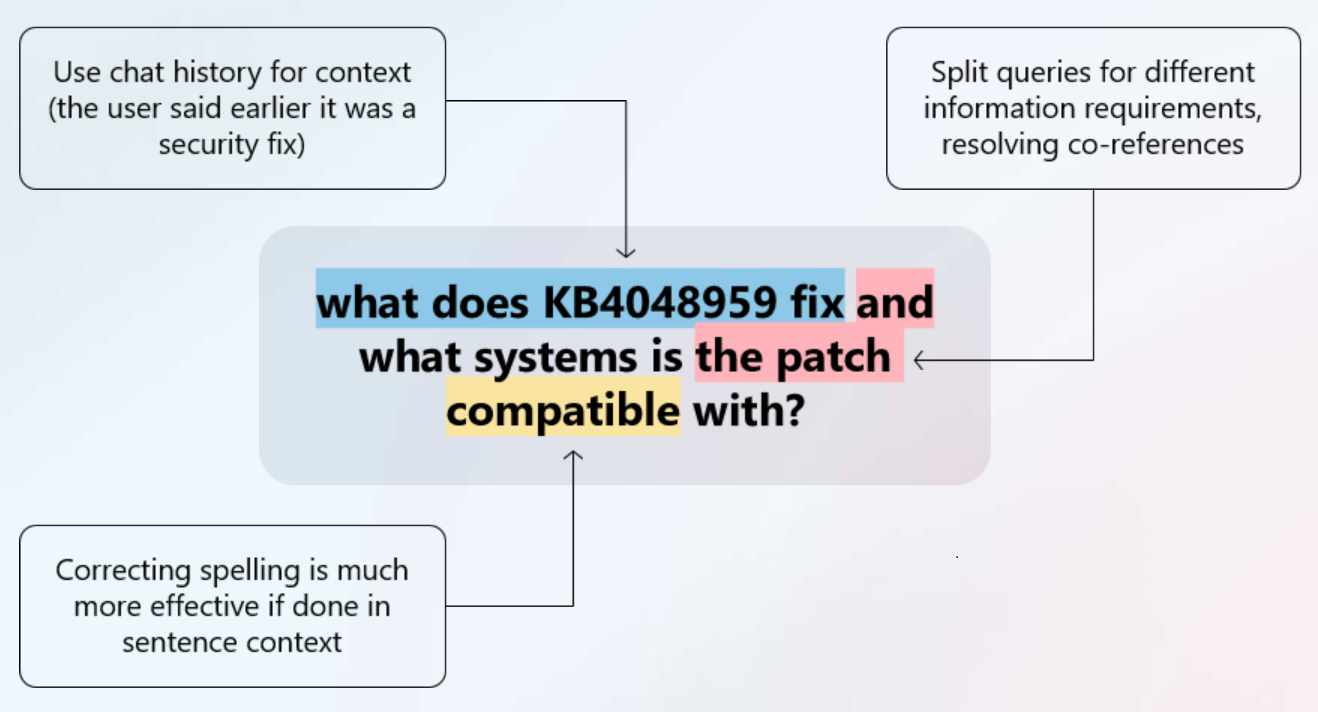
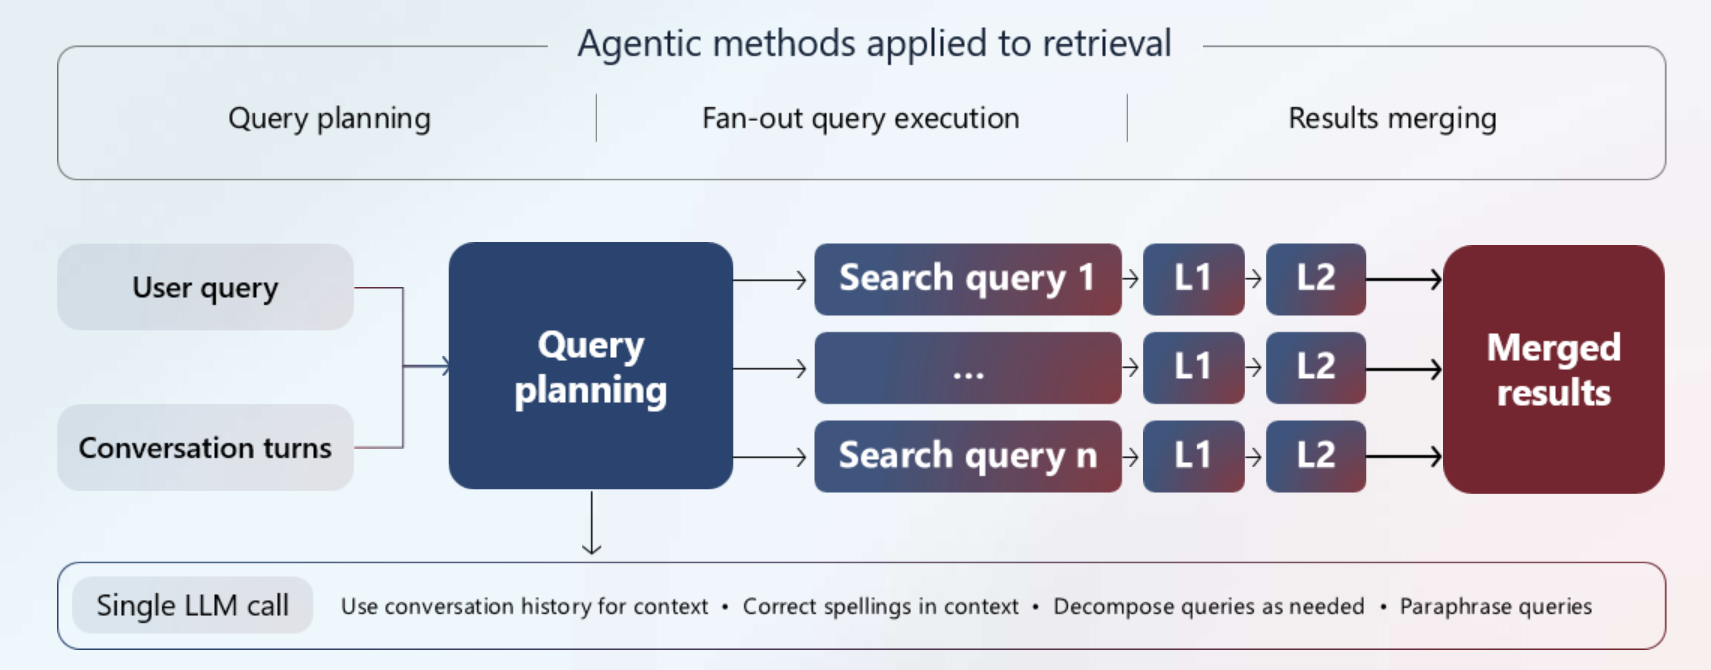
Kann die LLM-basierte Abfrageplanung verwenden, um eine komplexe Abfrage in kleinere, fokussierte Unterabfragen aufzuteilen, um eine bessere Abdeckung über proprietäre und externe Inhalte hinweg zu gewährleisten. Die Abfrageplanung kann den Chatverlauf für zusätzlichen Kontext verwenden.
Führt Unterabfragen parallel aus. Jede Unterabfrage wird semantisch neu bewertet, um die relevantesten Übereinstimmungen höher zu stufen.
Kombiniert die besten Ergebnisse in einer einheitlichen Antwort, die ein LLM verwenden kann, um geerdete Antworten zu generieren.
Es kann Quellverweise und ein Aktivitätsprotokoll zusammen mit den zusammengeführten Inhalten zurückgeben, sodass Sie entweder nur die Grounding-Daten verwenden oder sie für eine vollständige Antwort an ein LLM weitergeben können.
Diese leistungsstarke Pipeline hilft Ihnen, qualitativ hochwertige Bodendaten oder Antworten für Ihre Chatanwendung zu generieren, mit der Möglichkeit, komplexe Fragen schnell zu beantworten.
Warum Agentic-Abruf verwenden?
Foundry IQ unterstützt sowohl verwaltete als auch benutzerdefinierte agentische Abruferfahrungen für Agents und Apps. Verwenden Sie Wissensdatenbanken im Microsoft Foundry-Portal. Greifen Sie über das Azure Portal, die Search Service REST-API oder eine unterstützte Azure SDK auf dieselben Abruffunktionen zu.
Verwenden Sie die agentische Suche, wenn Sie Agenten und Apps die relevantesten Inhalte zur Beantwortung schwierigerer Fragen bereitstellen möchten, gestützt auf den Chatkontext, Ihre proprietären Inhalte und externe Quellen.
Die agentische Suche erhöht im Vergleich zu einer Single-Query-Pipeline die Latenz, bewältigt jedoch die Komplexität von Abfragen, die mit einer einzelnen Abfrage nicht bewältigt werden kann. So kann es z. B. folgendes behandeln:
Fragen mit mehreren Anliegen, z. B. „Finde mir ein Hotel in Strandnähe, mit Flughafentransfer und in fußläufiger Entfernung zu vegetarischen Restaurants.“
Fragen, die von einem früheren Kontext in der Unterhaltung abhängen.
Anfragen, die von einer Umformulierung profitieren, unter Verwendung von Synonymkarten und LLM-generierten Paraphrasierungen, um die Abdeckung Ihres Inhalts zu erweitern.
Rechtschreibfehler.
Architektur und Workflow
Der agentische Abrufvorgang funktioniert wie folgt:
Workflowinitiierung: Ihre Anwendung ruft eine Wissensbasis mit einer Abrufaktion auf, die eine Abfrage und einen Unterhaltungsverlauf bereitstellt.
Abfrageplanung: Ein
lowkonfigurierter LLM-Plänen fragt undmediumwählt Quellen aus. Gewöhnlichminimalwerden modellbasierte Planungen umgangen und alle Kandidatenquellen durchsucht. Legen Sie den Aufwand explizit für die Wissensbasis oder Anfrage fest, anstatt eine universelle Standardeinstellung anzunehmen. Die Novembervorschau Microsoft Retriever 1-Pfad weist ein separates Verhalten auf.Abfrageausführung: Die Wissensdatenbank sendet die Unterabfragen an Ihre Wissensquellen. Alle Unterabfragen werden gleichzeitig ausgeführt und können Schlüsselwort, Vektor oder Hybridsuche sein. Jede Unterabfrage durchläuft eine semantische Neubewertung, um die relevantesten Übereinstimmungen zu finden. Verweise werden für Zitatzwecke extrahiert und aufbewahrt.
Ergebnissynthese: Das System kombiniert aufbewahrte Ergebnisse zu extraktivem Inhalt oder einer modellsynthetisierten Antwort. Die Antwortsynthese erfordert ein Modell unabhängig vom Planungsaufwand. Quellverweise und ein Ausführungsaktivitätsprotokoll sind optional.
Components
Für alle agentischen Abrufszenarien sind eine Wissensbasis und mindestens eine Wissensquelle erforderlich. Andere Komponenten sind optional und hängen von Ihrer Konfiguration ab.
| Komponente | Dienst | Rolle |
|---|---|---|
| Wissensdatenbank | Gießerei IQ | Koordiniert die Pipeline, die Verwaltung von Wissensquellen und Abfrageparametern. |
| Wissensquelle | Gießerei IQ | Definiert den Inhalt, der in der Pipeline verwendet wird. Kann indiziert werden (unterstützt durch einen Suchindex in Ihrem Dienst) oder remote sein (Inhalte werden zum Zeitpunkt der Abfrage von einer externen Plattform abgerufen). |
| Suchindex | Gießerei IQ | Speichert durchsuchbare Inhalte (Text und Vektoren) mit einer semantischen Konfiguration. Bestimmt, welche Abfragetypen ausgeführt werden und welche Optimierungen gelten. Nur für indizierte Wissensquellen erforderlich. |
| Semantischer Sortierer | Gießerei IQ | Wird intern von der agentenbasierten Retrieval-Pipeline verwendet, um Ergebnisse nach Relevanz neu zu ordnen (L2 reranking). |
| LLM | Azure OpenAI | Kann Abfragen planen, Wissensquellen auswählen, Webergebnisse zusammenfassen und Zitat-gesicherte Antworten generieren. Eine einfache minimale Extraktion aus einem vorhandenen Suchindex oder einer vorhandenen Dateiquelle erfordert kein Chatmodell. |
Integrationsanforderungen
Ihre Anwendung steuert die Pipeline, indem sie die Knowledge Base aufruft und die Antwort verarbeitet. Die Pipeline gibt Grounding-Daten zurück, die Sie für die Antwortgenerierung an ein LLM übergeben oder direkt in Ihrer Konversationsoberfläche verwenden können. Details zur Implementierung finden Sie im Lernprogramm: Erstellen einer End-to-End-Agentic-Abruflösung.
Verfügbarkeit von Funktionen
Der agentenbasierte Abruf unterstützt sowohl allgemein verfügbare Funktionen als auch Vorschaufunktionen. Wählen Sie die REST-API-Version des Suchdiensts aus, die zu Ihrer agentenbasierten Abrufumgebung passt:
Verwendung
2026-10-01für den GA REST-Vertrag: minimaler, niedriger und mittlerer Aufwand; modellgestützte Planung und Antwortsynthese; Zitate; SSE; Quellsteuerelemente und Grenzwerte pro Anforderung; Aktivitätswarnungen; und KB CORS.Verwenden Sie eine unterstützende Vorschau-API für Nur-Vorschau-Funktionen.
2026-11-01-previewfügt Microsoft Retriever 1, benannte KB-Tools, zusätzliche GPT-6-Modellbezeichner und asynchrone Dateiaufnahme hinzu.auto, Abrufen von Standardsteuerelementen, Abfragehinweisen und Ergebnisverarbeitungssteuerelementen sind nicht Teil von2026-10-01.Vorhandene
2026-04-01-Beispiele behalten ihren engeren, minimalen und extraktiven Schnittstellenvertrag bei. Vorhandene SDK- und Portalworkflows verfügen über eigene Versionsgrenzen; die GA-REST-Schnittstelle stellt keine vollständige Funktionsgleichheit für alle Client- oder Erfassungsfunktionen her.
Beginnen Sie mit der GA-Wissensdatenbankerstellung und dem Abruf. Überprüfen Sie versionsspezifische Migrationsänderungen , bevor Sie vorhandene Definitionen in einen anderen Vertrag verschieben.
Verfügbarkeit, Grenzwerte und Abrechnung der Region
Bevor Sie die agentengestützte Abrufung verwenden, prüfen Sie deren regionale Verfügbarkeit, Dienstgrenzen und Abrechnungsmodell.
Verfügbarkeit der Region
Agentic-Abruf ist in ausgewählten Regionen verfügbar.
Limits
Wissensquellen und Wissensdatenbanken haben Höchstgrenzen, die je nach Preisstufe und dem Aufwand für Abruf und Schlussfolgerung variieren.
Abrechnung
Agentischer Abruf kann die folgenden Abrechnungskomponenten enthalten:
Foundry IQ berechnet Abruftoken, die während der Ausführung von Unterabfragen und der semantischen Rangfolge verbraucht werden. Der kostenlose Plan (standardmäßig) bietet ein monatliches Token-Kontingent. Der Standardplan ermöglicht eine Abrechnung nach Verbrauch, sobald das kostenlose Freikontingent aufgebraucht ist. Weitere Informationen finden Sie unter Aktivieren oder Deaktivieren von agentischer Abrufabrechnung.
Azure OpenAI berechnet Eingabe- und Ausgabetoken, die in der LLM-basierten Abfrageplanung und Antwortsynthese verwendet werden. Die Preise sind pay-as-you-go und basieren auf dem Modell, das Sie der Wissensbasis zuweisen. Gebühren werden auf Ihrer Azure OpenAI-Rechnung angezeigt. Preise finden Sie unter Azure OpenAI-Preise.
Die Nutzung von Microsoft Retriever 1 (Vorschau) wird in Eingabetoken gemessen, die während der Abfrageplanung verarbeitet werden. Die Eingabe umfasst die Frage des Benutzers und, während der Nachverfolgungsplanung, vorherige Abfragen und Dokumentnachweise, die an das Modell zurückgesendet werden. Wiederholungsversuche und Runden der Folgeplanung erhöhen die Anzahl der Eingabetoken. Ausgabetoken sind kostenlos. Diese Nutzung ist von Foundry IQ-Abruftoken und Azure OpenAI-Gebühren getrennt. Weitere Informationen finden Sie unter Verwenden von Microsoft Retriever 1.
In der folgenden Tabelle wird die Abrechnung zwischen der klassischen Einzelabfragepipeline und der agentischen Abrufpipeline mit mehreren Abfragen verglichen. In der klassischen Pipeline ist die abrechnende Komponente semantischer Sortierer. Die Tabelle schließt Microsoft Retriever 1, Azure OpenAI und andere Servicegebühren aus.
| Aspekt | Klassische Pipeline | Agentenbasiertes Abrufen |
|---|---|---|
| Einheit | Abfragebasiert | Tokenbasiert |
| Kosten pro Einheit | Einheitliche Kosten pro Abfrage | Variable Kosten pro Token (abhängig vom Abrufaufwand) |
| Kostenschätzung | Anzahl der Geschätzten Abfragen | Tokenverbrauch schätzen |
| Freibetrag | Monatliches kostenloses Abfragekontingent | Monatliches kostenloses Token-Kontingent |
Beispiel: Kosten schätzen
In diesem Beispiel wird der Kostenschätzungsprozess für die Abfrageplanung und Abfrageausführung veranschaulicht, aber keine Antwortsynthese. Ihre Kosten könnten niedriger sein. Aktuelle Preise finden Sie unter Foundry IQ-Preise und Azure OpenAI-Preise.
Verwenden Sie symbolische Raten pro Million Token:
-
R_search: Die Tokenrate für Foundry IQ Retrieval und Reranking. -
R_inputundR_output: Die Eingabe- und Ausgabetokenraten für das ausgewählte Azure OpenAI-Modell. -
R_retriever: Die Microsoft Retriever 1-Rate für Eingabetoken, wenn eine veröffentlichte Rate verfügbar ist.
Liefern Sie die aktuellen veröffentlichten Tarife aus den Preislinks. Informationen zu Microsoft Retriever 1-Preisupdates finden Sie unter Verwenden von Microsoft Retriever 1.
Um die Kosten des Abfrageplans bei nutzungsbasierter Bezahlung in Azure OpenAI zu schätzen, gehen Sie von Folgendem ausgpt-4o-mini:
- 2.000 Eingabetoken für die durchschnittliche Größe einer Chatunterhaltung.
- 350 Tokens für die durchschnittliche Ausgabeplangröße.
Geschätzte Abrechnungskosten für die Abfrageausführung
Um die Anzahl agentischer Abruftoken zu schätzen, beginnen Sie mit einer Vorstellung davon, wie ein durchschnittliches Dokument in Ihrem Index aussieht. Zum Beispiel könnten Sie Annahmen treffen:
- 10.000 Blöcke, wobei jeder Block ein bis zwei Absätze einer PDF-Datei ist.
- 500 Token pro Block.
- Jede Unterabfrage ordnet bis zu 50 Blöcke neu ein.
- Im Durchschnitt gibt es drei Unterabfragen pro Abfrageplan.
Berechnung des Preises der Ausführung
Angenommen, Sie erstellen 2.000 agentische Retrievals mit drei Unterabfragen pro Plan. Dadurch erhalten Sie ca. 6.000 Gesamtabfragen.
Ordnen Sie 50 Datenblöcke pro Unterabfrage neu, was insgesamt 300.000 Datenblöcke ergibt.
Der durchschnittliche Chunk beträgt 500 Token, sodass die Gesamttoken für das Reranking 150 Millionen betragen.
Multiplizieren Sie 150 Millionen Reranking-Token mit der Rate pro Million Token, um
150 × R_searchzu erhalten.Multiplizieren Sie für die Abfrageplanung 2.000 Eingabetoken mit 2.000 agentischen Abrufen. Die 4 Millionen Eingabetoken kosten
4 × R_input.Multiplizieren Sie für die Ausgabe 350 Token mit 2.000 agentischen Abrufen. Die 700.000 Ausgabetoken kosten
0.7 × R_output.
In diesem Beispiel betragen die Kosten für die Azure OpenAI-Abfrageplanung 4 × R_input + 0.7 × R_output. Inklusive Foundry IQ-Abruf und Reranking betragen die kombinierten Kosten 150 × R_search + 4 × R_input + 0.7 × R_output. Gebühren für die Antwortsynthese werden separat berechnet.
Geschätzte Kosten für Microsoft Retriever 1-Abfrageplanung
Gehen Sie nun davon aus, dass Microsoft Retriever 1 die Abfragen anstelle von gpt-4o-mini plant. Verwenden Sie dieselben 2.000 agentischen Retrievals und die folgenden Annahmen:
- Keine Gebühr für Ausgabetoken.
- 10.000 Eingabetoken pro agentengestütztem Abruf. Dieser hypothetische Mittelwert umfasst die Unterhaltung und alle vorherigen Abfragen und Dokumentnachweise, die während der Nachverfolgungsplanung wiedergegeben werden.
Multiplizieren Sie 10.000 Eingabetoken mit 2.000 agentischen Abrufen, um 20 Millionen Eingabetoken zu erhalten. Wenn ein veröffentlichter Preis verfügbar ist, beträgt
20 × R_retrieverdie Planungskosten.Ausgabetoken sind kostenlos, daher gibt es keine Ausgabetokengebühr.
Die Kosten für Foundry IQ bleiben bei
150 × R_search, da Abruftoken separat abgerechnet werden.
Die kombinierten Kosten in diesem Szenario sind 150 × R_search + 20 × R_retriever. Fügen Sie die Azure OpenAI-Abfrageplanungskosten nicht hinzu, da Microsoft Retriever 1 die Planung in diesem Szenario behandelt. Wenn Sie auch Azure OpenAI zur Antwortsynthese oder externen Eskalation aufrufen, fügen Sie diese Gebühren separat hinzu.
Tipps zum Steuern von Kosten
Überprüfen Sie das Aktivitätsprotokoll in der Antwort, um herauszufinden, welche Abfragen für welche Quellen und welche Parameter verwendet wurden. Sie können diese Abfragen für Ihre Indizes neu erstellen und einen öffentlichen Tokenizer verwenden, um Token zu schätzen und mit der api-gemeldeten Verwendung zu vergleichen. Möglicherweise können Sie eine Abfrage oder Antwort jedoch nicht genau rekonstruieren. Beispielsweise kann sich der Wissensquelltyp darauf auswirken, ob Sie eine Abfrage erneut ausführen können. Öffentliche Webdaten und Remote-SharePoint Wissensquellen, die von der Identität eines Benutzers abhängen, sind zwei Beispiele.
Verringern Sie die Anzahl der Wissensquellen (Indizes). Wenn Sie Inhalte konsolidieren, werden weniger Quellen abgefragt, und weniger Token werden verwendet.
Verringern Sie den Denkaufwand, um während der Abfrageplanung und der iterativen Suche bei der Abfrageerweiterung die LLM-Nutzung zu reduzieren.
Organisieren Sie Inhalte so, dass die relevantesten Informationen mit weniger Quellen und Dokumenten gefunden werden können (z. B. kuratierte Zusammenfassungen oder Tabellen).
Wenn Sie Microsoft Retriever 1 verwenden, reduzieren Sie die Dokumentenbelege, die Sie während der Planung verarbeiten. Wiederholungen und Nachverfolgungsplanungsrunden fügen Eingabetoken hinzu. Schließen Sie sie also ein, wenn Sie die Nutzung schätzen.
Erste Schritte
Um eine agentische Abruflösung zu erstellen, können Sie das Azure Portal, Microsoft Foundry (neues) Portal, REST-APIs oder ein entsprechendes Azure SDK-Paket verwenden.
- Schnellstart: Agentic-Abruf im Azure-Portal
- Schnellstart: Agentic-Abruf (C#, Java, JavaScript, Python, TypeScript, REST)