Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Note
Azure AI Vyhledávač je k dispozici prostřednictvím portálu Azure, rozhraní REST API a Sady Azure SDK. Podporuje také Foundry IQ, spravovanou znalostní vrstvu, která transformuje podnikový obsah na opakovaně použitelné znalostní báze s podporou oprávnění pro agenty na portálu Microsoft Foundry.
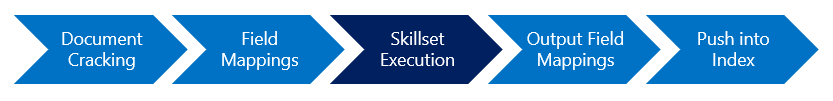
Sada dovedností definuje operace, které generují vektorový a textový obsah a strukturu z dokumentů, které obsahují obrázky nebo nezpracovaný obsah. Příkladem jsou dovednosti členění, vektorové vložení, slovní popis obrázků a další procesy, jako je optické rozpoznávání znaků (OCR) pro obrázky, rozpoznávání entit pro nečleněný text a překlad textu. Sada dovedností se spustí po extrakci nezpracovaného obsahu z externího zdroje dat a po zpracování mapování polí .
Tento článek vysvětluje, jak vytvořit sadu dovedností pomocí rozhraní REST API, ale stejné koncepty a kroky platí pro jiné programovací jazyky.
Mezi pravidla pro definici sady dovedností patří:
- Musí mít jedinečný název v kolekci s dovednostmi. Sada dovedností je prostředek na nejvyšší úrovni, který může používat jakýkoli indexátor.
- Musí mít alespoň jednu dovednost. Tři až pět dovedností jsou typické. Maximum je 30.
- Sada dovedností může opakovat dovednosti stejného typu. Sada dovedností může mít například více dovedností formovače.
- Sada dovedností podporuje řetězené operace, smyčky a větvení.
Připojte sadu dovedností k indexeru. Pokud chcete sadu dovedností použít, odkazujte na ni v indexeru a pak spusťte indexer pro import dat, vyvolání zpracování dovedností a odeslání výstupu do indexu. Sada dovedností je prostředek vyšší úrovně, ale je funkční pouze při zpracování indexeru. Jako prostředek vysoké úrovně můžete na něj odkazovat v několika indexerech.
Tip
Povolte ukládání do mezipaměti pro rozšiřování (Preview) a znovu použijte obsah, který jste už zpracovali, a snižte náklady na vývoj.
Přidání definice sady dovedností
Když vytvoříte sadu dovedností, přidáte ji do vyhledávací služby. Při aktualizaci sady dovedností plně přepíšete existující sadu dovedností obsahem datové části žádosti. Pokud chcete sadu dovedností aktualizovat, načtěte definici sady dovedností pomocí metody GET, upravte ji a pak ji aktualizujte pomocí příkazu PUT.
Note
Když načtete sadu dovedností pomocí metody GET, služba vrátí <redacted> pro všechny hodnoty httpHeaders ve vlastních dovednostech a ?code=<redacted> pro libovolný parametr dotazu ?code= v uri. Pokud chcete sadu dovedností aktualizovat beze změny těchto hodnot, nastavte tato pole do <unchanged> textu požadavku PUT. Úplné podrobnosti najdete v tématu Vlastní dovednosti webového rozhraní API – parametry dovedností.
Začněte základní strukturou. V rozhraní REST API pro vytvoření sady dovedností vytvořte text požadavku ve formátu JSON. Obsahuje následující části:
{
   "name":"skillset-template",
   "description":"A description makes the skillset self-documenting (comments aren't allowed in JSON itself)",
   "skills":[

   ],
   "cognitiveServices":{
      "@odata.type":"#Microsoft.Azure.Search.CognitiveServicesByKey",
      "description":"A Microsoft Foundry resource in the same region as Azure AI Search",
      "key":"<Your-Microsoft-Foundry-Resource-Key>"
   },
   "knowledgeStore":{
      "storageConnectionString":"<Your-Azure-Storage-Connection-String>",
      "projections":[
         {
            "tables":[ ],
            "objects":[ ],
            "files":[ ]
         }
      ]
    },
    "encryptionKey":{ }
}
Po názvu a popisu má sada dovedností čtyři hlavní vlastnosti:
skillspole, neseřazená kolekce dovedností. Dovednosti jsou buď samostatné, nebo zřetězené prostřednictvím přidružení vstupů a výstupů, kde se výstup jedné transformace stává vstupem do jiné. Dovednosti můžou být utilitární (například rozdělení textu), transformace (na základě AI z Azure OpenAI nebo Foundry Tools) nebo vlastní dovednosti, které poskytnete. Příklad pole dovedností je k dispozici v další části.cognitiveServicesslouží k fakturovatelným dovednostem, které volají rozhraní API Foundry Tools. Pokud nepoužíváte fakturovatelné dovednosti nebo vlastní vyhledávání entit, odeberte tuto část. Pokud ano, připojte prostředek Foundry.knowledgeStore(volitelné) určuje účet azure Storage a nastavení pro projektování výstupu sady dovedností do tabulek, objektů blob a souborů ve službě Azure Storage. Pokud ho nepotřebujete, odeberte tento oddíl. V opačném případě zadejte úložiště znalostí.encryptionKey(volitelné) určuje azure Key Vault a klíče spravované zákazníkem používané k šifrování citlivého obsahu (popisy, připojovací řetězec, klíče) v definici sady dovedností. Tuto vlastnost odeberte, pokud nepoužíváte šifrování spravované zákazníkem.
Přidání dovedností
V definici sady dovedností pole dovedností určuje, které dovednosti se mají provádět. Tři až pět dovedností jsou společné, ale podle limitů služeb můžete přidat tolik dovedností, kolik potřebujete.
Konečným výsledkem kanálu rozšiřování je textový obsah v indexu vyhledávání nebo ve znalostním úložišti. Z tohoto důvodu většina dovedností vytváří text z obrázků (text OCR, titulky, značky) nebo analyzuje existující text a vytváří nové informace (entity, klíčové fráze, mínění). Dovednosti, které fungují nezávisle, se zpracovávají paralelně. Dovednosti, které na sobě závisejí, určují výstup jedné dovednosti (například klíčové fráze) jako vstup druhé dovednosti (například překlad textu). Vyhledávací služba určuje pořadí provádění dovedností a spouštěcího prostředí.
Všechny dovednosti mají typ, kontext, vstupy a výstupy. Dovednost může mít volitelně název a popis. Následující příklad ukazuje dvě nesouvisející předdefinované dovednosti , abyste mohli porovnat základní strukturu.
"skills": [
    {
        "@odata.type": "#Microsoft.Skills.Text.V3.EntityRecognitionSkill",
        "name": "#1",
        "description": "This skill detects organizations in the source content",
        "context": "/document",
        "categories": [
            "Organization"
        ],
        "inputs": [
            {
                "name": "text",
                "source": "/document/content"
            }
        ],
        "outputs": [
            {
                "name": "organizations",
                "targetName": "orgs"
            }
        ]
    },
    {
        "name": "#2",
        "description": "This skill detects corporate logos in the source files",
        "@odata.type": "#Microsoft.Skills.Vision.ImageAnalysisSkill",
        "context": "/document/normalized_images/*",
        "visualFeatures": [
            "brands"
        ],
        "inputs": [
            {
                "name": "image",
                "source": "/document/normalized_images/*"
            }
        ],
        "outputs": [
            {
                "name": "brands"
            }
        ]
    }
]
Každá dovednost je jedinečná z hlediska vstupních hodnot a parametrů, které přebírá. Referenční dokumentace dovedností popisuje všechny parametry a vlastnosti dané dovednosti. I když existují rozdíly, většina dovedností sdílí společnou sadu a podobně se vzoruje.
Note
Pomocí podmíněné kognitivní dovednosti můžete vytvářet složité sady dovedností pomocí smyček a větvení a vytvářet výrazy. Syntaxe je založená na zápisu cesty ukazatele JSON s několika úpravami pro identifikaci uzlů ve stromu rozšiřování.
"/" prochází úrovní nižší ve stromu a "*" funguje jako operátor pro každou položku v kontextu. Syntaxi ilustruje celá řada příkladů v tomto článku.
Nastavení kontextu dovedností
Každá dovednost má kontextovou vlastnost , která určuje úroveň, na které se provoz provádí.
context Pokud vlastnost není explicitně nastavená, výchozí hodnota je "/document", kde kontext je celý dokument (dovednost se volá jednou pro každý dokument).
"skills":[
  {
    "@odata.type": "#Microsoft.Skills.Text.V3.EntityRecognitionSkill",
    "context": "/document",
    "inputs": [],
    "outputs": []
  },
  {
      "@odata.type": "#Microsoft.Skills.Vision.ImageAnalysisSkill",
      "context": "/document/normalized_images/*",
      "visualFeatures": [],
      "inputs": [],
      "outputs": []
  }
]
context Nastavte vlastnost na jeden z následujících příkladů:
| Příklad kontextu | Description |
|---|---|
context: /document |
(Výchozí) Vstupy a výstupy jsou na úrovni dokumentu. |
context: /document/pages/* |
Některé dovednosti, jako je analýza mínění, fungují lépe než menší bloky textu. Pokud rozdělujete velké pole obsahu na stránky nebo věty, měl by být kontext přes každou část komponenty. |
context: /document/normalized_images/* |
U obsahu obrázku je pro každý obrázek v nadřazeném dokumentu jeden vstup a jeden výstup. |
Kontext také určuje, kde se výstupy vytvářejí ve stromu zpracování. Například dovednost Rozpoznávání entit vrací vlastnost s názvem organizations, zachycena jako orgs. Pokud je kontext "/document", uzel organizations je přidán jako podřízený prvek "/document". Pokud pak chcete odkazovat na tento uzel v podřízených dovednostech, cesta je "/document/orgs".
Definování vstupů
Práce s dovednostmi na rozšířeném dokumentu zahrnuje čtení a zápis. Vstupy dovedností určují původ příchozích dat. Často se jedná o kořenový uzel obohaceného dokumentu. U objektů blob je typickým vstupem dovednosti parametr obsahu dokumentu.
Referenční dokumentace ke dovednostem pro každou dovednost popisuje vstupy, které může využívat. Každý vstup má name, který identifikuje specifický vstup, a source, který určuje umístění dat v rozšířeném dokumentu. Následující příklad pochází z dovednosti Rozpoznávání entit:
"inputs": [
    {
        "name": "text",
        "source": "/document/content"
    },
    {
        "name": "languageCode",
        "source": "/document/language"
    }
]
Dovednosti můžou mít více vstupů. Jedná se
nameo konkrétní vstup. Pro rozpoznávání entit jsou konkrétní vstupy text a languageCode.Vlastnost
sourceurčuje, které pole nebo řádek poskytují obsah, který se má zpracovat. Pro textové dovednosti je zdrojem pole v dokumentu nebo řádku, které poskytuje text. V případě dovedností založených na obrazech je uzel, který poskytuje vstup, normalizované obrázky.Příklad zdroje Description source:/documentPro tabulkovou datovou sadu představuje dokument řádek. source:/document/contentU objektů blob je zdrojem obvykle vlastnost obsahu. source:/document/some-named-fieldPro textové dovednosti, jako je rozpoznávání entit nebo extrakce klíčových frází, by měl být původ pole, které obsahuje dostatečný text k analýze, například popis nebo souhrn. source:/document/normalized_images/*Pro obsah obrázku je zdrojem obrázek, který byl normalizován během zpracování dokumentu.
Pokud dovednost prochází polem, měl by kontext i vstupní zdroj obsahovat /* na správných pozicích. Další informace o úplné syntaxi najdete v tématu Kontext dovedností a jazyk pro zadávání poznámek.
Definování výstupů
Každá dovednost je navržená tak, aby vygenerovávala konkrétní druhy výstupu, na které sada dovedností odkazuje podle názvu. Výstup dovednosti má name a volitelný targetName.
Referenční dokumentace ke dovednostem pro každou dovednost popisuje výstupy, které může vytvořit. Následující příklad pochází z dovednosti Rozpoznávání entit:
"outputs": [
    {
        "name": "persons",
        "targetName": "people"
    },
    {
        "name": "organizations",
        "targetName": "orgs"
    },
    {
        "name": "locations",
        "targetName": "places"
    }
]
Dovednosti můžou mít více výstupů. Vlastnost
nameidentifikuje konkrétní výstup. Výstupem pro rozpoznávání entit mohou být například osoby, místa, organizace, mimo jiné.Vlastnost
targetNameurčuje název, který má tento uzel mít v rozšířeném dokumentu. Tato vlastnost je užitečná, pokud výstupy dovedností mají stejný název. Pokud máte více dovedností, které vracejí stejný výstup, použijtetargetNamepro objasnění v cestách uzlů obohacení. Pokud nezadáte cílový název, použije se vlastnost name pro obojí.
V některých situacích je potřeba odkazovat na každý prvek pole samostatně. Předpokládejme například, že chcete předat každý prvek"/document/orgs" samostatně jiné dovednosti. Uděláte to tak, že do cesty přidáte hvězdičku: "/document/orgs/*".
Výstup dovednosti se zapíše do rozšířeného dokumentu jako nový uzel ve stromu rozšiřování. Může to být jednoduchá hodnota, například skóre mínění nebo kód jazyka. Může to být také kolekce, například seznam organizací, lidí nebo umístění. Výstup dovednosti je také složitou strukturou, stejně jako u dovednosti Shaper. Vstupy dovednosti určují složení obrazce, ale výstup je pojmenovaný objekt, na který lze odkazovat v indexu vyhledávání, projekci úložiště znalostí nebo jiné dovednosti podle názvu.
Přidání vlastní dovednosti
Tato část obsahuje příklad vlastní dovednosti. Identifikátor URI odkazuje na funkci Azure Functions, která zase vyvolá model nebo transformaci, kterou zadáte. Další informace najdete v tématu Přidání vlastní dovednosti do potrubí pro obohacení služby Azure AI Vyhledávač.
Ačkoli vlastní dovednost provádí kód, který je externí vůči kanálu, v poli dovedností je to jen další dovednost. Podobně jako předdefinované dovednosti má typ, kontext, vstupy a výstupy. Také čte a zapisuje do stromu obohacení, stejně jako vestavěné dovednosti. Všimněte si, že pole context je nastaveno na "/document/orgs/*" s hvězdičkou, což znamená, že krok rozšiřování se volá pro každou organizaci v rámci "/document/orgs".
Výstup, například popis společnosti v tomto příkladu, se vygeneruje pro identifikovanou organizaci. Pokud odkazujete na uzel v podřízeném kroku (například v extrakci klíčových frází), použijte k tomu cestu "/document/orgs/*/companyDescription" .
{
  "@odata.type": "#Microsoft.Skills.Custom.WebApiSkill",
  "description": "This skill calls an Azure function, which in turn calls custom code",
  "uri": "https://indexer-e2e-webskill.azurewebsites.net/api/InvokeCode?code=<YOUR-FUNCTION-KEY>",
  "httpHeaders": {
      "Ocp-Apim-Subscription-Key": "<YOUR-APIM-KEY>"
  },
  "context": "/document/orgs/*",
  "inputs": [
    {
      "name": "query",
      "source": "/document/orgs/*"
    }
  ],
  "outputs": [
    {
      "name": "description",
      "targetName": "companyDescription"
    }
  ]
}
Odeslání výstupu do cíle
I když můžete volitelně ukládat výstup dovednosti do mezipaměti pro opakované použití, je obvykle dočasný a existuje pouze v době, kdy probíhá provádění dovedností.
Pokud chcete odeslat výstup do pole v indexu vyhledávání, vytvořte v indexeru mapování výstupního pole.
Pokud chcete odeslat výstup do úložiště znalostí, vytvořte projekci.
Pokud chcete odeslat výstup do podřízené dovednosti, odkazujte na výstup podle názvu uzlu, například
"/document/organization", ve vstupní vlastnosti zdroje podřízené dovednosti. Příklady najdete v tématu Odkazování na poznámku .
Tipy pro první sadu dovedností
Zkuste průvodce importem dat.
Průvodce automatizuje několik kroků, které mohou při první zkušenosti být náročné. Definuje sadu dovedností, index a indexer, včetně mapování polí a mapování výstupních polí. Definuje také projekce v úložišti znalostí, pokud ho používáte. Pro některé dovednosti, jako je OCR nebo analýza obrázků, průvodce přidá pomocné dovednosti, které sloučí obrázek a textový obsah, který byl oddělen během prolomení dokumentu.
Po spuštění průvodce můžete každý objekt otevřít na webu Azure Portal a zobrazit jeho definici JSON.
Vyzkoušejte ladicí relace k vyvolání spuštění sady dovedností na cílovém dokumentu a k prohlédnutí obohaceného dokumentu, který tato sada dovedností vytvoří. Můžete zobrazit a upravit vstupní a výstupní nastavení a hodnoty. Tento kurz je dobrým místem, kde začít: Kurz: Ladění sady dovedností pomocí ladicích relací.
Další krok
Kontextová a vstupní zdrojová pole jsou cesty k uzlům ve stromu rozšiřování. Dalším krokem je dozvědět se více o syntaxi cesty pro uzly ve stromu obohacení.