Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Note
Azure AI Vyhledávač je k dispozici prostřednictvím portálu Azure, rozhraní REST API a Sady Azure SDK. Podporuje také Foundry IQ, spravovanou znalostní vrstvu, která transformuje podnikový obsah na opakovaně použitelné znalostní báze s podporou oprávnění pro agenty na portálu Microsoft Foundry.
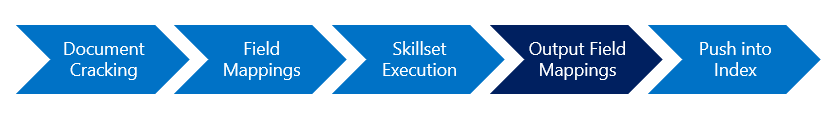
Tento článek vysvětluje, jak nastavit mapování výstupních polí, která definují cestu k datům v paměti vygenerovaným během zpracování sady dovedností a cílových polí v indexu vyhledávání. Během provádění indexeru existují informace generované dovednostmi pouze v paměti. Chcete-li tyto informace zachovat v indexu vyhledávání, musíte indexeru sdělit, kam se mají data odesílat.
Mapování výstupního pole je definováno v indexeru a má následující prvky:
"outputFieldMappings": [
  {
    "sourceFieldName": "document/path-to-a-node-in-an-enriched-document",
    "targetFieldName": "some-search-field-in-an-index",
    "mappingFunction": null
  }
],
Na rozdíl od definice fieldMappings, která mapuje cestu mezi původními zdrojovými poli a poli indexu, definice outputFieldMappings mapuje obohacení v paměti na pole ve vyhledávacím indexu.
Požadavky
Indexer, index, zdroj dat a soubor dovedností.
Pole indexu musí být jednoduchá nebo nejvyšší úrovně pole. Do komplexního typu nejde vypsat výstup. Pokud ale máte složitý typ, můžete pomocí definice výstupního pole zploštět části komplexního typu a odeslat je do kolekce v indexu vyhledávání.
Kdy použít mapování výstupního pole
Mapování výstupních polí se vyžaduje, pokud má váš indexer připojenou sadu dovedností, která vytvoří nové informace, které chcete mít v indexu. Příkladem může být:
- Vektory z vkládání dovedností
- Dovednosti optického rozpoznávání znaků (OCR) textu z obrázků.
- Lokality, organizace nebo osoby z dovedností rozpoznávání entit
Mapování výstupních polí lze použít také k:
Vytvořte více kopií svého generovaného obsahu (jedno k mnoha mapování výstupních polí).
Zploštěte složený typ zdrojového dokumentu. Předpokládejme například, že zdrojové dokumenty mají komplexní typ, například adresu s více částmi, a chcete jenom město. Pomocí mapování výstupního pole můžete zploštět vnořenou datovou strukturu a pak pomocí mapování výstupního pole odeslat výstup do kolekce řetězců ve vyhledávacím indexu.
Mapování výstupních polí platí jenom pro indexy vyhledávání. Pokud naplňujete úložiště znalostí, použijte projekce pro konfiguraci cesty k datům .
Definování mapování výstupních polí
Mapování výstupních polí jsou přidávána do pole outputFieldMappings v definici indexeru, obvykle se umisťují za pole fieldMappings. Mapování výstupního pole se skládá ze tří částí.
K definování mapování výstupních polí můžete použít rozhraní REST API nebo sadu Azure SDK.
Tip
Indexery vytvořené průvodcem importem dat zahrnují mapování výstupních polí vygenerovaných průvodcem. Pokud potřebujete příklady, spusťte průvodce přes zdroj dat a zobrazte mapování výstupních polí v indexeru.
Použijte Create Indexer, Create or Update Indexer nebo ekvivalentní metodu v Azure SDK. Tady je příklad definice indexeru.
{
   "name": "myindexer",
   "description": null,
   "dataSourceName": "mydatasource",
   "targetIndexName": "myindex",
   "schedule": { },
   "parameters": { },
   "fieldMappings": [],
   "outputFieldMappings": [],
   "disabled": false,
   "encryptionKey": { }
 }
Vyplňte
outputFieldMappingspole a určete mapování. Mapování polí se skládá ze tří částí."outputFieldMappings": [ { "sourceFieldName": "/document/path-to-a-node-in-an-enriched-document", "targetFieldName": "some-search-field-in-an-index", "mappingFunction": null } ]
| Vlastnost | Popis |
|---|---|
| názevPoleZdroj | Povinný Určuje cestu k rozšířenému obsahu. Příkladem může být /document/content. Informace o syntaxi a příkladech obohacení referencí najdete v sadě dovedností Azure AI Vyhledávač. |
| názevCílovéhoPole | Nepovinné. Určuje vyhledávací pole, které přijímá obohacený obsah. Cílová pole musí být jednoduchá pole nejvyšší úrovně nebo kolekce. Nemůže to být cesta k dílčímu poli v komplexním typu. Pokud chcete načíst konkrétní uzly ve složité struktuře, můžete zploštět jednotlivé uzly v paměti a pak odeslat výstup do kolekce řetězců v indexu. |
| mapovací funkce | Nepovinné. Přidá dodatečné zpracování poskytované funkcemi mapování podporovanými indexery. Pro uzly rozšiřování jsou nejčastěji používané funkce kódování a dekódování. |
Vždy
targetFieldNamese jedná o název pole v indexu vyhledávání.Jedná se
sourceFieldNameo cestu k uzlu v rozšířeném dokumentu. Je to výstup dovednosti. Cesta vždy začíná /document a pokud indexujete z objektu blob, druhý prvek cesty je /content. Třetí prvek je hodnota vytvořená dovedností. Další informace a příklady najdete v tématu Referenční obohacení v sestavě dovedností Azure AI Vyhledávač.Tento příklad přidá entity a popisky mínění extrahované z vlastnosti obsahu objektu blob do polí v indexu vyhledávání.
{
    "name": "myIndexer",
    "dataSourceName": "myDataSource",
    "targetIndexName": "myIndex",
    "skillsetName": "myFirstSkillSet",
    "fieldMappings": [],
    "outputFieldMappings": [
        {
            "sourceFieldName": "/document/content/organizations/*/description",
            "targetFieldName": "descriptions",
            "mappingFunction": {
                "name": "base64Decode"
            }
        },
        {
            "sourceFieldName": "/document/content/organizations",
            "targetFieldName": "orgNames"
        },
        {
            "sourceFieldName": "/document/content/sentiment",
            "targetFieldName": "sentiment"
        }
    ]
}
Před uložením do indexu přiřaďte všechny funkce mapování potřebné k transformaci obsahu pole. Pro uzly rozšiřování jsou nejčastěji používané funkce kódování a dekódování.
Mapování výstupních polí 1:N
Pomocí mapování výstupního pole můžete směrovat jedno zdrojové pole do více polí v indexu vyhledávání. Můžete to udělat pro srovnávací testování nebo pokud chcete pole s různými atributy.
Předpokládejme sadu dovedností, která generuje vkládání pro vektorové pole a index s více vektorovými poli, která se liší podle algoritmu a nastavení komprese. V indexeru namapujte výstup dovednosti vkládání na každé z více vektorových polí v indexu vyhledávání.
"outputFieldMappings": [
    { "sourceFieldName" : "/document/content/text_vector", "targetFieldName" : "vector_hnsw" },
    { "sourceFieldName" : "/document/content/text_vector", "targetFieldName" : "vector_eknn" },
    { "sourceFieldName" : "/document/content/text_vector", "targetFieldName" : "vector_narrow" },
    { "sourceFieldName" : "/document/content/text_vector", "targetFieldName" : "vector_no_stored" },
    { "sourceFieldName" : "/document/content/text_vector", "targetFieldName" : "vector_scalar" }
  ]
Cesta zdrojového pole je výstup schopnosti. V tomto příkladu je výstupem text_vector. Cílový název je volitelná vlastnost. Pokud nedáte mapování výstupu cílové jméno, cesta by byla embedding nebo přesněji, /document/content/embedding.
{
  "name": "test-vector-size-ss",
  "description": "Generate embeddings using Azure OpenAI in Foundry Models",
  "skills": [
    {
      "@odata.type": "#Microsoft.Skills.Text.AzureOpenAIEmbeddingSkill",
      "name": "#1",
      "description": null,
      "context": "/document/content",
      "resourceUri": "https://my-demo-eastus.openai.azure.com",
      "apiKey": null,
      "deploymentId": "text-embedding-ada-002",
      "dimensions": 1536,
      "modelName": "text-embedding-ada-002",
      "inputs": [
        {
          "name": "text",
          "source": "/document/content"
        }
      ],
      "outputs": [
        {
          "name": "embedding",
          "targetName": "text_vector"
        }
      ],
      "authIdentity": null
    }
  ]
}
Převést složité struktury na kolekci řetězců
Pokud se zdrojová data skládají z vnořeného nebo hierarchického FORMÁTU JSON, nemůžete k nastavení datových cest použít mapování polí. Místo toho musí index vyhledávání zrcadlit strukturu zdrojových dat pro každou úroveň pro úplný import.
Tato část vás provede procesem importu, který vytvoří jednoznačné zobrazení komplexního dokumentu na straně zdroje i cíle. Dále používá stejný zdrojový dokument k ukázce načítání a rozvinutí jednotlivých uzlů do kolekcí řetězců.
Tady je příklad dokumentu ve službě Azure Cosmos DB s vnořeným kódem JSON:
{
   "palette":"primary colors",
   "colors":[
      {
         "name":"blue",
         "medium":[
            "acrylic",
            "oil",
            "pastel"
         ]
      },
      {
         "name":"red",
         "medium":[
            "acrylic",
            "pastel",
            "watercolor"
         ]
      },
      {
         "name":"yellow",
         "medium":[
            "acrylic",
            "watercolor"
         ]
      }
   ]
}
Pokud byste chtěli tento zdrojový dokument plně indexovat, vytvořili byste definici indexu, ve které se názvy polí, úrovně a typy projeví jako složitý typ. Protože mapování polí nejsou podporována pro komplexní typy v indexu vyhledávání, definice indexu musí zrcadlit zdrojový dokument.
{
  "name": "my-test-index",
  "defaultScoringProfile": "",
  "fields": [
    { "name": "id", "type": "Edm.String", "searchable": false, "retrievable": true, "key": true},
    { "name": "palette", "type": "Edm.String", "searchable": true, "retrievable": true },
    { "name": "colors", "type": "Collection(Edm.ComplexType)",
      "fields": [
        {
          "name": "name",
          "type": "Edm.String",
          "searchable": true,
          "retrievable": true
        },
        {
          "name": "medium",
          "type": "Collection(Edm.String)",
          "searchable": true,
          "retrievable": true,
        }
      ]
    }
  ]
}
Tady je ukázková definice indexeru, která provede import. Všimněte si, že neexistují žádná mapování polí ani žádná sada dovedností.
{
  "name": "my-test-indexer",
  "dataSourceName": "my-test-ds",
  "skillsetName": null,
  "targetIndexName": "my-test-index",

  "fieldMappings": [],
  "outputFieldMappings": []
}
Výsledkem je následující ukázkový vyhledávací dokument podobný původnímu dokumentu ve službě Azure Cosmos DB.
{
  "value": [
    {
      "@search.score": 1,
      "id": "11bb11bb-cc22-dd33-ee44-55ff55ff55ff",
      "palette": "primary colors",
      "colors": [
        {
          "name": "blue",
          "medium": [
            "acrylic",
            "oil",
            "pastel"
          ]
        },
        {
          "name": "red",
          "medium": [
            "acrylic",
            "pastel",
            "watercolor"
          ]
        },
        {
          "name": "yellow",
          "medium": [
            "acrylic",
            "watercolor"
          ]
        }
      ]
    }
  ]
}
Alternativní vykreslení v indexu vyhledávání spočívá v transformaci jednotlivých uzlů ze zdrojové vnořené struktury na kolekci řetězců v indexu vyhledávání.
K provedení tohoto úkolu budete potřebovat outputFieldMappings, který mapuje uzel v paměti na kolekci řetězců v indexu. I když mapování výstupních polí primárně platí pro výstupy dovedností, můžete je také použít k adresování uzlů po prolomení dokumentu, kde indexer otevře zdrojový dokument a přečte ho do paměti.
Následující ukázková definice indexu používá kolekce řetězců k příjmu zploštěného výstupu:
{
  "name": "my-new-flattened-index",
  "defaultScoringProfile": "",
  "fields": [
    { "name": "id", "type": "Edm.String", "searchable": false, "retrievable": true, "key": true },
    { "name": "palette", "type": "Edm.String", "searchable": true, "retrievable": true },
    { "name": "color_names", "type": "Collection(Edm.String)", "searchable": true, "retrievable": true },
    { "name": "color_mediums", "type": "Collection(Edm.String)", "searchable": true, "retrievable": true}
  ]
}
Tady je ukázková definice indexeru, která používá outputFieldMappings k přidružení vnořeného JSON k polím kolekce řetězců. Zdrojové pole používá pro uzly rozšíření syntaxi cest, i když není definovaná žádná sada dovedností. Rozšířené dokumenty jsou vytvořeny v systému během rozbíjení dokumentu, což znamená, že můžete přistupovat k uzlům v každém stromu dokumentu, pokud tyto uzly existují, když je dokument rozbit.
{
  "name": "my-test-indexer",
  "dataSourceName": "my-test-ds",
  "skillsetName": null,
  "targetIndexName": "my-new-flattened-index",
  "parameters": {  },
  "fieldMappings": [   ],
  "outputFieldMappings": [
    {
       "sourceFieldName": "/document/colors/*/name",
       "targetFieldName": "color_names"
    },
    {
       "sourceFieldName": "/document/colors/*/medium",
       "targetFieldName": "color_mediums"
    }
  ]
}
Výsledky z definice jsou následující. Zjednodušení struktury v tomto případě ztratí kontext. Mezi danou barvou a médium, ve které je dostupná, už neexistují žádná přidružení. V závislosti na vašem scénáři ale může být výsledek podobný následujícímu příkladu přesně to, co potřebujete.
{
  "value": [
    {
      "@search.score": 1,
      "id": "11bb11bb-cc22-dd33-ee44-55ff55ff55ff",
      "palette": "primary colors",
      "color_names": [
        "blue",
        "red",
        "yellow"
      ],
      "color_mediums": [
        "[\"acrylic\",\"oil\",\"pastel\"]",
        "[\"acrylic\",\"pastel\",\"watercolor\"]",
        "[\"acrylic\",\"watercolor\"]"
      ]
    }
  ]
}