Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Note
Azure AI Vyhledávač je k dispozici prostřednictvím portálu Azure, rozhraní REST API a Sady Azure SDK. Podporuje také Foundry IQ, spravovanou znalostní vrstvu, která transformuje podnikový obsah na opakovaně použitelné znalostní báze s podporou oprávnění pro agenty na portálu Microsoft Foundry.
Note
Úložiště znalostí jsou sekundární úložiště, které existuje ve službě Azure Storage a obsahuje výstupy sad dovedností Azure AI Vyhledávač. Jsou oddělené od zdrojů znalostí a znalostních bází, které se používají při agenturním načítání.
Úložiště znalostí je sekundární úložiště pro obsah obohacený umělou inteligencí, vytvořený sadou schopností ve službě Azure AI Vyhledávač. Ve službě Azure AI Vyhledávač úloha indexování vždy odesílá výstup do indexu vyhledávání, ale pokud připojíte sadu dovedností k indexeru, můžete volitelně také odeslat výstup obohacený o AI do kontejneru nebo tabulky ve službě Azure Storage. Úložiště znalostí lze použít k nezávislé analýze nebo zpracování v podřízených scénářích, jako je dolování znalostí.
Dva výstupy indexování, index vyhledávání a úložiště znalostí, jsou navzájem výlučné produkty stejného zpracovatelského procesu. Jsou odvozeny ze stejných vstupů a obsahují stejná data, ale jejich obsah je strukturovaný, uložený a používaný v různých aplikacích.
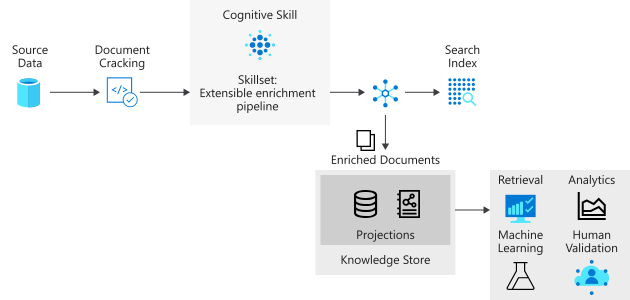
Úložiště znalostí je fyzicky v Azure Storage, a to v Azure Table Storage, Azure Blob Storage, nebo obojím. Jakýkoli nástroj nebo proces, který se může připojit ke službě Azure Storage, může využívat obsah úložiště znalostí. Azure AI Vyhledávač nepodporuje dotazy pro načítání obsahu z úložiště znalostí.
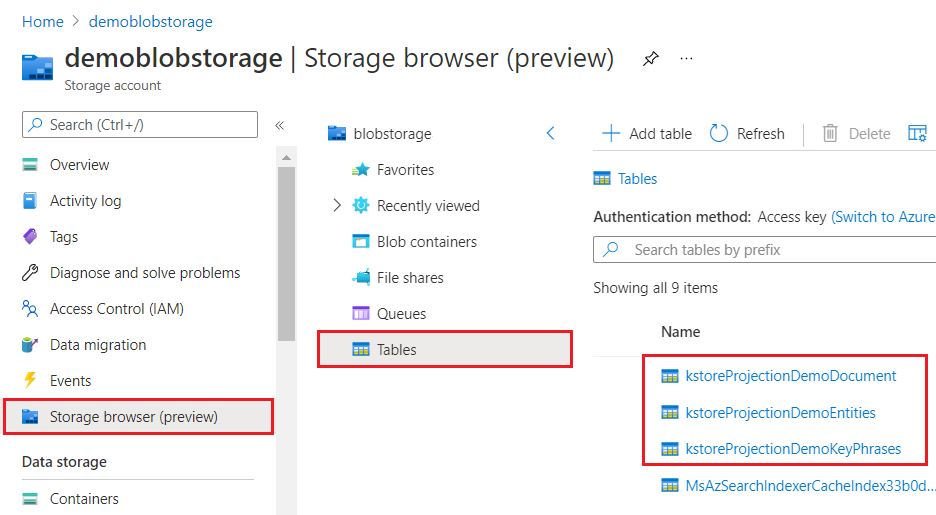
Při prohlížení prostřednictvím webu Azure Portal vypadá úložiště znalostí jako jakákoli jiná kolekce tabulek, objektů nebo souborů. Následující snímek obrazovky ukazuje úložiště znalostí složené ze tří tabulek. Můžete přijmout konvenci vytváření názvů, jako je předpona kstore , aby byl obsah pohromadě.
Výhody úložiště znalostí
Hlavními výhodami úložiště znalostí jsou dvounásobný: flexibilní přístup k obsahu a schopnost tvarovat data.
Na rozdíl od indexu vyhledávání, ke kterému je možné přistupovat pouze prostřednictvím dotazů ve službě Azure AI Vyhledávač, je úložiště znalostí přístupné pro jakýkoli nástroj, aplikaci nebo proces, který podporuje připojení ke službě Azure Storage. Tato flexibilita otevírá nové scénáře pro využívání analyzovaného a rozšířeného obsahu vytvořeného kanálem rozšiřování.
Stejnou sadu dovedností, která rozšiřuje data, lze také použít k tvarování dat. Některé nástroje, jako je Power BI, fungují lépe s tabulkami, zatímco úloha datových věd může vyžadovat složitou datovou strukturu ve formátu objektu blob. Přidání dovednosti Shaper do sady dovedností vám dává kontrolu nad tvarem dat. Tyto obrazce pak můžete předat projekcím, ať už tabulkám nebo objektům blob, a vytvořit tak fyzické datové struktury, které odpovídají zamýšlenému použití dat.
Následující video vysvětluje jak tyto výhody, tak i další.
Definice úložiště znalostí
Úložiště znalostí je definováno v definici sady dovedností a má dvě komponenty:
Připojovací řetězec do Azure Storage
Projekce, které určují, jestli se úložiště znalostí skládá z tabulek, objektů nebo souborů. Prvek projekce je pole. V jednom úložišti znalostí můžete vytvořit více sad kombinací tabulek-objektů-souborů.
"knowledgeStore": {
    "storageConnectionString":"<YOUR-AZURE-STORAGE-ACCOUNT-CONNECTION-STRING>",
    "projections":[
       {
          "tables":[ ],
          "objects":[ ],
          "files":[ ]
       }
    ]
}
Typ projekce, kterou zadáte v této struktuře, určuje typ úložiště používaného úložištěm znalostí, ale ne jeho strukturu. Pole v tabulkách, objektech a souborech jsou určena výstupem dovednosti Shaper, pokud vytváříte úložiště znalostí prostřednictvím kódu programu, nebo průvodcem importem dat , pokud používáte Azure Portal.
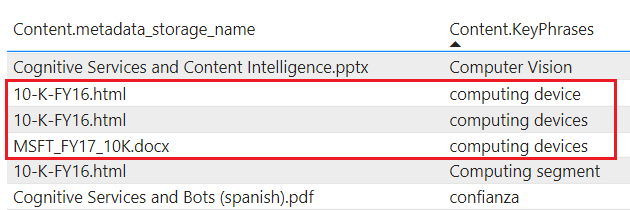
tablesrozšíření obsahu projektu do služby Table Storage Definujte projekci tabulky, pokud potřebujete tabulkové struktury generování sestav pro vstupy analytickým nástrojům nebo exportovat jako datové rámce do jiných úložišť dat. Pokud chcete získat podmnožinu nebo průřez obohacených dokumentů, můžete zadat vícetablesve stejné skupině projekce. Ve stejné skupině projekcí jsou relace mezi tabulkami zachovány, abyste s nimi mohli pracovat.Projektovaný obsah není agregovaný ani normalizovaný. Následující snímek obrazovky ukazuje tabulku seřazenou podle klíčové fráze s nadřazeným dokumentem označeným v sousedním sloupci. Na rozdíl od příjmu dat během indexování neexistuje žádná lingvistická analýza ani agregace obsahu. Tvary a rozdíly v množném čísle jsou považovány za jedinečné instance.
objectsprojekt dokumentu JSON do úložiště Blob. Fyzická reprezentaceobjectje hierarchická struktura JSON, která představuje obohacený dokument.filesprojektové obrazové soubory do úložiště Blob. Afileje obrázek extrahovaný z dokumentu, přenesený beze změny do úložiště Blob. I když se jmenuje "files", zobrazuje se ve službě Blob Storage, nikoli v úložišti souborů.
Vytvoření úložiště znalostí
K vytvoření úložiště znalostí použijte Azure Portal, rozhraní REST API nebo balíček sady Azure SDK. Všechny metody vyžadují Azure Storage, sadu dovedností a indexer. Protože indexery vyžadují index vyhledávání, musíte také zadat definici indexu.
Rozhraní REST API a sady SDK poskytují úplnou kontrolu nad projekcemi: tabulky, objekty a soubory. Azure Portal vytvoří úložiště znalostí automaticky jako součást vícemodálního pracovního postupu RAG, které je omezené na projekce souborů pro extrahované obrázky.
Průvodce importem dat vytvoří znalostní databázi pouze pro multimodální scénář RAG. Pokud chcete začít, přečtěte si rychlý start: Vícemodální vyhledávání na webu Azure Portal.
Připojení s aplikacemi
Jakmile v úložišti existuje obohacený obsah, můžete k prozkoumání, analýze nebo využívání obsahu použít jakýkoli nástroj nebo technologie, které se připojují ke službě Azure Storage. Následující seznam představuje začátek:
Průzkumník služby Storage nebo prohlížeč úložiště v Azure portálu pro zobrazení rozšířené struktury a obsahu dokumentu. Zvažte to jako základní nástroj pro zobrazení obsahu úložiště znalostí.
Power BI pro vytváření sestav a analýzu
Azure Data Factory pro další manipulaci.
Životní cyklus obsahu
Při každém spuštění indexeru a sady dovedností se úložiště znalostí aktualizuje, pokud se sada dovedností nebo podkladová zdrojová data změnila. Všechny změny získané indexerem se šíří prostřednictvím procesu rozšiřování do projekcí v úložišti znalostí a zajišťují, aby data, která se promítají, představují aktuální reprezentaci obsahu ve zdrojovém zdroji dat.
Note
I když můžete upravit data v projekcích, všechny úpravy se přepíšou při dalším vyvolání kanálu za předpokladu, že se dokument ve zdrojových datech aktualizuje.
Změny ve zdrojových datech
U zdrojů dat, které podporují sledování změn, indexer zpracuje nové a změněné dokumenty a vynechá stávající dokumenty, které už byly zpracovány. Informace o časovém razítku se liší podle zdroje dat, ale v kontejneru objektů blob se indexer podívá na lastmodified datum a určí, které objekty blob je potřeba ingestovat.
Změny sady dovedností
Pokud provádíte změny v sadě dovedností, měli byste povolit ukládání do mezipaměti obohacených dokumentů (Preview), abyste mohli opakovaně používat existující rozšiřování, pokud je to možné.
Bez přírůstkového ukládání do mezipaměti bude indexer vždy zpracovávat dokumenty v pořadí od vyznačeného bodu pokroku, bez návratu zpět. U objektů blob by indexer zpracovával objekty blob seřazené podle lastModified, bez ohledu na změny nastavení indexeru nebo sady dovedností. Pokud změníte sadu dovedností, dříve zpracované dokumenty se neaktualizují tak, aby odrážely novou sadu dovedností. Dokumenty zpracovávané po změně sady dovedností budou používat novou sadu dovedností, což vede k tomu, že dokumenty indexu jsou kombinací starých a nových sad dovedností.
S inkrementálním ukládáním do mezipaměti a po aktualizaci sady dovedností indexer znovu použije všechna obohacení, která nejsou změnou sady dovedností ovlivněna. Upstreamová obohacení se načítají z mezipaměti, stejně jako všechna obohacení, která jsou nezávislá a izolovaná od schopnosti, která byla změněna.
Deletions
I když indexer vytváří a aktualizuje struktury a obsah ve službě Azure Storage, neodstraní je. Projekce nadále existují, i když se indexer nebo sada dovedností odstraní. Jako vlastník účtu úložiště byste měli odstranit projekci, pokud už ji nepotřebujete.
Další kroky
Úložiště znalostí nabízí trvalost obohacených dokumentů, užitečné při navrhování sady dovedností nebo vytváření nových struktur a obsahu pro použití všemi klientskými aplikacemi, které mají přístup k účtu Azure Storage.
Nejjednodušším přístupem k vytváření obohacených dokumentů prostřednictvím kódu programu je rozhraní REST API.