Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Note
Azure AI Vyhledávač je k dispozici prostřednictvím portálu Azure, rozhraní REST API a Sady Azure SDK. Podporuje také Foundry IQ, spravovanou znalostní vrstvu, která transformuje podnikový obsah na opakovaně použitelné znalostní báze s podporou oprávnění pro agenty na portálu Microsoft Foundry.
Tento článek je určený pro vývojáře, kteří potřebují hlubší znalosti složení sady dovedností a předpokládají znalost základních konceptů rozšiřování AI nebo způsobu použití umělé inteligence ve službě Azure AI Vyhledávač k transformaci nezpracovaného obsahu během indexování.
Sada dovedností je opakovaně použitelný objekt ve službě Azure AI Vyhledávač, který je připojený k indexeru. Obsahuje jednu nebo více schopností, které volají vestavěnou AI nebo externí přizpůsobené zpracování nad nezpracovaným obsahem načteným z externího zdroje dat.
Následující diagram znázorňuje základní tok dat při provádění sady dovedností.
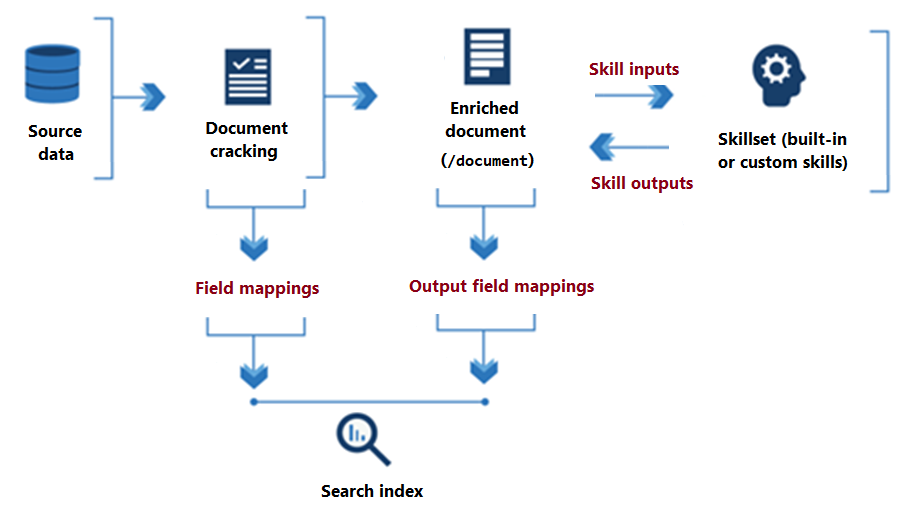
Od začátku zpracování schopností do svého závěru se dovednosti čtou a zapisují do *rozšířeného stromu dokumentů existujícího v paměti. Na začátku je obohacený dokument pouze nezpracovaný obsah extrahovaný ze zdroje dat (vyjádřený jako "/document" kořenový uzel). Při každém provádění dovedností získá obohacený dokument strukturu a látku, protože každá dovednost zapisuje svůj výstup jako uzly v grafu.
Po dokončení provádění sady dovedností se výstup rozšířeného dokumentu směruje do indexu prostřednictvím mapování výstupních polí definovaných uživatelem. Veškerý nezpracovaný obsah, který chcete přenést beze změny ze zdroje do indexu, je definován prostřednictvím mapování polí. Naproti tomu mapování výstupních polí přenáší obsah v paměti (uzly) do indexu.
Pokud chcete nakonfigurovat aplikovanou AI, zadejte nastavení v sadě dovedností a v indexeru.
Definice sady dovedností
Sada dovedností je pole jednoho nebo více dovedností , které provádějí rozšiřování, například překlad textu nebo optického rozpoznávání znaků (OCR) v souboru obrázku. Dovednosti můžou být integrované dovednosti od Microsoftu nebo vlastní dovednosti pro logiku zpracování, kterou hostujete externě. Sada dovedností vytváří rozšířené dokumenty, které se buď spotřebovávají během indexování, nebo se promítají do úložiště znalostí.
Dovednosti mají kontext, vstupy a výstupy:
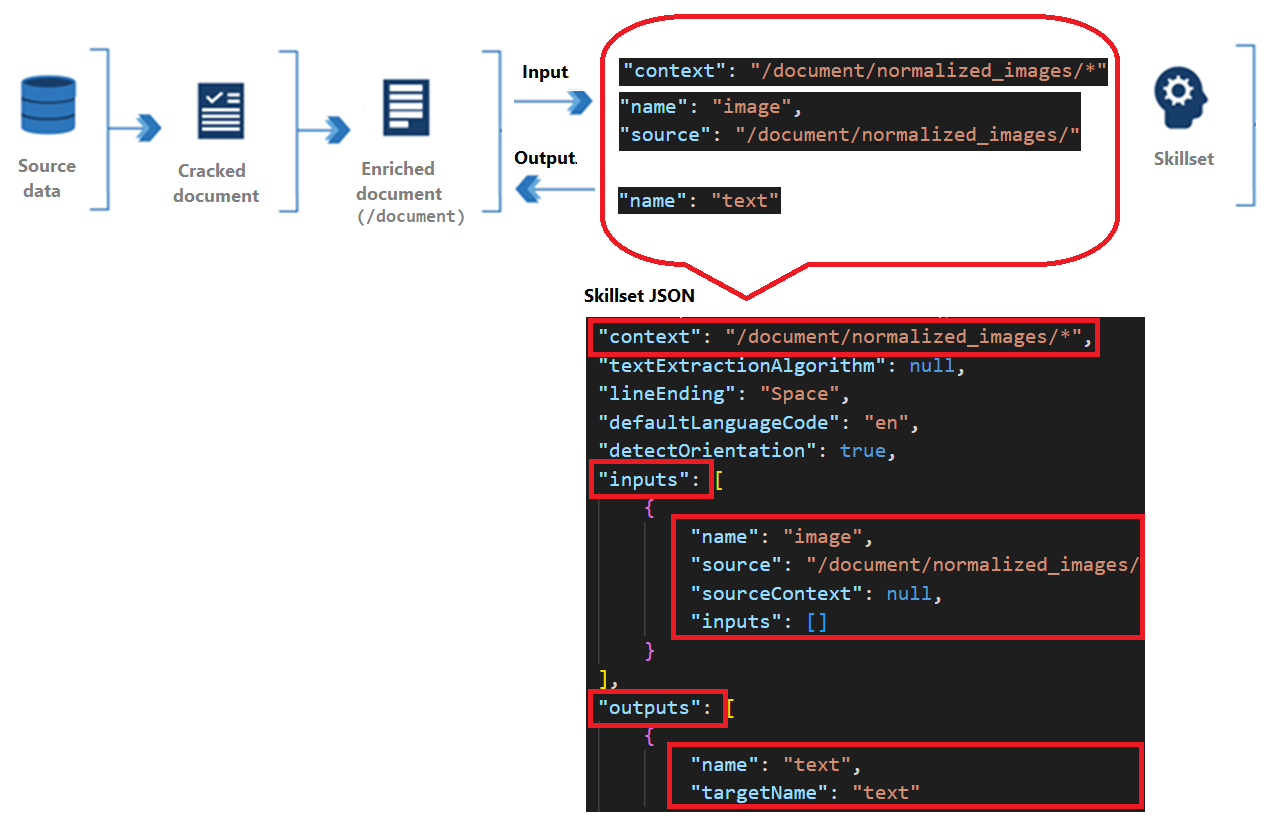
Kontext odkazuje na rozsah operace, který může být jednou pro každý dokument nebo jednou pro každou položku v kolekci.
Vstupy pocházejí z uzlů v rozšířeném dokumentu, kde "zdroj" a "název" identifikují daný uzel.
Výstup se odešle zpět do rozšířeného dokumentu jako nový uzel. Hodnoty jsou název uzlu a obsah uzlu. Pokud je název uzlu duplicitní, můžete nastavit cílový název pro nejednoznačnost.
Kontext dovedností
Každá dovednost má kontext, který může být celý dokument (/document) nebo uzel nižší ve stromu (/document/countries/*).
Kontext určuje:
Počet, kolikrát se dovednost provede při jedné hodnotě (jednou za pole, na dokument), nebo v případě kolekce, kde přidání
/*vyvolá dovednost pro každou instanci v kolekci.Deklarace výstupu nebo kde ve stromu obohacení jsou přidány výstupy dovedností. Výstupy se vždy přidají do stromu jako podřízené položky kontextového uzlu.
Tvar vstupů U víceúrovňových kolekcí má nastavení kontextu nadřazené kolekce vliv na tvar vstupu pro dovednost. Pokud máte například strom rozšiřování se seznamem zemí/oblastí, každý obohacený seznamem států obsahujících seznam PSČ, způsob nastavení kontextu určuje, jak se vstup interpretuje.
Context Input Tvar vstupu Vyvolání dovedností /document/countries/*/document/countries/*/states/*/zipcodes/*Seznam všech PSČ v zemi/oblasti Jednou za zemi nebo oblast /document/countries/*/states/*/document/countries/*/states/*/zipcodes/*Seznam PSČ ve státě Jednou za kombinaci země/oblasti a státu
Závislosti dovedností
Dovednosti se můžou spouštět nezávisle a paralelně nebo postupně v závislém vztahu, pokud dáte výstup jedné dovednosti do jiné dovednosti. Následující příklad ukazuje dvě předdefinované dovednosti , které se spouštějí postupně:
Dovednost č. 1 je dovednost rozdělení textu, která přijímá obsah zdrojového pole "reviews_text" jako vstup a rozdělí tento obsah na "stránky" o 5 000 znacích jako výstup. Rozdělení velkého textu na menší bloky může generovat lepší výsledky pro dovednosti, jako je detekce mínění.
Dovednost č. 2 je dovednost detekce sentimentu, která závisí na rozdělení výstupu dovednosti. Přijímá jako vstup "pages" a vytvoří jako výstup nové pole s názvem Sentiment (Mínění), které obsahuje výsledky analýzy mínění.
Všimněte si, jak se při analýze mínění používá výstup první dovednosti ("stránky"), kde "/document/reviews_text/pages/*" je kontext i vstup. Další informace o definování cesty viz Jak odkazovat na obohacení.
{
    "skills": [
        {
            "@odata.type": "#Microsoft.Skills.Text.SplitSkill",
            "name": "#1",
            "description": null,
            "context": "/document/reviews_text",
            "defaultLanguageCode": "en",
            "textSplitMode": "pages",
            "maximumPageLength": 5000,
            "inputs": [
                {
                    "name": "text",
                    "source": "/document/reviews_text"
                }
            ],
            "outputs": [
                {
                    "name": "textItems",
                    "targetName": "pages"
                }
            ]
        },
        {
            "@odata.type": "#Microsoft.Skills.Text.SentimentSkill",
            "name": "#2",
            "description": null,
            "context": "/document/reviews_text/pages/*",
            "defaultLanguageCode": "en",
            "inputs": [
                {
                    "name": "text",
                    "source": "/document/reviews_text/pages/*",
                }
            ],
            "outputs": [
                {
                    "name": "sentiment",
                    "targetName": "sentiment"
                },
                {
                    "name": "confidenceScores",
                    "targetName": "confidenceScores"
                },
                {
                    "name": "sentences",
                    "targetName": "sentences"
                }
            ]
        }
      . . .
  ]
}
Strom rozšiřování
Obohacený dokument je dočasná datová struktura podobná stromu vytvořená během provádění sady dovedností, která shromažďuje všechny změny zavedené prostřednictvím dovedností. Společně jsou rozšiřování reprezentována jako hierarchie adresovatelných uzlů. Uzly také obsahují všechna neobohacená pole, která jsou předávána bez úprav z externího zdroje dat. Nejlepší přístup ke zkoumání struktury a obsahu stromu rozšiřování je prostřednictvím ladicí relace na webu Azure Portal.
Obohacený dokument existuje po dobu trvání provádění sady dovedností, ale může být uložen v mezipaměti (Preview) nebo odeslán do úložiště znalostí.
Na začátku je obohacený dokument jednoduše obsah extrahovaný ze zdroje dat během rozkládání dokumentu, kde se text a obrázky extrahují ze zdroje a zpřístupní se pro jazykovou analýzu nebo analýzu obrázků.
Počáteční obsah je metadata a kořenový uzel (document/content). Kořenový uzel je obvykle celý dokument nebo normalizovaný obrázek, který se extrahuje ze zdroje dat během prolomení dokumentu. Způsob znázornění ve stromu obohacení se liší v závislosti na typu zdroje dat. Následující tabulka ukazuje stav dokumentu, který vstupuje do pipeline obohacení pro několik podporovaných zdrojů dat:
| Zdroj dat\Režim analýzy | Default | JSON, řádky JSON a CSV |
|---|---|---|
| Blob Storage | /document/content /document/normalized_images/* … |
/document/{key1} /document/{key2} … |
| Azure SQL | /document/{column1} /document/{column2} … |
N/A |
| Azure Cosmos DB | /document/{key1} /document/{key2} … |
N/A |
Při provádění dovedností se výstup přidá do stromu rozšiřování jako nové uzly. Pokud se provádění funkce vztahuje na celý dokument, uzly se přidají na první úrovni pod kořenem.
Uzly lze použít jako vstupy pro podřízené dovednosti. Například dovednosti, které vytvářejí obsah, jako jsou přeložené řetězce, se mohou stát vstupem pro dovednosti, které rozpoznávají entity nebo extrahují klíčové fráze.

I když můžete vizualizovat strom obohacení a pracovat s ním prostřednictvím vizuálního editoru Ladicí relace, je to většinou interní struktura.
Rozšiřování je neměnné: po vytvoření není možné uzly upravovat. Jakmile se vaše sady dovedností stanou komplexnějšími, tak se rozšíří i váš strom obohacení, ale ne všechny uzly v tomto stromu musí být zařazeny do indexu nebo úložiště znalostí.
Můžete selektivně zachovat jenom podmnožinu výstupů rozšiřování, abyste zachovali jenom to, co chcete použít. Mapování výstupních polí v definici indexeru určuje, jaký obsah se ve vyhledávacím indexu skutečně ingestuje. Podobně pokud vytváříte úložiště znalostí, můžete výstupy mapovat na obrazce , které jsou přiřazené k projekcím.
Note
Formát stromu rozšiřování umožňuje kanálu rozšiřování připojit metadata k i primitivním datovým typům. Metadata nebudou platným objektem JSON, ale dají se v definicích projekce v úložišti znalostí promítnou do platného formátu JSON. Další informace naleznete v Dovednost Shaper.
Definice indexeru
Indexer má vlastnosti a parametry používané ke konfiguraci provádění indexeru. Mezi tyto vlastnosti patří mapování, která nastavují cestu k datům do polí ve vyhledávacím indexu.
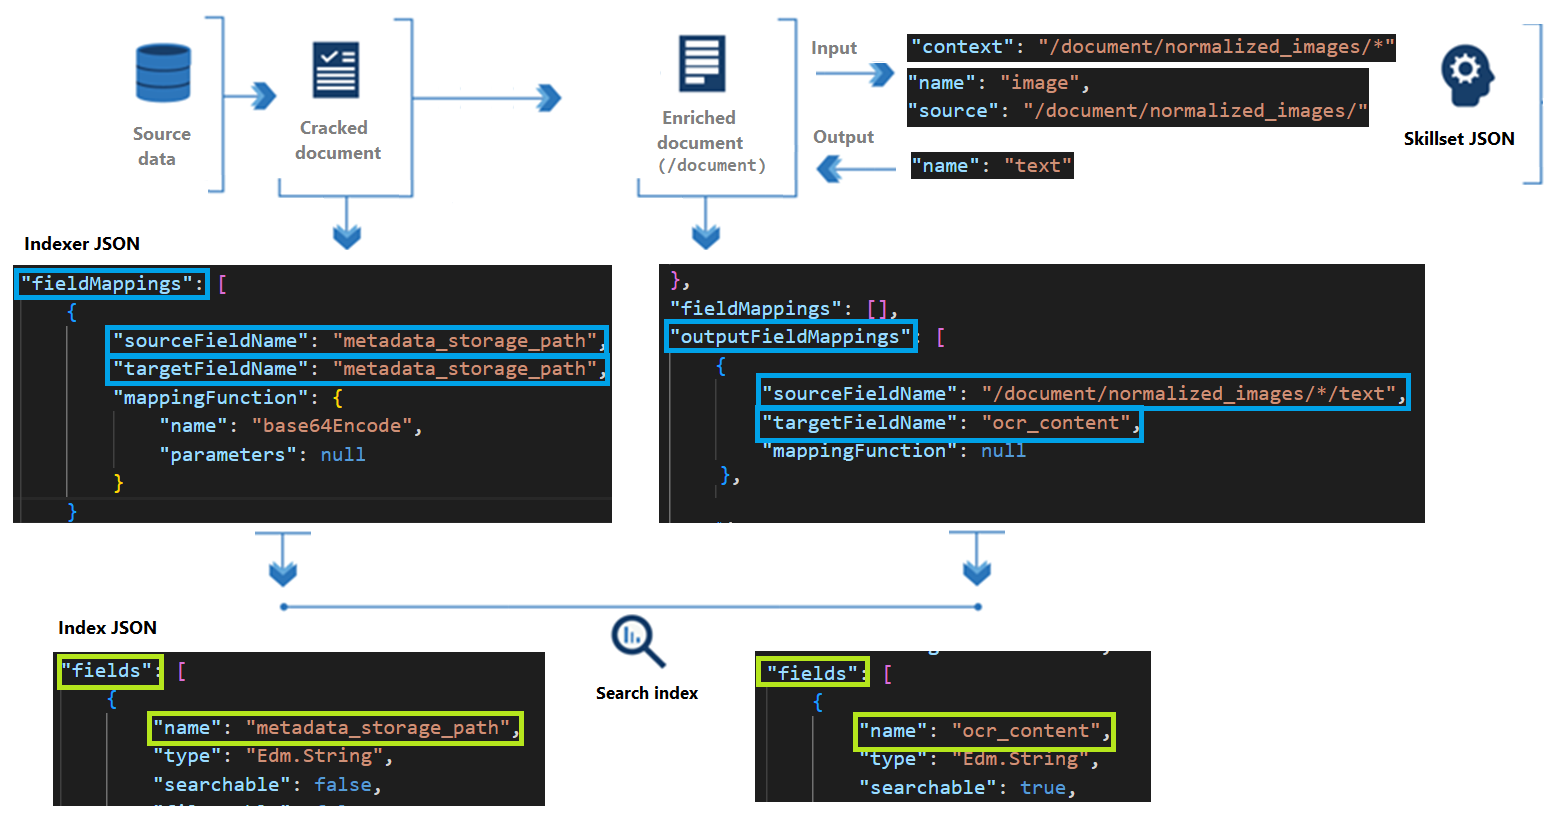
Existují dvě sady mapování:
"fieldMappings" mapuje zdrojové pole na vyhledávací pole.
OutputFieldMappings mapuje uzel v rozšířeném dokumentu na vyhledávací pole.
Vlastnost sourceFieldName určuje pole ve zdroji dat nebo uzel ve stromu rozšiřování. Vlastnost targetFieldName určuje vyhledávací pole v indexu, který přijímá obsah.
Příklad obohacení
Pomocí sady dovedností recenzí hotelů jako referenčního bodu tento příklad vysvětluje, jak se strom rozšiřování vyvíjí prostřednictvím provádění dovednostních úloh pomocí koncepčních diagramů.
Tento příklad také ukazuje:
- Jak funguje kontext a vstupy dovedností, abyste zjistili, kolikrát se dovednost provádí
- Jaký je tvar vstupu založený na kontextu
V tomto příkladu zdrojová pole ze souboru CSV obsahují recenze zákazníků o hotelech ("reviews_text") a hodnoceních ("reviews_rating"). Indexer přidá pole metadat z Blob úložiště a funkce přidají přeložený text, skóre sentimentu a detekci klíčových frází.
V příkladu hodnocení hotelů představuje "dokument" v rámci procesu rozšiřování jednu recenzi hotelu.
Tip
Index vyhledávání a úložiště znalostí pro tato data můžete vytvořit pomocí rozhraní REST API. Můžete také použít ladicí relace pro získání analyzovaného přehledu o složení dovedností, závislostech a efektech na strom obohacení. Obrázky v tomto článku se natahují z ladicích relací.
Koncepčně vypadá počáteční strom rozšiřování takto:

Kořenový uzel pro všechna obohacení je "/document". Při práci s indexery blobů má uzel podřízené uzly "/document" a "/document/content". Pokud jsou data CSV, jak je uvedeno v tomto příkladu, názvy sloupců se mapují na uzly pod "/document".
Dovednost č. 1: Dělená dovednost
Pokud se zdrojový obsah skládá z velkých bloků textu, je užitečné ho rozdělit na menší komponenty pro integrovanou vektorizaci nebo pro větší přesnost rozpoznávání jazyka, mínění a klíčových frází. K dispozici jsou dvě zrnka: stránky a věty. Stránka se skládá z přibližně 5 000 znaků.
Alternativou k rozdělování obsahu pomocí dovednosti Split je dovednost Azure Content Understanding, ale ta není předmětem tohoto článku.
Když je třeba rozdělit data, schopnost Split je obvykle první v rámci sady schopností.
"@odata.type": "#Microsoft.Skills.Text.SplitSkill",
"name": "#1",
"description": null,
"context": "/document/reviews_text",
"defaultLanguageCode": "en",
"textSplitMode": "pages",
"maximumPageLength": 5000,
"inputs": [
    {
        "name": "text",
        "source": "/document/reviews_text"
    }
],
"outputs": [
    {
        "name": "textItems",
        "targetName": "pages"
    }
]
V kontextu "/document/reviews_text" dovednosti se rozdělená dovednost provádí jednou pro reviews_text. Výstup dovednosti je seznam, ve kterém je reviews_text rozdělený do segmentů po 5 000 znacích. Výstup rozdělené dovednosti se pojmenuje pages a přidá se do stromu rozšiřování. Tato targetName funkce umožňuje přejmenovat výstup dovednosti před tím, než se přidá do stromu rozšiřování.
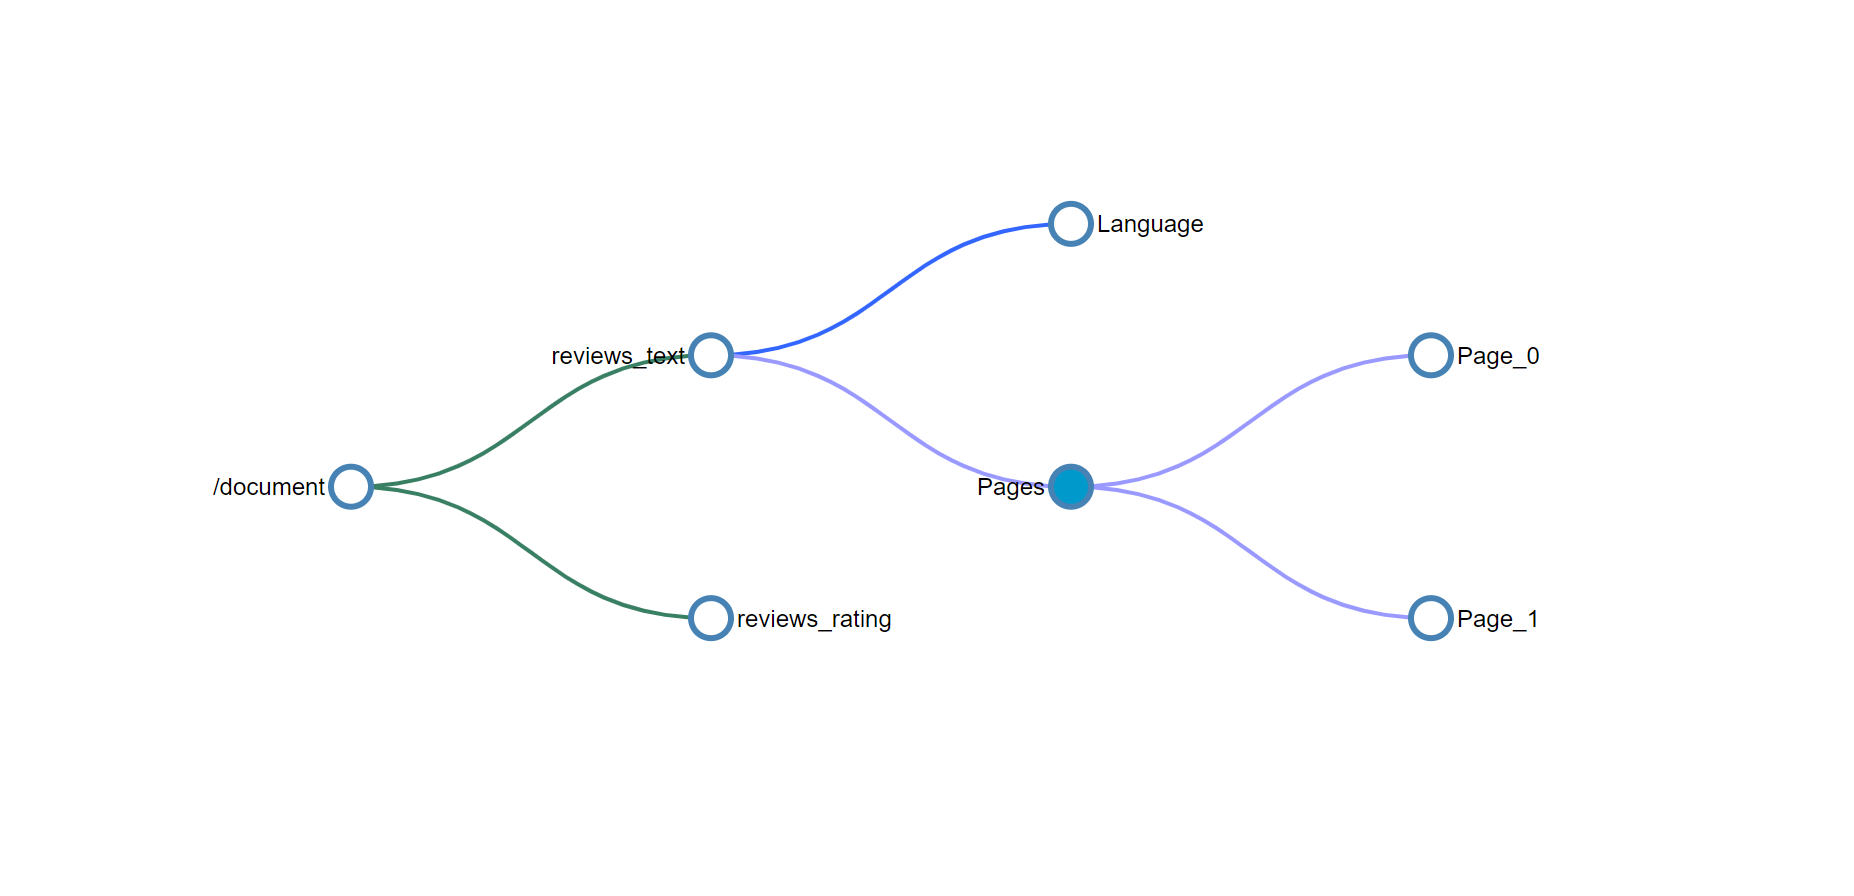
Strom obohacování má nyní nový uzel umístěný pod kontextem dovednosti. Tento uzel je k dispozici pro libovolnou dovednost, projekci nebo mapování výstupního pole.

Pro přístup k jakémukoli obohacení přidanému do uzlu pomocí dovednosti je nutná úplná cesta k obohacení. Pokud například chcete použít text z pages uzlu jako vstup do jiné dovednosti, zadejte ho jako "/document/reviews_text/pages/*". Další informace o cestách naleznete v tématu Referenční rozšiřování.
Dovednost č. 2 Rozpoznávání jazyka
Dokumenty pro kontrolu hotelu zahrnují zpětnou vazbu od zákazníků vyjádřenou ve více jazycích. Dovednost rozpoznávání jazyka určuje, který jazyk se používá. Výsledek se pak předá extrakci klíčových frází a detekci mínění (nezobrazuje se), přičemž při zjišťování mínění a frází bere v úvahu jazyk.
I když je dovednost rozpoznávání jazyka třetí (dovednost č. 3) definovaná v sadě dovedností, je to další dovednost, která se má provést. Nevyžaduje žádné vstupy, takže se provádí paralelně s předchozí dovedností. Stejně jako dovednost pro rozdělování, která jí předchází, se dovednost rozpoznávání jazyka vyvolá také jednou pro každý dokument. Strom rozšiřování teď obsahuje nový uzel pro jazyk.
Dovednosti č. 3 a #4 (analýza mínění a detekce klíčových frází)
Zpětná vazba od zákazníků odráží řadu pozitivních a negativních zkušeností. Dovednost analýzy mínění analyzuje zpětnou vazbu a přiřazuje skóre v kontinuu záporných kladných čísel nebo neutrální, pokud je mínění neurčené. Paralelně s analýzou sentimentu, detekce klíčových frází identifikuje a extrahuje slova a krátké fráze, které jsou významné.
Vzhledem k kontextu /document/reviews_text/pages/* se analýza sentimentu a klíčová slova vyhodnocují jednou pro každou z položek v kolekci pages. Výstupem dovednosti bude uzel pod přidruženým prvkem stránky.
Teď byste měli být schopni prohlédnout si zbývající dovednosti v sadě dovedností a představit si, jak se strom obohacení rozrůstá s každou vykonanou dovedností. Některé dovednosti, jako je dovednost sloučení a dovednost tvarovače, také vytvářejí nové uzly, ale používají pouze data z existujících uzlů a nevytvují čisté nové rozšiřování.
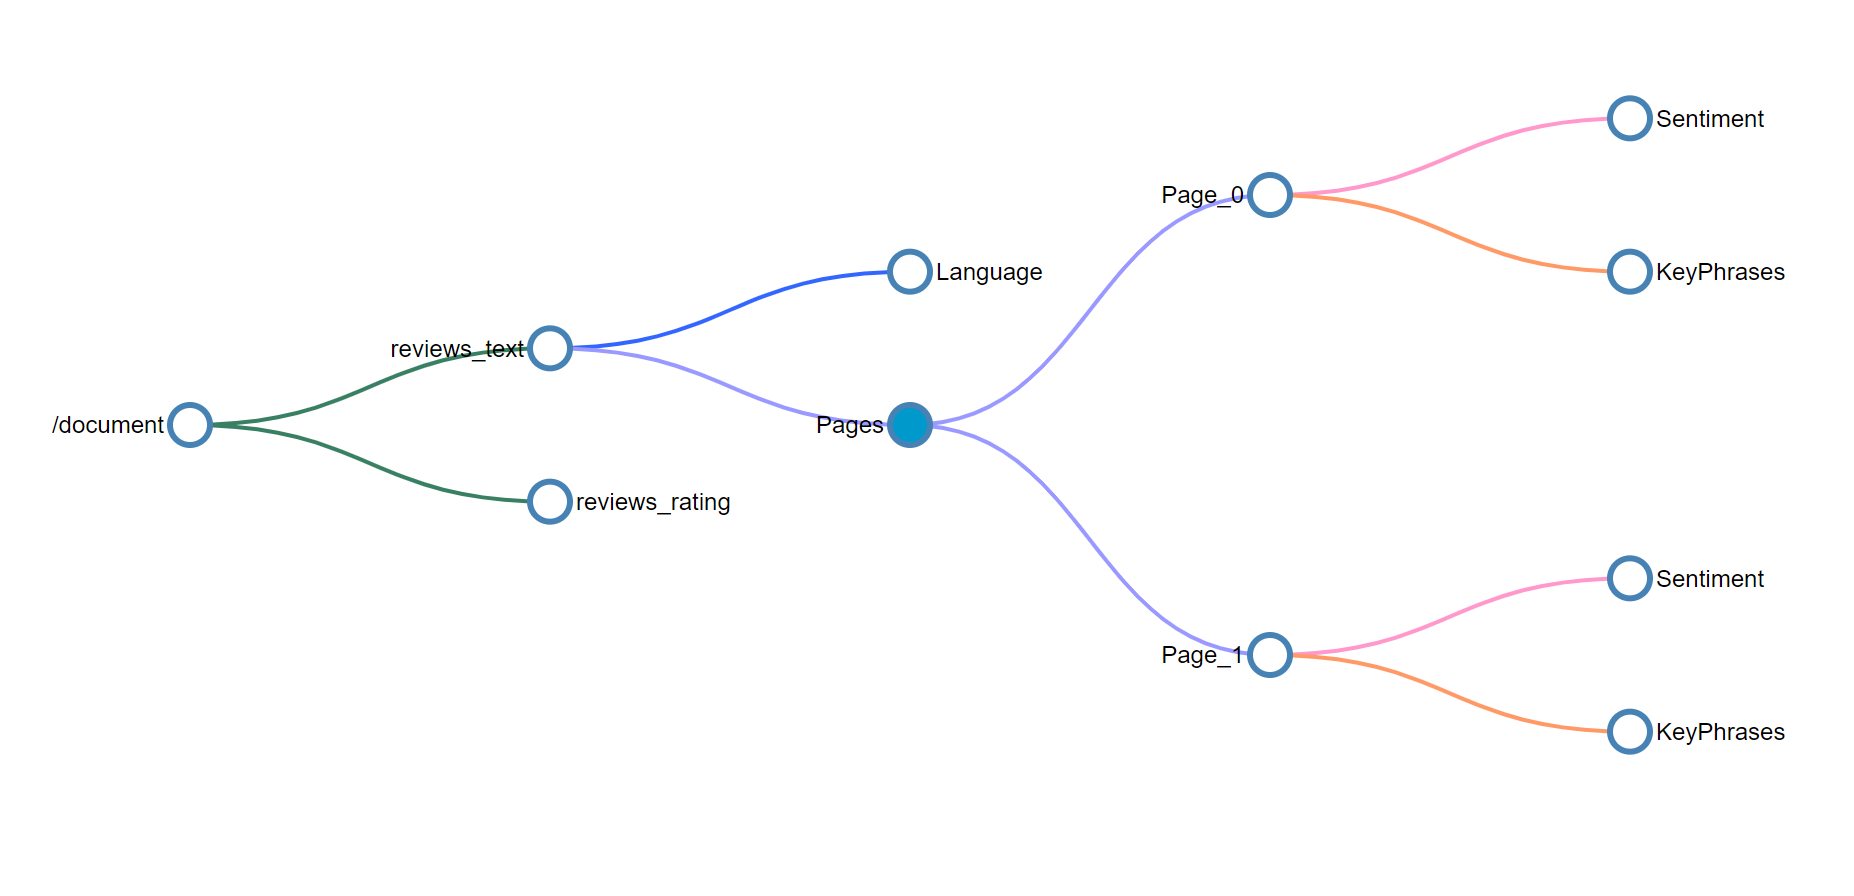
Barvy spojnic ve stromu výše ukazují, že obohacení byla vytvořena různými schopnostmi a uzly je třeba řešit jednotlivě, protože nebudou zahrnuty do objektu vráceného při výběru nadřazeného uzlu.
Dovednost 5 Shaper
Pokud výstup obsahuje úložiště znalostí, přidejte dovednost Shaper jako poslední krok. Dovednost Shaper vytváří datové obrazce z uzlů ve stromu obohacení. Můžete například chtít sloučit více uzlů do jednoho obrazce. Tento obrazec pak můžete promítnout jako tabulku (uzly se stanou sloupci v tabulce), předat obrazec podle názvu do projekce tabulky.
Práce s dovedností Shaper je snadná, protože se soustředí na tvarování pod jednou dovedností. Alternativně můžete zvolit in-line formování v rámci jednotlivých projekcí. Dovednost Shaper nic nepřidává ani neubírá do stromu vylepšení, proto není zobrazena. Místo toho si můžete představit dovednost Shaper jako prostředky, kterými přeuspořádáte strom obohacení, který už máte. Koncepčně se to podobá vytváření zobrazení z tabulek v databázi.
{
  "@odata.type": "#Microsoft.Skills.Util.ShaperSkill",
  "name": "#5",
  "description": null,
  "context": "/document",
  "inputs": [
    {
      "name": "name",
      "source": "/document/name"
    },
    {
      "name": "reviews_date",
      "source": "/document/reviews_date"
    },
    {
      "name": "reviews_rating",
      "source": "/document/reviews_rating"
    },
    {
      "name": "reviews_text",
      "source": "/document/reviews_text"
    },
    {
      "name": "reviews_title",
      "source": "/document/reviews_title"
    },
    {
      "name": "AzureSearch_DocumentKey",
      "source": "/document/AzureSearch_DocumentKey"
    },
    {
      "name": "pages",
      "sourceContext": "/document/reviews_text/pages/*",
      "inputs": [
        {
          "name": "Sentiment",
          "source": "/document/reviews_text/pages/*/Sentiment"
        },
        {
          "name": "LanguageCode",
          "source": "/document/Language"
        },
        {
          "name": "Page",
          "source": "/document/reviews_text/pages/*"
        },
        {
          "name": "keyphrase",
          "sourceContext": "/document/reviews_text/pages/*/Keyphrases/*",
          "inputs": [
            {
              "name": "Keyphrases",
              "source": "/document/reviews_text/pages/*/Keyphrases/*"
            }
          ]
        }
      ]
    }
  ],
  "outputs": [
    {
      "name": "output",
      "targetName": "tableprojection"
    }
  ]
}
Další kroky
S úvodem a příkladem za vámi zkuste vytvořit první sadu dovedností pomocí předdefinovaných dovedností.