Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Note
Azure AI Vyhledávač je k dispozici prostřednictvím portálu Azure, rozhraní REST API a Sady Azure SDK. Podporuje také Foundry IQ, spravovanou znalostní vrstvu, která transformuje podnikový obsah na opakovaně použitelné znalostní báze s podporou oprávnění pro agenty na portálu Microsoft Foundry.
Důležité
Na funkce, možnosti nebo vlastnosti označené jako (Preview) se nevztahuje smlouva o úrovni služeb, nejsou doporučené pro produkční úlohy a mohou se změnit nebo být omezeny dříve, než budou obecně k dispozici. Podmínky Azure AI Vyhledávač Preview platí pro všechny funkce ve verzi Preview, ať už jsou samostatné nebo součástí obecně dostupné funkce.
Tento článek vysvětluje, jak přidat cache do pipeline skillsetu, abyste mohli upravit kroky obohacení v dolní části procesu bez nutnosti plného opětovného sestavení pokaždé. Ukládání obohacení do mezipaměti (ve verzi Preview) vyžaduje REST API ve verzi Preview. Ve výchozím nastavení je sada dovedností bezstavová a změna jakékoli části jeho složení vyžaduje úplné opětovné spuštění indexeru. Při použití mezipaměti rozšiřování indexer určuje, které části stromu dokumentů musí být aktualizovány na základě změn sady dovedností nebo definice indexeru. Indexer zachová a znovu použije existující zpracovaný výstup, pokud je to možné.
Obsah uložený v mezipaměti umístíte do Azure Storage pomocí připojovací řetězec, který zadáte. Indexer tyto objekty vytvoří při spuštění. Považujte mezipaměť obohacení za interní komponentu spravovanou vaší vyhledávací službou, kterou nesmíte upravovat.
Důležité
Mezipaměť obohacení není zálohou výstupů sady dovedností, stavu indexeru ani indexovaných dokumentů. Nesleduje, které dokumenty byly plně zpracovány. V případě velkých zdrojů dat si před povolením ukládání do mezipaměti projděte část Omezení .
- Kontejner s názvem
ms-az-search-indexercache-<alpha-numeric-string> - Tabulky s názvem
MsAzSearchIndexerCacheIndex<alpha-numeric-string>
Požadavky
Azure Storage pro ukládání rozšíření uložených v mezipaměti. Účet úložiště musí být pro obecné účely verze 2.
Pro indexování objektů blob stačí, když potřebujete synchronizované odebrání dokumentu z mezipaměti i indexu, když se objekty blob odstraní z vašeho zdroje dat, povolte v indexeru zásadu odstranění . Bez této zásady není odstranění dokumentu z mezipaměti podporované.
Měli byste být obeznámeni s nastavením indexerů a skillsetů. Začněte přehledem indexeru a poté pokračujte na sady dovedností, abyste se seznámili s obohacovacími kanály.
Omezení
Pozor
Pokud používáte indexer SharePoint (Preview), vyhněte se přírůstkovým rozšiřováním. Za určitých okolností se mezipaměť stane neplatnou. Pokud ho chcete znovu načíst, proveďte resetování indexeru a úplné opětovné sestavení.
Velké zdroje dat mají další omezení mezipaměti.
Pozor
U velkých zdrojů dat může mezipaměť obohacení zvýšit celkový objem opětovného zpracování při dlouho běžících dovednostech, opakovaných přerušeních nebo častých selháních dovedností. Indexer upřednostňuje správnost před minimalizací opětovného zpracování, takže nahromadění položek v mezipaměti způsobené opakovanými přerušeními vede k častějším opakovaným pokusům. Toto chování je očekávané, nikoli chyba.
Pokud se chcete zotavit z rostoucího backlogu mezipaměti, rozdělte zdroj dat do menších kontejnerů nebo virtuálních složek. Pak použijte paralelní indexery odkazující na stejný index. Pokud chcete zrušit přidružení mezipaměti, nastavte vlastnost cache na indexeru na hodnotu null. Pokyny k modelu dělení najdete v tématu Indexování velkých datových sad .
Oprávnění
Identita Azure AI Vyhledávač potřebuje k Azure Storage přístup k zápisu:
- Přispěvatel dat Storage Blobu
- Přispěvatel dat tabulky úložiště
Syntaxe připojovací řetězec určuje, jestli se používá identita přiřazená systémem nebo přiřazená uživatelem. Další informace najdete v tématu Pojení k Azure Storage pomocí spravované identity.
Nastavení vlastnosti mezipaměti
Tento postup použijte pro nové i existující indexery.
V definici indexeru nastavte cache :
- (Povinné)
storageConnectionStringnastaveno na Azure Storage připojovací řetězec. - (Volitelné)
enableReprocessing(trueve výchozím nastavení). Nastavte ho nafalsepro dočasné pozastavení přírůstkového rozšiřování a přepněte ho zpět natruepozději.
Vlevo vyberte Indexery.
Vyberte Přidat indexer a vytvořte nový indexer nebo otevřete existující indexer v režimu úprav JSON.
Povolte přírůstkové obohacení, nastavte účet úložiště mezipaměti obohacení a uložte indexér.
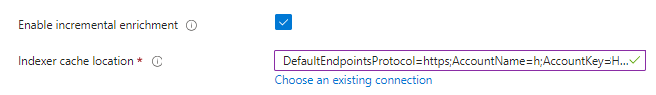
Pokud už indexer existuje, obnovte ho.
Spusťte indexer. Toto jednorázové úplné obnovení vyplní mezipaměť. Po načtení se přírůstkové znovuvyužití použije opakovaně.