Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Poznámka
Azure AI Vyhledávač je k dispozici prostřednictvím portálu Azure, rozhraní REST API a Sady Azure SDK. Podporuje také Foundry IQ, spravovanou znalostní vrstvu, která transformuje podnikový obsah na opakovaně použitelné znalostní báze s podporou oprávnění pro agenty na portálu Microsoft Foundry.
V Azure AI Vyhledávač můžete indexer spustit několika způsoby:
- Spusťte okamžitě po vytvoření indexeru. Tato možnost je výchozí, pokud indexer nevytvoříte v zakázaném stavu.
- Spuštění podle plánu za účelem vyvolání provádění v pravidelných intervalech. Pokud se naplánovaný indexer přestane spouštět, postup obnovení najdete v článku Časté dotazy k chování plánování.
- Spusťte podle potřeby, s resetováním nebo bez resetování.
Tento článek vysvětluje, jak spouštět indexery na vyžádání s resetováním a bez nich. Popisuje také provádění indexeru, délku trvání a souběžnost.
Jak se indexery připojují k prostředkům Azure
Indexery jsou jedním z několika subsystémů, které provádějí výrazná odchozí volání do jiných Azure prostředků. V závislosti na externím zdroji dat můžete k ověření připojení použít klíče nebo role.
Pokud jde o Azure role, indexery nemají samostatné identity: připojení z vyhledávacího webu k jinému Azure prostředku používá spravovanou identitu vyhledávací služby přiřazenou systémem nebo uživatelem a navíc přiřazení role k cílovému Azure prostředku. Pokud se indexer připojí k prostředku Azure ve virtuální síti, měli byste pro toto připojení vytvořit sdílené privátní propojení.
Poznámka
Indexery pracují s oprávněními na úrovni služby místo uživatelských oprávnění. Indexer může zapisovat do libovolného indexu vyhledávací služby, a to i v případě, že jste přiřadili role k omezení přístupu na konkrétní indexy. Další informace naleznete na téma Rozsah indexu a operace indexeru.
Spuštění indexeru
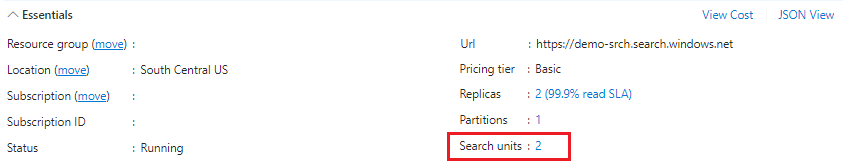
Vyhledávací služba spouští jednu úlohu indexeru na jednotku vyhledávání. Každá vyhledávací služba začíná s jednou jednotkou vyhledávání, ale přidáním každého nového oddílu nebo repliky se zvyšuje počet jednotek vyhledávání vaší služby. Počet jednotek vyhledávání můžete zkontrolovat v části Základní Azure portálu na stránce Overview. Pokud potřebujete paralelní zpracování, ujistěte se, že vaše vyhledávací jednotky obsahují dostatečné repliky. Indexery se nespouštějí na pozadí, takže pokud je služba pod tlakem, může dojít k většímu omezování dotazů než obvykle.
Následující snímek obrazovky ukazuje počet jednotek hledání, které určují, kolik indexerů může běžet najednou.
Po spuštění indexeru ho nemůžete pozastavit ani zastavit. Provádění indexeru se zastaví, pokud nejsou k dispozici žádné další dokumenty k načtení nebo aktualizaci, nebo při dosažení maximálního časového limitu.
Můžete spustit více indexerů najednou za předpokladu, že je dostatečná kapacita, ale každý samotný indexer je jedna instance. Spuštění nové instance, zatímco indexer je již spuštěn, způsobí tuto chybu: "Failed to run indexer "<indexer name>" error: "Another indexer invocation is currently in progress; concurrent invocations are not allowed."
Spouštěcí prostředí indexeru
Úloha indexeru se spouští ve spravovaném spouštěcím prostředí. V současné době existují dvě prostředí:
Prostředí privátního spouštění běží na vyhledávacích clusterech, které jsou specifické pro vaši vyhledávací službu.
Prostředí s více tenanty má procesory obsahu, které Microsoft spravuje a zabezpečuje bez dalších poplatků. Toto prostředí přesměruje výpočetně náročné zpracování, takže prostředky specifické pro službu zůstanou dostupné pro rutinní operace. Kdykoli je to možné, většina dovedností se spustí v multi-tenantním prostředí. Toto prostředí je výchozí.
Výpočetní zpracování se týká sad dovedností běžících na procesorech obsahu a úlohách indexeru, které zpracovávají velký objem dokumentů nebo dokumentů velké velikosti. Heuristiky a systémové informace určují zpracování mimo sadu dovedností na víceklientských procesorech obsahu a toto zpracování není pod kontrolou zákazníka.
Použití víceklientských prostředí ve službách Standard2 nebo vyšších můžete zabránit tak, že připnete indexer a zpracování sady dovedností výhradně do vyhledávacích clusterů.
Nastavte parametr v definici indexeru executionEnvironment tak, aby vždy spustil indexer v privátním spouštěcím prostředí.
Brány firewall protokolu IP blokují víceklientských prostředí, takže pokud máte bránu firewall, vytvořte pravidlo , které umožňuje připojení víceklientských procesorů.
Omezení indexeru se pro každé prostředí liší:
| Pracovní zatížení | Maximální doba trvání | Maximální počet úloh | Spouštěcí prostředí |
|---|---|---|---|
| Privátní provádění | 24 hodin | Jedna úloha indexeru na jednotku vyhledávání1. | Indexování neprobíhá na pozadí. Místo toho vyhledávací služba vyrovnává všechny úlohy indexování proti průběžným dotazům a akcím správy objektů (například vytváření nebo aktualizace indexů). Při spouštění indexerů byste měli počítat s latencí dotazů, pokud jsou objemy indexování velké. |
| Multitenantní | 2 hodiny 2 | Neurčitá 3 | Vzhledem k tomu, že cluster pro zpracování obsahu je víceklientní, systém přidává procesory obsahu, aby splňoval požadavky. Pokud dojde ke zpoždění při spuštění na vyžádání nebo plánovaném spuštění, důvodem je pravděpodobně to, že systém buď přidává procesory, nebo čeká na to, až bude k dispozici. |
1 Vyhledávací jednotky mohou být flexibilními kombinacemi oddílů a replik, ale úlohy indexeru nejsou pevně svázány s jednou nebo druhou možností. Jinými slovy, pokud máte 12 jednotek, můžete mít 12 úloh indexeru spuštěných souběžně v privátním spuštění bez ohledu na to, jak se jednotky vyhledávání nasazují.
2 Pokud jsou ke zpracování všech dat potřeba více než dvě hodiny, povolte detekci změn a naplánujte, aby indexer běžel v 5minutových intervalech, aby se indexování rychle obnovilo, pokud se zastaví kvůli vypršení časového limitu. Další strategie najdete v tématu Indexování velké datové sady .
3 " Neurčitá" znamená, že limit není kvantifikován počtem úloh. Některé úlohy, jako je zpracování sady dovedností, se můžou spouštět paralelně, což může vést k mnoha úlohám, i když je zapojen pouze jeden indexer. I když prostředí neukládá omezení, platí omezení indexeru pro vaši vyhledávací službu.
Spustit bez resetování
Operace spuštění Indexeru detekuje a zpracovává pouze to, co potřebuje k synchronizaci indexu vyhledávání se změnami v podkladovém zdroji dat. Přírůstkové indexování začíná nalezením interní mezní hodnoty, podle které se určí naposledy aktualizovaný dokument ve vyhledávacím indexu. Tento dokument se stane výchozím bodem pro provádění indexeru v nových a aktualizovaných dokumentech ve zdroji dat.
Detekce změn je nezbytná pro určení toho, co je nového nebo aktualizováno ve zdroji dat. Indexery používají možnosti detekce změn podkladového zdroje dat k určení toho, co je nového nebo aktualizováno ve zdroji dat.
Azure Storage má integrovanou detekci změn prostřednictvím vlastnosti LastModified.
Jiné zdroje dat, například Azure SQL nebo Azure Cosmos DB, vyžadují konfiguraci detekce změn, aby indexer mohl číst nové a aktualizované řádky.
Pokud se podkladový obsah nezmění, operace spuštění nemá žádný vliv. V tomto případě historie spuštění indexeru 0\0 označuje zpracované dokumenty.
Pokud chcete znovu zpracovat všechny dokumenty, musíte indexer resetovat.
Resetování indexerů
Po počátečním spuštění indexer sleduje, které vyhledávací dokumenty se indexují prostřednictvím interní horní meze. Značka není vystavená, ale indexer interně ví, kde se naposledy zastavil.
Chcete-li znovu sestavit celý index nebo jeho část, použijte rozhraní API Reset dostupná na postupně nižších úrovních v hierarchii objektů:
- Resetování indexerů vymaže horní mez a provede úplnou reindexaci všech dokumentů.
- Opětovná synchronizace indexerů (Preview) provede efektivní částečnou reindexaci všech dokumentů.
- Obnovit dokumenty (Preview) přeindexuje určitý dokument nebo seznam dokumentů.
- Resetování dovedností (Preview) vyvolá zpracování dovedností pro určitou dovednost.
Po resetování postupujte podle příkazu Spustit a znovu zpracujte nové a existující dokumenty. Pomocí resetování a spuštění nemůžete odebrat osiřelé vyhledávací dokumenty, které nemají odpovídající protějšek ve zdroji dat. Pokud chcete odstranit konkrétní dokumenty, přečtěte si téma Odstranění dokumentů v indexu vyhledávání nebo Dokumenty – Index.
Poznámka
Tabulky nemohou být prázdné. Pokud používáte TRUNCATE TABLE k vymazání řádků, resetování a opětovné spuštění indexeru neodebere odpovídající vyhledávací dokumenty. Pokud chcete odebrat osamocené dokumenty, musíte je odstranit pomocí akce indexování.
Jak resetovat a spouštět indexery
Reset odstraní maximální hodnotu. Všechny dokumenty v indexu vyhledávání jsou označeny pro úplné přepsání, bez aktualizací v řádku nebo sloučení do stávajícího obsahu. U indexerů s dovednostní sadou a mezipamětí obohacení (Preview) resetování indexu také implicitně resetuje dovednostní sadu.
Skutečná práce nastane, když provedete resetování pomocí příkazu Spustit:
- Všechny nové dokumenty nalezené v podkladovém zdroji se přidají do indexu vyhledávání.
- Všechny dokumenty, které existují ve zdroji dat i indexu vyhledávání, se přepíšou v indexu vyhledávání.
- Veškerý obohacený obsah vytvořený ze sad dovedností se znovu sestaví. Mezipaměť rozšiřování, pokud je povolená, se aktualizuje.
Jak už jsme uvedli dříve, resetování je pasivní operace: musíte postupovat s požadavkem Spustit, abyste znovu vytvořili index.
Operace resetování/spuštění se vztahují na index vyhledávání nebo úložiště znalostí, na konkrétní dokumenty nebo projekce a na rozšiřování v mezipaměti, pokud resetování explicitně nebo implicitně zahrnuje dovednosti.
Resetování platí také pro operace vytváření a aktualizace. Neaktivuje odstranění ani nevyčistí osamocené dokumenty v indexu vyhledávání. Další informace o odstraňování dokumentů naleznete v tématu Dokumenty – Index.
Operaci resetování nemůžete vrátit zpět.
- Portál Azure
- REST
- .NET SDK (C#)
Přejděte do vyhledávací služby na portálu Azure.
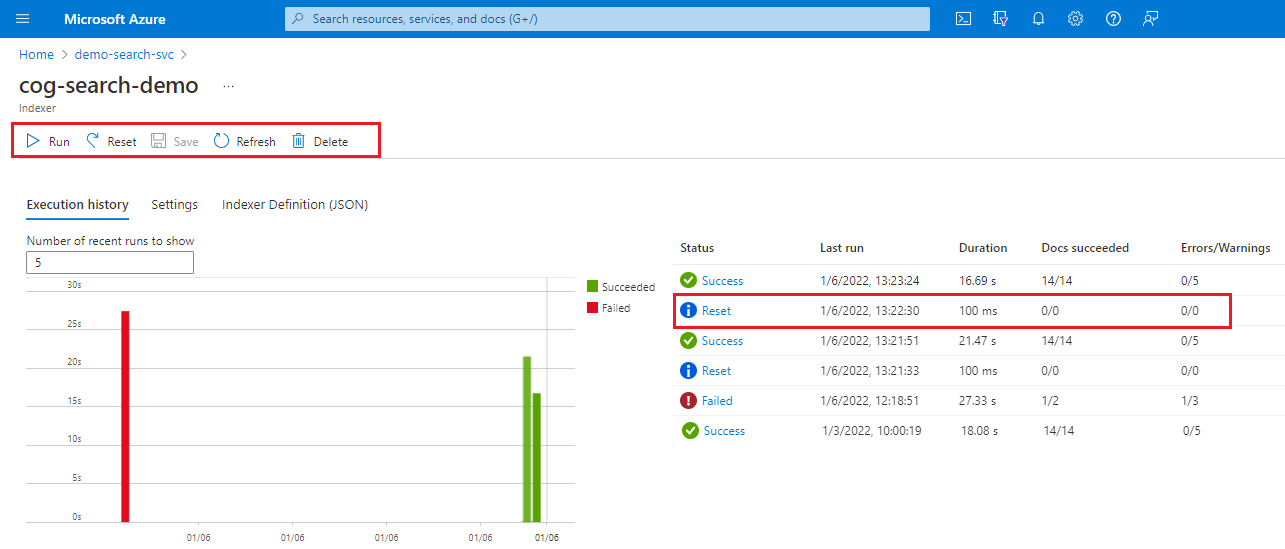
Na stránce Přehled vyberte kartu Indexery .
Vyberte indexer.
Vyberte příkaz Obnovit a akci potvrďte výběrem možnosti Ano .
Aktualizujte stránku, aby se zobrazil stav. Položku můžete vybrat a zobrazit její podrobnosti.
Vyberte Spustit , chcete-li spustit zpracování indexeru, nebo počkejte na další plánované spuštění.
Resetování dovedností (Preview)
Žádost o resetování dovedností selektivně zpracuje jednu nebo více dovedností během dalšího spuštění indexeru. U indexerů, které mají sady dovedností, můžete resetovat jednotlivé dovednosti, abyste vynutili opětovné zpracování pouze této dovednosti a všech podřízených dovedností, které závisí na jeho výstupu. Pokud jste povolili mezipaměť rozšiřování, požadavek ji také aktualizuje.
U indexerů s povoleným ukládáním do mezipaměti můžete explicitně požádat o zpracování aktualizací dovedností, které indexer nedokáže rozpoznat. Pokud například provedete externí změny, jako jsou revize vlastní dovednosti, použijte toto rozhraní API k opětovnému spuštění dovednosti. Proces aktualizuje výstupy, jako je úložiště znalostí nebo index vyhledávání, pomocí opakovaně použitelných dat z mezipaměti a nového obsahu podle aktualizované dovednosti.
Použijte nejnovější rozhraní API ve verzi Preview.
POST /skillsets/[skillset name]/resetskills?api-version=2026-08-01-preview
{
    "skillNames" : [
        "#1",
        "#5",
        "#6"
    ]
}
Můžete určit jednotlivé dovednosti, jak je znázorněno v předchozím příkladu, ale pokud některý z těchto dovedností vyžaduje výstup z nezasílaných dovedností (#2 až #4), proces spustí nezasílané dovednosti, pokud mezipaměť nedokáže poskytnout potřebné informace. Aby byla tato podmínka pravdivá, nesmí rozšíření v mezipaměti pro dovednosti č. 2 až #4 záviset na #1 (uvedené pro resetování).
Pokud nezadáte žádné dovednosti, proces spustí celou sadu dovedností a pokud je ukládání do mezipaměti povolené, aktualizuje také mezipaměť.
Nezapomeňte pokračovat s Run Indexer pro vyvolání skutečného zpracování.
Jak resetovat dokumenty (náhled)
Rozhraní API Indexers - Reset Docs (preview) přijímá seznam klíčů dokumentů, takže můžete obnovit konkrétní dokumenty. Pokud zadáte parametry resetování, určí pouze to, co se zpracuje, bez ohledu na jiné změny v podkladových datech. Pokud se například od posledního spuštění indexeru přidalo nebo aktualizovalo 20 objektů blob, ale resetujete jenom jeden dokument, indexer zpracuje pouze tento dokument.
Na základě jednotlivých dokumentů indexer aktualizuje všechna pole ve vyhledávacím dokumentu hodnotami a metadaty ze zdroje dat. Nemůžete vybrat a zvolit, která pole se mají aktualizovat.
Pokud je zdroj dat Azure Data Lake Storage (ADLS) Gen2 a objekty blob jsou přidružené k metadatům oprávnění, indexer tato oprávnění znovu ingestuje v indexu vyhledávání, pokud se oprávnění v podkladových datech změní. Další informace najdete v tématu Opětovné indexování seznamu ACL a rozsahu RBAC pomocí indexerů ADLS Gen2.
Pokud dokument rozšiřujete prostřednictvím sady dovedností a obsahuje data uložená v mezipaměti, indexer vyvolá sadu dovedností pouze pro zadané dokumenty a aktualizuje mezipaměť pro reprocesované dokumenty.
Při prvním testování tohoto rozhraní API vám následující rozhraní API můžou pomoct ověřit a otestovat chování. Použijte nejnovější rozhraní API ve verzi Preview.
Zavolejte Indexery - Získat stav s předběžnou verzí rozhraní API za účelem kontroly stavu resetu a stavu provádění. Informace o žádosti o resetování najdete na konci odpovědi na stav.
Zavolejte indexery - obnovení dokumentů s ukázkovou verzí rozhraní API, abyste určili, které dokumenty se mají zpracovat.
POST https://[service name].search.windows.net/indexers/[indexer name]/resetdocs?api-version=2026-08-01-preview
{
    "documentKeys" : [
        "1001",
        "4452"
    ]
}
Rozhraní API přijímá jako vstup dva typy identifikátorů dokumentů: klíče dokumentů, které jednoznačně identifikují dokumenty v indexu vyhledávání, a identifikátory dokumentů zdroje dat, které jednoznačně identifikují dokumenty ve zdroji dat. Tělo by mělo obsahovat buď seznam klíčů dokumentu , nebo seznam identifikátorů dokumentu zdroje dat, které indexer hledá ve zdroji dat. Vyvolání rozhraní API přidá klíče dokumentu nebo identifikátory dokumentu zdroje dat, které se mají obnovit do metadat indexeru. Při dalším naplánovaném spuštění indexeru nebo na vyžádání indexer zpracovává pouze resetované dokumenty.
Pokud k resetování dokumentů používáte klíče dokumentu a klíče dokumentu se odkazují v mapování polí indexeru, indexer použije mapování polí k vyhledání příslušného pole v podkladovém zdroji dat.
Klíče dokumentu, které v požadavku zadáte, jsou hodnoty z indexu vyhledávání, které se můžou lišit od odpovídajících polí ve zdroji dat. Pokud si nejste jisti hodnotou klíče, odešlete dotaz , který vrátí hodnotu. Můžete použít
selectk vrácení pouze pole klíče dokumentu.U blobů, které indexer parsuje do více vyhledávacích dokumentů (kde je
parsingModenastaveno na jsonLines nebo jsonArrays nebo delimitedText), indexer vygeneruje klíč dokumentu, který vám nemusí být znám. V tomto scénáři se zadává dotaz na klíč dokumentu, aby se vrátila správná hodnota.Pokud chcete, aby indexer přestal zkoušet zpracovávat resetování dokumentů, nastavte
"documentKeys"nebo"datasourceDocumentIds"do prázdného seznamu[]. Výsledkem této akce je obnovení pravidelného indexování na základě horní meze. Neplatné klíče dokumentu nebo klíče dokumentu, které neexistují, se ignorují.
Spusťte indexer (libovolná verze rozhraní API) pro zpracování vámi zadaných dokumentů. Indexer indexuje pouze ty konkrétní dokumenty.
Znovu spusťte Run Indexer k zpracování od posledního kontrolního bodu.
Voláním prohledat dokumenty můžete vyhledat aktualizované hodnoty a také vrátit klíče dokumentu, pokud si nejste jisti hodnotou. Použijte
"select": "<field names>", pokud chcete omezit, která pole se zobrazí v odpovědi.
Přepsání seznamu klíčů dokumentu
Pokud rozhraní API Reset Documents zavoláte vícekrát s různými klíči, nové klíče se přidají do seznamu resetovaných klíčů dokumentů. Pokud zavoláte rozhraní API s parametrem overwrite nastaveným na true, aktuální seznam se nahradí novým:
POST https://[service name].search.windows.net/indexers/[indexer name]/resetdocs?api-version=2026-08-01-preview
{
    "documentKeys" : [
        "200",
        "630"
    ],
    "overwrite": true
}
Postup opětovné synchronizace indexerů (Preview)
Resync indexery je rozhraní REST API ve verzi Preview, které provádí částečné přeindexování všech dokumentů. Indexer se považuje za synchronizovaný se zdrojem dat, pokud jsou specifická pole všech dokumentů v cílovém indexu konzistentní s daty ve zdroji dat. Indexer obvykle dosahuje synchronizace po úspěšném počátečním spuštění. Pokud odstraníte dokument ze zdroje dat, indexer zůstane synchronizovaný podle této definice. Během dalšího spuštění indexeru se ale odpovídající dokument v cílovém indexu odebere, pokud je povolené sledování odstranění.
Pokud upravíte dokument ve zdroji dat, indexer se nesynchronizuje. Obecně platí, že mechanismy sledování změn resynchronizují indexer během dalšího spuštění. Například v Azure Storage se úprava objektu blob aktualizuje čas poslední změny, aby ho indexer mohl v dalším spuštění indexeru znovu indexovat, protože aktualizovaný čas překračuje horní mez nastavenou předchozím spuštěním.
Naproti tomu u některých zdrojů dat, jako je ADLS Gen2, změna seznamů řízení přístupu (ACL) objektu blob nemění čas poslední změny, takže sledování změn je neefektivní, pokud se seznamy ACL ingestují. V důsledku toho se upravený objekt blob v následujícím spuštění znovu neindexuje, protože se zpracovávají pouze dokumenty upravené po posledním kontrolním bodu.
I když použití příkazu „reset“ nebo „reset docs“ může tento problém vyřešit, příkaz „reset“ může být u velkých datových sad časově náročný a neefektivní a příkaz „reset docs“ vyžaduje identifikaci klíče dokumentu objektu blob, který chcete aktualizovat.
Reindexace indexerů nabízí efektivní a pohodlnou alternativu. Indexer jednoduše umístíte do režimu resynchronizace a určíte obsah, který se má znovu synchronizovat voláním rozhraní API pro resynchronizaci indexerů. V dalším spuštění indexer zkontroluje pouze relevantní část dat ve zdroji a zabrání zbytečnému zpracování, které nesouvisí se zadanými daty. Dotazuje se také na existující dokumenty v cílovém indexu a aktualizuje pouze dokumenty, které zobrazují nesrovnalosti mezi zdrojem dat a cílovým indexem. Po opětovné synchronizaci se indexer synchronizuje a vrátí se do režimu běžného spuštění indexeru pro následné spuštění.
Postup opětovné synchronizace a spuštění indexerů
Volání indexerů – Resync s verzí Preview rozhraní API pro určení, jaký obsah má být znovu synchronizován.
POST https://[service name].search.windows.net/indexers/[indexer name]/resync?api-version=2026-08-01-preview { "options" : [ "permissions" ] }- Pole
optionsje povinné. V současné době jepermissionsjedinou podporovanou možností . To znamená, že se aktualizují pouze pole filtru oprávnění v cílovém indexu.
- Pole
Pokud chcete indexer znovu synchronizovat, zavolejte indexer spustit (libovolnou verzi rozhraní API).
Znovu spusťte Run Indexer k zpracování od posledního kontrolního bodu.
Zkontrolujte stav resetování "currentState"
Pokud chcete zkontrolovat stav resetování a zjistit, které klíče dokumentu se zařadí do fronty ke zpracování, postupujte takto:
Zavolejte Get Indexer Status pomocí preview verze rozhraní API.
Preview API vrací oddíl
currentState, který se nachází na konci odpovědi."currentState": { "mode": "indexingResetDocs", "allDocsInitialTrackingState": "{\"LastFullEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"LastAttemptedEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"NameHighWaterMark\":null}", "allDocsFinalTrackingState": "{\"LastFullEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"LastAttemptedEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"NameHighWaterMark\":null}", "resetDocsInitialTrackingState": null, "resetDocsFinalTrackingState": null, "resyncInitialTrackingState": null, "resyncFinalTrackingState": null, "resetDocumentKeys": [ "200", "630" ] }Zkontrolujte režim:
Pro resetování dovedností nastavte „režim“ na
indexingAllDocs, protože mohou být ovlivněny všechny dokumenty z hlediska polí, která vyplňuje obohacení AI.Pro resynchronní indexery nastavte "mode" na
indexingResync. Indexer kontroluje všechny dokumenty a zaměřuje se na relevantní data ve zdroji dat a relevantní pole v cílovém indexu.U příkazu Obnovit dokumenty nastavte „mode“ na
indexingResetDocs. Indexer zůstane v tomto stavu, dokud nezpracuje všechny klíče dokumentů zadané ve volání pro resetování dokumentů. Během této doby se během operace nespustí žádné jiné úlohy indexeru. Vyhledání všech dokumentů ze seznamu klíčů dokumentů vyžaduje zpracování každého dokumentu, aby bylo možné najít odpovídající klíč. Tento proces může chvíli trvat, pokud je sada dat velká. Pokud kontejner objektů blob obsahuje stovky objektů blob a dokumenty, které chcete resetovat, jsou na konci, indexer nenajde odpovídající objekty blob, dokud nekontroluje všechny ostatní.Poté, co indexer znovu zpracuje dokumenty, znovu spusťte příkaz Get Indexer Status. Indexer se vrátí do
indexingAllDocsrežimu a zpracuje všechny nové nebo aktualizované dokumenty při příštím spuštění.
Zkontrolujte kvótu doby běhu indexeru pro vyhledávací služby S3 HD a Serverless Search
Tato část se vztahuje na vyhledávací služby Standard 3 High Density (S3 HD) a bezserverové vyhledávací služby. Informace o agregovaném chování kvót a plánování najdete v tématu Spouštění indexerů v bezserverovém prostředí a S3 HD (Preview).
Každé spuštění indexeru může trvat maximálně dvě hodiny. Samostatně všechny indexery sdílejí 24 hodin kumulativní doby běhu na jednu službu v každém 24hodinovém okně UTC.
Abyste mohli monitorovat dobu spuštění indexeru vzhledem k 24hodinovému intervalu, získejte statistiku služby a získejte stav indexeru nyní v odpovědi další informace.
Sledování kumulativní kvóty modulu runtime
Sledujte kumulativní využití doby běhu indexeru vyhledávací služby a zjistěte, kolik časové kvóty zbývá v rámci aktuálního 24hodinového okna.
Odešlete požadavek GET do koncového bodu vyhledávací služby. Nápovědu k nastavení klienta REST a získání přístupového tokenu najdete v tématu Připojení ke vyhledávací službě.
GET {{search-endpoint}}/servicestats?api-version=2026-08-01-preview
  Content-Type: application/json
  Authorization: Bearer {{accessToken}}
Mezi odpovědi patří indexersRuntime vlastnosti, které zobrazují časy spuštění a ukončení okna, kumulativní sekundy používané všemi indexery a zbývající sekundy pro službu.
Sledování limitu běhu indexeru
Vrátí stejné informace pro jeden indexer.
GET {{search-endpoint}}/indexers/hotels-sample-indexer/search.status?api-version=2026-08-01-preview
  Content-Type: application/json
  Authorization: Bearer {{accessToken}}
Mezi odpovědi patří runtime vlastnosti, které zobrazují časy spuštění a ukončení okna, sekundy používané indexerem a sekundy zbývající pro všechny indexery ve službě.
Další kroky
API pro reset se používají k určení rozsahu dalšího spuštění indexeru. Pro skutečné zpracování je potřeba vyvolat spuštění indexeru na vyžádání nebo povolit naplánované úloze dokončení práce. Po dokončení běhu se indexer vrátí k normálnímu zpracování, ať už probíhá podle plánu, nebo na vyžádání.
Po resetování a opětovném spuštění úloh indexeru můžete monitorovat stav prostřednictvím služby vyhledávání nebo získat podrobné informace prostřednictvím protokolování zdrojů.