Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Note
Azure AI Vyhledávač je k dispozici prostřednictvím portálu Azure, rozhraní REST API a Sady Azure SDK. Podporuje také Foundry IQ, spravovanou znalostní vrstvu, která transformuje podnikový obsah na opakovaně použitelné znalostní báze s podporou oprávnění pro agenty na portálu Microsoft Foundry.
Důležité
Na funkce, možnosti nebo vlastnosti označené jako (Preview) se nevztahuje smlouva o úrovni služeb, nejsou doporučené pro produkční úlohy a mohou se změnit nebo být omezeny dříve, než budou obecně k dispozici. Podmínky Azure AI Vyhledávač Preview platí pro všechny funkce ve verzi Preview, ať už jsou samostatné nebo součástí obecně dostupné funkce.
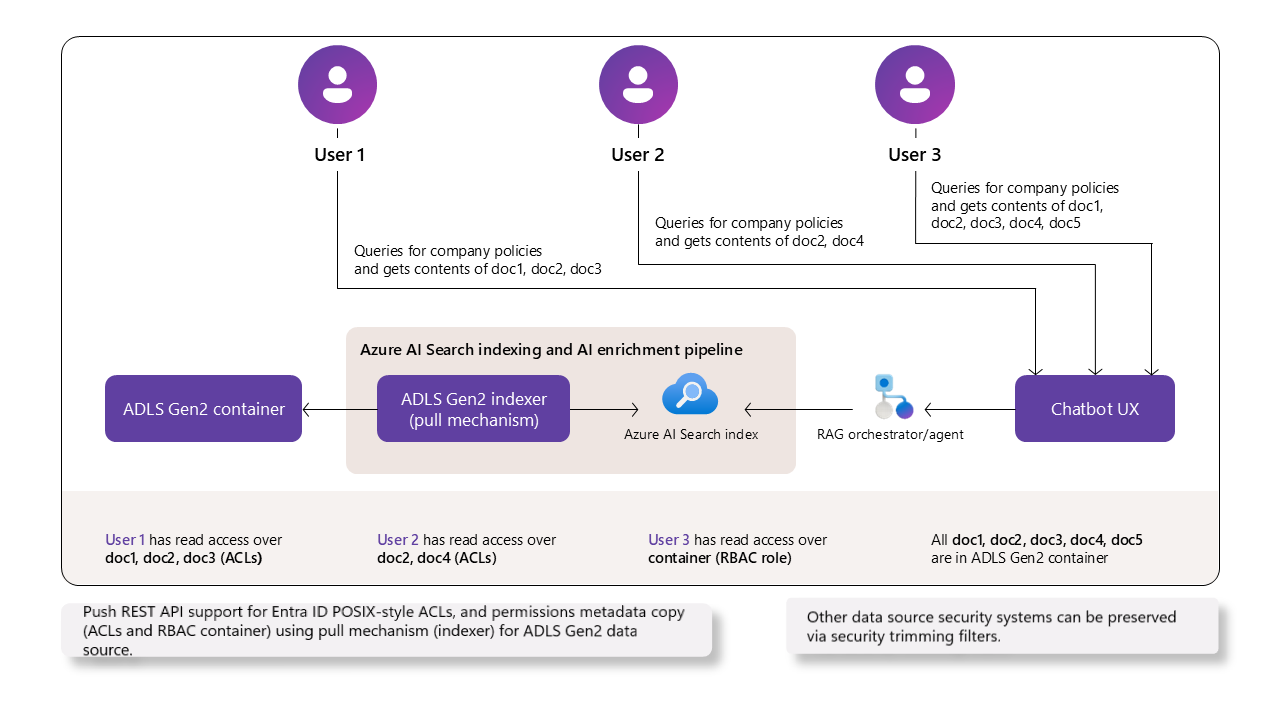
Azure Data Lake Storage (ADLS) Gen2 podporuje přístup jednotlivých uživatelů k adresářům a souborům prostřednictvím seznamů řízení přístupu (ACL) a řízení přístupu na základě role (Azure RBAC). Řízení přístupu na základě atributu (Azure ABAC) se nepodporuje.
Azure AI Vyhledávač může pomocí rozhraní REST API ve verzi Preview zpracovávat tato metadata o oprávněních (verze Preview) společně s obsahem dokumentu. Uživatelé, kteří nemají přístup k adresáři nebo souboru v úložišti, nevidí odpovídající dokumenty ve výsledcích hledání. Toto je jedna z několika strategií řízení přístupu na úrovni dokumentu v Azure AI Vyhledávač.
Tento článek vysvětluje, jak nakonfigurovat indexer ADLS Gen2 nebo zdroj znalostí ADLS Gen2 blob, aby automaticky stahoval metadata oprávnění do indexu vyhledávání. Doplňuje data indexu z ADLS Gen2 a vytvoří zdroj znalostí objektů blob pro ADLS Gen2 s informacemi specifickými pro příjem oprávnění. Pokud chcete ručně odeslat metadata oprávnění, viz Indexování seznamů ACL dokumentů pomocí push API.
Požadavky
Microsoft Entra ID ověřování a autorizace. Služby a aplikace musí být ve stejném tenantu. Uživatelé můžou být v různých tenantech, pokud všichni tenanti používají Microsoft Entra ID. Přiřazení rolí se používají pro každé ověřené připojení.
Azure AI Vyhledávač na fakturovatelné úrovni (Basic nebo vyšší) v libovolné oblasti. Vyhledávací služba musí mít povolený přístup na základě role a spravovanou identitu přiřazenou systémem nebo přiřazenou uživatelem.
Objekty blob ADLS Gen2 v hierarchickém oboru názvů s uživatelskými oprávněními udělenými pomocí ACL nebo rolí.
Ingestování oprávnění indexeru ve verzi REST API 2025-05-01-preview nebo novější. Pro podporu zdrojů znalostí je vyžadováno rozhraní REST API ve verzi 2025-11-01-preview nebo novější. Použijte nejnovější rozhraní REST API verze Preview nebo balíček sady SDK verze Preview, který podporuje filtry oprávnění.
Omezení
Tuto funkci nepodporuje portál Azure.
Platí omezení ADLS Gen2 pro přiřazení rolí a položky seznamu ACL.
Kategorie
owning usersowning groupsaOtherall() a () nejsou ve verzi Preview podporované. Místo toho používejte přiřazenínamed usersanamed groups.Následující funkce indexeru nepodporují dědičnost oprávnění v indexovaných dokumentech pocházejících z ADLS Gen2. Pokud některou z těchto funkcí použijete v sadě dovedností nebo indexeru, nebudou oprávnění na úrovni dokumentu zahrnuta do indexovaného obsahu.
Úložiště znalostí, včetně úložiště prostředků vyžadovaného pro poskytování obrázků (preview) v agentním načítání. Proto se poskytování obrázků nepodporuje pro zdroje znalostí, které přejímají seznamy řízení přístupu (ACL) nebo rozsahy RBAC.
Podpora modelu oprávnění
Tato část porovnává funkce řízení přístupu na úrovni dokumentu mezi ADLS Gen2 a Azure AI Vyhledávač. Vysvětluje, které mechanismy řízení přístupu podporuje nebo mapuje AI Search v Azure Data Lake Storage (ADLS) Gen2. To vám pomůže pochopit, jak se oprávnění vynucují na úrovni dokumentu.
| Funkce ADLS Gen2 | Popis | Podporováno | Poznámky |
|---|---|---|---|
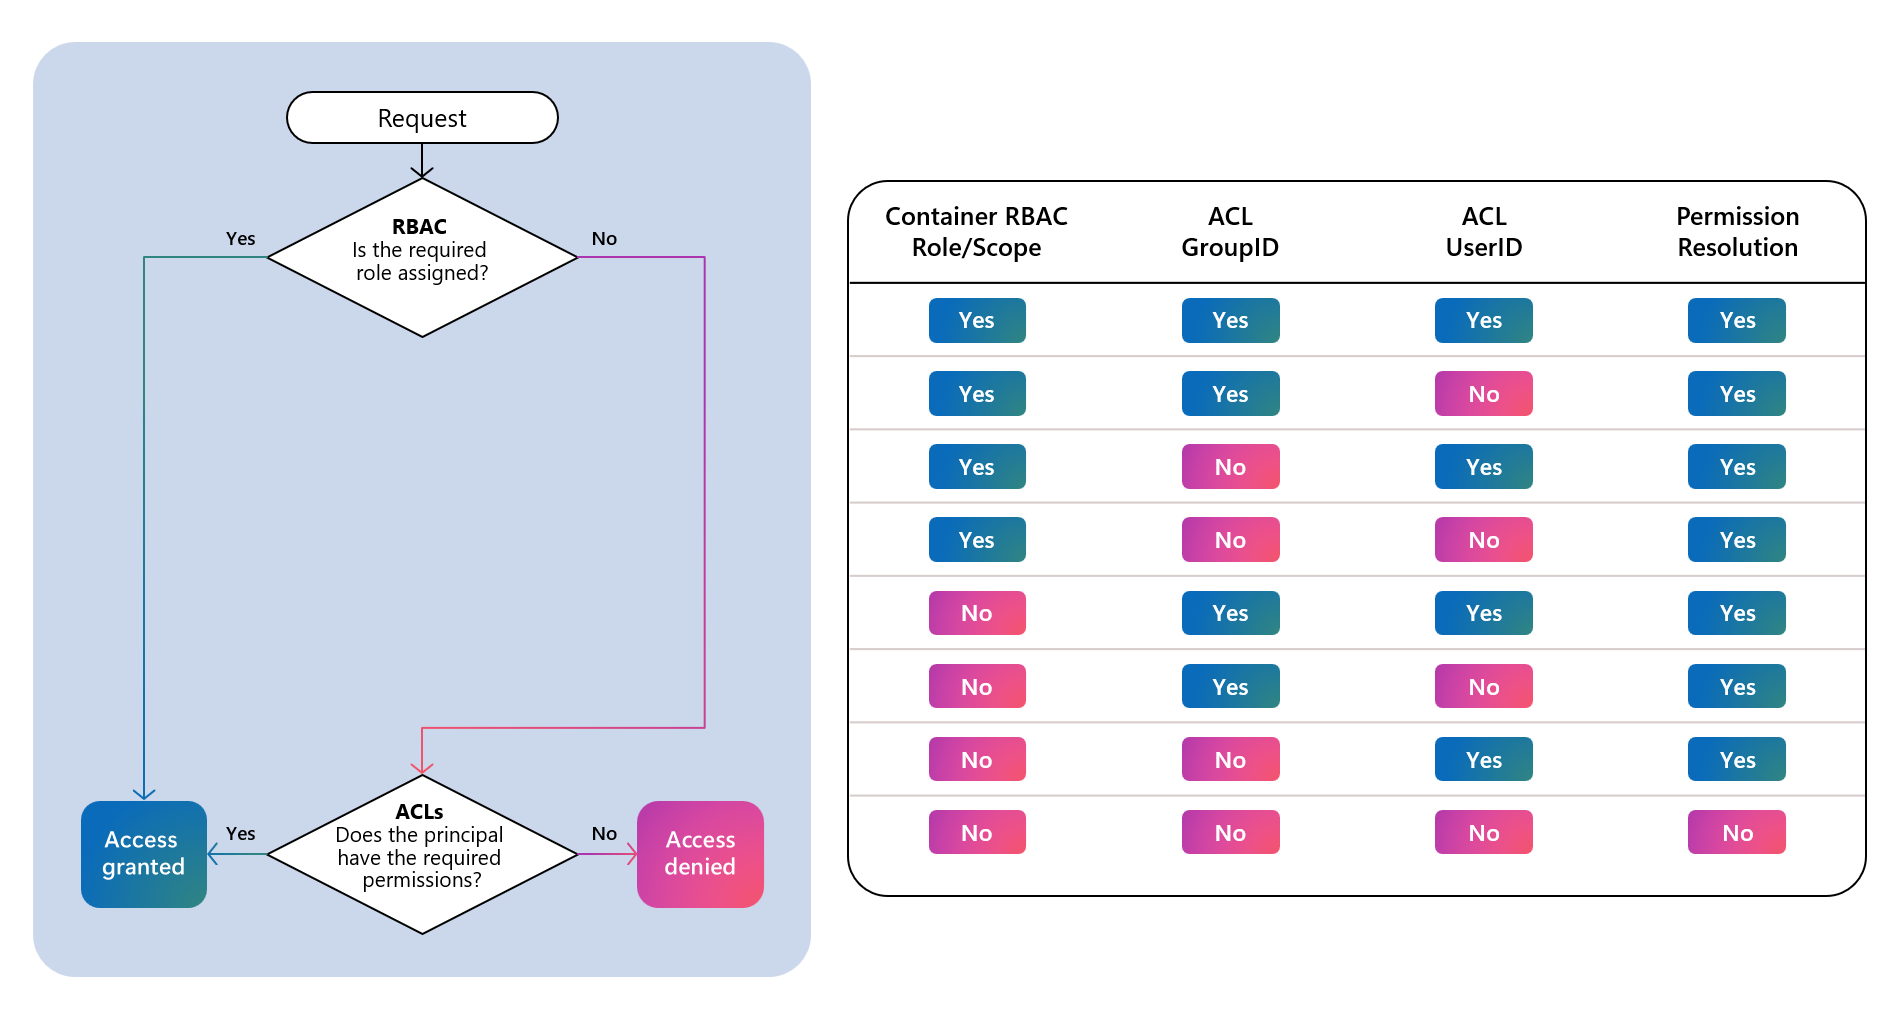
| RBAC | Hrubozrnný přístup na úrovni kontejneru | Ano | AI Search respektuje RBAC pro přístup ke všem dokumentům v celém kontejneru. |
| ABAC | Podmínky založené na atributech ve vazbě na RBAC | Ne | Vyhledávání AI nevyhodnocuje podmínky ABAC pro přístup na úrovni dokumentu. |
| ACL | Jemně odstupňovaná oprávnění na úrovni adresáře nebo souboru (dokument) | Ano | AI Search používá seznamy ACL na úrovni dokumentu pro filtry oprávnění. |
| Skupiny zabezpečení | Přiřazení oprávnění založená na skupinách | Ano | Podporuje se, pokud jsou skupiny zabezpečení mapovány v seznamu ACL na úrovni dokumentu. |
V době dotazu Azure AI Vyhledávač nejprve vyhodnotí RBAC na úrovni kontejneru a pak zkontroluje položky seznamu ACL na úrovni dokumentu. Přístup se udělí, pokud to nějaký mechanismus povolí.
Hierarchická oprávnění ACL
Indexery a zdroje znalostí mohou načítat přiřazení ACL ze zadaného kontejneru a všech adresářů, které vedou ke každému souboru, podle hierarchického toku vyhodnocení přístupu ADLS Gen2. Poslední efektivní přístupové seznamy pro každý soubor se počítají a různé kategorie přístupu se indexují do odpovídajících polí indexu.
Například v ADLS Gen2 běžné scénáře související s oprávněními jako cesta k souboru /Oregon/Portland/Data.txt.
| Operace | / | Oregon/ | Portland/ | Data.txt |
|---|---|---|---|---|
| Přečtěte Data.txt | --X | --X | --X | R-- |
Indexer nebo zdroj znalostí shromažďuje seznamy ACL z každého kontejneru a adresáře. Pak určí efektivní přístup na nižších úrovních a pokračuje, dokud nevyřeší oprávnění pro každý soubor.
/ assigned access vs Oregon/ assigned access
  => Oregon/ effective access vs Portland/ assigned access
    => Portland/ effective access vs Data.txt assigned access
      => Data.txt effective access
Konfigurace ADLS Gen2
Indexer nebo zdroj znalostí může získat přístup k seznamům řízení přístupu (ACL) pro účet úložiště, pokud jsou splněna následující kritéria. Další informace o přiřazení ACL naleznete v tématu Přiřazení ACL ADLS Gen2.
Autorizace
Pro indexování musí mít identita vaší vyhledávací služby oprávnění Čtenář dat objektů blob služby Storage.
Pokud testujete místně, měli byste mít také přiřazení role Čtenář dat objektů blob služby Storage . Další informace najdete v tématu Pojení k Azure Storage pomocí spravované identity.
Oprávnění kořenového kontejneru:
Přiřaďte všechny sady
GroupaUser(objekty zabezpečení) v kořenovém kontejneru/s oprávněnímiReadaExecute.Ujistěte se, že jsou obě
ReadaExecutejsou přidané jako výchozí oprávnění, aby se automaticky rozšířily do nově vytvořených souborů a adresářů.
Propagace oprávnění dolů v hierarchii souborů
I když nové adresáře a soubory dědí oprávnění, stávající adresáře a soubory nedědí tato přiřazení automaticky.
Použijte nástroj ADLS Gen2 k rekurzivnímu použití ACL pro rekurzivní šíření přiřazení u existujícího obsahu. Tento nástroj rozšíří přiřazení seznamu ACL kořenového kontejneru do všech základních adresářů a souborů.
Odebrání nadbytečných oprávnění
Po rekurzivním použití seznamů ACL zkontrolujte oprávnění pro každý adresář a soubor.
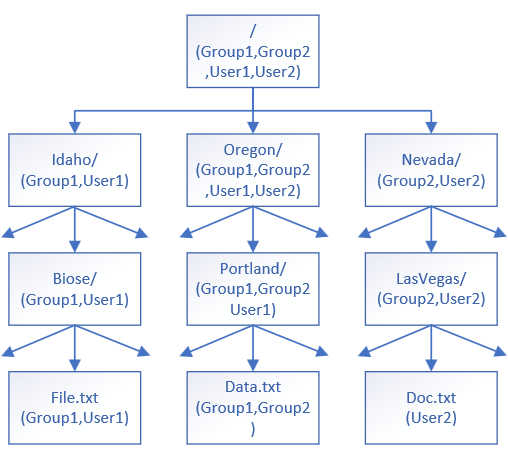
Odeberte všechny Group nebo User sady, které by neměly mít přístup ke konkrétním adresářům nebo souborům. Například, u složky User2 odeberte Portland/, a ze složky Idaho odeberte ze svých přiřazení Group2 a User2, a tak dále.
Ukázková struktura přiřazení ACL
Tady je diagram struktury přiřazení oprávnění ACL pro fiktivní hierarchii adresářů v dokumentaci ADLS Gen2.
Aktualizace přiřazení ACL v čase
V průběhu času, jakmile se jakákoliv nová přiřazení ACL přidají nebo upraví, opakujte předchozí kroky, abyste zajistili správné šíření a zarovnání oprávnění. Aktualizovaná oprávnění v ADLS Gen2 se aktualizují v indexu vyhledávání při opětovném ingestování obsahu pomocí indexeru nebo zdroje znalostí.
Konfigurace Azure AI Vyhledávač
Vzpomeňte si, že vyhledávací služba musí mít:
Autorizace
Pro indexování musí mít klient, který volá rozhraní API, oprávnění přispěvatele vyhledávací služby k vytváření objektů, oprávnění Přispěvatel dat indexu vyhledávání k provádění importu dat a Čtenář dat indexu vyhledávání pro dotazování indexu.
Pokud testujete místně, měli byste mít stejná přiřazení rolí. Další informace najdete v tématu Pojení k Azure AI Vyhledávač pomocí rolí.
Konfigurace zdroje znalostí
Pokud používáte zdroj znalostí, definice ve zdroji znalostí se používají k vygenerování úplného indexovacího kanálu (indexer, zdroj dat a index). Přiřazení ACL jsou zjištěna a automaticky zahrnuta do vygenerovaného indexu. Pokud chcete, aby byla v indexovaném obsahu zachována dědičnost oprávnění, nemusíte upravovat žádný z vygenerovaných objektů.
Klíčové body týkající se konfigurace, která v tomto scénáři funguje:
-
isADLSGen2hodnota je nastavená na hodnotu true a splňuje požadavek na zdroj dat pro tento scénář. -
ingestionPermissionOptionsurčuje ID uživatelů a skupin.
# Create / Update Azure Blob Knowledge Source
###
PUT {{url}}/knowledgesources/azure-blob-ks?api-version=2026-08-01-preview
api-key: {{key}}
Content-Type: application/json

{
    "name": "azure-blob-ks",
    "kind": "azureBlob",
    "description": "A sample azure blob knowledge source",
    "azureBlobParameters": {
        "connectionString": "{{blob-connection-string}}",
        "containerName": "blobcontainer",
        "folderPath": null,
        "isADLSGen2": true,
        "ingestionParameters": {
            "identity": null,
            "embeddingModel": {
                "kind": "azureOpenAI",
                "azureOpenAIParameters": {
                    "deploymentId": "text-embedding-3-large",
                    "modelName": "text-embedding-3-large",
                    "resourceUri": "{{aoai-endpoint}}",
                    "apiKey": "{{aoai-key}}"
                }
            },
            "chatCompletionModel": null,
            "disableImageVerbalization": true,
            "ingestionSchedule": null,
             "ingestionPermissionOptions": [
                "userIds","groupIds"
                           ],
            "contentExtractionMode": "minimal",
            "aiServices": {
                "uri": "{{ai-endpoint}}",
                "apiKey": "{{ai-key}}"
            }
        }
    }
}
###
Konfigurace indexování na bázi indexeru
Pokud používáte indexer, nakonfigurujte ho, zdroj dat a index pro vyžádání metadat oprávnění z objektů blob ADLS Gen2.
Vytvoření zdroje dat
Tato část doplňuje Index dat z ADLS Gen2 s informacemi, které jsou specifické pro příjem oprávnění spolu s obsahem dokumentu do indexu Azure AI Vyhledávač.
Typ zdroje dat musí být
adlsgen2.Zdroj dat musí mít
indexerPermissionOptionssuserIds,groupIdsa/neborbacScope.Pro
rbacScopenakonfigurujte připojovací řetězec ve formátu spravované identity.U připojovacích řetězců používajících spravovanou identitu přiřazenou uživatelem musíte také zadat
identityvlastnost.
Příklad JSON se spravovanou identitou systému:
{
    "name" : "my-adlsgen2-acl-datasource",
    "type": "adlsgen2",
    "indexerPermissionOptions": ["userIds", "groupIds", "rbacScope"],
    "credentials": {
    "connectionString": "ResourceId=/subscriptions/<your subscription ID>/resourceGroups/<your resource group name>/providers/Microsoft.Storage/storageAccounts/<your storage account name>/;"
    },
    "container": {
    "name": "<your container name>",
    "query": "<optional-virtual-directory-name>"
    }
}
Příklad schématu JSON s identitou spravovanou uživatelem v připojovací řetězec:
{
    "name" : "my-adlsgen2-acl-datasource",
    "type": "adlsgen2",
    "indexerPermissionOptions": ["userIds", "groupIds", "rbacScope"],
    "credentials": {
    "connectionString": "ResourceId=/subscriptions/<your subscription ID>/resourceGroups/<your resource group name>/providers/Microsoft.Storage/storageAccounts/<your storage account name>/;"
    },
    "container": {
    "name": "<your container name>",
    "query": "<optional-virtual-directory-name>"
    },
    "identity": {
    "@odata.type": "#Microsoft.Azure.Search.DataUserAssignedIdentity",
    "userAssignedIdentity": "/subscriptions/{subscription-ID}/resourceGroups/{resource-group-name}/providers/Microsoft.ManagedIdentity/userAssignedIdentities/{user-assigned-managed-identity-name}"
    }
}
Vytvoření polí oprávnění v indexu
V Azure AI Vyhledávač se ujistěte, že index obsahuje definice polí pro metadata oprávnění. Metadata oprávnění lze indexovat, pokud indexerPermissionOptions je zadána v definici zdroje dat.
Doporučené atributy schématu pro ACL (UserIds, GroupIds) a rozsah RBAC:
- Pole Identifikátor uživatele (ID) s
userIdshodnotou permissionFilter - Pole ID skupiny s
groupIdshodnotou permissionFilter - Pole oboru RBAC s
rbacScopehodnotou permissionFilter - Vlastnost
permissionFilterOption, která povolí filtrování v době dotazování. - Používejte řetězcová pole pro metadata oprávnění
- Nastavte
filterablehodnotu true u všech polí.
Všimněte si, že retrievable je false. Během vývoje můžete nastavit hodnotu True, abyste ověřili, že jsou oprávnění k dispozici, ale nezapomeňte před nasazením do produkčního prostředí nastavit hodnotu false.
Příklad schématu JSON:
{
  ...
  "fields": [
    ...
    { "name": "UserIds", "type": "Collection(Edm.String)", "permissionFilter": "userIds", "filterable": true, "retrievable": false },
    { "name": "GroupIds", "type": "Collection(Edm.String)", "permissionFilter": "groupIds", "filterable": true, "retrievable": false },
    { "name": "RbacScope", "type": "Edm.String", "permissionFilter": "rbacScope", "filterable": true, "retrievable": false }
  ],
  "permissionFilterOption": "enabled"
}
Nakonfigurujte indexer
Mapování polí v indexeru nastavují cestu k datům v indexu. Cílová a cílová pole, která se liší podle názvu nebo datového typu, vyžadují explicitní mapování polí. Následující pole metadat v ADLS Gen2 můžou potřebovat mapování polí, pokud se název pole liší:
-
metadata_user_ids (
Collection(Edm.String)) – seznam ID uživatelů ACL. -
metadata_group_ids (
Collection(Edm.String)) – seznam ID skupin ACL. -
metadata_rbac_scope (
Edm.String) – rozsah RBAC kontejneru.
Zadejte fieldMappings v indexeru pro směrování metadat oprávnění do cílových polí během indexování.
Příklad schématu JSON:
{
  ...
  "fieldMappings": [
    { "sourceFieldName": "metadata_user_ids", "targetFieldName": "UserIds" },
    { "sourceFieldName": "metadata_group_ids", "targetFieldName": "GroupIds" },
    { "sourceFieldName": "metadata_rbac_scope", "targetFieldName": "RbacScope" }
  ]
}
Doporučení a osvědčené postupy
Před vytvořením jakýchkoli složek pečlivě naplánujte strukturu složek ADLS Gen2.
Uspořádejte identity do skupin a používejte skupiny, kdykoli je to možné, místo udělení přístupu přímo jednotlivým uživatelům. Průběžné přidávání jednotlivých uživatelů místo použití skupin zvyšuje počet položek řízení přístupu, které je potřeba sledovat a vyhodnocovat. Nedodržování tohoto osvědčeného postupu může vést k častějším aktualizacím metadat zabezpečení potřebným pro index, protože se tato metadata mění, což způsobuje zvýšená zpoždění a nefektivnosti v procesu aktualizace.
Synchronizace oprávnění mezi indexovaným a zdrojovým obsahem
Povolení rozšíření ACL nebo RBAC na indexeru funguje automaticky pouze ve dvou případech:
Úplně první úplné spuštění indexeru / procházení dat: všechna metadata oprávnění, která v tuto chvíli existují pro každý dokument, se zachytí.
Úplně nové dokumenty přidané po povolení podpory ACL/RBAC: jejich informace ACL/RBAC se ingestují spolu s obsahem.
Pokud změníte oprávnění k dokumentu, jako je přidání uživatele do seznamu ACL nebo aktualizace přiřazení role, tato změna se nezobrazí v indexu vyhledávání, pokud indexeru neoznačíte, aby znovu procházel metadata oprávnění dokumentu.
V závislosti na tom, kolik položek se změnilo, zvolte jeden z následujících mechanismů:
| Rozsah změny | Nejlepší spouštěč | Co se aktualizuje při dalším spuštění |
|---|---|---|
| Jednotlivý blob nebo jen několik | Aktualizace časového razítka Last-Modified objektu blob v úložišti (dotkněte se souboru) |
Dokumentovat obsah a metadata ACL/RBAC |
| Desítky až tisíce blobů | Zavolejte /resetdocs (Preview) a zobrazte seznam klíčů ovlivněných dokumentů. | Dokumentovat obsah a metadata ACL/RBAC |
| Celý zdroj dat | Volejte /resync (preview) s možností oprávnění. | Pouze Metadata ACL/RBAC (obsah zůstává nedotčený) |
Příklad rozhraní API Resetdocs (Preview):
POST https://{service}.search.windows.net/indexers/{indexer}/resetdocs?api-version=2026-08-01-preview
{
  "documentKeys": [
    "1001",
    "4452"
  ]
}
Příklad rozhraní API pro opětovnou synchronizaci (Preview):
POST https://{service}.search.windows.net/indexers/{indexer}/resync?api-version=2026-08-01-preview
{
  "options": [
    "permissions"
  ]
}
Důležité
Pokud změníte oprávnění u indexovaných dokumentů a neaktivujete některý z výše uvedených mechanismů, index vyhledávání bude dál obsluhovat zastaralá data seznamu ACL nebo RBAC. Nové dokumenty se budou dál indexovat automaticky; pro ně není nutná žádná ruční aktivační událost.
Sledování odstranění
Pokud chcete efektivně spravovat odstraňování objektů blob, ujistěte se, že je zapnuté sledování odstranění ještě před tím, než indexer poprvé spustíte. Tato funkce umožňuje systému rozpoznat odstraněné objekty blob ve zdroji a odebrat je z indexu.