Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
Nota
Pesquisa de IA do Azure está disponível por meio do portal Azure, APIs REST e SDKs do Azure. Ele também sustenta o IQ do Foundry, a camada de conhecimento gerenciado que transforma o conteúdo da empresa em bases de conhecimento reutilizáveis e com reconhecimento de permissão para agentes no portal do Microsoft Foundry.
Este artigo explica como atualizar um índice existente em Pesquisa de IA do Azure com alterações de esquema ou alterações de conteúdo por meio da indexação incremental.
Dica
Para atualizar documentos imediatamente, pule para Atualizar conteúdo. Para obter alterações de esquema, consulte Atualizar um esquema de índice.
Pré-requisitos
Um serviço da Pesquisa de IA do Azure (qualquer camada). Criar um serviço ou encontre um existente.
Um índice de pesquisa existente com documentos. Este artigo pressupõe que você já criou um índice e carregou documentos.
Permissões para atualizar ou recompilar índices:
- Autenticação baseada em chave: uma chave de API de administrador para seu serviço de pesquisa.
- Autenticação baseada em função: função Colaborador de Dados de Índice de Pesquisa para atualizações de documentos ou Colaborador do Serviço de Pesquisa para alterações de esquema.
Para desenvolvimento do SDK, instale a biblioteca de clientes do Azure Search:
- Python: azure-search-documents
- .NET: Azure. Search.Documents
- JavaScript: @azure/search-documents
- Java: azure-search-documents
Dica
Durante o desenvolvimento ativo, é comum descartar e recompilar índices ao iterar sobre o design do índice. Trabalhe com uma pequena amostra representativa de dados para que a reindexação seja mais rápida. Para alterações de esquema de produção, crie e teste um novo índice lado a lado e use um alias de índice para trocar índices sem alterar o código do aplicativo.
Atualizar conteúdo
A indexação incremental e a sincronização de um índice em relação às alterações nos dados de origem são fundamentais para a maioria dos aplicativos de pesquisa. Esta seção explica o fluxo de trabalho para adicionar, remover ou substituir o conteúdo de um índice de pesquisa por meio da API REST, mas os SDKs do Azure fornecem funcionalidade equivalente.
O corpo da solicitação contém um ou mais documentos a serem indexados. Na solicitação, cada documento no índice é:
- Identificado por uma chave exclusiva que diferencia maiúsculas de minúsculas.
- Cada documento está associado uma ação: "carregar", "excluir", "mesclar" ou "mergeOrUpload".
- Preenchido com um conjunto de pares nome/valor para cada campo que você está adicionando ou atualizando.
{
  "value": [
    {
      "@search.action": "upload (default) | merge | mergeOrUpload | delete",
      "key_field_name": "unique_key_of_document", (key/value pair for key field from index schema)
      "field_name": field_value (name/value pairs matching index schema)
        ...
    },
    ...
  ]
}
Reference:Documents – Index
Primeiro, use as APIs para carregar documentos, como Documents - Índice (REST) ou uma API equivalente no SDKs do Azure. Para obter mais informações sobre técnicas de indexação, consulte Carregar documentos.
Para uma atualização grande, o envio em lote (até 1.000 documentos por lote ou cerca de 16 MB por lote, o que for o limite primeiro) é recomendado e melhora significativamente o desempenho da indexação.
Defina o
@search.actionparâmetro na API para determinar o efeito nos documentos existentes. UsemergeOrUploadpara atualizações incrementais (mais comuns),deletepara remover documentos oumergepara atualizações parciais de campo em documentos existentes.Ação Efeito excluir Remove todo o documento do índice. Se você quiser remover um campo individual, use mesclagem, definindo o campo em questão como nulo. Documentos e campos excluídos não liberam imediatamente espaço no índice. A cada poucos minutos, um processo em segundo plano executa a exclusão física. Se você usar o portal Azure ou uma API para retornar estatísticas de índice, poderá esperar um pequeno atraso antes que a exclusão seja refletida no portal do Azure e por meio de APIs. Para obter mais informações, consulte Excluir documentos em um índice de pesquisa. merge Atualiza um documento que já existe e falha quando um documento não pode ser encontrado. A mesclagem substitui os valores existentes. Por esse motivo, verifique se há campos de coleção que contêm vários valores, como campos do tipo Collection(Edm.String). Por exemplo, se umtagscampo começa com um valor de["budget"]e você executa uma mesclagem com["economy", "pool"], o valor final dotagscampo é["economy", "pool"]. Não será["budget", "economy", "pool"].
O mesmo comportamento se aplica a coleções complexas. Se o documento contiver um campo de coleção complexo chamado Salas com um valor de[{ "Type": "Budget Room", "BaseRate": 75.0 }], e você executar uma mesclagem com um valor de[{ "Type": "Standard Room" }, { "Type": "Budget Room", "BaseRate": 60.5 }], o valor final do campo Salas será[{ "Type": "Standard Room" }, { "Type": "Budget Room", "BaseRate": 60.5 }]. Ele não acrescentará ou mesclará valores novos e existentes.mesclarOuCarregar Comporta-se como mesclar se o documento existir e fazer upload se o documento for novo. Essa é a ação mais comum para atualizações incrementais. carregamento Semelhante a um "upsert" onde o documento é inserido se for novo e atualizado ou substituído se existir. Se o documento estiver faltando valores que o índice requer, o valor do campo do documento será definido como nulo.
As consultas continuam sendo executadas durante a indexação, mas se você estiver atualizando ou removendo os campos existentes, poderá esperar resultados mistos e uma maior incidência de limitação.
Nota
Não há garantias de ordenação sobre qual ação no corpo da solicitação será executada primeiro. Não é recomendável ter várias ações de "mesclagem" associadas ao mesmo documento em um único corpo de solicitação. Se houver várias ações de "mesclagem" necessárias para o mesmo documento, execute a mesclagem do lado do cliente antes de atualizar o documento no índice de pesquisa.
Respostas
O código de status 200 é retornado para uma resposta bem-sucedida, o que significa que todos os itens foram armazenados de forma durável e começarão a ser indexados. A indexação é executada em segundo plano e disponibiliza novos documentos (ou seja, consultáveis e pesquisáveis) alguns segundos após a conclusão da operação de indexação. O atraso específico depende da carga do serviço.
A indexação bem-sucedida é indicada quando a propriedade de status é definida como true para todos os itens, e a propriedade statusCode é definida como 201 (para documentos recém-carregados) ou 200 (para documentos mesclados ou excluídos):
{
  "value": [
    {
      "key": "unique_key_of_new_document",
      "status": true,
      "errorMessage": null,
      "statusCode": 201
    },
    {
      "key": "unique_key_of_merged_document",
      "status": true,
      "errorMessage": null,
      "statusCode": 200
    },
    {
      "key": "unique_key_of_deleted_document",
      "status": true,
      "errorMessage": null,
      "statusCode": 200
    }
  ]
}
O código de status 207 é retornado quando pelo menos um item não foi indexado com êxito. Os itens que não foram indexados têm o campo de status definido como false. As propriedades errorMessage e statusCode indicam o motivo do erro de indexação.
{
  "value": [
    {
      "key": "unique_key_of_document_1",
      "status": false,
      "errorMessage": "The search service is too busy to process this document. Please try again later.",
      "statusCode": 503
    },
    {
      "key": "unique_key_of_document_2",
      "status": false,
      "errorMessage": "Document not found.",
      "statusCode": 404
    },
    {
      "key": "unique_key_of_document_3",
      "status": false,
      "errorMessage": "Index is temporarily unavailable because it was updated with the 'allowIndexDowntime' flag set to 'true'. Please try again later.",
      "statusCode": 422
    }
  ]
}
A errorMessage propriedade indica o motivo do erro de indexação, se possível.
A tabela a seguir explica os vários códigos de status por documento que podem ser retornados na resposta. Alguns códigos de status indicam problemas com a solicitação em si, enquanto outros indicam condições de erro temporárias. Este último você deve tentar novamente após um atraso.
| Código de status | Significado | Com nova tentativa | Notas |
|---|---|---|---|
| 200 | O documento foi modificado ou excluído com êxito. | n/a | As operações de exclusão são idempotentes. Ou seja, mesmo que uma chave de documento não exista no índice, tentar uma operação de exclusão com essa chave resultará em um código de status 200. |
| 201 | O documento foi criado com êxito. | n/a | |
| 400 | Houve um erro no documento que o impediu de ser indexado. | Não | A mensagem de erro na resposta indica o que há de errado com o documento. |
| 404 | O documento não pôde ser mesclado porque a chave fornecida não existe no índice. | Não | Esse erro não ocorre em carregamentos, uma vez que eles criam novos documentos e não ocorre em exclusões porque elas são idempotentes. |
| 409 | Um conflito de versão foi detectado ao tentar indexar um documento. | Sim | Isso pode acontecer quando você está tentando indexar o mesmo documento mais de uma vez simultaneamente. |
| 422 | O índice está temporariamente indisponível porque foi atualizado com o sinalizador 'allowIndexDowntime' definido como 'true'. | Sim | |
| 429 | Muitas solicitações | Sim | Se você receber esse código de erro durante a indexação, isso geralmente significa que você está com pouco armazenamento. À medida que você se aproxima dos limites de armazenamento, o serviço pode inserir um estado em que você não pode adicionar ou atualizar até que você exclua alguns documentos. Para obter mais informações, consulte Planejar e gerenciar a capacidade se você quiser mais armazenamento ou liberar espaço excluindo documentos. |
| 503 | O serviço de pesquisa está temporariamente indisponível, possivelmente devido à carga pesada. | Sim | Seu código deve aguardar antes de tentar novamente nesse caso ou você corre o risco de prolongar a indisponibilidade do serviço. |
Se o código do cliente frequentemente encontrar uma resposta 207, um motivo possível é que o sistema está sobrecarregado. Você pode confirmar isso verificando a propriedade statusCode para 503. Se o statusCode for 503, recomendamos a limitação de solicitações de indexação. Caso contrário, se o tráfego de indexação não diminuir, o sistema poderá começar a rejeitar todas as solicitações com 503 erros.
O código de status 429 indica que você excedeu sua cota no número de documentos por índice. Você deve atualizar para limites de capacidade mais altos ou criar um novo índice.
Nota
Quando você carrega valores DateTimeOffset com informações de fuso horário no índice, Pesquisa de IA do Azure normaliza esses valores para UTC. Por exemplo, 2024-01-13T14:03:00-08:00 é armazenado como 2024-01-13T22:03:00Z. Se você precisar armazenar informações de fuso horário, adicione uma coluna extra ao índice para esse ponto de dados.
Dicas para indexação incremental
Os indexadores automatizam a indexação incremental. Se você puder usar um indexador e, se a fonte de dados der suporte ao controle de alterações, poderá executar o indexador em um agendamento recorrente para adicionar, atualizar ou substituir o conteúdo pesquisável para que ele seja sincronizado com seus dados externos.
Se você estiver fazendo chamadas de índice diretamente por meio da API de push, use
mergeOrUploadcomo a ação de pesquisa.O conteúdo deve incluir as chaves ou identificadores de cada documento que você deseja adicionar, atualizar ou excluir.
Se o índice incluir campos de vetor e você definir
stored, certifique-se de fornecer o vetor na atualização parcial do documento, mesmo se o valor estiver inalterado. Um efeito colateral da configuraçãostoredcomo false é que os vetores são descartados em uma operação de reindexação. Fornecer o vetor na carga de documentos impede que isso aconteça.Para atualizar o conteúdo de campos e subcampos simples em tipos complexos, liste apenas os campos que você deseja alterar. Por exemplo, se você precisar apenas atualizar um campo de descrição, o conteúdo deverá consistir na chave do documento e na descrição modificada. Omitir outros campos mantém seus valores existentes.
Para mesclar as alterações embutidas na coleção de cadeias de caracteres, forneça o valor completo. Lembre-se do
tagsexemplo de campo da seção anterior. Novos valores substituem os valores antigos de um campo inteiro e não há mesclagem dentro do conteúdo de um campo.
Aqui está um exemplo de API REST demonstrando estas dicas:
### Get Stay-Kay City Hotel by ID
GET  {{baseUrl}}/indexes/hotels-vector-quickstart/docs('1')?api-version=2026-04-01  HTTP/1.1
    Content-Type: application/json
    api-key: {{apiKey}}

### Change the description, city, and tags for Stay-Kay City Hotel
POST {{baseUrl}}/indexes/hotels-vector-quickstart/docs/search.index?api-version=2026-04-01  HTTP/1.1
  Content-Type: application/json
  api-key: {{apiKey}}

    {
        "value": [
            {
            "@search.action": "mergeOrUpload",
            "HotelId": "1",
            "Description": "I'm overwriting the description for Stay-Kay City Hotel.",
            "Tags": ["my old item", "my new item"],
            "Address": {
                "City": "Gotham City"
                }
            }
        ]
    }

### Retrieve the same document, confirm the overwrites and retention of all other values
GET  {{baseUrl}}/indexes/hotels-vector-quickstart/docs('1')?api-version=2026-04-01  HTTP/1.1
    Content-Type: application/json
    api-key: {{apiKey}}
Reference:Documents – Index, Lookup Document
Exemplos do SDK
Os exemplos a seguir mostram como atualizar documentos usando o SDKs do Azure.
from azure.core.credentials import AzureKeyCredential
from azure.search.documents import SearchClient

# Set up the client
service_name = "<your-search-service-name>"
index_name = "hotels-sample"
api_key = "<your-admin-api-key>"

endpoint = f"https://{service_name}.search.windows.net"
credential = AzureKeyCredential(api_key)
client = SearchClient(endpoint=endpoint, index_name=index_name, credential=credential)

# Update documents using merge_or_upload
documents = [
    {
        "HotelId": "1",
        "Description": "Updated description for the hotel.",
        "Tags": ["updated", "renovated"]
    }
]

result = client.merge_or_upload_documents(documents=documents)
print(f"Updated {len(result)} document(s)")
Reference:SearchClient, merge_or_upload_documents
Atualizar um esquema de índice
O esquema de índice define as estruturas de dados físicas criadas no serviço de pesquisa, portanto, não há muitas alterações de esquema que você pode fazer sem incorrer em uma recompilação completa.
Atualizações sem recompilação
A lista a seguir enumera as alterações de esquema que podem ser introduzidas perfeitamente em um índice existente. Em geral, a lista inclui novos campos e funcionalidades usadas durante a execução da consulta.
- Adicionar uma descrição de índice
- Adicionar um novo campo
- Definir o
retrievableatributo em um campo existente - Atualizar
searchAnalyzerem um campo que já possuiindexAnalyzer - Adicionar uma nova definição de analisador em um índice (que pode ser aplicado a novos campos)
- Adicionar, atualizar ou excluir perfis de pontuação
- Adicionar, atualizar ou excluir mapas de sinônimos
- Adicionar, atualizar ou excluir configurações semânticas
- Adicionar, atualizar ou excluir configurações do CORS
A ordem das operações é:
Revise o esquema com atualizações da lista anterior.
Atualize o esquema de índice no serviço de pesquisa.
Atualize o conteúdo do índice para corresponder ao esquema revisado se você adicionou um novo campo. Para todas as outras alterações, o conteúdo indexado existente é usado as-is.
Quando você atualiza um esquema de índice para incluir um novo campo, os documentos existentes no índice recebem um valor nulo para esse campo. No próximo trabalho de indexação, os valores de dados de origem externos substituem os nulos adicionados por Pesquisa de IA do Azure .
Não deve haver interrupções de consulta durante as atualizações, mas os resultados da consulta variarão conforme as atualizações entrarem em vigor.
Atualizações que exigem uma recompilação
Algumas modificações exigem a exclusão e reconstrução de um índice, substituindo um índice atual por um novo.
| Ação | Descrição |
|---|---|
| Excluir um campo | Para remover fisicamente todos os vestígios de um campo, você precisa reconstruir o índice. Quando uma recompilação imediata não é prática, você pode modificar o código do aplicativo para redirecionar o acesso para longe de um campo obsoleto ou usar os searchFields e selecionar parâmetros de consulta para escolher quais campos são pesquisados e retornados. Fisicamente, a definição de campo e o conteúdo permanecem no índice até a próxima recompilação, quando você aplica um esquema que omite o campo em questão. |
| Alterar uma definição de campo | As revisões para um nome de campo, tipo de dados ou atributos de índice específicos (pesquisáveis, filtráveis, classificáveis, facetáveis) exigem uma recompilação completa. |
| Atribuir um analisador a um campo | Os analisadores são definidos em um índice, atribuídos a campos e invocados durante a indexação para informar como os tokens são criados. Você pode adicionar uma nova definição de analisador a um índice a qualquer momento, mas só pode atribuir um analisador quando o campo é criado. Isso é verdadeiro para as propriedades do analisador e do indexAnalyzer . A propriedade searchAnalyzer é uma exceção (você pode atribuir essa propriedade a um campo existente). |
| Atualizar ou excluir uma definição de analisador em um índice | Você não pode excluir ou alterar uma configuração de analisador existente (analisador, tokenizador, filtro de token ou filtro de caractere) no índice, a menos que recompile todo o índice. |
| Adicionar um campo a um sugestor | Se já existir um campo e você quiser adicioná-lo a um constructo de Sugestores , recompile o índice. |
| Atualizar seu serviço ou plano | Se você precisar de mais capacidade, verifique se pode atualizar seu serviço ou mudar para um tipo de preço mais alto. Caso contrário, você deve criar um novo serviço e recompilar seus índices do zero. Para ajudar a automatizar esse processo, você pode usar um exemplo de código que faz backup do índice para uma série de arquivos JSON. Em seguida, você pode recriar o índice em um serviço de pesquisa especificado. |
A ordem das operações é:
Obtenha uma definição de índice caso precise dela para referência futura ou para usar como base para uma nova versão.
Considere usar uma solução de backup e restauração para preservar uma cópia do conteúdo do índice. Há soluções em C# e em Python. Recomendamos a versão Python porque ela está mais atualizada.
Se você tiver capacidade em seu serviço de pesquisa, mantenha o índice existente enquanto cria e testa o novo.
Exclua o índice existente. As consultas direcionadas ao índice são imediatamente descartadas. Lembre-se de que excluir um índice é irreversível, destruindo o armazenamento físico para a coleção de campos e outras construções.
Poste um índice revisado, em que o corpo da solicitação inclui definições e configurações de campo alteradas ou modificadas.
Carregue o índice com documentos de uma origem externa. Os documentos são indexados usando as definições de campo e as configurações do novo esquema.
Quando você cria o índice, o armazenamento físico é alocado para cada campo no esquema de índice, com um índice invertido criado para cada campo pesquisável e um índice de vetor criado para cada campo de vetor. Campos que não são pesquisáveis podem ser usados em filtros ou expressões, mas não têm índices invertidos e não são pesquisáveis por meio de texto completo ou fuzzy. Em uma recompilação de índice, esses índices invertidos e índices vetoriais são excluídos e recriados com base no esquema de índice fornecido.
Para minimizar a interrupção do código do aplicativo, considere a criação de um alias de índice. O código do aplicativo faz referência ao alias, mas você pode atualizar o nome do índice ao qual o alias aponta.
Adicionar uma descrição de índice
Um índice tem uma description propriedade que você pode especificar e usar quando um sistema deve acessar vários índices e tomar uma decisão com base na descrição. Considere um servidor MCP (Model Context Protocol) que deve escolher o índice correto em tempo de execução. A decisão pode ser baseada na descrição e não apenas no nome do índice.
Uma descrição de índice é uma atualização de esquema e você pode adicioná-la sem precisar recompilar todo o índice.
- O comprimento da cadeia de caracteres é máximo de 4.000 caracteres.
- O conteúdo deve ser legível por humanos, no Unicode. Seu caso de uso deve determinar qual idioma usar.
Você pode adicionar uma descrição de índice por meio do portal Azure, da API REST estável mais recente ou de um pacote SDK do Azure que fornece o recurso.
O portal Azure dá suporte à API de versão prévia mais recente.
Acesse o serviço de pesquisa no Azure portal.
Em gerenciamento de pesquisa>Índices, selecione um índice.
Selecione Editar JSON.
Insira
"description", seguido pela descrição. O valor deve ter menos de 4.000 caracteres e em Unicode.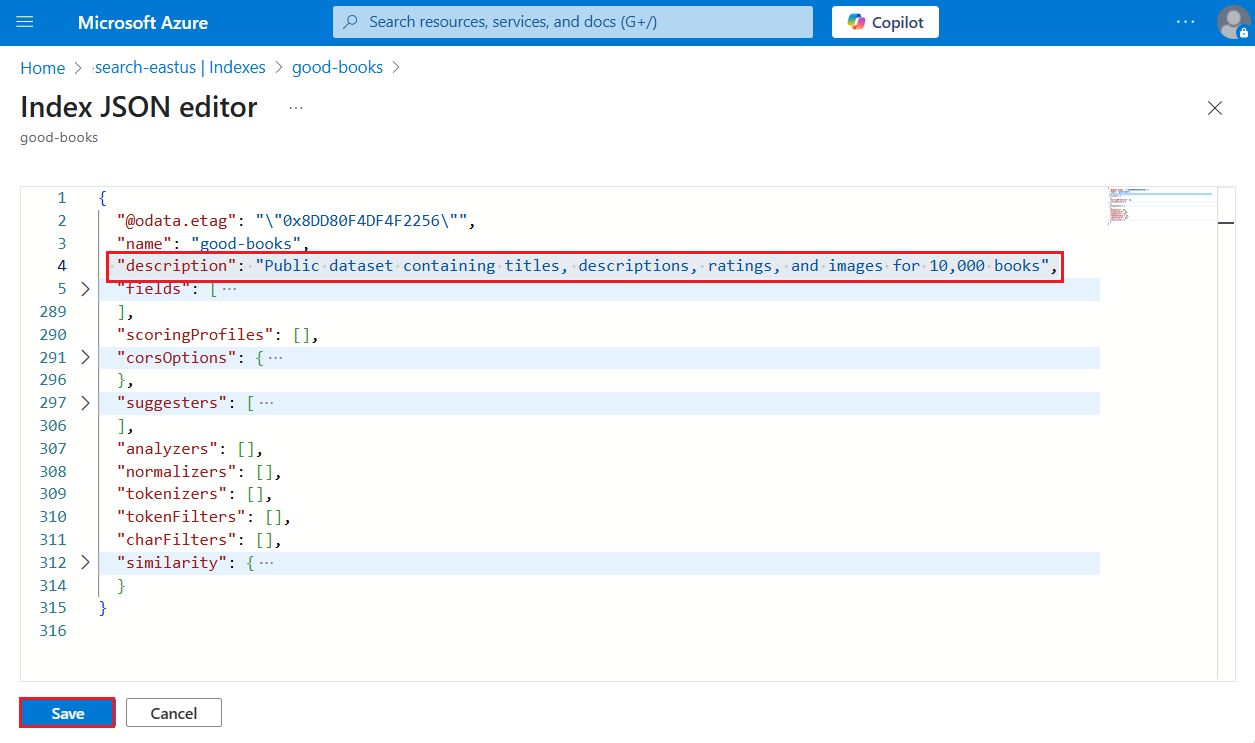
Salve o índice.
Balanceamento de cargas de trabalho
A indexação não é executada em segundo plano, mas o serviço de pesquisa equilibrará todos os trabalhos de indexação em relação a consultas em andamento. Durante a indexação, você pode monitor solicitações de consulta no portal Azure para garantir que as consultas estejam sendo concluídas em tempo hábil.
Se as cargas de trabalho de indexação introduzirem níveis inaceitáveis de latência de consulta, realize a análise de desempenho e examine essas dicas de desempenho para possíveis mitigações.
Verificar se há atualizações
Você pode começar a consultar um índice assim que o primeiro documento for carregado. Se você souber a ID de um documento, a API REST do Documento de Pesquisa retornará o documento específico. Para testes mais amplos, você deve aguardar até que o índice seja totalmente carregado e, em seguida, usar consultas para verificar o contexto que você espera ver.
Você pode usar o Gerenciador de Pesquisa ou um cliente REST para verificar se há conteúdo atualizado.
Se você adicionou ou renomeou um campo, use selecionar para retornar esse campo:
"search": "*",
"select": "document-id, my-new-field, some-old-field",
"count": true
O portal do Azure fornece o tamanho do índice e o tamanho do índice de vetor. Você pode verificar esses valores depois de atualizar um índice, mas lembre-se de esperar um pequeno atraso à medida que o serviço processa a alteração e contabilize as taxas de atualização do portal, o que pode demorar alguns minutos.
Solucionar problemas de reindexação
A tabela a seguir lista problemas comuns ao atualizar ou recompilar índices e como resolvê-los.
| Questão | Causa | Resolução |
|---|---|---|
| Resposta 207 com resultados mistos | Alguns documentos foram bem-sucedidos, outros falharam. | Verifique statusCode para cada documento em resposta. Se 503, restrinja solicitações e tente novamente. |
| Conflito de versão 409 | Atualizações simultâneas para o mesmo documento. | Serialize atualizações no mesmo documento ou implemente a repetição com retirada exponencial. |
| 429 Solicitações demais | Cota de armazenamento excedida ou muitas solicitações simultâneas. | Exclua documentos para espaço livre ou atualize a camada de serviço para obter mais capacidade. |
| Serviço 503 indisponível | Serviço sob carga pesada. | Aguarde e tente novamente com retirada exponencial. Considere reduzir o tamanho do lote. |
| Contagem de documentos inalterada após a exclusão | A exclusão é assíncrona. | Aguarde de 2 a 3 minutos para que o processo em segundo plano conclua a exclusão física. |
| Novo campo retorna nulo | Campo adicionado ao esquema, mas documentos não reindexados. | Execute o indexador ou envie documentos atualizados por push para preencher o novo campo. |
| Alteração de esquema rejeitada | Tentativa de mudança incompatível (renomeação, alteração de tipo). | Descarte e recompile o índice. Use o alias de índice para minimizar o tempo de inatividade. |
Consulte também
- Visão geral do indexador
- Excluir documentos de um índice de pesquisa
- Indexar grandes conjuntos de dados em escala
- Indexação no portal do Azure
- Banco de Dados SQL do Azure indexador
- Indexador do Azure Cosmos DB para NoSQL
- Indexador de blob do Azure
- Azure indexador de tabelas
- Dados, privacidade e proteções internas