Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
Observação
Pesquisa de IA do Azure está disponível por meio do portal Azure, APIs REST e SDKs do Azure. Ele também sustenta o IQ do Foundry, a camada de conhecimento gerenciado que transforma o conteúdo da empresa em bases de conhecimento reutilizáveis e com reconhecimento de permissão para agentes no portal do Microsoft Foundry.
Pesquisa de IA do Azure oferece dois modelos de preços que lidam com a capacidade de forma diferente:
Dedicado: Planeje a capacidade dimensionando réplicas e partições e selecionando um nível de serviço.
- Provisione antecipadamente a capacidade diretamente por meio de réplicas e partições.
- Estimar o armazenamento necessário (partições) e a taxa de transferência necessária (réplicas).
- Escolha uma camada de serviço para provisionar a capacidade necessária com base na demanda de pico esperada.
- Depois de configurar a capacidade antecipadamente, você paga uma taxa por hora medida pelas SUs (Unidades de Pesquisa), independentemente do uso.
Sem servidor (versão prévia): o serviço gerencia automaticamente a capacidade com base nos limites de uso e serviço. Você não precisa provisionar capacidade antecipadamente. Em vez disso, otimize a eficiência da carga de trabalho para gerenciar o custo.
- A capacidade é dimensionada automaticamente com demanda (pode ser dimensionada para zero quando ociosa).
- Você é cobrado com base no uso real, conforme medido por CUs (Unidades de Computação) e armazenamento.
- Em vez de infraestrutura, o planejamento se concentra nesses drivers de custo: padrões de consulta, tamanho e crescimento do índice e padrões de ingestão de dados. Consulte Otimizar o custo para o modelo sem servidor.
| Dimensão | Dedicado | Serverless |
|---|---|---|
| Modelo de capacidade | Provisionado (réplicas × partições) | Baseado no consumo |
| Scaling | Manual | Automatic |
| Controlo do utilizador | Explícito (definir réplicas e partições) | Indireto (influenciado por características de carga de trabalho) |
| Faturamento | Taxa fixa por hora por SUs (Unidades de Pesquisa) | Pagamentos baseados em consumo para CUs (Unidades de Computação) e armazenamento |
| Custo de ociosidade | Sempre incorrido (capacidade mínima provisionada) | É reduzido para zero quando está ocioso |
| Foco de otimização | Dimensionamento de infraestrutura | Eficiência da carga de trabalho |
| Mais adequado para | Cargas de trabalho previsíveis e estáveis | Cargas de trabalho variáveis, intermitentes ou multilocatários, incluindo cenários controlados por agente |
| Abordagem de planejamento de capacidade | Dimensionar e escalar a infraestrutura (réplicas e partições) | Otimizar a eficiência da carga de trabalho e os padrões de uso |
| Impacto da ineficiência | Latência e pressão de escalabilidade | Aumento de custo direto |
Importante
A camada desenvolvedor sem servidor está atualmente em versão prévia. Essa versão prévia é fornecida sem um contrato de nível de serviço e não é recomendada para cargas de trabalho de produção. Alguns recursos podem não ter suporte ou podem ter restrição de recursos. Para obter mais informações, consulte Termos de Uso Complementares para Versões Prévias do Microsoft Azure.
A cobrança da camada Serverless Developer teve início em 13 de setembro de 2026. Os encargos de uso em ou após essa data aparecem em sua fatura Azure. Você não é cobrado pelo uso antes de 13 de setembro de 2026.
A camada de Desenvolvedor sem Servidor não dá suporte à migração para ou de outros tipos de preço e alguns recursos disponíveis em outras camadas não têm suporte durante a Visualização Pública. Limites de serviço, recursos com suporte e detalhes de preços podem ser alterados antes da disponibilidade geral.
Durante a visualização, o modelo de preços sem servidor tem suporte apenas em regiões específicas.
Para saber mais, veja como:
- Planejar e gerenciar custos
- Escolher um modelo de preços e uma camada de serviço
- Otimizar custos com o modelo de preços sem servidor
Planejar a capacidade do modelo dedicado
No modelo Dedicado, você provisiona a capacidade usando SU (Unidades de Pesquisa):
- Unidade de pesquisa (SU) = réplicas × partições
- Réplica: cópias do mecanismo de pesquisa. Fornece taxa de transferência de consulta e alta disponibilidade.
- Partição: unidades de armazenamento. Fornece taxa de transferência de armazenamento e de indexação.
Cada serviço começa com uma réplica × 1 partição (1 SU). Você pode adicionar ou remover réplicas e partições independentemente para acomodar cargas de trabalho flutuantes. Adicionar capacidade aumenta o custo de execução de um serviço de pesquisa.
| Conceito | Definição |
|---|---|
| Unidade de pesquisa | Um único incremento da capacidade total disponível. Um mínimo de uma unidade de pesquisa é necessário para executar o serviço. Dependendo da faixa de preço, o máximo varia de uma a 36 unidades. O número de unidades de pesquisa é igual ao número de réplicas multiplicadas pelo número de partições: R × P = SU. Cada serviço começa com uma réplica e uma partição, que consome uma unidade: 1 × 1 = 1. Adicionar uma segunda réplica consome duas unidades: 2 × 1 = 2. Uma unidade de pesquisa também é a unidade de cobrança de um serviço de pesquisa. |
| Réplica | Instâncias do serviço de pesquisa, usadas principalmente para equilibrar a carga das operações de consulta. Cada réplica hospeda uma cópia de um índice. Se você alocar três réplicas, terá três cópias de um índice disponíveis para atender às solicitações de consulta. |
| Partição | Armazenamento físico e E/S para operações de leitura/gravação (por exemplo, ao recompilar ou atualizar um índice). Cada partição tem uma fatia do índice total. Se você alocar três partições, o índice será dividido em terços. |
Revise a tabela de partições e réplicas para ver as possíveis combinações que não ultrapassem o limite de 36 unidades.
As características físicas de réplicas e partições, como velocidade de processamento e E/S de disco, variam de acordo com a camada de serviço. Em um serviço de pesquisa padrão, as réplicas e partições são mais rápidas e maiores do que as de um serviço básico.
Quando adicionar capacidade para o modelo dedicado
Considere adicionar réplicas ou partições quando:
- A latência da consulta aumenta ou os critérios do acordo de nível de serviço não são atendidos.
- A frequência de erros HTTP 503 (Serviço indisponível) aumenta.
- A frequência de erros HTTP 429 (solicitações em excesso) aumenta, indicando limitação de taxa das solicitações.
- Grandes volumes de consulta são esperados.
- Os trabalhos de indexação estão lentos ou ficando para trás.
- A capacidade de processamento de armazenamento ou indexação é insuficiente.
Diretrizes de dimensionamento:
- Adicione réplicas para aumentar a taxa de transferência de consultas e a disponibilidade.
- Adicione partições para aumentar o desempenho de armazenamento e indexação.
- Cargas de trabalho pesadas de consulta normalmente exigem mais réplicas.
- Índices grandes podem exigir réplicas extras para manter o desempenho.
Importante
As operações de dimensionamento podem levar tempo para serem concluídas e aumentar o custo. Sempre valide as alterações usando testes de desempenho e estimativas de preços.
A camada de serviço escolhida determina o tamanho e a velocidade da partição. Cada camada é otimizada em torno de um conjunto de características que se ajustam a vários cenários. Se você escolher uma camada superior, poderá precisar de menos partições do que se você usar a S1. Uma das perguntas que você precisa responder ao conduzir testes autodirigidos é se uma partição maior e mais cara oferece melhor desempenho do que duas partições mais baratas em um serviço provisionado em um nível inferior.
Um único serviço deve ter recursos suficientes para manipular todas as cargas de trabalho (indexação e consultas). Nenhuma carga de trabalho é executada em segundo plano. Você pode agendar a indexação para horários em que as solicitações de consulta são naturalmente menos frequentes, mas o serviço não prioriza uma tarefa em vez de outra. Além disso, certa quantidade de redundância otimizará o desempenho da consulta quando os serviços ou nós forem atualizados internamente.
Como regra geral, os aplicativos de pesquisa tendem a precisar de mais réplicas do que partições, especialmente quando as operações de serviço são direcionadas para demandas de consulta. Cada réplica é uma cópia do seu índice. Portanto, o serviço pode realizar o balanceamento de carga das solicitações nas várias cópias. Pesquisa de IA do Azure gerencia todo o balanceamento de carga e a replicação de um índice. Você pode alterar o número de réplicas alocadas para seu serviço a qualquer momento. É possível alocar até 12 réplicas em um serviço de pesquisa Standard e três réplicas em um serviço de pesquisa Básico. Você pode configurar a alocação de réplicas usando o portal do Azure ou uma das opções programáticas.
Partições extras são úteis para cargas de trabalho de indexação intensiva. Partições extras espalham operações de leitura e gravação em um número maior de recursos de computação.
Por fim, índices maiores levam mais tempo para consultar. Assim, você poderá perceber que cada aumento incremental em partições requer um aumento proporcional, mas menor, em réplicas. A complexidade e o volume de suas consultas influenciam a rapidez com que a execução da consulta é realizada.
Para limites de serviço e intervalos de dimensionamento válidos, consulte:
Observação
Adicionar mais réplicas ou partições aumenta o custo da execução do serviço e pode causar pequenas variações na ordenação dos resultados. Verifique a calculadora de preços para entender as implicações de cobrança da adição de mais nós. A tabela de combinações de partição e réplica pode ajudá-lo a fazer referência cruzada ao número de unidades de pesquisa necessárias para uma configuração específica. Para obter mais informações sobre como réplicas extras afetam o processamento de consultas, consulte Ordenando resultados.
Como gerenciar e ajustar a capacidade
A alteração de capacidade não é instantânea. Dependendo do volume de dados e do tipo de operação, o dimensionamento pode levar de minutos a várias horas.
Ao escalar um serviço de pesquisa, você pode escolher entre as seguintes ferramentas e abordagens:
Observação
Se o serviço de pesquisa tiver sido criado antes de abril ou maio de 2024, ele poderá ser qualificado para uma atualização única para uma infraestrutura mais recente com tamanhos de partição maiores sem custo adicional. Essa atualização pode aumentar o armazenamento disponível por partição e reduzir o número de partições necessárias para sua carga de trabalho. Para obter mais informações, consulte Atualizar seu serviço de pesquisa.
Para aumentar ou diminuir a capacidade do serviço, você tem duas opções:
Adicionar ou remover partições e réplicas
Acesse o serviço de pesquisa no Azure portal.
No painel à esquerda, selecione Configurações>Escala.
A captura de tela a seguir mostra um serviço Standard provisionado com uma réplica e uma partição. A fórmula na parte inferior indica quantas unidades de pesquisa estão sendo usadas (1). Se o preço unitário era US$ 100 (preço fictício), o custo mensal da execução desse serviço seria de US$ 100 em média.
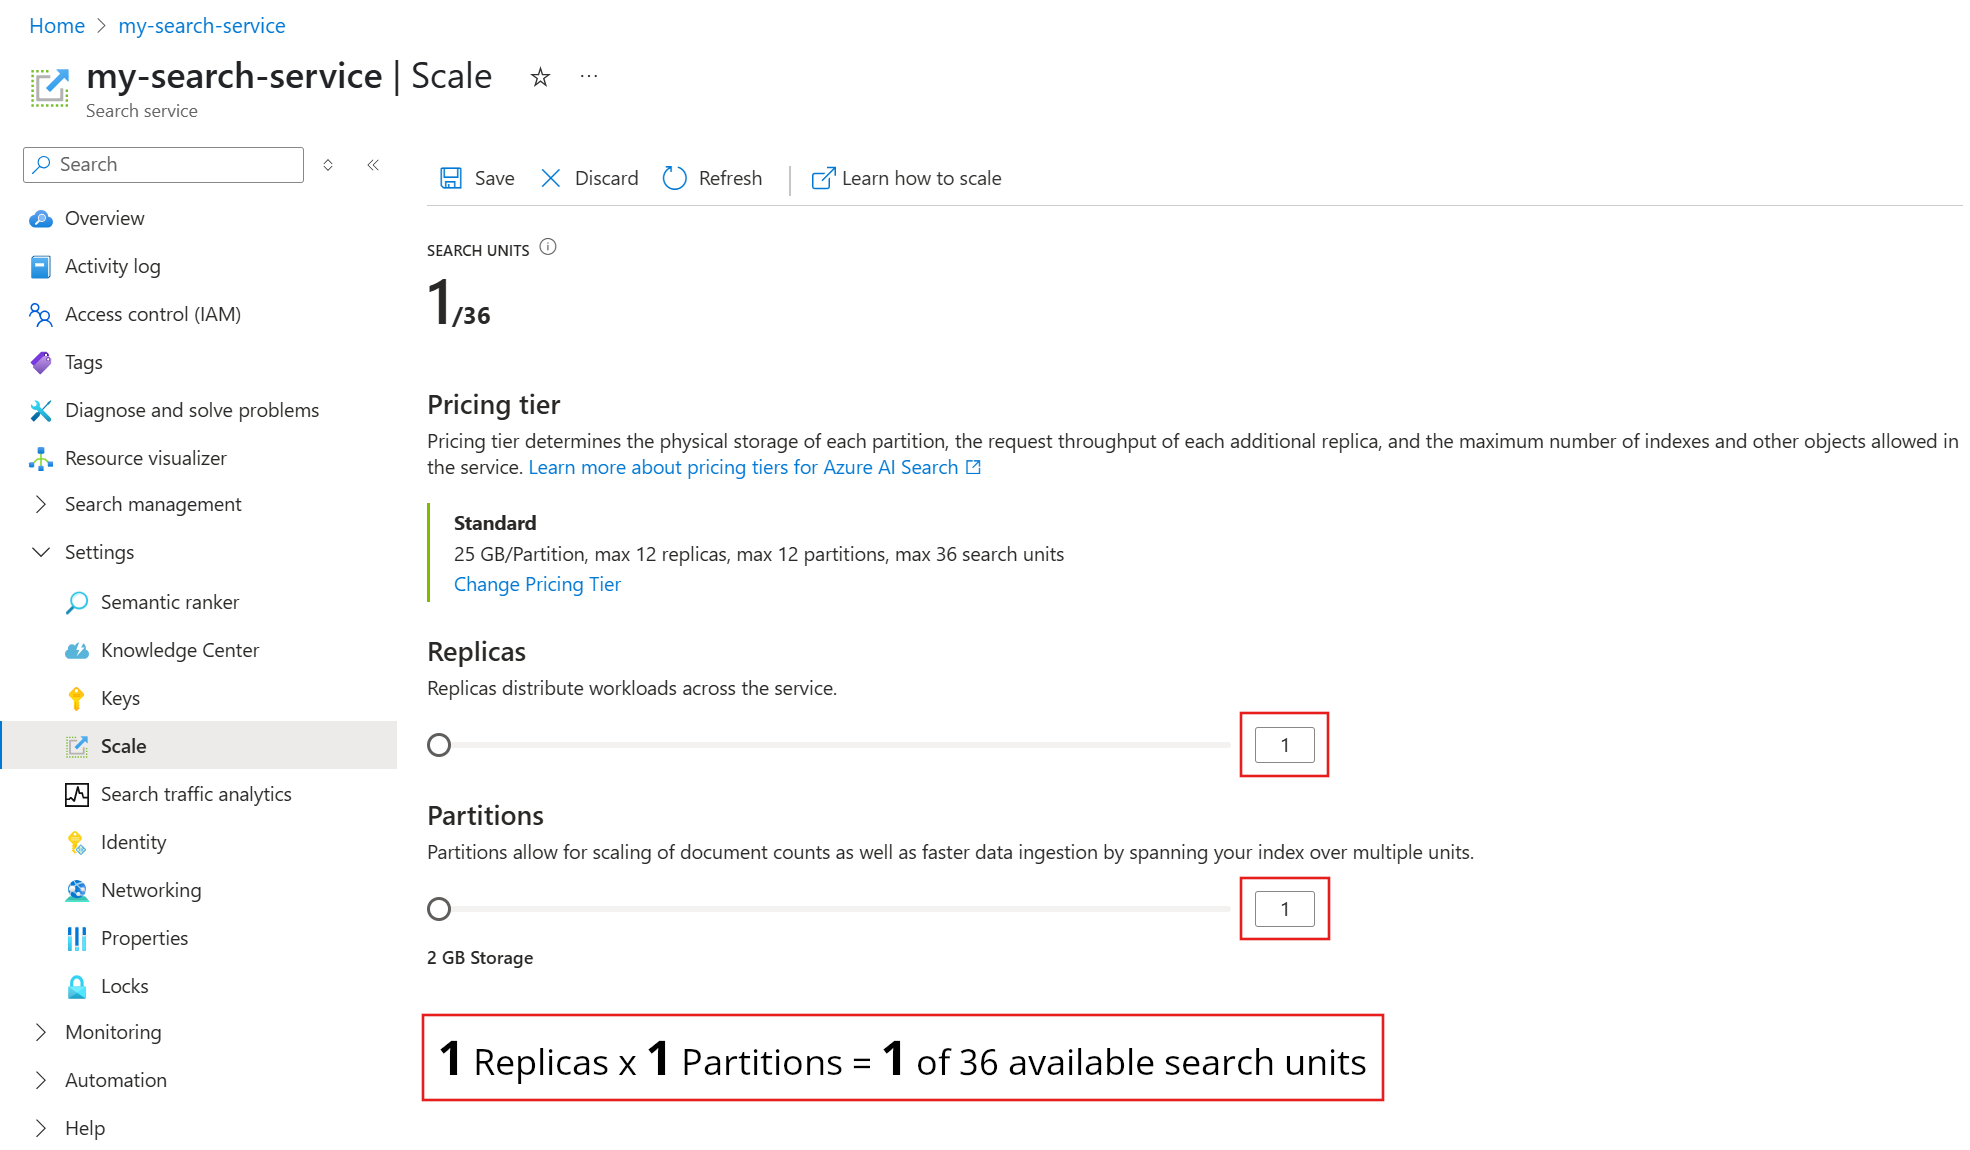
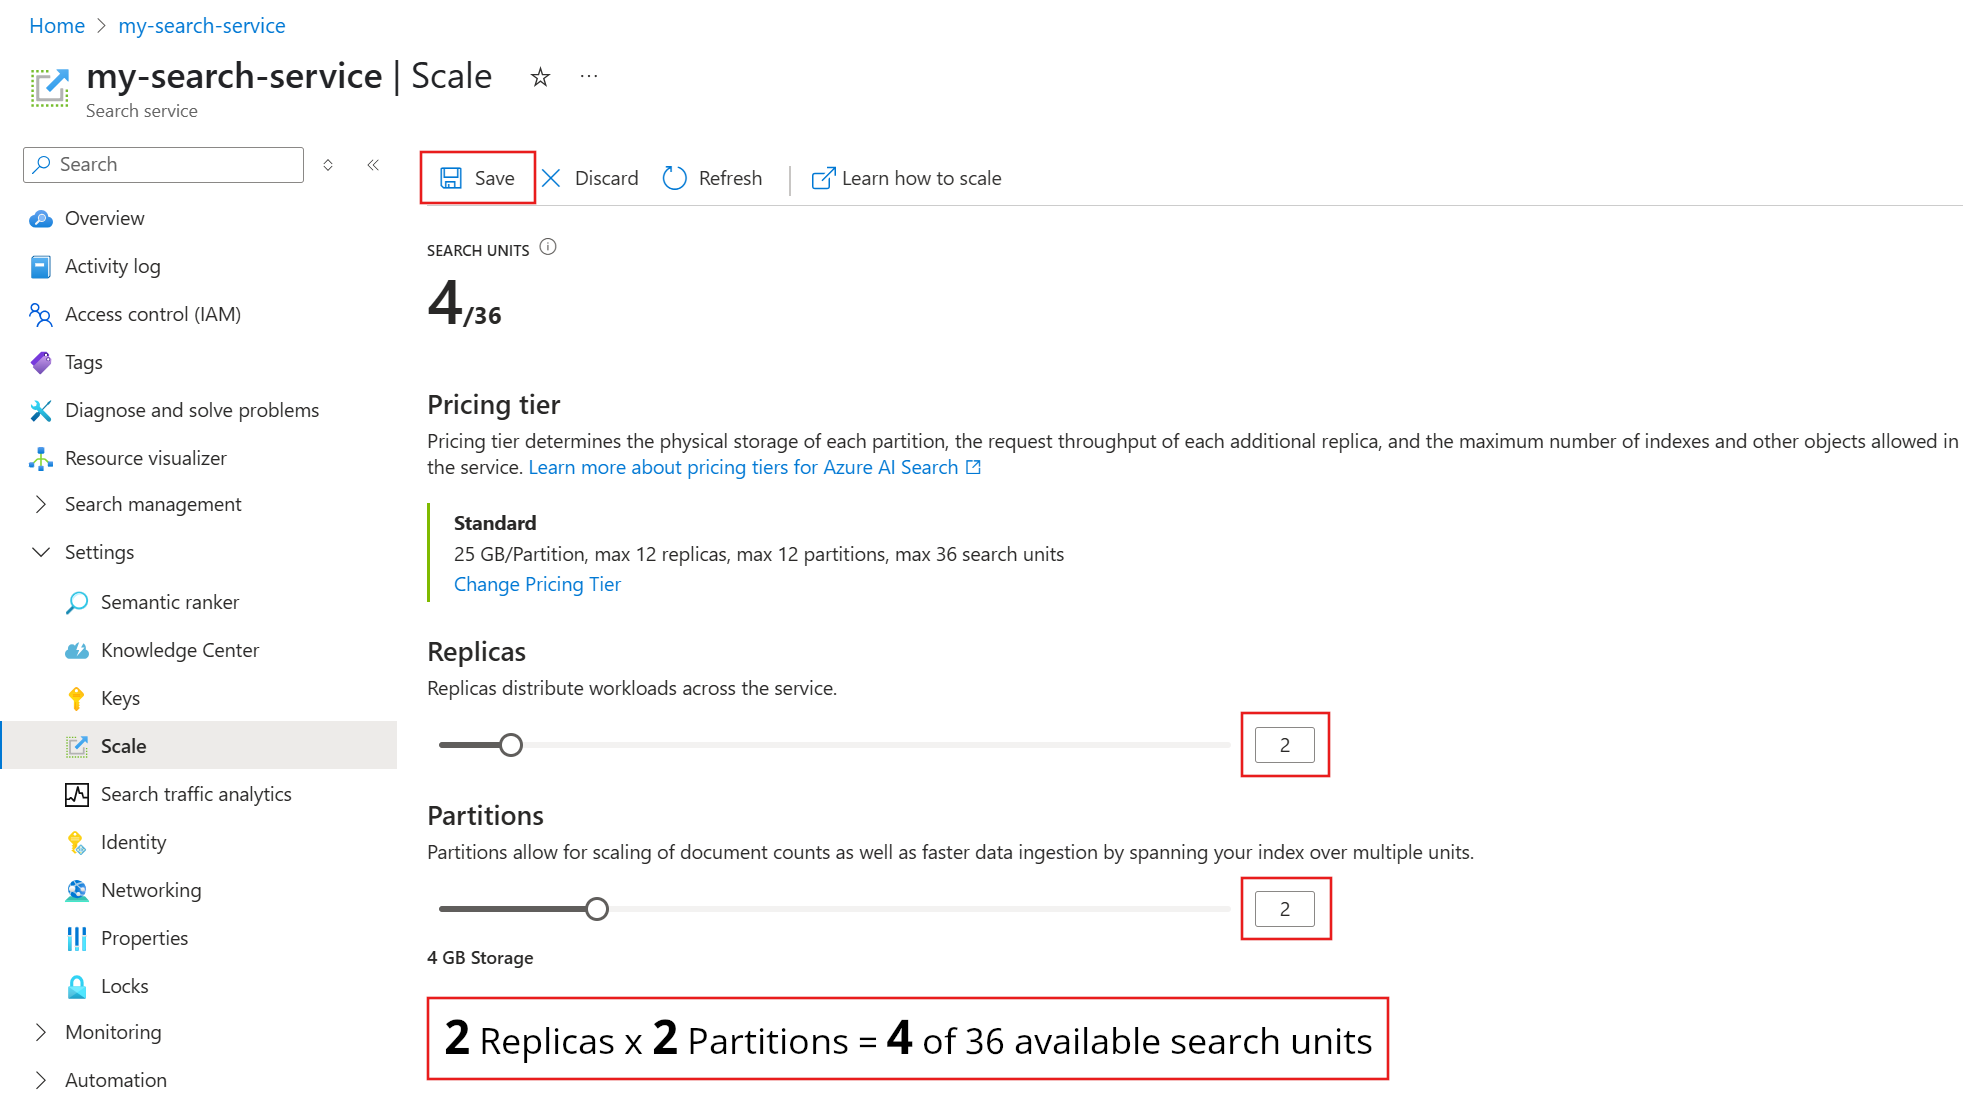
Use o controle deslizante para aumentar ou diminuir o número de partições e, em seguida, selecione Salvar.
Este exemplo adiciona uma segunda réplica e partição. Observe a contagem de unidades de pesquisa. No momento, a contagem é quatro porque a fórmula de cobrança é o resultado das réplicas multiplicadas pelas partições (2 x 2). Dobrar a capacidade mais que dobra o custo da execução do serviço. Se o custo da unidade de pesquisa fosse US$ 100, a nova fatura mensal seria US$ 400.
Para obter os custos atuais por unidade de cada camada, visite a página de preços.
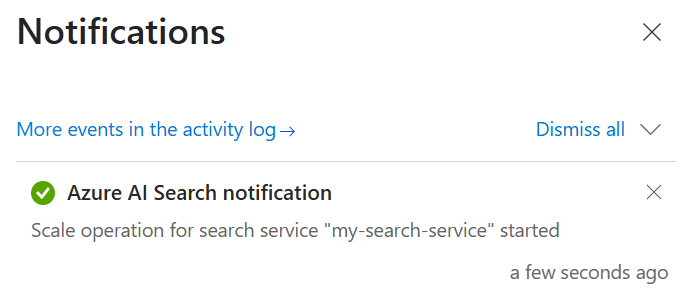
Verifique suas notificações para confirmar se a operação foi iniciada.
Essa operação pode levar várias horas para ser concluída. Ele ocorre em segundo plano, portanto, seu serviço de pesquisa permanece totalmente operacional e disponível para operações de leitura e gravação.
Você não pode cancelar a operação nem monitorar seu progresso. No entanto, a mensagem a seguir é exibida enquanto as alterações estão em andamento.
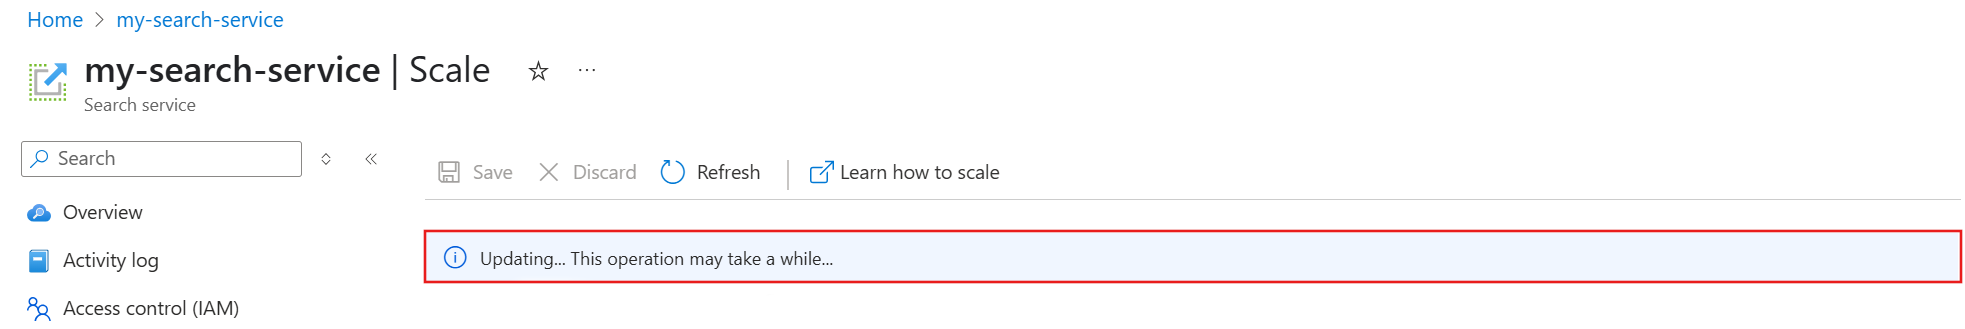
Alterar sua faixa de preço
Observação
O portal Azure e Services – Atualização (API REST) suportam alterações entre as camadas Básica e Standard (S1, S2 e S3). Você pode atualizar ou fazer downgrade de camadas, desde que sua configuração de serviço atual não exceda os limites da camada de destino. Sua região também não pode ter restrições de capacidade na camada de destino.
Sua camada de preço determina qual é o armazenamento máximo do seu serviço de busca para o modelo de preço Dedicado. Se você precisar de mais ou menos capacidade, poderá alternar para um tipo de preço diferente que acomode suas necessidades de armazenamento. (Isso se aplica somente às camadas de modelo de preços dedicados. A camada de desenvolvedor do modelo sem servidor não pode ser alterada depois de selecionada).
Além da capacidade, os tipos de preço determinam limites de índices, indexadores e outros objetos de pesquisa. Compare os limites de serviço da camada atual e da camada desejada antes de prosseguir. Em geral, mudar para uma camada mais alta aumenta o limite de armazenamento e o limite de vetor, aumenta a taxa de transferência de solicitação e diminui a latência, enquanto alternar para uma camada inferior tem o efeito oposto.
A mudança para um tipo de preço mais alto também aumenta o custo de execução do serviço de pesquisa. Para saber mais, confira a página de preço.
Para alterar o tipo de preço:
Acesse o serviço de pesquisa no Azure portal.
No painel à esquerda, selecione Configurações>Escala.
Na camada atual, selecione Alterar Tipo de Preço.
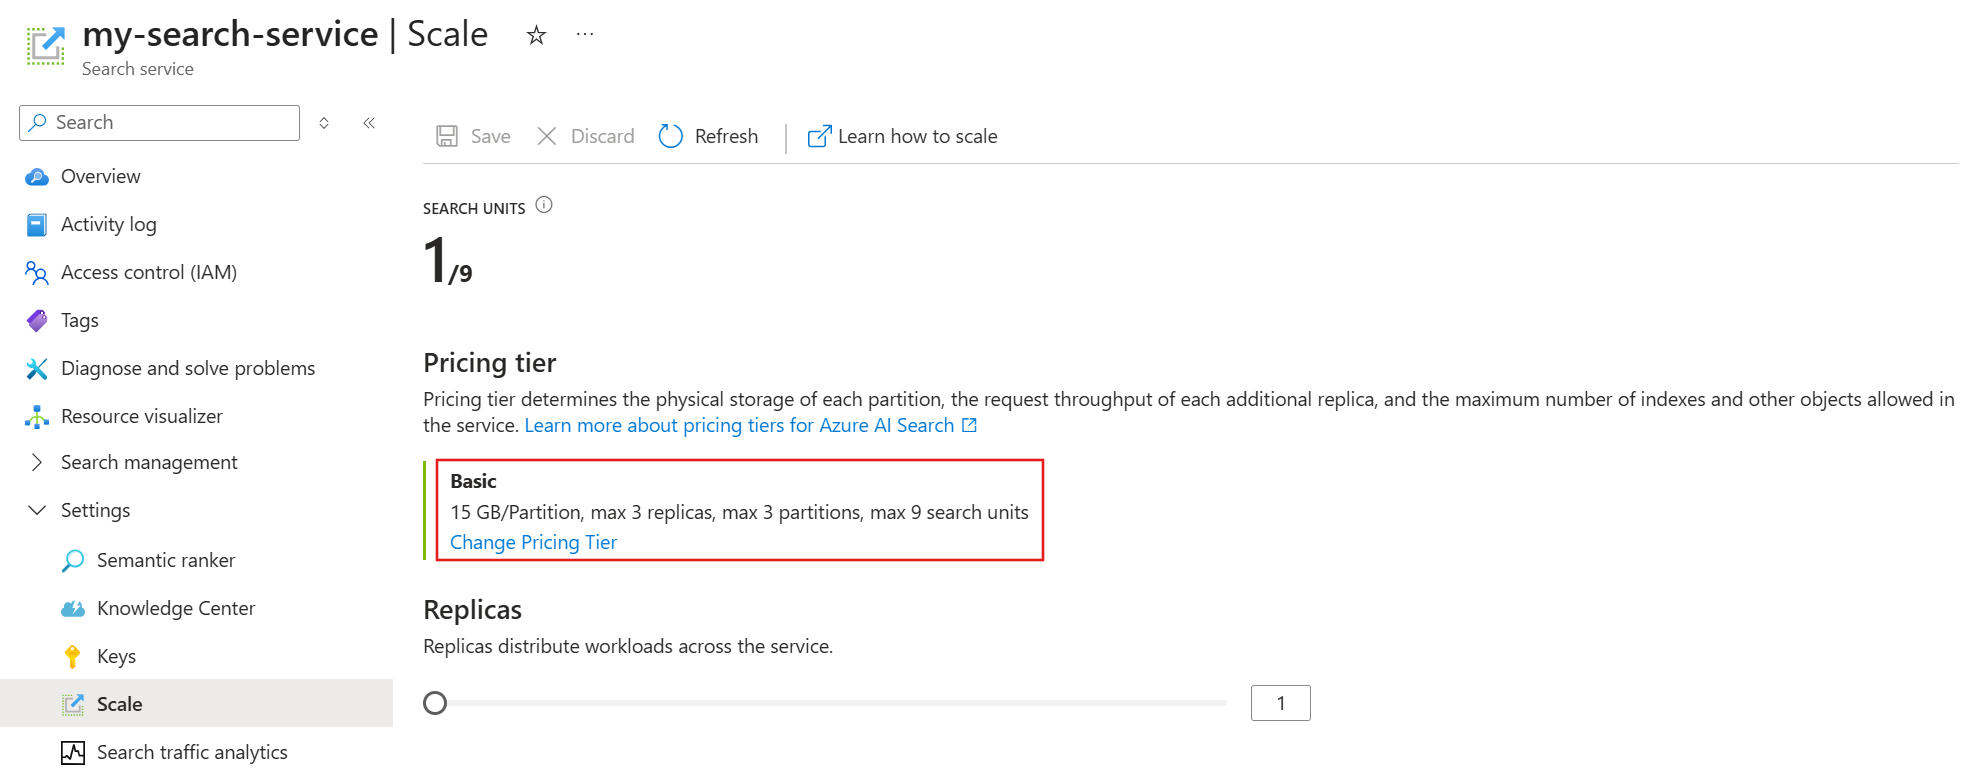
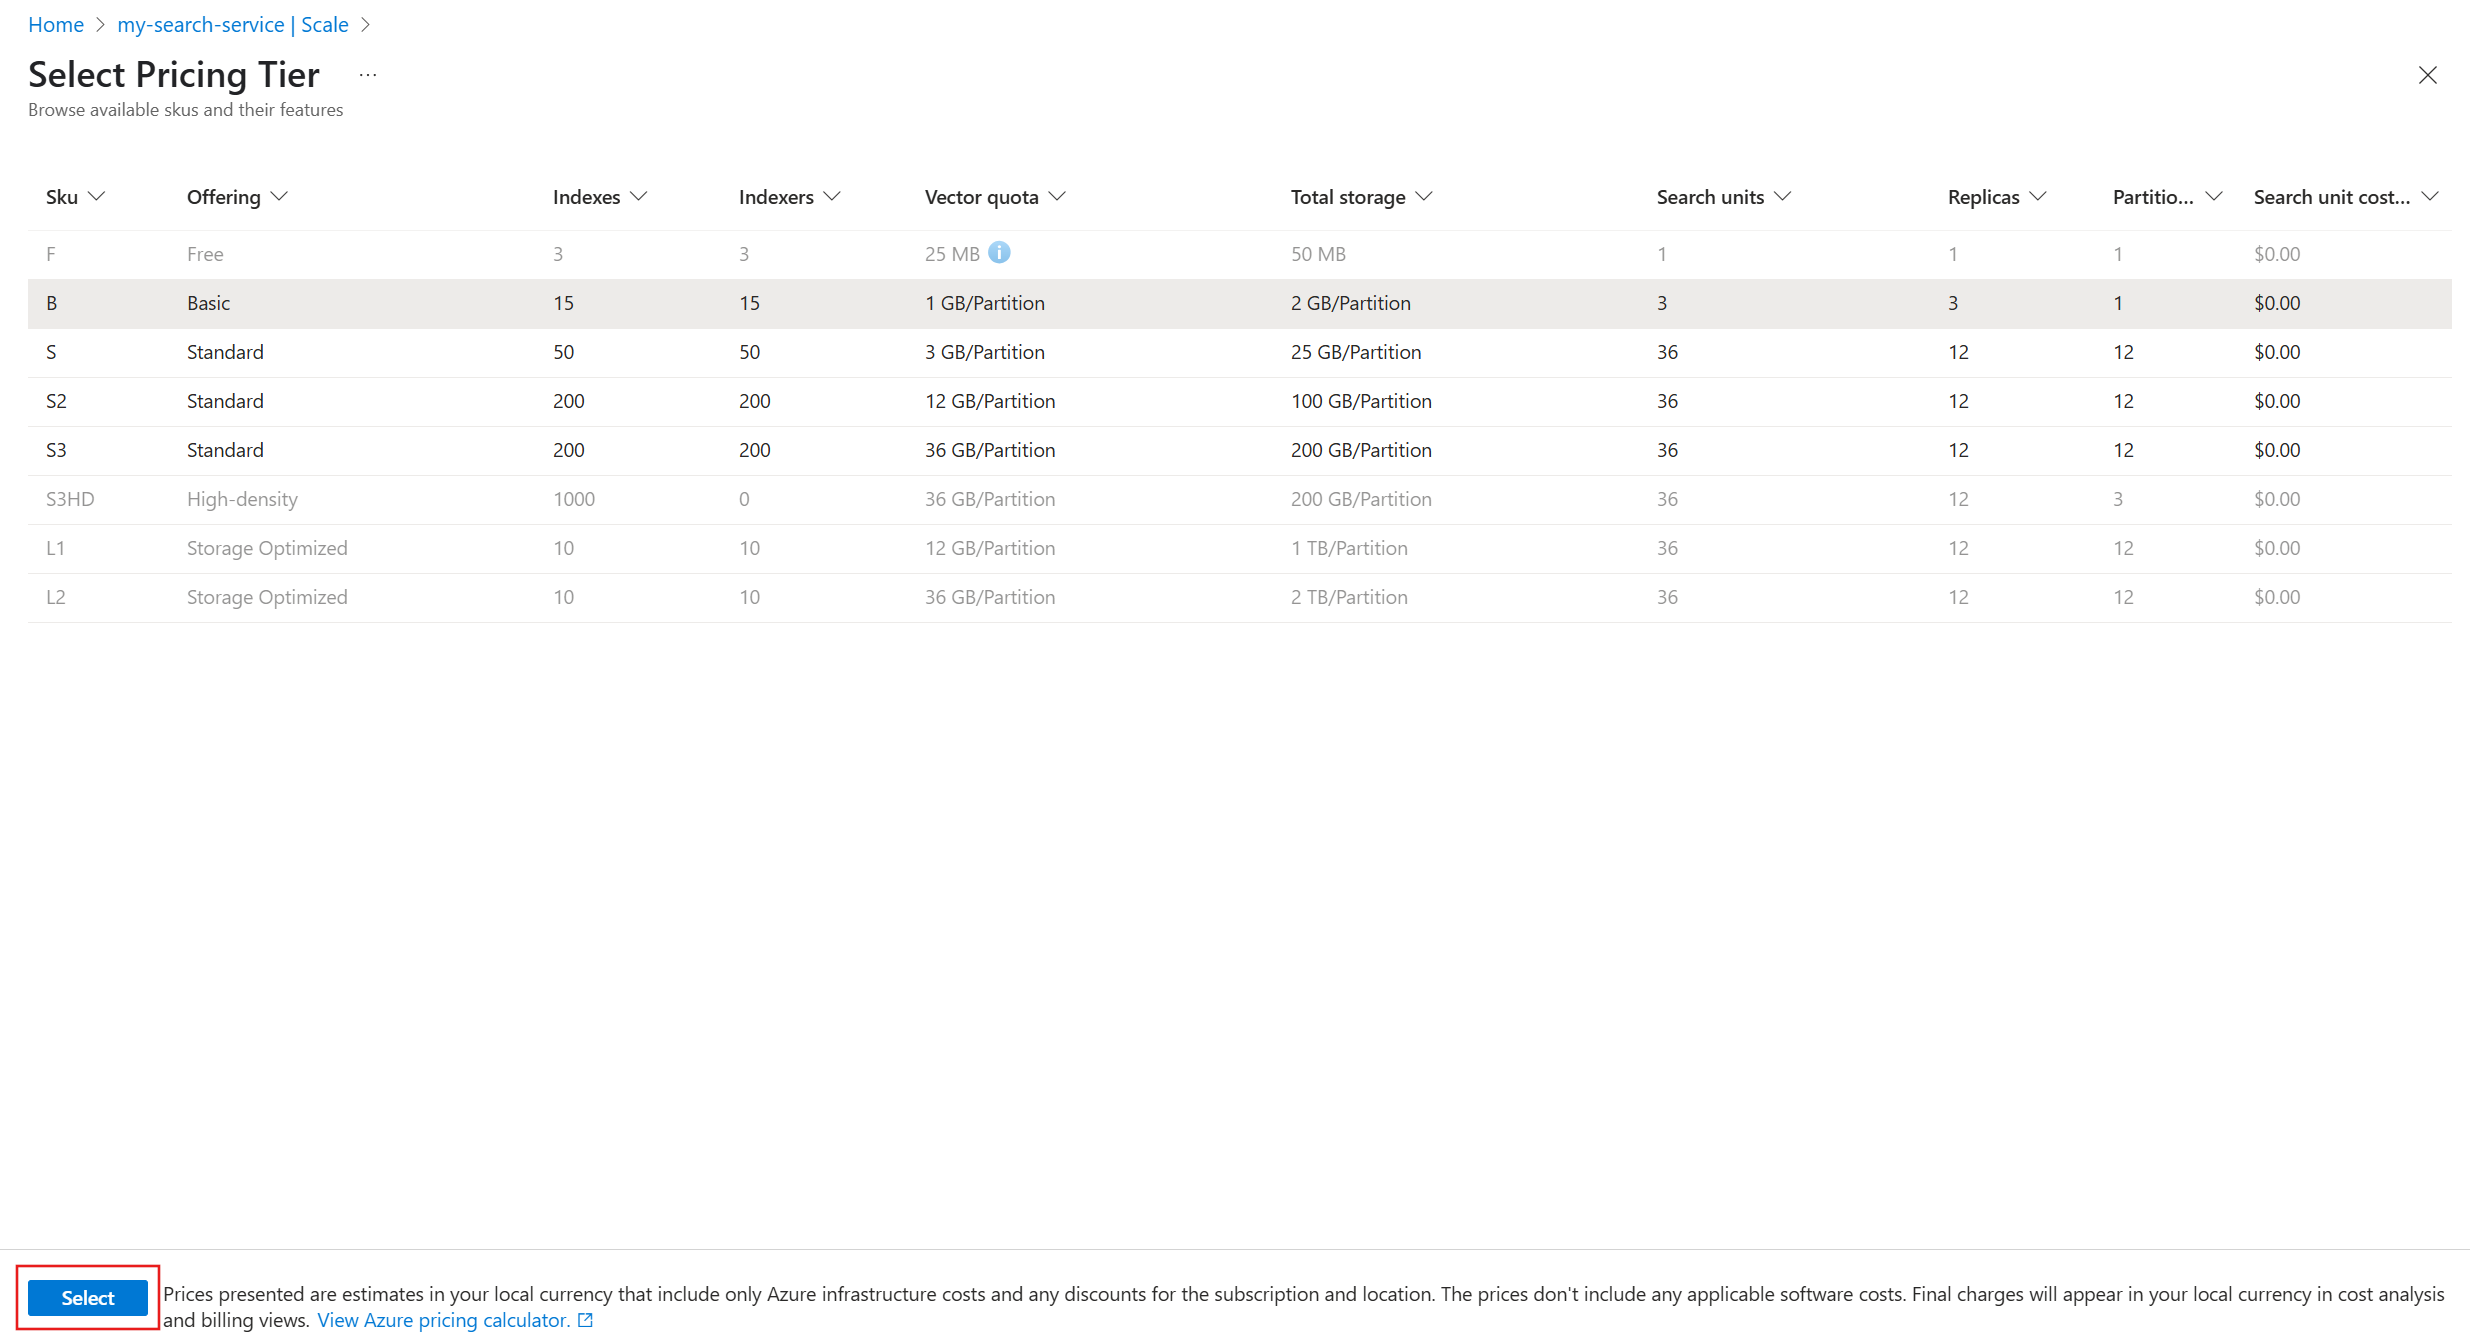
Na página Selecionar Tipo de Preço, escolha um tipo diferente na lista.
Você pode alternar entre Basic, S1, S2 e S3, mas não pode alternar para ou de Gratuito, S3HD, L1 ou L2. Esses níveis não são selecionáveis e aparecem acinzentados.
Para iniciar a operação de escala, selecione Salvar.
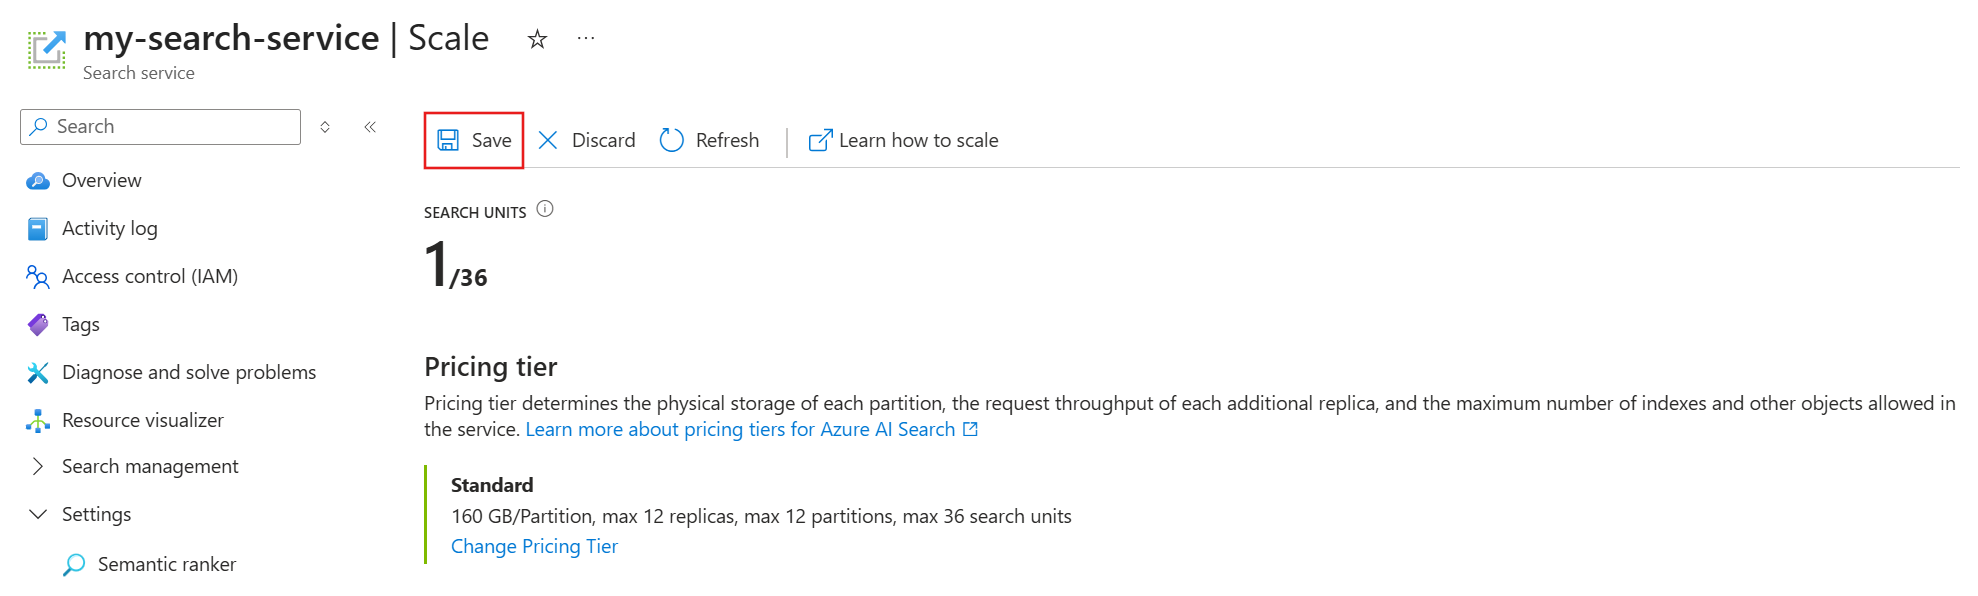
Essa operação pode levar várias horas para ser concluída. Ele ocorre em segundo plano, portanto, seu serviço de pesquisa permanece totalmente operacional e disponível para operações de leitura e gravação.
Você não pode cancelar a operação nem monitorar seu progresso. No entanto, a mensagem a seguir é exibida enquanto as alterações estão em andamento.
Como as solicitações de escala são tratadas para o modelo dedicado
Quando o serviço de busca recebe uma solicitação de escalonamento, ele:
- Verifica se a solicitação é válida.
- Inicia o backup de dados e informações do sistema.
- Verifica se o serviço já está em um estado de provisionamento (atualmente adicionando ou eliminando réplicas ou partições).
- Inicia o provisionamento.
O dimensionamento de um serviço pode levar de vários minutos a várias horas, dependendo do tamanho do serviço e do escopo da solicitação. A duração do backup também varia de acordo com a quantidade de dados e o número de partições e réplicas.
As etapas para lidar com uma solicitação de escala não são totalmente consecutivas. Por exemplo, o sistema iniciará o provisionamento quando ele puder fazer isso com segurança, o que pode ser enquanto o backup estiver terminando.
Erros durante o escalonamento
A tabela a seguir lista causas e soluções para erros que podem ocorrer durante operações de dimensionamento.
| Mensagem de erro | Motivo | Solução |
|---|---|---|
| "Operações de atualização de serviço não são permitidas no momento, pois estamos processando uma solicitação anterior." | Outra operação de dimensionamento está em andamento. | Verifique a página Overview no portal do Azure ou use a API REST Search Management, Azure PowerShell ou CLI do Azure para obter o status do serviço de pesquisa. Se o status for "Provisionamento", aguarde até que ele se torne "Concluído" ou "Falhou" antes de tentar novamente. 1, 2 |
| Falha ao dimensionar o serviço de pesquisa nome do serviço. Erro: a contagem de ObjectActualCount excede o limite permitido: MaximumCount." | Sua configuração de serviço atual excede os limites do tipo de preço de destino. | Verifique se o uso de armazenamento, o uso de vetores, índices, indexadores e outros objetos se ajustam aos limites de serviço da camada inferior. Por exemplo, a camada Básica dá suporte a até 15 índices, portanto, você não poderá alternar de S1 para Basic se tiver 16 índices. Ajuste seus recursos antes de tentar novamente. |
1 Não há status para backups, que são operações internas que provavelmente não interromperão uma escala.
2 Se o serviço de pesquisa parecer travado em um estado de provisionamento, verifique se há índices órfãos que não podem ser usados, com volume de consultas zero e nenhuma atualização de índice. Um índice inutilizável pode bloquear alterações na capacidade do serviço. Em particular, procure índices CMK criptografados cujas chaves não são mais válidas. Exclua o índice ou restaure as chaves para colocá-lo online novamente e desbloquear a operação de escala.
Combinações de partição e réplica
O gráfico a seguir se aplica à camada Standard e superior. Ele mostra todas as combinações possíveis de partições e réplicas, sujeitas ao máximo de 36 unidades de pesquisa por serviço.
| 1 partição | 2 partições | 3 partições | 4 partições | 6 partições | 12 partições | |
|---|---|---|---|---|---|---|
| 1 réplica | 1 SU | 2 SU | 3 SU | 4 SU | 6 SU | 12 SU |
| 2 réplicas | 2 SU | 4 SU | 6 SU | 8 SU | 12 SU | 24 SU |
| 3 réplicas | 3 SU | 6 SU | 9 SU | 12 SU | 18 SU | 36 SU |
| 4 réplicas | 4 SU | 8 SU | 12 SU | 16 SU | 24 SU | N/D |
| 5 réplicas | 5 SU | 10 SU | 15 SU | 20 SU | 30 SU | N/D |
| 6 réplicas | 6 SU | 12 SU | 18 SU | 24 SU | 36 SU | N/D |
| 12 réplicas | 12 SU | 24 SU | 36 SU | N/D | N/D | N/D |
Os serviços de pesquisa básicos têm contagens de unidades de pesquisa menores.
Nos serviços de pesquisa criados antes de 3 de abril de 2024, os serviços Básicos podem ter exatamente uma partição e até três réplicas, para um limite máximo de três SUs. O único recurso ajustável são as réplicas. No entanto, você pode aumentar a contagem de partições atualizando seu serviço.
Nos serviços de pesquisa criados após 3 de abril de 2024 em regiões com suporte, os serviços básicos podem ter até três partições e três réplicas. O limite máximo de unidade de armazenamento é nove para dar suporte a um complemento completo de partições e réplicas.
Para os serviços de pesquisa em qualquer camada faturável, independentemente da data de criação, você precisará de, no mínimo, duas réplicas para alta disponibilidade em consultas.
Para obter taxas de cobrança por camada e moeda, consulte a página de preços Pesquisa de IA do Azure .
Estimar a capacidade usando um tipo de modelo de preço dedicado
Suas necessidades de armazenamento dependem do tamanho dos índices que você espera criar. Não há nenhuma heurística sólida ou diretrizes gerais que ajudem com estimativas. A única maneira de determinar o tamanho de um índice é compilar um. Seu tamanho depende da tokenização e das inserções e se você habilita sugestores, filtragem e classificação ou pode aproveitar a compactação de vetor.
Estime a capacidade em um nível pago, básico ou superior. A camada Gratuita é executada em recursos físicos compartilhados por vários clientes e está sujeita a fatores fora do seu controle. Apenas os recursos dedicados de um serviço de pesquisa com cobrança podem acomodar tempos de amostragem e processamento maiores para estimativas mais realistas da quantidade de índices, tamanho e volumes de consulta durante o desenvolvimento.
Examine os limites de serviço em cada camada para determinar se as camadas mais baixas podem dar suporte ao número de índices que você precisa. Considere se você precisa de várias cópias de um índice para desenvolvimento ativo, testes e produção.
Um serviço de pesquisa está sujeito a limites de objeto (número máximo de índices, indexadores, conjuntos de habilidades e assim por diante) e limites de armazenamento. O limite que for atingido primeiro é o limite efetivo.
Crie um serviço em uma camada faturável. As camadas são otimizadas para determinadas cargas de trabalho. Por exemplo, a camada Otimizada para Armazenamento tem um limite de 10 índices porque foi projetada para dar suporte a um número baixo de índices grandes.
Comece em um nível mais baixo, como Básica ou S1, se você não tiver certeza da carga projetada.
Comece em um nível alto, como S2 ou até mesmo S3, se o teste incluir cargas de consulta e indexação em grande escala.
Comece com Otimizado para Armazenamento, em L1 ou L2, se você estiver indexando uma grande quantidade de dados e a carga de consulta for relativamente baixa, assim como em um aplicativo de negócios interno.
Criar um índice inicial para determinar como a fonte de dados traduz para um índice. Essa é a única maneira de estimar o tamanho do índice. Os atributos nas definições de campo afetam os requisitos de armazenamento físico:
Para a pesquisa de palavras-chave, marcar os campos como filtráveis e classificáveis aumenta o tamanho do índice.
Para busca em vetores, você pode definir parâmetros para reduzir o tamanho do vetor.
Monitore o armazenamento, os limites de serviço, o volume de consulta e a latência no portal do Azure. O portal do Azure mostra consultas por segundo, consultas limitadas e latência de pesquisa. Esses valores podem ajudá-lo a decidir se você selecionou a camada certa.
Adicione réplicas para alta disponibilidade ou para mitigar o desempenho lento de consultas.
Não há diretrizes sobre quantas réplicas são necessárias para acomodar as cargas de consulta. O desempenho da consulta depende da complexidade da consulta e das cargas de trabalho concorrentes. Embora a adição de réplicas definitivamente melhore o desempenho, o resultado não é estritamente linear: a adição de três réplicas não garante o triplo da taxa de transferência. Para orientações sobre como estimar o QPS da sua solução, consulte Analisar o desempenho e Monitorar consultas.
Para um índice invertido, o tamanho e a complexidade são determinados pelo conteúdo, não necessariamente pela quantidade de dados que você alimenta nele. Uma fonte de dados grande com alta redundância pode resultar em um índice menor do que um conjunto de dados menor que contém um conteúdo altamente variável. Portanto, é raramente possível inferir o tamanho de índice com base no tamanho do conjunto de dados original.
Os requisitos de armazenamento podem ser inflados se você incluir dados que você nunca pesquisa. Idealmente, os documentos contêm apenas os dados necessários para a experiência de pesquisa.
Considerações sobre o contrato de nível de serviço
Os SLAs (contratos de nível de serviço) não abrangem a camada gratuita e os recursos de visualização. Para todas as camadas faturáveis, os SLAs entram em vigor quando você provisiona redundância suficiente para o serviço.
Duas ou mais réplicas satisfazem os SLAs de consulta (leitura).
Três ou mais réplicas satisfazem os SLAs de consulta e indexação (leitura e gravação).
O número de partições não afeta os SLAs.
Otimizar o custo para o modelo sem servidor
No modelo de preços sem servidor:
- O serviço gerencia automaticamente a capacidade.
- Você não precisa configurar réplicas, partições ou unidades de pesquisa.
- A computação é dimensionada dinamicamente com base na carga de trabalho (demanda de consulta e indexação) e pode ser dimensionada para zero quando ociosa.
Para saber mais sobre limitações para o modelo sem servidor, consulte os limites de serviço.
A cobrança é baseada em duas dimensões:
- Uso de computação (CUs): Cobrado com base em operações de consulta e indexação.
- Armazenamento indexado: Cobrado por GB por mês.
Como a cobrança é baseada em consumo, o custo está diretamente vinculado ao uso:
- Consultas complexas consomem mais computação.
- O design de esquema ineficiente aumenta os custos de indexação e consulta.
- Padrões de consulta ruins com índices grandes ou frequentemente atualizados aumentam o uso de armazenamento e computação.
Otimizar a eficiência da carga de trabalho
Como a ineficiência aparece como custo no modelo sem servidor, você paga mais pelo mesmo trabalho se não pratica o design com reconhecimento de carga de trabalho. A melhor maneira de controlar os gastos sem servidor é projetar seus índices e consultas com eficiência desde o início.
Para projetar cargas de trabalho para eficiência ao usar o modelo de preços sem servidor, considere:
Design de índice
- Inclua somente campos usados em consultas.
- Reduza as dimensões de vetor sempre que possível.
- Evite atributos filtráveis, ordenáveis ou facetáveis desnecessários.
Padrões de consulta
- Use
$selectpara limitar os campos retornados. - Aplique filtros antecipadamente para reduzir os conjuntos de resultados.
- Evite paginação profunda (
$skip). - Prefira consultas direcionadas em vez de consultas de texto completo amplas.
- Use a pesquisa híbrida cuidadosamente devido a um custo de computação mais alto.
Monitoring
- Monitore o consumo de CU para identificar consultas de alto custo.
- Acompanhe o crescimento do armazenamento e remova dados não utilizados.
No Serverless, melhorar o desempenho (consultas mais rápidas e direcionadas) normalmente reduz o custo.
Para saber mais, consulte Optimize custos com o modelo de preços sem servidor em Pesquisa de IA do Azure .
Considerações sobre capacidade regional
A capacidade e a disponibilidade podem variar de acordo com a região com suporte. Algumas regiões podem ter restrições para provisionar novos serviços ou dimensionar os existentes.
Observação
Durante a visualização pública, o modelo de preços sem servidor está disponível apenas em regiões específicas.
Se sua região de Pesquisa de IA do Azure preferencial não estiver disponível devido a restrições de capacidade, consulte Como lidar com restrições de capacidade regionais no Pesquisa de IA do Azure .