Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
Note
Pesquisa de IA do Azure está disponível por meio do portal Azure, APIs REST e SDKs do Azure. Ele também sustenta o IQ do Foundry, a camada de conhecimento gerenciado que transforma o conteúdo da empresa em bases de conhecimento reutilizáveis e com reconhecimento de permissão para agentes no portal do Microsoft Foundry.
Pesquisa de IA do Azure dá suporte a dois modelos de preços, cada um projetado para diferentes padrões de carga de trabalho:
Dedicado: preço fixo medido por SUs (Unidades de Pesquisa). Você seleciona uma camada de serviço e é cobrado por hora com base em unidades provisionadas.
Serverless (prévia): preços com base no consumo, medidos em Unidades de Computação por hora (CU/hr) e por GB/mês para armazenamento indexado.
Importante
A camada desenvolvedor sem servidor está atualmente em versão prévia. Essa versão prévia é fornecida sem um contrato de nível de serviço e não é recomendada para cargas de trabalho de produção. Alguns recursos podem não ter suporte ou podem ter restrição de recursos. Para obter mais informações, consulte Termos de Uso Complementares para Versões Prévias do Microsoft Azure.
A cobrança da camada Serverless Developer teve início em 13 de setembro de 2026. Os encargos de uso em ou após essa data aparecem em sua fatura Azure. Você não é cobrado pelo uso antes de 13 de setembro de 2026.
A camada de Desenvolvedor sem Servidor não dá suporte à migração para ou de outros tipos de preço e alguns recursos disponíveis em outras camadas não têm suporte durante a Visualização Pública. Limites de serviço, recursos com suporte e detalhes de preços podem ser alterados antes da disponibilidade geral.
Durante a visualização, o modelo de preços sem servidor tem suporte apenas em regiões específicas.
Para obter mais informações sobre as diferenças do modelo de preços e da camada de serviço, consulte Escolher um modelo de preços e uma camada de serviço.
Como o custo é determinado no modelo sem servidor
Os modelos de preços Dedicated e Serverless tratam de forma diferente o trabalho realizado dentro do serviço de busca. Os serviços dedicados executam consultas, indexação e processamento de resultados na capacidade provisionada que você já comprou. Os serviços sem servidor medem a E/S de computação, memória e disco que essas operações consomem e convertem esse uso em CUs (Unidades de Computação). Como resultado, a otimização de desempenho afeta diretamente o custo sem servidor.
Os custos sem servidor estão vinculados à execução da carga de trabalho:
- Consultas e indexação consomem computação, medida em UNIDADES de Computação por hora (/h).
- Os índices ativos consomem computação com base no uso de recursos e por quanto tempo permanecem ativos.
- Um índice permanece ativo por 10 minutos após sua última consulta ou solicitação de indexação antes de ficar inativo.
- Índices inativos não têm cobrança de computação mínima ou reservada. O uso de recursos computacionais para índices inativos é reduzido a zero. Não há cobrança mínima de computação quando um índice está inativo.
- O armazenamento é cobrado separadamente com base no tamanho do índice em disco, e a cobrança continua independentemente de um índice estar ou não em uso.
- A recuperação agêntica consome recursos computacionais para consultas de busca e para a orquestração realizadas no serviço de busca.
Os encargos de armazenamento são interrompidos somente quando você exclui o índice.
Para exibir a divisão de custos e as taxas de uso do ciclo de cobrança atual, exiba a guia Escala + Custo no portal do Azure.

Como o tamanho do índice afeta o uso da computação
Embora um índice esteja ativo, Pesquisa de IA do Azure avalia dois recursos finitos para determinar seu uso de computação:
- Tamanho total do índice: o espaço total que o índice ocupa no disco, incluindo texto, metadados e vetores.
- Tamanho do índice vetor: a memória usada pelo índice de vetor. A memória é mais intensiva em recursos do que o disco, portanto, o tamanho do índice vetor tem uma ponderação maior quando convertido em CUs.
O Pesquisa de IA do Azure não soma as duas quantidades de CU resultantes. O uso de computação é calculado com base no valor que for maior. Por exemplo, o tamanho do índice vetor pode determinar o uso da computação mesmo quando o tamanho total do índice no disco é relativamente pequeno.
Para reduzir o uso de computação do índice ativo, identifique qual recurso produz a maior quantidade de CU. Em seguida, reduza o tamanho total do índice, o tamanho do índice vetor ou ambos. O armazenamento indexado continua sendo uma cobrança separada por GB/mês.
O modelo de preços sem servidor é mais econômico para cargas de trabalho com tráfego variável, intermitente ou imprevisível, em que a capacidade provisionada seria subutilizada.
Importante
As cobranças de CU sem servidor cobrem o trabalho realizado dentro do serviço de busca, incluindo consultas, indexação, processamento de resultados e orquestração da recuperação agêntica. As chamadas de modelo e outros trabalhos executados fora do serviço de pesquisa continuam a usar seus medidores de cobrança existentes. Os exemplos incluem classificação semântica, reescrita agêntica de consultas, extração de imagens e execução de habilidades.
Entender as CUs (Unidades de Computação)
Uma Unidade de Computação (CU) representa a medida dos recursos do sistema necessários para executar operações de pesquisa e indexação no modelo sem servidor. O custo da CU é determinado principalmente pela utilização de CPU, memória e E/S e, em segundo lugar, pelo tamanho do índice e pelo tamanho da carga útil do documento, sendo o uso cobrado em Unidade de Computação por hora (CU/h).
Dimensionamento de custos de computação com:
- Complexidade da consulta
- Tamanho do índice (GB) e estrutura
- Tamanho da carga do documento (KB)
- Número de campos e resultados recuperados
Diferentes operações têm perfis de custo diferentes:
- Consulta: Baixo custo. Recuperar um único documento por sua ID é a operação mais eficiente.
- Pesquisa de palavra-chave: baixo custo. A pesquisa de texto usa índices invertidos, que são otimizados para velocidade e baixo uso de computação.
- Pesquisa de vetor: alto custo. As consultas vetoriais são computacionalmente caras porque exigem cálculos de similaridade entre inserções de alta dimensão. Em comparação com a pesquisa de palavras-chave, elas consomem significativamente mais computação.
- Pesquisa híbrida: combina os custos da pesquisa por palavra-chave e da pesquisa vetorial, pois ambos os pipelines são executados para cada consulta, além de uma pequena sobrecarga adicional para a Reciprocal Rank Fusion (RRF), usada para mesclar os resultados.
Monitorar o uso de computação
O monitoramento do consumo de computação ajuda você a identificar operações caras, otimizar padrões de consulta e estimar custos. O custo da Unidade de Computação (CU) de cada solicitação é retornado no cabeçalho de resposta HTTP x-ms-azs-compute-units-consumed na forma de um número de ponto flutuante. Use esse cabeçalho para identificar operações caras e otimizar padrões de consulta. Você pode acompanhar o custo em CU de cada solicitação ao inspecionar os cabeçalhos de resposta HTTP e os eventos de operação no Azure Monitor. Para obter mais diretrizes sobre os tipos de dados de monitoramento disponíveis e métodos para analisar esses dados, consulte Monitor Pesquisa de IA do Azure .
-
Cabeçalho:
x-ms-azs-compute-units-consumed: <value> - Valor: um número de ponto flutuante que representa as CUs consumidas.
Exemplo:
Status: 200 OK
Content-Type: application/json
x-ms-azs-compute-units-consumed: 12.45
Neste exemplo, a solicitação consumiu 12,45 unidades de computação. Você pode usar esse valor para identificar operações de alto custo e comparar o custo relativo de diferentes padrões de consulta.
Para examinar o consumo de computação histórico para um serviço de pesquisa sem servidor, use as métricas de Azure Monitor no portal Azure:
- Navegue até seu serviço de pesquisa.
- Selecione Métricas.
- Selecione + Adicionar métrica.
- Na lista de métricas, selecione Uso de unidades de computação.
- Use o gráfico para analisar tendências de uso e identificar períodos de aumento do consumo de computação.
O monitoramento do uso agregado ajuda você a entender os custos gerais do serviço e a identificar cargas de trabalho que consomem mais recursos de computação. Para obter descrições das métricas de monitoramento disponíveis, consulte Referência de Dados de Monitoramento. Você pode usar Azure Monitor logs para acompanhar o uso agregado de CU ao longo do tempo e correlacioná-lo com mudanças no volume de consultas e na carga de trabalho.

Configurar alertas para uso de computação
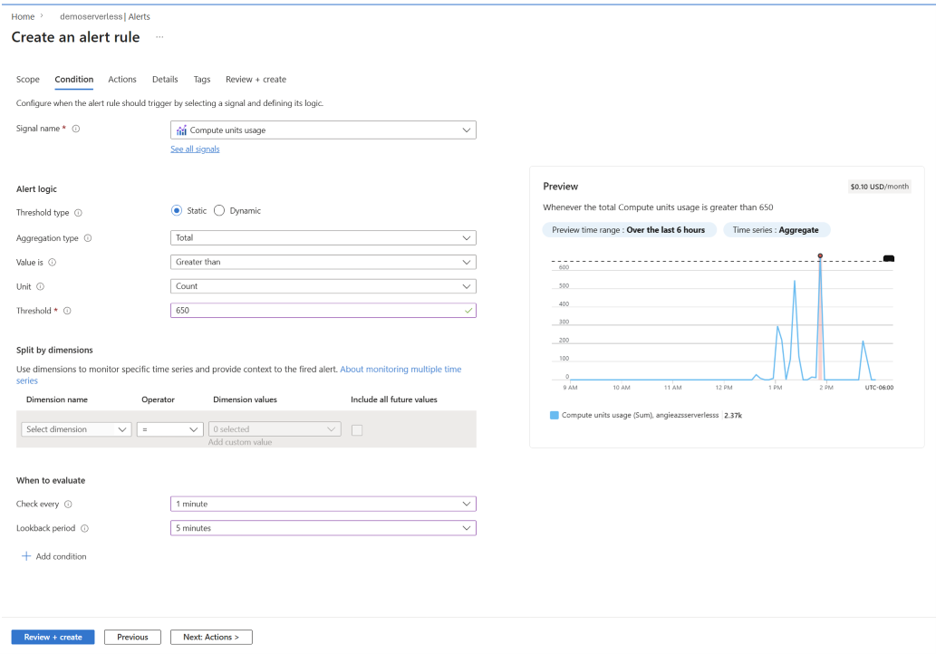
Você pode criar uma regra de alerta para ser notificado quando o consumo de computação atingir um limite especificado no portal Azure.
- Vá para Alertas em seu serviço de pesquisa.
- Selecione + Criar regra de alerta.
- Em Condição, escolha o uso de unidades de computação como o sinal.
- Defina a lógica de alerta. Por exemplo, dispare quando o uso total for maior que um valor especificado.
- Configure Ações, como notificações por email, SMS ou webhook.
- Conclua as etapas restantes e selecione Examinar + criar.
Os alertas ajudam você a responder proativamente a picos de uso inesperados e gerenciar custos.
Estimar os custos sem servidor
A calculadora de preços Azure e as diretrizes de planejamento de capacidade baseadas em SU (unidade de pesquisa) não se aplicam aos serviços que usam o modelo de preços sem servidor.
Para estimar os custos sem servidor:
- Indexe dados de amostra representativos.
- Execute cargas de trabalho típicas de indexação e consulta.
- Registre o
x-ms-azs-compute-units-consumedvalor retornado para cada operação. - Use as métricas do Azure Monitor para medir o uso agregado ao longo do tempo.
- Extrapolar custos com base no tráfego de produção esperado.
Use a guia Escala + Custo no portal Azure para ver o uso atual e estimar os custos.
Como a mesma solicitação executada em relação aos mesmos dados geralmente produz consumo de computação semelhante, cargas de trabalho representativas podem fornecer uma base confiável para estimativa de custo.
O uso sem servidor é medido continuamente e agregado para cobrança. O consumo de computação é acompanhado ao longo de cada minuto e emitido somente quando recursos de computação são usados.
Ao estimar os custos, use os valores de cobrança da solicitação para entender o custo de operações individuais e as métricas do Azure Monitor para entender os padrões gerais de consumo do serviço.
Use ambas as fontes de dados em conjunto para entender os custos: os dados de cobrança por solicitação ajudam você a avaliar operações individuais, enquanto as métricas de Azure Monitor ajudam você a entender o consumo de serviço agregado ao longo do tempo. Para uma imagem de custo completa, também contabilize os recursos que são cobrados separadamente das Unidades de Computação.
A cobrança é baseada no uso de computação agregado em vez de solicitações individuais. O uso é medido em intervalos de um minuto e arredondado para cima para o múltiplo de 0,25 CU por minuto mais próximo. Esses intervalos de uso de um minuto se acumulam ao longo de uma hora para determinar a quantidade faturável de CU/hora. Internamente, o uso é agregado de unidades de computação em milésimos (mCU) para unidades de computação (CU) e convertido no uso por hora informado para cobrança.
Operações diferentes consomem diferentes quantidades de computação. Em geral:
- As pesquisas de palavra-chave normalmente usam os recursos de computação mínimos.
- Pesquisas de vetor normalmente usam mais recursos de computação do que pesquisas de palavra-chave.
- Pesquisas híbridas combinam a palavra-chave e a execução da pesquisa de vetor, de modo que normalmente usam mais recursos de computação do que qualquer técnica sozinha.
O consumo real de computação depende de fatores como complexidade da consulta, tamanho do índice, volume de dados, configuração de vetor e o número de resultados retornados. Monitorar encargos de solicitação e métricas de uso agregado podem ajudá-lo a identificar oportunidades de otimização e prever melhor os custos de produção.
Reduzir os custos de computação por meio da otimização
Consultas eficientes e um bom projeto de índices reduzem o consumo de recursos computacionais e os custos.
Otimizar seu esquema
O esquema de índice determina os custos de computação e armazenamento da linha de base:
- Limitar atributos de campo: habilitar somente atributos (pesquisáveis, filtrados, facetáveis, classificáveis) quando necessário. Cada atributo aumenta o tamanho do índice e o custo de indexação.
- Nivelar tipos complexos: mapeie estruturas JSON aninhadas para campos simples ou coleções, sempre que possível.
-
Defina retrievable=false para campos somente filtro ou somente classificação: se um campo for usado para filtragem ou classificação, mas não precisar ser retornado nos resultados, mantenha-o indexado e definido
retrievable=falsepara reduzir o armazenamento em disco e o custo de armazenamento por GB/mês. - Use campos somente recuperáveis quando possível: por exemplo, os campos usados apenas para exibição (como URLs de imagem) não devem ser pesquisáveis.
- Reduzir dimensões de vetor: vetores de dimensões mais altas aumentam o custo de armazenamento e consulta. Use modelos de inserção menores ou quantização quando apropriado.
- Minimizar o tamanho da carga do documento antes da indexação: documentos maiores custam mais para indexar. Remova campos desnecessários, corte texto longo e remova HTML antes de enviar documentos para o índice.
Otimizar solicitações de indexação
Como você envia dados para o índice afeta o custo e a taxa de transferência:
Use lotes maiores quando possível: a indexação em lote reduz a sobrecarga por requisição, distribuindo os custos de rede e processamento entre mais documentos. Em geral, lotes de até ~1.000 documentos ou ~16 MB são mais eficientes em termos de CU do que várias solicitações pequenas. No entanto, o tamanho ideal do lote depende da carga de trabalho. Teste para balancear a taxa de transferência, a latência e a confiabilidade.
Indexar apenas dados novos ou alterados: evite reindexação total quando possível. Enviar apenas adições e atualizações reduz o número de documentos processados, reduzindo o custo de computação e melhorando a velocidade de ingestão.
Ignore a extração de imagem, a menos que você precise: a extração de imagem adiciona um trabalho de processamento extra e pode se tornar um driver de custo separado. Ative-o apenas para documentos ou fluxos de trabalho que realmente precisam de conteúdo de imagem.
Leve em consideração o crescimento do tamanho do índice: sempre que possível, crie índices menores. À medida que um índice aumenta, os custos de indexação aumentam porque mais dados devem ser armazenados e mantidos, e as operações exigem mais computação. Para conjuntos de dados muito grandes, considere particionar dados em vários índices para ajudar a gerenciar o desempenho e os custos. Embora os custos aumentem com o tamanho do índice, o aumento é sublinear. Índices maiores custam mais por operação, mas não proporcionalmente mais.
Para obter mais diretrizes, consulte Tips para obter melhor desempenho em Pesquisa de IA do Azure .
Otimizar operações do indexador
O uso de computação do indexador sem servidor depende do trabalho executado durante cada execução do indexador. Para fontes orientadas a linhas, use o número de documentos processados como um indicador do volume de carga de trabalho. Para fontes baseadas em arquivo, como Armazenamento de Blobs do Azure e Azure Data Lake Storage Gen2, monitore a quantidade de dados de origem processados. O uso real de computação também depende de cargas de documento, estrutura de índice, enriquecimento e outros processamentos executados durante a execução.
Para reduzir o uso de computação do indexador:
Use a detecção de alterações e a indexação incremental: processe apenas dados novos ou alterados em vez de indexar repetidamente a fonte de dados completa.
Ajuste adequadamente os agendamentos do indexador: escolha um agendamento que atenda aos seus requisitos de atualização dos dados. Use a telemetria da unidade de computação para avaliar o impacto da frequência de agendamento.
Reduza o conteúdo desnecessário do documento: remova o conteúdo que não precisa ser indexado e exclua arquivos ou tipos de arquivo que não são necessários.
Defina cuidadosamente o escopo das habilidades de enriquecimento: execute as habilidades apenas nos campos e documentos que exijam enriquecimento e evite gerar saídas que não sejam usadas nas etapas posteriores. As habilidades faturáveis podem incorrer em encargos de transação separados.
Monitorar execuções com falha e repetidas: um indexador pode consumir recursos computacionais por trabalho já concluído antes de falhar. Examine o histórico de execução e o uso da Unidade de Computação para identificar falhas recorrentes e padrões de repetição.
Otimizar suas consultas
O design da consulta é um driver primário de custo variável:
Use
$selectpara limitar os campos retornados: isso reduz o tamanho da carga e a computação necessárias para serialização.GET /docs?search=test&$select=id,title,urlUse
searchFieldspara limitar onde o texto é pesquisado: restrinja a correspondência de tempo de consulta aos campos que importam para o cenário. Cada campo pesquisável adicional aumenta o processamento da consulta e pode aumentar o CU/h.Prefira correspondência exata ou consultas simples por palavra-chave: consultas aproximadas, com curingas, regex e por prefixo podem forçar varreduras amplas no índice e consumir significativamente mais CU/h. Use-as somente quando precisar de um comportamento de correspondência parcial e escolher consultas de correspondência exata ou de palavra-chave mais simples sempre que possível.
Use consultas por ID em vez de buscas, quando possível: consultar um documento por ID é mais eficiente do que executar uma consulta de busca. Se você souber o ID do documento, use uma consulta direta em vez de uma consulta de busca. As pesquisas são mais eficientes porque recuperam um documento diretamente por chave, enquanto as consultas de pesquisa invocam o pipeline de consulta completo (análise, passagem de índice, pontuação e classificação), o que aumenta o custo de computação.
Evite paginação profunda (
$skip): valores grandes$skipaumentam a computação porque o mecanismo deve processar, pontuar e classificar os resultados que precedem a página solicitada. Por exemplo,$skip=5000requer que o mecanismo processe pelo menos 5.000 resultados que não são retornados. Essa opção consome CUs (unidades de computação) extras e pode aumentar o custo. Em vez disso, use filtros para restringir o resultadosete$toplimitar o número de resultados retornados. Ajuste o tamanho de$toppara seu aplicativo ou interface de usuário. Embora$topnão altere quantos documentos correspondentes são pontuados, um valor menor reduz o número de resultados que devem ser coletados, classificados e serializados. Solicite apenas quantos resultados o aplicativo precisar e evite padrões de paginação que exijam que o mecanismo processe um grande número de resultados não utilizados.Minimizar a contagem de facetas e o escopo da faceta: solicite apenas as facetas exibidas na interface do usuário e mantenha cada valor de faceta
counttão baixo quanto prático. Facetas exigem agregações para cada consulta, e contagens elevadas aumentam o custo computacional.Use
search.inpara filtragem: ao filtrar por uma lista de IDs ou valores, use asearch.infunção em vez de váriasorcondições (por exemplo,id eq '1' or id eq '2'). Essa abordagem é mais eficiente e reduz a sobrecarga de computação. Você também deve evitar marcar campos de alta cardinalidade (aqueles com um grande número de valores exclusivos, como IDs exclusivos ou descrições em texto livre) como filtráveis ou facetáveis, a menos que isso seja necessário, pois isso aumenta o tamanho do índice e o custo da consulta.
Otimizar suas solicitações administrativas
Além das operações de consulta e indexação, Pesquisa de IA do Azure inclui operações administrativas no nível do objeto e no nível do serviço (como recuperar esquemas de índice ou estatísticas de serviço). Essas solicitações têm um custo fixo por solicitação. Embora cada solicitação seja barata, chamadas repetidas ou desnecessárias podem se acumular ao longo do tempo e aumentar o uso geral da computação.
- Evite solicitações administrativas excessivas: armazene em cache metadados, como esquemas de índice, no cliente, em vez de recuperá-los repetidamente. Por exemplo, buscar o esquema do índice antes de cada operação de gravação introduz um custo desnecessário. No modelo sem servidor, esse padrão aumenta diretamente os encargos de computação, enquanto nos serviços dedicados, o impacto geralmente é oculto por cobrança fixa por hora.
Otimizar custos com vetores
As cargas de trabalho de vetor normalmente são o componente de maior custo na pesquisa do modelo de preços sem servidor porque afetam as Unidades de Computação (consultas e indexação) e o armazenamento (tamanho do vetor no disco). Para reduzir o custo, otimize a forma como os vetores são armazenados e como eles são consultados.
Otimizar o armazenamento e o esquema de vetor
Os campos de vetor podem aumentar significativamente o tamanho do índice e o custo de indexação. Use as seguintes técnicas para reduzir a sobrecarga de armazenamento:
Use a compactação para reduzir o tamanho do vetor: aplique a quantização para reduzir o volume de armazenamento com impacto mínimo de relevância. Por exemplo, a quantização escalar pode reduzir o armazenamento de vetores em até 4× com impacto mínimo na qualidade da pesquisa.
Desabilite o armazenamento para vetores quando não for necessário: defina stored=false em campos de vetor se você precisar apenas de vetores para pesquisa, não recuperação. Isso evita armazenar os vetores originais no índice, reduzindo o custo de armazenamento sem afetar o comportamento da consulta.
Use dimensões de inserção menores quando possível: vetores de dimensões mais altas aumentam o custo de armazenamento e de consulta. Para cargas de trabalho não críticas, use modelos de inserção menores (por exemplo, dimensões 384 ou 768 em vez de 1536) para reduzir o custo.
Otimizar a execução da consulta vetor
As consultas vetoriais são intensivas em computação porque exigem cálculos de similaridade em estruturas de dados de alta dimensão.
Use a busca híbrida seletivamente: as consultas híbridas executam tanto a recuperação por palavra-chave quanto a recuperação vetorial. Use somente quando necessário para relevância.
Reduzir o maxTextRecallSize para consultas híbridas: A configuração
hybridSearch.maxTextRecallSizecontrola quantos resultados classificados por BM25 são enviados para a Fusão por Classificação Recíproca. O padrão é 1.000 (intervalo de 1 a 10.000). O consumo de computação é dimensionado aproximadamente linearmente com esse valor, portanto, reduzi-lo é uma das alavancas de custo mais diretas para cargas de trabalho híbridas.Os valores em torno de 500 geralmente reduzem a computação significativamente com pouca perda de relevância.
Reduzir ainda mais pode eliminar correspondências por palavra-chave que a busca vetorial não encontra, como termos exatos, IDs e acrônimos.
Controle os vetores candidatos separadamente usando k em cada consulta vetorial.
Teste consultas representativas e compare relevância, latência e o
x-ms-azs-compute-units-consumedcabeçalho antes de estabelecer um valor.Aplicar filtros antes das consultas de vetor: restrinja o conjunto de candidatos antes da pesquisa de vetor para reduzir a quantidade de dados processados. Veja como a filtragem funciona em consultas de vetor.
Reduzir custos minimizando o uso
O modelo sem servidor cobra apenas pelos recursos consumidos. Quando não há solicitações, o uso de computação diminui de acordo.
Para minimizar os custos de uso:
- Execute consultas somente quando necessário.
- Evite solicitações redundantes ou excessivamente frequentes.
- Monitore o uso e ajuste cargas de trabalho com base na demanda.
Dica
A mesma consulta pode ter diferentes perfis de latência e de CU, dependendo de o serviço estar em estado quente ou frio. Após um período sem tráfego de leitura ou gravação, o uso de computação no modelo de preços sem servidor cai para zero. A próxima solicitação pode ter maior latência e consumir mais CUs enquanto os caminhos de dados se aquecem. Índices maiores geralmente levam mais tempo para aquecer do que índices menores, de modo que efeitos de início frio geralmente são mais perceptíveis em serviços maiores.
Otimizar os custos de armazenamento
O armazenamento é cobrado por GB/mês com base no tamanho do índice em disco, que pode exceder o tamanho bruto dos dados. Para reduzir os custos de armazenamento:
- Remova índices não utilizados.
- Minimize os campos armazenados.
- Projete esquemas com a sobrecarga de armazenamento em mente.
- Use sugestores seletivamente porque eles podem aumentar drasticamente o tamanho do armazenamento.
Para técnicas específicas de vetor (compactação, poda e configurações de armazenamento), consulte Otimizar para armazenamento e processamento de vetores.
Para obter mais diretrizes sobre compensações de desempenho de armazenamento e consulta, consulte Tips para obter melhor desempenho em Pesquisa de IA do Azure .