Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
Nota
Pesquisa de IA do Azure está disponível por meio do portal Azure, APIs REST e SDKs do Azure. Ele também sustenta o IQ do Foundry, a camada de conhecimento gerenciado que transforma o conteúdo da empresa em bases de conhecimento reutilizáveis e com reconhecimento de permissão para agentes no portal do Microsoft Foundry.
Importante
Recursos, funcionalidades ou propriedades marcados como (versão prévia) não são cobertos por um contrato de nível de serviço (SLA), não são recomendados para cargas de trabalho de produção e podem mudar ou ser restringidos antes da disponibilidade geral. Os termos de visualização do Pesquisa de IA do Azure se aplicam a toda funcionalidade em visualização, seja autônoma ou parte de um recurso de disponibilidade geral.
Em Pesquisa de IA do Azure , você pode usar uma expressão filtro para adicionar critérios de inclusão ou exclusão a uma consulta vector. Você também pode especificar um modo de filtragem que aplica o filtro:
- Antes da execução da consulta, conhecida como pré-filtragem.
- Após a execução da consulta, conhecida como postfiltering.
- Depois que os principais
kresultados globais são identificados, conhecido como pós-filtragem estrita (versão prévia).
Este artigo usa REST para ilustração. Para obter exemplos de código em outros idiomas e soluções de ponta a ponta que incluem consultas vetoriais, consulte o repositório do GitHub azure-search-vector-samples.
Você também pode usar Search Explorer no portal Azure para consultar o conteúdo do vetor. No modo de exibição JSON, você pode adicionar filtros e especificar o modo de filtro.
Como a filtragem funciona em consultas vetoriais
A Pesquisa de IA do Azure usa o algoritmo HNSW (Hierarchical Navigable Small World) para pesquisa ANN (Approximate Nearest Neighbor), armazenando grafos HNSW em vários fragmentos. Cada fragmento contém uma parte de todo o índice.
Os filtros se aplicam a filterable campos não vetoriais, cadeia de caracteres ou numéricos, para incluir ou excluir documentos de pesquisa com base em critérios de filtro. Os próprios campos de vetor não são filtrados, mas você pode usar filtros em outros campos no mesmo índice para restringir os documentos considerados para pesquisa de vetor. Se o índice não tiver um texto adequado ou campos numéricos, verifique se há metadados de documento que podem ajudar na filtragem, como LastModified ou CreatedBy propriedades.
O parâmetro vectorFilterMode controla onde as operações de filtro são aplicadas durante os estágios da pesquisa, o que afeta a forma como os resultados são filtrados para um subconjunto de itens (como por categoria, tag ou outros atributos) e impacta a latência, a precisão e a taxa de transferência. Há três modos:
preFilteraplica o filtro durante a travessia HNSW em cada fragmento. Esse modo maximiza o recall, mas pode percorrer mais do grafo, aumentando a CPU e a latência para filtros altamente seletivos.postFilterexecuta a travessia HNSW e a filtragem em cada fragmento independentemente, cruza os resultados no nível do fragmento e, em seguida, agrega os principaiskde cada fragmento em um principal globalk. Esse modo pode criar falsos negativos para filtros altamente seletivos ou valores pequenosk.strictPostFilter(versão prévia) encontra o principal global não filtradokantes de aplicar o filtro. Esse modo tem o maior risco de retornar falsos negativos para filtros altamente seletivos e valores pequenosk.
Para obter mais informações sobre esses modos, consulte Definir o modo de filtro.
Definir um filtro
Os filtros determinam o escopo das consultas de vetor e são definidos usando Documentos – Postagem de Pesquisa (API REST). A menos que você queira usar um recurso de visualização, use a versão estável mais recente das APIs REST do Serviço de Pesquisa para formular a solicitação.
Esta API REST fornece:
-
filterpara os critérios. -
vectorFilterModepara especificar quando o filtro é aplicado durante a consulta de vetor. Para modos com suporte, consulte Definir o modo de filtro.
POST https://{search-endpoint}/indexes/{index-name}/docs/search?api-version={api-version}
Content-Type: application/json
api-key: {admin-api-key}

{
    "count": true,
    "select": "title, content, category",
    "filter": "category eq 'Databases'",
    "vectorFilterMode": "preFilter",
    "vectorQueries": [
        {
            "kind": "vector",
            "vector": [
                -0.009154141,
                0.018708462,
                . . . // Trimmed for readability
                -0.02178128,
                -0.00086512347
            ],
            "fields": "contentVector",
            "k": 50
        }
    ]
}
Neste exemplo, a inserção de vetor tem como destino o contentVector campo e os critérios de filtro se aplicam a categoryum campo de texto filtreável. Como o preFilter modo é usado, o filtro é aplicado antes que o mecanismo de pesquisa execute a consulta, portanto, somente documentos na Databases categoria são considerados durante a pesquisa de vetor.
Definir o modo de filtro
O vectorFilterMode parâmetro determina quando e como o filtro é aplicado em relação à execução da consulta vetor. Você pode usar os seguintes modos:
-
preFilter(recomendado) postFilter-
strictPostFilter(versão prévia)
Nota
preFilter é o padrão para índices criados após aproximadamente 15 de outubro de 2023. Para índices criados antes dessa data, postFilter é o padrão. Para usar preFilter e outros recursos de vetor avançados, como compactação de vetor, você deve recriar seu índice.
Você pode testar a compatibilidade enviando uma consulta vetorial com "vectorFilterMode": "preFilter" na versão 2023-10-01-preview da API REST ou posterior. Se a consulta falhar, o índice não terá suporte preFilter.
A pré-filtragem aplica filtros antes da execução da consulta, o que reduz o conjunto de candidatos para o algoritmo de pesquisa vetorial. Os principais resultadosk são então selecionados desse conjunto filtrado.
Em uma consulta vetor, preFilter é o modo padrão porque favorece o recall e a qualidade em relação à latência.
Como esse modo funciona
Em cada fragmento, aplique o predicado de filtro durante a travessia do HNSW, expandindo o grafo até encontrar
kcandidatos.Produza os
kresultados principais locais pré-filtrados por fragmento.Agregue os resultados filtrados em um conjunto de resultados global principal
k.
Efeito desta função
O Traversal expande a superfície de pesquisa para encontrar candidatos mais filtrados, especialmente se o filtro for seletivo. Isso produz os principais resultados k mais semelhantes em todos os fragmentos. Cada fragmento identifica os k resultados que atendem ao predicado de filtro.
A pré-filtragem garante que os resultados de k sejam retornados se existirem no índice. Para filtros altamente seletivos, isso pode fazer com que uma parte significativa do grafo seja percorrida, aumentando o custo e a latência da computação, reduzindo a taxa de transferência. Se o filtro for altamente seletivo (tem poucas correspondências), considere usar exhaustive: true para executar uma pesquisa exaustiva.
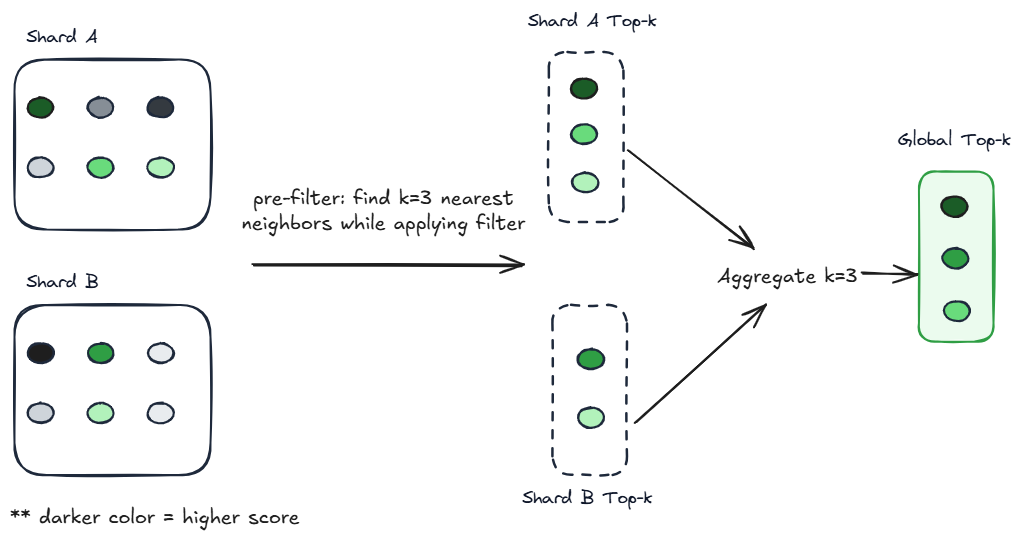
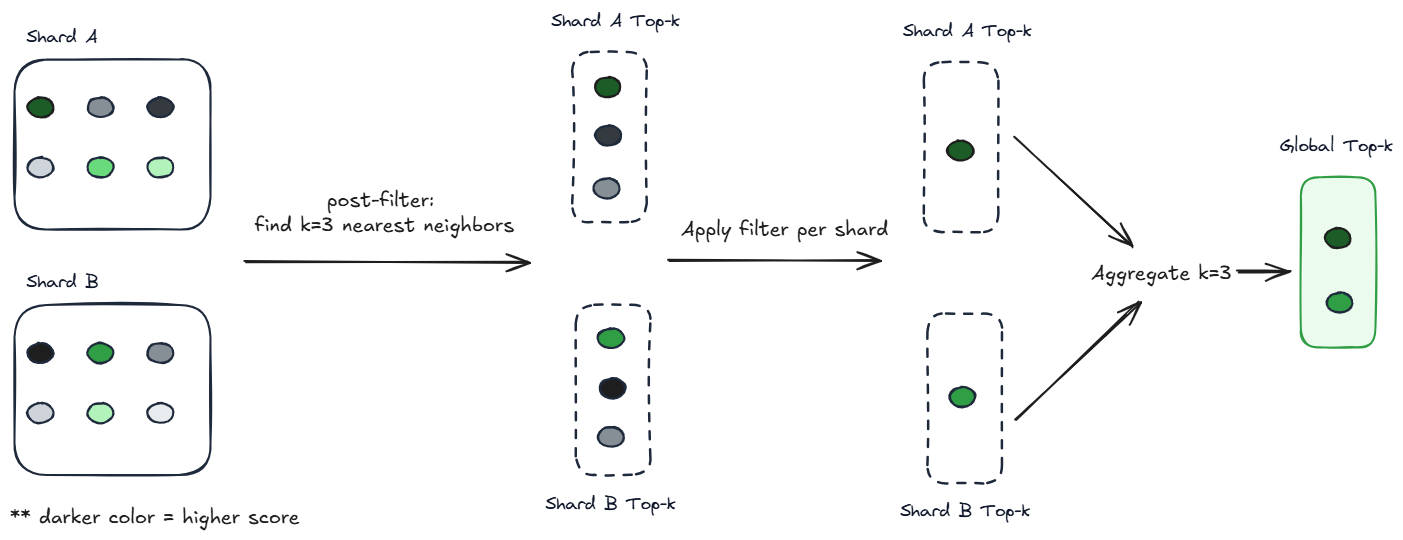
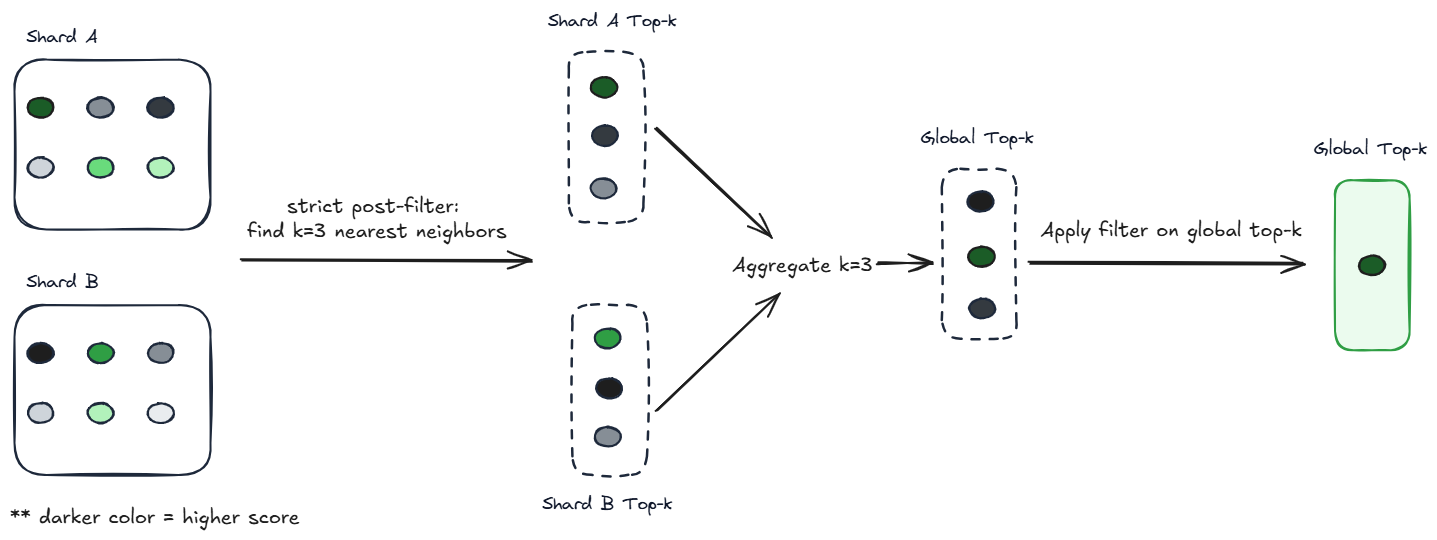
Tabela de comparação
| Modo | Relembrar (resultados filtrados) | Custo computacional | Risco de falsos negativos | Quando usar |
|---|---|---|---|---|
preFilter |
Muito alto | Maior (aumenta com a seletividade e a complexidade do filtro) | Sem risco |
Padrão recomendado para todos os cenários, especialmente quando a recuperação é crítica (domínios de pesquisa confidenciais), quando se usa filtros seletivos ou usa-se k pequenos. |
postFilter |
Médio a alto (diminui com seletividade de filtro) | Semelhante ao não filtrado, mas aumenta com a complexidade do filtro | Moderado (pode perder correspondências por partição) | Uma opção para filtros que não são muito seletivos e para consultas superioresk . |
strictPostFilter |
Menor (diminui mais rapidamente com seletividade de filtro) | Semelhante ao não filtrado | Mais alto (pode retornar zero resultados para filtros seletivos ou pequenos k) |
Uma opção para aplicativos de pesquisa por facetas em que a exibição de mais resultados após a aplicação do filtro afeta a experiência do usuário mais do que o risco de falsos negativos. Não use com valores k pequenos. |
Teste de benchmark de pré-filtragem e pós-filtragem
Importante
Esta seção se aplica à pré-filtragem e à pós-filtragem, não à filtragem pós-estrita.
Para entender as condições sob as quais um modo de filtro tem um desempenho melhor que o outro, executamos uma série de testes para avaliar os resultados da consulta em índices pequenos, médios e grandes.
- Pequeno (100.000 documentos, índice de 2,5 GB, 1.536 dimensões)
- Médio (1 milhão de documentos, índice de 25 GB, 1.536 dimensões)
- Grande (1 bilhão de documentos, índice de 1,9 TB, 96 dimensões)
Para as cargas de trabalho pequenas e médias, usamos um serviço Standard 2 (S2) com uma partição e uma réplica. Para a carga de trabalho grande, usamos um serviço Standard 3 (S3) com 12 partições e uma réplica.
Os índices tinham uma construção idêntica: um campo de chave, um campo de vetor, um campo de texto e um campo filtre numérico. O índice a seguir é definido usando a 2023-11-01 sintaxe.
def get_index_schema(self, index_name, dimensions):
    return {
        "name": index_name,
        "fields": [
            {"name": "id", "type": "Edm.String", "key": True, "searchable": True},
            {"name": "content_vector", "type": "Collection(Edm.Single)", "dimensions": dimensions,
              "searchable": True, "retrievable": True, "filterable": False, "facetable": False, "sortable": False,
              "vectorSearchProfile": "defaulthnsw"},
            {"name": "text", "type": "Edm.String", "searchable": True, "filterable": False, "retrievable": True,
              "sortable": False, "facetable": False},
            {"name": "score", "type": "Edm.Double", "searchable": False, "filterable": True,
              "retrievable": True, "sortable": True, "facetable": True}
        ],
      "vectorSearch": {
        "algorithms": [
            {
              "name": "defaulthnsw",
              "kind": "hnsw",
              "hnswParameters": { "metric": "euclidean" }
            }
          ],
          "profiles": [
            {
              "name": "defaulthnsw",
              "algorithm": "defaulthnsw"
            }
        ]
      }
    }
Em consultas, usamos um filtro idêntico para operações de pré-filtro e pós-filtro. Usamos um filtro simples para garantir que as variações no desempenho fossem devido ao modo de filtragem, não à complexidade do filtro.
Os resultados foram medidos em consultas por segundo (QPS).
Considerações
A pré-filtragem é quase sempre mais lenta do que a pós-filtragem, exceto em índices pequenos em que o desempenho é aproximadamente igual.
Em conjuntos de dados maiores, a pré-filtragem é ordens de magnitude mais lenta.
Por que o pré-filtro é o padrão se é quase sempre mais lento? A pré-filtragem garante que resultados
ksejam retornados se existirem no índice, onde o viés favorece o recall e a precisão em vez da velocidade.Usar pós-filtragem se:
Priorize a velocidade em vez da seleção (a pós-filtragem pode retornar menos de
kresultados).Use filtros que não são excessivamente seletivos.
Tenha índices de tamanho suficiente para que o desempenho da pré-filtragem seja inaceitável.
Detalhes
Dado um conjunto de dados com 100.000 vetores em 1.536 dimensões:
Ao filtrar mais de 30% do conjunto de dados, o pré-filtragem e o pós-filtragem eram comparáveis.
Ao filtrar menos de 0,1% do conjunto de dados, o pré-filtragem era cerca de 50% mais lento do que o pós-filtragem.
Dado um conjunto de dados com 1 milhão de vetores em 1.536 dimensões:
Ao filtrar mais de 30% do conjunto de dados, o pré-filtragem era cerca de 30% mais lento.
Ao filtrar menos de 2% do conjunto de dados, o pré-filtragem era cerca de sete vezes mais lento.
Dado um conjunto de dados com 1 bilhão de vetores em 96 dimensões:
Ao filtrar mais de 5% do conjunto de dados, o pré-filtragem era cerca de 50% mais lento.
Ao filtrar menos de 10% do conjunto de dados, o pré-filtragem era cerca de sete vezes mais lento.
O grafo a seguir mostra o QPS relativo do pré-filtro, computado como QPS de pré-filtro dividido pelo QPS do pós-filtro.
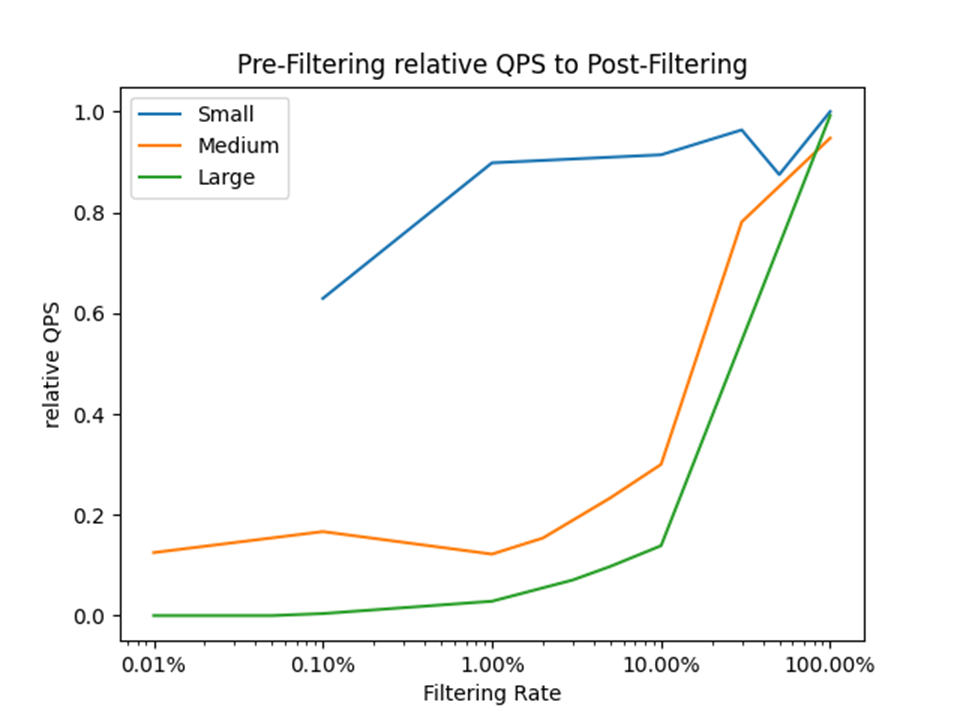
O eixo vertical representa o desempenho relativo da pré-filtragem em comparação com o pós-filtragem, expresso como uma taxa de QPS (consultas por segundo). Por exemplo:
- Um valor de
0.0significa que a pré-filtragem é 100% mais lenta que a pós-filtragem. - Um valor de
0.5significa que o pré-filtragem é 50% mais lento. - Um valor de
1.0significa que pré-filtragem e pós-filtragem são equivalentes.
O eixo horizontal representa a taxa de filtragem ou o percentual de documentos candidatos após a aplicação do filtro. Por exemplo, uma taxa de 1.00% significa que os critérios de filtro selecionaram um por cento do corpus de pesquisa.