Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Uwaga
Wyszukiwanie AI platformy Azure jest dostępna za pośrednictwem portalu Azure, interfejsów API REST i Azure SDKs. Jest także podstawą Foundry IQ — zarządzanej warstwy wiedzy, która przekształca treści przedsiębiorstwa w bazy wiedzy wielokrotnego użytku z uwzględnieniem uprawnień dla agentów w portalu Microsoft Foundry.
W tym artykule wyjaśniono, jak zaktualizować istniejący indeks w Wyszukiwanie AI platformy Azure za pomocą zmian schematu lub zmian zawartości za pomocą indeksowania przyrostowego.
Wskazówka
Aby natychmiast zaktualizować dokumenty, przejdź do sekcji Aktualizowanie zawartości. Aby uzyskać informacje o zmianach schematu, zobacz Aktualizowanie schematu indeksu.
Wymagania wstępne
Usługa Wyszukiwanie AI platformy Azure (dowolna warstwa). Utwórz usługę lub znajdź istniejącą usługę.
Istniejący indeks wyszukiwania z dokumentami. W tym artykule założono, że utworzono już indeks i załadowano dokumenty.
Uprawnienia do aktualizowania lub ponownego kompilowania indeksów:
- Uwierzytelnianie oparte na kluczach: klucz interfejsu API administratora dla usługi wyszukiwania.
- Uwierzytelnianie oparte na rolach: rola Współautor danych indeksu wyszukiwania dla aktualizacji dokumentów lub Współautor usługi wyszukiwania dla zmian schematu.
W przypadku programowania zestawu SDK zainstaluj bibliotekę klienta usługi Azure Search:
- Python: azure-search-documents
- .NET: Azure. Search.Documents
- JavaScript: @azure/search-documents
- Java: azure-search-documents
Wskazówka
Podczas aktywnego programowania często należy usuwać i ponownie kompilować indeksy podczas iteracji nad projektem indeksu. Współpracuj z małą reprezentatywną próbką danych, aby ponowne indeksowanie przebiegało szybciej. W przypadku zmian schematu produkcyjnego utwórz i przetestuj nowy indeks obok siebie, a następnie użyj aliasu indeksu do zamiany indeksów bez zmieniania kodu aplikacji.
Aktualizowanie zawartości
Indeksowanie przyrostowe i synchronizowanie indeksu ze zmianami w danych źródłowych ma podstawowe znaczenie dla większości aplikacji wyszukiwania. W tej sekcji wyjaśniono przepływ pracy dodawania, usuwania lub zastępowania zawartości indeksu wyszukiwania za pomocą interfejsu API REST, ale Azure SDKs zapewniają równoważne funkcje.
Treść żądania zawiera co najmniej jeden dokument do indeksowania. W żądaniu każdy dokument w indeksie to:
- Zidentyfikowany przez unikatowy klucz z uwzględnieniem wielkości liter.
- Skojarzone z akcją: "upload", "delete", "merge" lub "mergeOrUpload".
- Wypełnione zestawem par nazwa/wartość dla każdego pola, które dodajesz lub aktualizujesz.
{
  "value": [
    {
      "@search.action": "upload (default) | merge | mergeOrUpload | delete",
      "key_field_name": "unique_key_of_document", (key/value pair for key field from index schema)
      "field_name": field_value (name/value pairs matching index schema)
        ...
    },
    ...
  ]
}
Dokumentacja:Dokumenty — indeks
Najpierw użyj interfejsów API do ładowania dokumentów, takich jak Documents — Index (REST) lub równoważnego interfejsu API w Azure SDKs. Aby uzyskać więcej informacji na temat technik indeksowania, zobacz Ładowanie dokumentów.
W przypadku dużej aktualizacji zalecane jest procesowanie wsadowe (do 1000 dokumentów na partię lub około 16 MB na partię, w zależności od tego, która wartość jest niższa), co znacznie poprawia wydajność indeksowania.
@search.actionUstaw parametr w interfejsie API, aby określić wpływ na istniejące dokumenty. SłużymergeOrUploaddo przyrostowych aktualizacji (najczęściej),deletedo usuwania dokumentów lubmergedo aktualizowania części pól w istniejących dokumentach.Działania Efekt usunąć Usuwa cały dokument z indeksu. Jeśli chcesz usunąć pojedyncze pole, zamiast tego użyj scalania, ustawiając dane pole na null. Usunięte dokumenty i pola nie zwalniają natychmiast miejsca w indeksie. Co kilka minut proces w tle wykonuje fizyczne usunięcie. Niezależnie od tego, czy używasz portalu Azure, czy interfejsu API do zwracania statystyk indeksu, możesz oczekiwać małego opóźnienia, zanim usunięcie zostanie odzwierciedlone w portalu Azure i za pośrednictwem interfejsów API. Aby uzyskać więcej informacji, zobacz Usuwanie dokumentów w indeksie wyszukiwania. scalać Aktualizuje dokument, który już istnieje, i kończy się niepowodzeniem dokumentu, którego nie można odnaleźć. Scalanie zastępuje istniejące wartości. Z tego powodu należy sprawdzić pola kolekcji zawierające wiele wartości, takie jak pola typu Collection(Edm.String). Jeśli na przykład poletagszaczyna się od wartości["budget"]i wykonasz scalanie z["economy", "pool"], to końcowa wartość polatagswynosi["economy", "pool"]. To nie będzie["budget", "economy", "pool"].
To samo zachowanie dotyczy złożonych kolekcji. Jeśli dokument zawiera złożone pole kolekcji o nazwie Pokoje z wartością[{ "Type": "Budget Room", "BaseRate": 75.0 }], a wykonasz scalanie z wartością[{ "Type": "Standard Room" }, { "Type": "Budget Room", "BaseRate": 60.5 }], ostateczną wartością pola Pokoje będzie[{ "Type": "Standard Room" }, { "Type": "Budget Room", "BaseRate": 60.5 }]. Nie będzie dołączać ani scalać nowych i istniejących wartości.mergeOrUpload Zachowuje się jak scalanie, jeśli dokument istnieje, a jak przesyłanie, jeśli dokument jest nowy. Jest to najbardziej typowa operacja aktualizacji przyrostowych. przekazywać Podobnie jak w przypadku operacji "upsert", gdzie dokument jest wstawiany, jeśli jest nowy, lub aktualizowany bądź zastępowany, jeśli już istnieje. Jeśli w dokumencie brakuje wartości, których indeks wymaga, wartość pola dokumentu jest ustawiona na wartość null.
Zapytania nadal działają podczas indeksowania, ale jeśli aktualizujesz lub usuwasz istniejące pola, możesz oczekiwać mieszanych wyników i większej częstości ograniczania przepustowości.
Uwaga
Nie ma gwarancji kolejności, dla których akcja w treści żądania jest wykonywana jako pierwsza. Nie zaleca się posiadania wielu akcji "scalania" skojarzonych z tym samym dokumentem w jednej treści żądania. Jeśli dla tego samego dokumentu jest wymaganych wiele akcji "scalania", należy wykonać scalanie po stronie klienta, zanim zaktualizujesz dokument w indeksie wyszukiwania.
Odpowiedzi
Kod stanu 200 jest zwracany dla pomyślnej odpowiedzi, co oznacza, że wszystkie elementy zostały trwale przechowywane i zaczną być indeksowane. Indeksowanie jest uruchamiane w tle i udostępnia nowe dokumenty (czyli z możliwością wykonywania zapytań i wyszukiwania) kilka sekund po zakończeniu operacji indeksowania. Określone opóźnienie zależy od obciążenia usługi.
Pomyślne indeksowanie jest wskazywane przez właściwość 'status' ustawioną jako true dla wszystkich elementów, a także przez właściwością statusCode ustawioną jako 201 (dla dokumentów nowo przesłanych) lub 200 (dla scalonych lub usuniętych dokumentów):
{
  "value": [
    {
      "key": "unique_key_of_new_document",
      "status": true,
      "errorMessage": null,
      "statusCode": 201
    },
    {
      "key": "unique_key_of_merged_document",
      "status": true,
      "errorMessage": null,
      "statusCode": 200
    },
    {
      "key": "unique_key_of_deleted_document",
      "status": true,
      "errorMessage": null,
      "statusCode": 200
    }
  ]
}
Kod stanu 207 jest zwracany, gdy co najmniej jeden element nie został pomyślnie indeksowany. Elementy, które nie zostały indeksowane, mają pole stanu ustawione na wartość false. Właściwości errorMessage i statusCode wskazują przyczynę błędu indeksowania:
{
  "value": [
    {
      "key": "unique_key_of_document_1",
      "status": false,
      "errorMessage": "The search service is too busy to process this document. Please try again later.",
      "statusCode": 503
    },
    {
      "key": "unique_key_of_document_2",
      "status": false,
      "errorMessage": "Document not found.",
      "statusCode": 404
    },
    {
      "key": "unique_key_of_document_3",
      "status": false,
      "errorMessage": "Index is temporarily unavailable because it was updated with the 'allowIndexDowntime' flag set to 'true'. Please try again later.",
      "statusCode": 422
    }
  ]
}
Właściwość errorMessage wskazuje przyczynę błędu indeksowania, jeśli jest to możliwe.
W poniższej tabeli opisano różne kody stanu poszczególnych dokumentów, które można zwrócić w odpowiedzi. Niektóre kody stanu wskazują problemy z samym żądaniem, podczas gdy inne wskazują tymczasowe warunki błędu. To ostatnie należy spróbować ponownie po opóźnieniu.
| Kod stanu | Znaczenie | Wznawialny | Notatki |
|---|---|---|---|
| 200 | Dokument został pomyślnie zmodyfikowany lub usunięty. | N/a | Operacje usuwania są idempotentne. Oznacza to, że nawet jeśli klucz dokumentu nie istnieje w indeksie, próba wykonania operacji usuwania z tym kluczem powoduje wyświetlenie kodu stanu 200. |
| 201 | Dokument został pomyślnie utworzony. | N/a | |
| 400 | Wystąpił błąd w dokumencie, który uniemożliwił indeksowanie. | Nie | Komunikat o błędzie w odpowiedzi wskazuje, co jest nie tak z dokumentem. |
| 404 | Nie można scalić dokumentu, ponieważ dany klucz nie istnieje w indeksie. | Nie | Ten błąd nie występuje w przypadku przekazywania, ponieważ tworzą nowe dokumenty i nie występuje w przypadku usuwania, ponieważ są idempotentne. |
| 409 | Podczas próby indeksowania dokumentu wykryto konflikt wersji. | Tak | Może się to zdarzyć, gdy próbujesz zaindeksować ten sam dokument więcej niż raz jednocześnie. |
| 422 | Indeks jest tymczasowo niedostępny, ponieważ został zaktualizowany z flagą "allowIndexDowntime" ustawioną na wartość "true". | Tak | |
| 429 | Zbyt wiele żądań | Tak | Jeśli ten kod błędu jest wyświetlany podczas indeksowania, zwykle oznacza to, że brakuje miejsca do magazynowania. Gdy zbliżasz się do limitów magazynu, usługa może wprowadzić stan, w którym nie można dodać ani zaktualizować, dopóki nie usuniesz niektórych dokumentów. Aby uzyskać więcej informacji, zobacz Planowanie pojemności i zarządzanie nią , jeśli potrzebujesz więcej miejsca do magazynowania lub zwolnij miejsce, usuwając dokumenty. |
| 503 | Usługa wyszukiwania jest tymczasowo niedostępna, prawdopodobnie ze względu na duże obciążenie. | Tak | Aby nie ryzykować wydłużenia niedostępności usługi, kod powinien czekać przed ponowną próbą w tym przypadku. |
Jeśli kod klienta często napotyka odpowiedź 207, jedną z możliwych przyczyn jest to, że system jest pod obciążeniem. Możesz to potwierdzić, sprawdzając właściwość statusCode dla wartości 503. Jeśli statusCode ma wartość 503, zalecamy ograniczanie żądań indeksowania. W przeciwnym razie, jeśli indeksowanie ruchu nie ustąpi, system może rozpocząć odrzucanie wszystkich żądań z błędami 503.
Kod stanu 429 wskazuje, że przekroczono limit przydziału liczby dokumentów na indeks. Należy uaktualnić w celu zwiększenia limitów pojemności lub utworzyć nowy indeks.
Uwaga
Podczas przekazywania wartości DateTimeOffset z informacjami o strefie czasowej do indeksu, Wyszukiwanie AI platformy Azure normalizuje te wartości do UTC. Na przykład 2024-01-13T14:03:00-08:00 jest przechowywany jako 2024-01-13T22:03:00Z. Jeśli musisz przechowywać informacje o strefie czasowej, dodaj dodatkową kolumnę do indeksu dla tego punktu danych.
Porady dotyczące indeksowania przyrostowego
Indeksatory automatyzują indeksowanie przyrostowe. Jeśli możesz użyć indeksatora, a źródło danych obsługuje śledzenie zmian, możesz uruchomić indeksator w harmonogramie cyklicznym, aby dodać, zaktualizować lub zastąpić zawartość z możliwością wyszukiwania, aby była synchronizowana z danymi zewnętrznymi.
Jeśli tworzysz wywołania indeksu bezpośrednio za pośrednictwem interfejsu API wypychania, użyj
mergeOrUploadjako czynność wyszukiwania.Ładunek musi zawierać klucze lub identyfikatory każdego dokumentu, który chcesz dodać, zaktualizować lub usunąć.
Jeśli indeks zawiera pola wektorowe, a właściwość jest ustawiona na
storedfalse, upewnij się, że wektor został uwzględniony w częściowej aktualizacji dokumentu, nawet jeśli wartość jest niezmieniona. Efektem ubocznym ustawieniastoredna fałsz jest fakt, że wektory są porzucane podczas operacji ponownego indeksowania. Podanie wektora w ładunku dokumentów uniemożliwia takie zdarzenie.Aby zaktualizować zawartość prostych pól i pól podrzędnych w typach złożonych, wyświetl listę tylko pól, które chcesz zmienić. Jeśli na przykład musisz zaktualizować tylko pole opisu, ładunek powinien składać się z klucza dokumentu i zmodyfikowanego opisu. Pominięcie innych pól zachowuje istniejące wartości.
Aby scalić zmiany liniowe w kolekcji ciągów, podaj całą wartość.
tagsPrzypomnij sobie przykład pola z poprzedniej sekcji. Nowe wartości zastępują stare wartości dla całego pola i nie ma scalania w zawartości pola.
Oto przykład interfejsu API REST pokazujący następujące porady:
### Get Stay-Kay City Hotel by ID
GET  {{baseUrl}}/indexes/hotels-vector-quickstart/docs('1')?api-version=2026-04-01  HTTP/1.1
    Content-Type: application/json
    api-key: {{apiKey}}

### Change the description, city, and tags for Stay-Kay City Hotel
POST {{baseUrl}}/indexes/hotels-vector-quickstart/docs/search.index?api-version=2026-04-01  HTTP/1.1
  Content-Type: application/json
  api-key: {{apiKey}}

    {
        "value": [
            {
            "@search.action": "mergeOrUpload",
            "HotelId": "1",
            "Description": "I'm overwriting the description for Stay-Kay City Hotel.",
            "Tags": ["my old item", "my new item"],
            "Address": {
                "City": "Gotham City"
                }
            }
        ]
    }

### Retrieve the same document, confirm the overwrites and retention of all other values
GET  {{baseUrl}}/indexes/hotels-vector-quickstart/docs('1')?api-version=2026-04-01  HTTP/1.1
    Content-Type: application/json
    api-key: {{apiKey}}
Dokumentacja:Dokumenty — indeks, dokument odnośnika
Przykłady zestawu SDK
W poniższych przykładach pokazano, jak zaktualizować dokumenty przy użyciu Azure SDKs.
from azure.core.credentials import AzureKeyCredential
from azure.search.documents import SearchClient

# Set up the client
service_name = "<your-search-service-name>"
index_name = "hotels-sample"
api_key = "<your-admin-api-key>"

endpoint = f"https://{service_name}.search.windows.net"
credential = AzureKeyCredential(api_key)
client = SearchClient(endpoint=endpoint, index_name=index_name, credential=credential)

# Update documents using merge_or_upload
documents = [
    {
        "HotelId": "1",
        "Description": "Updated description for the hotel.",
        "Tags": ["updated", "renovated"]
    }
]

result = client.merge_or_upload_documents(documents=documents)
print(f"Updated {len(result)} document(s)")
Reference:SearchClient, merge_or_upload_documents
Aktualizowanie schematu indeksu
Schemat indeksu definiuje fizyczne struktury danych utworzone w usłudze wyszukiwania, więc nie ma wielu zmian schematu, które można wprowadzić bez ponoszenia pełnej kompilacji.
Aktualizacje bez ponownej kompilacji
Poniższa lista wylicza zmiany schematu, które można bezproblemowo wprowadzić do istniejącego indeksu. Ogólnie rzecz biorąc, lista zawiera nowe pola i funkcje używane podczas wykonywania zapytania.
- Dodawanie opisu indeksu
- Dodawanie nowego pola
- Ustawianie atrybutu
retrievablew istniejącym polu - Aktualizuj
searchAnalyzerna polu z istniejącymindexAnalyzer - Dodawanie nowej definicji analizatora w indeksie (które można zastosować do nowych pól)
- Dodawanie, aktualizowanie lub usuwanie profilów oceniania
- Dodawanie, aktualizowanie lub usuwanie map synonimów
- Dodawanie, aktualizowanie lub usuwanie konfiguracji semantycznych
- Dodawanie, aktualizowanie lub usuwanie ustawień mechanizmu CORS
Kolejność operacji to:
Popraw schemat za pomocą aktualizacji z poprzedniej listy.
Zaktualizuj schemat indeksu w usłudze wyszukiwania.
Zaktualizuj zawartość indeksu , aby pasowała do zmienionego schematu, jeśli dodano nowe pole. W przypadku wszystkich innych zmian istniejąca indeksowana zawartość jest używana as-is.
Po zaktualizowaniu schematu indeksu w celu uwzględnienia nowego pola istniejące dokumenty w indeksie otrzymują wartość null dla tego pola. W następnym zadaniu indeksowania, wartości z danych zewnętrznego źródła zastępują null-e dodane przez Wyszukiwanie AI platformy Azure.
Podczas aktualizacji nie powinny występować żadne zakłócenia zapytań, ale wyniki zapytania będą się różnić w miarę wprowadzania aktualizacji.
Aktualizacje wymagające ponownej kompilacji
Niektóre modyfikacje wymagają upuszczania i ponownego kompilowania indeksu, zastępując bieżący indeks nowym.
| Działania | Opis |
|---|---|
| Usuwanie pola | Aby fizycznie usunąć wszystkie ślady pola, należy ponownie skompilować indeks. Gdy natychmiastowa ponowna kompilacja nie jest praktyczna, można zmodyfikować kod aplikacji, aby przekierować dostęp z przestarzałego pola lub użyć parametrów zapytania searchFields oraz select, aby określić, które pola są przeszukiwane i zwracane. Fizycznie definicja i zawartość pola pozostają w indeksie do momentu następnego ponownego zbudowania, po zastosowaniu schematu, który pomija dane pole. |
| Zmienianie definicji pola | Poprawki nazwy pola, typu danych lub określonych atrybutów indeksu (z możliwością wyszukiwania, filtrowania, sortowania, możliwości tworzenia aspektów) wymagają pełnej przebudowy. |
| Przypisywanie analizatora do pola | Analizatory są definiowane w indeksie, przypisywane do pól, a następnie wywoływane podczas indeksowania w celu informowania o tworzeniu tokenów. W dowolnym momencie można dodać nową definicję analizatora do indeksu, ale można przypisać tylko analizator po utworzeniu pola. Dotyczy to zarówno właściwości analyzer , jak i indexAnalyzer . Właściwość searchAnalyzer jest wyjątkiem (tę właściwość można przypisać do istniejącego pola). |
| Aktualizowanie lub usuwanie definicji analizatora w indeksie | Nie można usunąć ani zmienić istniejącej konfiguracji analizatora (analizatora, tokenizatora, filtru tokenu lub filtru znaków) w indeksie, chyba że ponownie skompilujesz cały indeks. |
| Dodawanie pola do sugestora | Jeśli pole już istnieje i chcesz dodać je do konstrukcji sugestorów, przebuduj indeks. |
| Uaktualnij swoją usługę lub poziom | Jeśli potrzebujesz większej pojemności, sprawdź, czy możesz uaktualnić usługę lub przełączyć się na wyższą warstwę cenową. Jeśli nie, musisz utworzyć nową usługę i ponownie skompilować indeksy od podstaw. Aby zautomatyzować ten proces, możesz użyć przykładowego kodu, który wykonuje kopię zapasową indeksu w serii plików JSON. Następnie możesz ponownie utworzyć indeks w określonej usłudze wyszukiwania. |
Kolejność operacji to:
Pobierz definicję indeksu , jeśli potrzebujesz jej do użycia w przyszłości lub jako podstawy dla nowej wersji.
Rozważ użycie rozwiązania do tworzenia kopii zapasowej i przywracania w celu zachowania kopii zawartości indeksu. Istnieją rozwiązania w C# i w Python. Zalecamy Python wersję, ponieważ jest ona bardziej aktualna.
Jeśli masz pojemność w usłudze wyszukiwania, zachowaj istniejący indeks podczas tworzenia i testowania nowego.
Usuń istniejący indeks. Zapytania skierowane do indeksu są natychmiast porzucane. Pamiętaj, że usunięcie indeksu jest nieodwracalne, co spowoduje zniszczenie fizycznego przechowywania zbioru pól i innych konstrukcji.
Opublikuj poprawiony indeks, w którym treść żądania zawiera zmienione lub zmodyfikowane definicje pól i konfiguracje.
Załaduj indeks z dokumentami ze źródła zewnętrznego. Dokumenty są indeksowane przy użyciu definicji pól i konfiguracji nowego schematu.
Podczas tworzenia indeksu magazyn fizyczny jest przydzielany dla każdego pola w schemacie indeksu z odwróconym indeksem utworzonym dla każdego pola z możliwością wyszukiwania i indeksem wektorowym utworzonym dla każdego pola wektora. Pola, których nie można wyszukiwać, mogą być używane w filtrach lub wyrażeniach, ale nie mają odwróconych indeksów i nie są przeszukiwane pełnotekstowo ani za pomocą wyszukiwania zbliżonego. Podczas odbudowy indeksu te odwrócone indeksy i indeksy wektorowe są usuwane i tworzone ponownie na podstawie podanego schematu indeksu.
Aby zminimalizować zakłócenia w kodzie aplikacji, rozważ utworzenie aliasu indeksu. Kod aplikacji odwołuje się do aliasu, ale można zaktualizować nazwę indeksu wskazywanego przez alias.
Dodawanie opisu indeksu
Indeks ma description właściwość, którą można określić i użyć, gdy system musi uzyskać dostęp do kilku indeksów i podjąć decyzję na podstawie opisu. Rozważmy serwer protokołu MCP (Model Context Protocol), który musi wybrać prawidłowy indeks w czasie wykonywania. Decyzja może być oparta na opisie, a nie na samej nazwie indeksu.
Opis indeksu to aktualizacja schematu i można ją dodać bez konieczności ponownego kompilowania całego indeksu.
- Długość ciągu wynosi maksymalnie 4000 znaków.
- Zawartość musi być czytelna dla człowieka w formacie Unicode. Przypadek użycia powinien określać język do użycia.
Opis indeksu można dodać za pomocą portalu Azure, najnowszego stabilnego interfejsu API REST lub pakietu Azure SDK, który udostępnia tę funkcję.
Portal Azure obsługuje najnowszy interfejs API w wersji zapoznawczej.
Przejdź do usługi wyszukiwania w portalu Azure.
W obszarzeIndeksy> wybierz indeks.
Wybierz pozycję Edytuj kod JSON.
Wstaw
"description", a następnie opis. Wartość musi być mniejsza niż 4000 znaków i w formacie Unicode.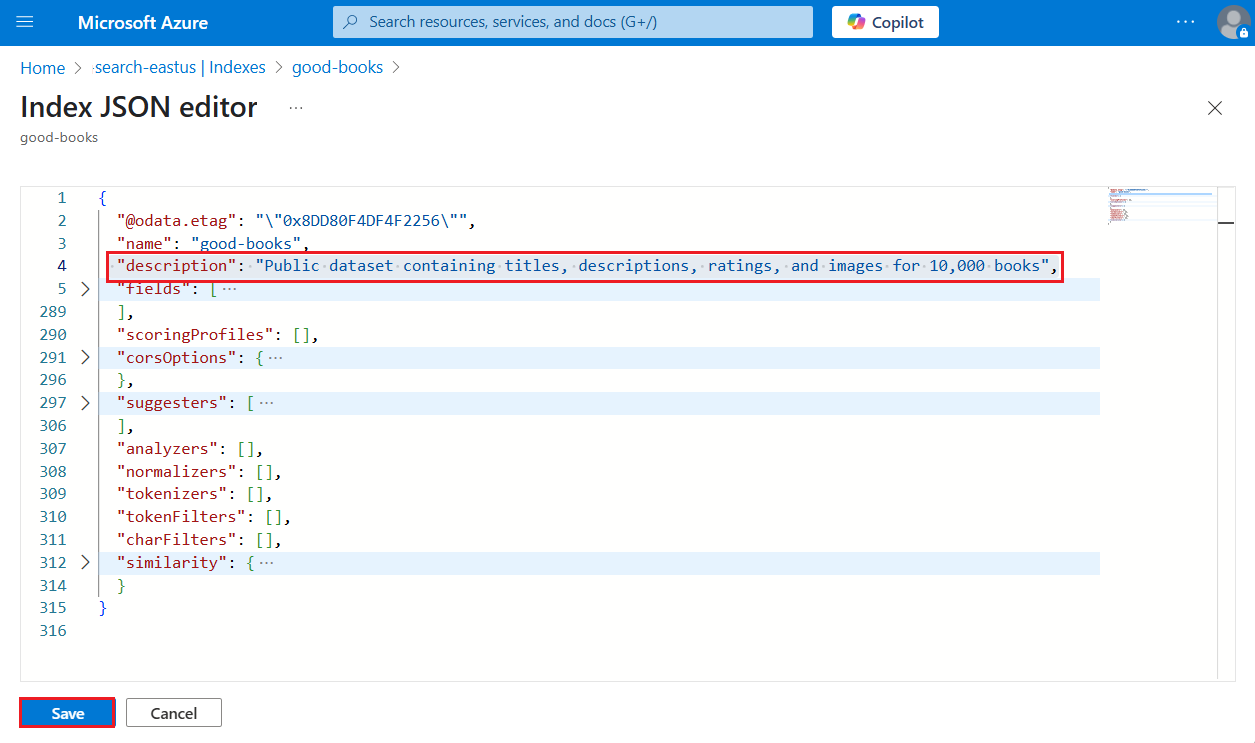
Zapisz indeks.
Równoważenie obciążeń
Indeksowanie nie działa w tle, ale usługa wyszukiwania równoważy wszystkie zadania indeksowania względem bieżących zapytań. Podczas indeksowania można monitorować żądania zapytań w portalu Azure, aby zapewnić wykonywanie zapytań w odpowiednim czasie.
Jeśli obciążenia indeksowania wprowadzają niedopuszczalne poziomy opóźnienia zapytań, przeprowadź analizę wydajności i przejrzyj te porady dotyczące wydajności , aby uzyskać potencjalne środki zaradcze.
Sprawdzanie dostępności aktualizacji
Możesz rozpocząć wykonywanie zapytań dotyczących indeksu zaraz po załadowaniu pierwszego dokumentu. Jeśli znasz identyfikator dokumentu, interfejs API REST wyszukiwania dokumentów zwraca określony dokument. W przypadku szerszego testowania należy poczekać na pełne załadowanie indeksu, a następnie użyć zapytań, aby zweryfikować oczekiwany kontekst.
Aby sprawdzić zaktualizowaną zawartość, możesz użyć Eksploratora wyszukiwania lub klienta REST .
Jeśli dodano lub zmieniono nazwę pola, użyj opcji wybierz , aby zwrócić to pole:
"search": "*",
"select": "document-id, my-new-field, some-old-field",
"count": true
Portal Azure udostępnia rozmiar indeksu i rozmiar indeksu wektorowego. Te wartości można sprawdzić po zaktualizowaniu indeksu, ale pamiętaj, aby spodziewać się małego opóźnienia, ponieważ usługa przetwarza zmianę i uwzględnia częstotliwość odświeżania portalu, co może potrwać kilka minut.
Rozwiązywanie problemów z ponownym indeksowaniem
W poniższej tabeli wymieniono typowe problemy występujące podczas aktualizowania lub ponownego kompilowania indeksów oraz sposobu ich rozwiązywania.
| Problem | Przyczyna | Rozdzielczość |
|---|---|---|
| Odpowiedź HTTP 207 z wynikami mieszanymi | Niektóre dokumenty zakończyły się pomyślnie, inne zakończyły się niepowodzeniem. | Sprawdź statusCode dla każdego dokumentu w odpowiedzi. Jeśli wystąpi błąd 503, zmniejsz liczbę żądań i spróbuj ponownie. |
| Konflikt wersji 409 | Równoczesne aktualizacje tego samego dokumentu. | Serializuj aktualizacje tego samego dokumentu lub zaimplementuj ponawianie przy użyciu wycofywania wykładniczego. |
| 429 Zbyt wiele żądań | Przekroczono limit przydziału przestrzeni składowania lub zbyt wiele współbieżnych żądań. | Usuń dokumenty, aby zwolnić miejsce, lub uaktualnij pakiet usługi, aby zwiększyć pojemność. |
| Usługa 503 jest niedostępna | Usługa pod dużym obciążeniem. | Zaczekaj i ponów próbę z eksponencjalnym opóźnieniem. Rozważ zmniejszenie rozmiaru partii. |
| Liczba dokumentów bez zmian po usunięciu | Usuwanie jest asynchroniczne. | Poczekaj 2–3 minuty, aż proces w tle zakończy fizyczne usunięcie. |
| Nowe pole zwraca wartość null | Pole dodane do schematu, ale dokumenty nie są ponownie indeksowane. | Uruchom indeksator lub wypchnij zaktualizowane dokumenty, aby wypełnić nowe pole. |
| Odrzucono zmianę schematu | Podjęto próbę niekompatybilnej zmiany (zmiana nazwy, zmiana typu). | Usuń i odtwórz indeks. Użyj aliasu indeksu, aby zmniejszyć przestoje. |
Zobacz też
- Omówienie indeksatora
- Usuwanie dokumentów z indeksu wyszukiwania
- Indeksowanie dużych zestawów danych na dużą skalę
- Indeksowanie w portalu Azure
- Indeksator bazy danych Azure SQL
- Azure Cosmos DB dla indeksatora NoSQL
- Azure indeksator obiektów blob
- indeksator tabel Azure
- Dane, prywatność i wbudowane zabezpieczenia