Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Uwaga / Notatka
Foundry IQ (Wyszukiwanie AI platformy Azure) udostępnia bezpośrednie interfejsy API indeksowania i zapytań, a także interfejsy API wyższego poziomu dla źródeł wiedzy i baz wiedzy do zarządzanego pobierania. Użyj portalu Azure, interfejsów API REST lub Azure SDKs, aby skonfigurować te możliwości lub połączyć agentów z bazami wiedzy w portalu Microsoft Foundry.
Indeksator tabel Azure importuje zawartość z Azure Table Storage do indeksu Foundry IQ (Wyszukiwanie AI platformy Azure). Dane wejściowe indeksatora to twoje jednostki danych w jednej tabeli. Dane wyjściowe to indeks wyszukiwania z możliwością wyszukiwania zawartości i metadanymi przechowywanymi w poszczególnych polach.
Ten artykuł uzupełnia tworzenie indeksatora o informacje specyficzne dla indeksowania z usługi Azure Table Storage. Używa ona witryny Azure Portal i interfejsów API REST, aby zademonstrować trzyczęściowy przepływ pracy wspólny dla wszystkich indeksatorów: tworzenie źródła danych, tworzenie indeksu, tworzenie indeksatora. Wyodrębnianie danych odbywa się podczas przesyłania żądania utworzenia indeksatora.
Wymagania wstępne
Tabele zawierające tekst. Jeśli masz dane binarne, rozważ wzbogacanie sztucznej inteligencji na potrzeby analizy obrazów.
Uprawnienia do odczytu w usłudze Azure Storage. Connection string "pełny dostęp" zawiera klucz, który zapewnia dostęp do zawartości, ale jeśli używasz ról Azure, upewnij się, że tożsamość zarządzana usługi Foundry IQ ma uprawnienia Storage Table Data Reader.
Aby pracować z przykładami w tym artykule, potrzebujesz witryny Azure Portal lub klienta REST. Jeśli używasz witryny Azure Portal, upewnij się, że dostęp do wszystkich sieci publicznych jest włączony. Inne podejścia do tworzenia indeksatora tabel platformy Azure obejmują zestawy AZURE SDK.
Wypróbuj przykładowe dane
Skorzystaj z tych instrukcji, aby utworzyć tabelę w usłudze Azure Storage na potrzeby testowania.
Zaloguj się do Azure Portal, przejdź do swojego konta magazynu i utwórz tabelę o nazwie hotels.
Pobierz HotelsData_toAzureSearch.csv z GitHub. Ten plik jest podzbiorem wbudowanego przykładowego zestawu danych hoteli. Pomija kolekcję pokoi, przetłumaczone opisy i współrzędne geograficzne.
W Eksploratorze Azure Storage zaloguj się do Azure, wybierz swoją subskrypcję, a następnie wybierz konto magazynu.
Otwórz tabele i wybierz hotele.
Wybierz pozycję Importuj na pasku poleceń, a następnie wybierz plik HotelsData_toAzureSearch.csv .
Zaakceptuj wartości domyślne. Wybierz pozycję Importuj , aby załadować dane.
W tabeli powinny znajdować się 50 rekordów hotelowych z automatycznie wygenerowanym kluczem partycji, kluczem wiersza i sygnaturą czasową. Teraz możesz używać tej zawartości do indeksowania w witrynie Azure Portal, kliencie REST lub zestawie Azure SDK.
Pole Opis zawiera najbardziej szczegółową zawartość. To pole powinno być przeznaczone dla wyszukiwania pełnotekstowego i opcjonalnych zapytań wektorowych.
Korzystanie z witryny Azure Portal
Za pomocą kreatora importu danych można zautomatyzować indeksowanie z tabeli lub widoku bazy danych SQL.
Na stronie Połącz z danymi wybierz lub sprawdź, czy typ źródła danych to Azure Table Storage lub czy pola wyboru danych wymagają wskazania tabel.
Nazwa źródła danych odwołuje się do obiektu połączenia ze źródłem danych w usłudze Foundry IQ. Nazwa źródła danych jest generowana automatycznie przy użyciu niestandardowego prefiksu określonego na końcu procesu kreatora.
Określ nazwę konta magazynu i tabeli. Zapytanie jest opcjonalne. Jest to przydatne, jeśli masz określone kolumny, które chcesz zaimportować.
Określ metodę uwierzytelniania , tożsamość zarządzaną lub wbudowany klucz interfejsu API. ** Jeśli nie określisz połączenia tożsamości zarządzanej, Azure Portal użyje klucza.
Jeśli skonfigurujesz Foundry IQ do używania tożsamości zarządzanej i utworzysz przypisanie roli w Azure Storage, które przyznaje tożsamości rolę Storage Table Data Reader, indeksator może połączyć się z magazynem tabel przy użyciu Microsoft Entra ID.
Można określić opcje wykrywania usuwania.
Wykrywanie usuwania wymaga istniejącego pola w tabeli, którego można użyć jako flagi miękkiego usunięcia. Powinno to być pole Boolean (można je nazwać "IsDeleted"). Określ
truejako wartość miękkiego usunięcia. W indeksie wyszukiwania dodaj odpowiednie pole wyszukiwania o nazwie IsDeleted ustawione na pobieranie i filtrowanie.Kontynuuj z pozostałymi krokami, aby ukończyć kreatora.
Korzystanie z interfejsów API REST
W tej sekcji przedstawiono wywołania interfejsu API REST, które tworzą źródło danych, indeks i indeksator.
Definiowanie źródła danych
Definicja źródła danych określa dane źródłowe do indeksowania, poświadczeń i zasad wykrywania zmian. Źródło danych to niezależny zasób, który może być używany przez wiele indeksatorów.
Utwórz lub zaktualizuj źródło danych, aby zdefiniować je:
 POST https://[service name].search.windows.net/datasources?api-version=2026-10-01
 {
     "name": "my-table-storage-ds",
     "description": null,
     "type": "azuretable",
     "subtype": null,
     "credentials": {
        "connectionString": "DefaultEndpointsProtocol=https;AccountName=<account name>"
     },
     "container": {
        "name": "my-table-in-azure-storage",
        "query": ""
     },
     "dataChangeDetectionPolicy": null,
     "dataDeletionDetectionPolicy": null,
     "encryptionKey": null,
     "identity": null
 }
Ustaw wartość "type" na
"azuretable"(wymagane).Ustaw wartość "credentials" na parametry połączenia usługi Azure Storage. W następnej sekcji opisano obsługiwane formaty.
Ustaw "container" jako nazwę tabeli.
Opcjonalnie, ustaw "query" jako filtr na PartitionKey. Ustawienie tej właściwości jest najlepszym rozwiązaniem, które poprawia wydajność. Jeśli "zapytanie" ma wartość null, indeksator wykonuje pełne skanowanie tabeli, co może spowodować niską wydajność, jeśli tabele są duże.
Definicja źródła danych może również obejmować polityki miękkiego usuwania, jeśli indeksator ma usunąć dokument wyszukiwania, gdy dokument źródłowy jest oflagowany do usunięcia.
Obsługiwane poświadczenia i parametry połączenia
Indeksatory mogą łączyć się z tabelą przy użyciu następujących połączeń.
| Pełny dostęp do konta magazynu parametry połączenia |
|---|
{ "connectionString" : "DefaultEndpointsProtocol=https;AccountName=<your storage account>;AccountKey=<your account key>;" } |
| Ciąg połączenia można pobrać ze strony konta magazynowego w portalu Azure, wybierając Klucze dostępu w lewym panelu. Pamiętaj, aby wybrać pełny ciąg połączenia, a nie tylko klucz. |
| Parametry połączenia tożsamości zarządzanej |
|---|
{ "connectionString" : "ResourceId=/subscriptions/<your subscription ID>/resourceGroups/<your resource group name>/providers/Microsoft.Storage/storageAccounts/<your storage account name>/;" } |
| Ten parametry połączenia nie wymaga klucza konta, ale musisz wcześniej skonfigurować usługę Foundry IQ w celu nawiązania połączenia przy użyciu tożsamości zarządzanej. |
| Parametry połączenia sygnatury współdzielonego dostępu (SAS) konta magazynowego |
|---|
{ "connectionString" : "BlobEndpoint=https://<your account>.blob.core.windows.net/;SharedAccessSignature=?sv=2016-05-31&sig=<the signature>&spr=https&se=<the validity end time>&srt=co&ss=b&sp=rl;" } |
| SAS powinien mieć uprawnienia do listowania i odczytu tabel i bytów. |
| Sygnatura dostępu współdzielonego kontenera |
|---|
{ "connectionString" : "ContainerSharedAccessUri=https://<your storage account>.blob.core.windows.net/<container name>?sv=2016-05-31&sr=c&sig=<the signature>&se=<the validity end time>&sp=rl;" } |
| Sygnatura dostępu współdzielonego powinna mieć uprawnienia do odczytu i listy w kontenerze. Aby uzyskać więcej informacji, zobacz Udzielanie ograniczonego dostępu do zasobów usługi Azure Storage przy użyciu sygnatur dostępu współdzielonego (SAS). |
Uwaga / Notatka
Jeśli używasz poświadczeń SAS, musisz okresowo aktualizować poświadczenia źródła danych, korzystając z odnowionych podpisów, aby zapobiec ich wygaśnięciu. Jeśli poświadczenia sygnatury dostępu współdzielonego wygasną, indeksator zakończy się niepowodzeniem i wyświetli komunikat o błędzie podobny do "Poświadczenia podane w parametrach połączenia są nieprawidłowe lub wygasły".
Partycjonowanie dla większej wydajności
Domyślnie funkcja IQ usługi Foundry używa następującego wewnętrznego filtru zapytań, aby śledzić, które jednostki źródłowe zostały zaktualizowane od ostatniego uruchomienia: Timestamp >= HighWaterMarkValue. Ponieważ tabele platformy Azure nie mają indeksu pomocniczego w Timestamp polu, ten typ zapytania wymaga pełnego skanowania tabeli i dlatego jest powolny dla dużych tabel.
Aby uniknąć pełnego skanowania, można użyć partycji tabeli, aby zawęzić zakres każdego zadania indeksatora.
Jeśli dane mogą być naturalnie podzielone na kilka zakresów partycji, utwórz źródło danych i odpowiedni indeksator dla każdego zakresu partycji. Każdy indeksator musi teraz przetwarzać tylko określony zakres partycji, co skutkuje lepszą wydajnością zapytań. Jeśli dane, które należy indeksować, mają niewielką liczbę stałych partycji, jeszcze lepiej: każdy indeksator wykonuje tylko skanowanie partycji.
Aby na przykład utworzyć źródło danych do przetwarzania zakresu partycji z kluczami z
000do100, użyj zapytania w następujący sposób:"container" : { "name" : "my-table", "query" : "PartitionKey ge '000' and PartitionKey lt '100' " }Jeśli dane są partycjonowane według czasu (na przykład jeśli tworzysz nową partycję codziennie lub tydzień), rozważ następujące podejście:
W definicji źródła danych określ zapytanie podobne do następującego przykładu:
(PartitionKey ge <TimeStamp>) and (other filters).Monitoruj postęp indeksatora przy użyciu interfejsu API pobierania stanu indeksatora i okresowo aktualizuj
<TimeStamp>stan zapytania na podstawie najnowszej pomyślnej wartości znacznika wysokiego poziomu.W przypadku tego podejścia, jeśli musisz wyzwolić pełne ponowne indeksowanie, zresetuj zapytanie źródła danych oprócz zresetowania indeksatora.
Dodawanie pól wyszukiwania do indeksu
W indeksie wyszukiwania dodaj pola umożliwiające przyjęcie zawartości i metadanych jednostek tabeli.
Utwórz lub zaktualizuj indeks, aby zdefiniować pola wyszukiwania, które przechowują zawartość z jednostek:
POST https://[service name].search.windows.net/indexes?api-version=2026-10-01
{
  "name" : "my-search-index",
  "fields": [
    { "name": "Key", "type": "Edm.String", "key": true, "searchable": false },
    { "name": "SomeColumnInMyTable", "type": "Edm.String", "searchable": true }
  ]
}
Utwórz pole klucza dokumentu ("key": true), ale zezwól indeksatorowi na automatyczne wypełnienie go. Indeksator tabeli wypełnia pole klucza połączonymi kluczami partycji i kluczami wierszy z tabeli. Jeśli na przykład klucz partycji wiersza to
1, a wartość RowKey to1_123, wartość klucza to11_123. Jeśli klucz partycji ma wartość null, używany jest tylko klucz wiersza.Jeśli używasz kreatora importu danych do utworzenia indeksu, witryna Azure Portal wywnioskuje pole "Klucz" dla indeksu wyszukiwania i używa niejawnego mapowania pól w celu połączenia pól źródłowych i docelowych. Nie musisz samodzielnie dodawać pola i nie trzeba konfigurować mapowania pól.
Jeśli używasz interfejsów API REST i chcesz niejawnych mapowań pól, utwórz i nadaj nazwę polu klucza dokumentu "Klucz" w definicji indeksu wyszukiwania, jak pokazano w poprzednim kroku (
{ "name": "Key", "type": "Edm.String", "key": true, "searchable": false }). Indeksator wypełnia pole Klucz automatycznie bez wymaganych mapowań pól.Jeśli nie potrzebujesz pola o nazwie "Klucz" w indeksie wyszukiwania, dodaj jawne mapowanie pól w definicji indeksatora z odpowiednią nazwą pola, ustawiając pole źródłowe na "Klucz":
 "fieldMappings" : [
   {
     "sourceFieldName" : "Key",
     "targetFieldName" : "MyDocumentKeyFieldName"
   }
]
Teraz dodaj wszelkie inne pola encji, które chcesz uwzględnić w indeksie. Jeśli na przykład jednostka wygląda jak w poniższym przykładzie, indeks wyszukiwania powinien zawierać pola HotelName, Description i Category, aby otrzymywać te wartości.
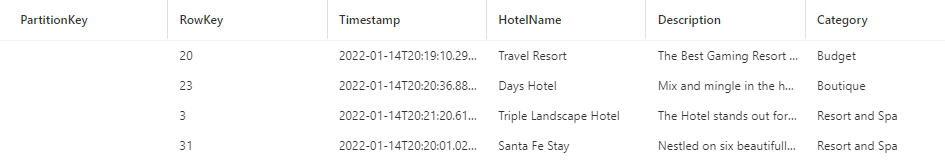
Użycie tych samych nazw i zgodnych typów danych minimalizuje potrzebę mapowania pól. Gdy nazwy i typy są takie same, indeksator może automatycznie określić ścieżkę danych.
Konfigurowanie i uruchamianie indeksatora tabel
Po utworzeniu indeksu i źródła danych możesz utworzyć indeksator. Konfiguracja indeksatora określa dane wejściowe, parametry i właściwości kontrolujące zachowania czasu wykonywania.
Utwórz lub zaktualizuj indeksator , podając mu nazwę i odwołując się do źródła danych i indeksu docelowego:
POST https://[service name].search.windows.net/indexers?api-version=2026-10-01
{
    "name" : "my-table-indexer",
    "dataSourceName" : "my-table-storage-ds",
    "targetIndexName" : "my-search-index",
    "disabled": null,
    "schedule": null,
    "parameters" : {
        "batchSize" : null,
        "maxFailedItems" : null,
        "maxFailedItemsPerBatch" : null,
        "configuration" : { }
    },
    "fieldMappings" : [ ],
    "cache": null,
    "encryptionKey": null
}
Określ mapowania pól , jeśli istnieją różnice w nazwie lub typie pola lub jeśli potrzebujesz wielu wersji pola źródłowego w indeksie wyszukiwania. Pole Target (Cel) to nazwa pola w indeksie wyszukiwania.
 "fieldMappings" : [
   {
     "sourceFieldName" : "Description",
     "targetFieldName" : "HotelDescription"
   }
]
Aby uzyskać więcej informacji na temat innych właściwości, zobacz Tworzenie indeksatora .
Indeksator jest uruchamiany automatycznie po jego utworzeniu. Możesz temu zapobiec, ustawiając wartość "disabled" na true. Aby kontrolować wykonywanie indeksatora, uruchom indeksator na żądanie lub umieść go zgodnie z harmonogramem.
Sprawdzanie stanu indeksatora
Aby monitorować stan indeksatora i historię wykonywania, sprawdź historię wykonywania indeksatora w portalu Azure lub wyślij żądanie interfejsu API REST Pobierania stanu indeksatora.
Na stronie usługi Foundry IQ otwórz pozycję Zarządzanie wyszukiwaniem>.
Wybierz indeksator, aby uzyskać dostęp do konfiguracji i historii wykonywania.
Wybierz określone zadanie indeksatora, aby wyświetlić szczegóły, ostrzeżenia i błędy.
Historia wykonywania zawiera do 50 ostatnio wykonanych wykonań, które są sortowane w odwrotnej kolejności chronologicznej, tak aby najnowsze wykonanie było wykonywane jako pierwsze.
Dalsze kroki
Dowiedz się więcej na temat uruchamiania indeksatora, monitorowania stanu lub planowania wykonywania indeksatora. Następujące artykuły dotyczą indeksatorów, które ściągają zawartość z usługi Azure Storage: