Note
Azure AI 検索は、Azure ポータル、REST API、およびAzure SDKから使用できます。 また、Foundry IQ は、エンタープライズ コンテンツを、Microsoft Foundry ポータルのエージェントの再利用可能なアクセス許可に対応したナレッジ ベースに変換するマネージド ナレッジ レイヤーです。
新しいAzure AI 検索 サービスの構成には、セキュリティ、アクセス、およびパフォーマンスを最適化するためのいくつかのタスクが含まれます。 この記事では、Azure ポータルでサービスを設定するのに役立つ 1 日のチェックリストを提供します。
検索サービスを作成した後は、次のことをお勧めします。
ロールベースのアクセスを構成する
ポータルへのアクセスは、 ロールの割り当てに基づいています。 既定では、新しい検索サービスには少なくとも 1 人のサービス管理者または所有者がいます。 サービス管理者、共同管理者、所有者は、より多くの管理者を作成し、他のロールを割り当てるアクセス許可を持っています。 また、既定の検索サービスのすべてのポータル ページと操作にアクセスできます。
ヒント
既定では、管理者または所有者はサービスを作成または削除できます。 誤って削除されないようにするには、 リソースをロックすることを検討してください。
各検索サービスには API キー が付属しており、既定ではキーベースの認証が使用されます。 ただし、セキュリティを強化するために、Microsoft Entra IDとロールベースのアクセス制御 (RBAC) を使用することをお勧めします。 RBAC を使用すると、プレーン テキストで API キーを格納して渡す必要がなくなります。
キーベースの認証からキーレス認証に切り替える場合、サービス管理者はオブジェクトとデータへのフル アクセスのためにデータ プレーン ロールを自分自身に割り当てる必要があります。 これらのロールには、Search Service 共同作成者、検索インデックス データ共同作成者、および検索インデックス データ閲覧者が含まれます。
ロールベースのアクセスを構成するには:
検索サービスでロールを有効にします。 API キーとロールの両方を使用することをお勧めします。
API キーを無効にしたときに失われた機能を置き換えるためにデータ プレーン ロールを割り当てます。 所有者は検索インデックス データ閲覧者のみを必要としますが、開発者はより 多くのロールを必要とします。
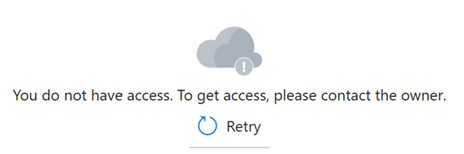
ロールの割り当てが有効になるまでに数分かかる場合があります。 それまでは、データ プレーン操作に使用されるポータル ページに次のメッセージが表示されます。
ソリューション開発者とアプリにさらにロールを割り当てます。
マネージド ID の構成
自動インデックス作成、適用された AI、または統合ベクター化にインデクサーを使用する場合は、 マネージド ID を使用するように検索サービスを構成する必要があります。 その後、検索サービスがデータや操作にアクセスすることを承認する他のAzure サービスにロールを割り当てることができます。
統合ベクター化の場合、検索サービス ID には次のロールが必要です。
- Azure Storage のストレージ BLOB データ閲覧者
- Microsoft Foundry リソースの Cognitive Services データ ユーザー
ロールの割り当てが有効になるまでに数分かかる場合があります。
ネットワーク セキュリティに進む前に、すべての接続ポイントをテストしてロールの割り当てを検証することを検討してください。 インポート ウィザードを実行してアクセス許可をテストします。
ネットワーク セキュリティを構成する
既定では、検索サービスは、パブリック インターネット接続経由で認証済みおよび承認された要求を受け入れます。 ネットワーク セキュリティを強化するには、次の 2 つのオプションがあります。
- IP アドレスによるネットワーク アクセスを制限するようにファイアウォール規則を構成します。
- 仮想ネットワークからのトラフィックのみを許可するようにプライベート エンドポイントAzure構成します。 パブリック エンドポイントをオフにすると、 データのインポート ウィザードは実行されません。
Azure AI 検索での着信呼び出しと発信呼び出しの詳細については、ネットワーク トラフィック パターンを参照してください。
容量を確認し、課金を理解する
既定では、検索サービスは 1 つのレプリカと 1 つのパーティションで作成されます。 レプリカとパーティションを 追加することで容量を追加 できますが、ボリュームで必要になるまで待機することをお勧めします。 多くのお客様は、最小限の構成で運用ワークロードを実行します。
セマンティック ランカーとエージェント検索は、既定で無料プランに設定されている Premium 機能です。 無料利用分を超える有料使用が必要な場合は、「 セマンティック ランカーの課金を有効または無効にする 」および 「エージェント検索課金を有効または無効にする」を参照してください。
課金に影響するその他の機能については、「プランとAzure AI 検索 サービスのコストの管理を参照してください。
診断ログを有効にする
診断ログを有効 にして、ユーザー アクティビティを追跡します。 この手順をスキップしても、 アクティビティ ログ と プラットフォーム メトリックが 自動的に取得されます。 ただし、インデックスとクエリの使用状況情報が必要な場合は、診断ログを有効にして、ログに記録される操作の宛先を選択する必要があります。 耐久性のあるストレージとして Log Analytics ワークスペースを使用することをお勧めします。これにより、Azure ポータルでシステムクエリを実行できます。
内部的には、Microsoftはサービスとプラットフォームに関するテレメトリ データを収集します。 データ保持の詳細については、「 メトリックのリテンション期間」を参照してください。
データの場所とプライバシーの詳細については、「 データ所在地」を参照してください。
開発者に接続情報を提供する
Azure AI 検索に接続するには、開発者は次のものが必要です。
- [概要] ページのエンドポイントまたは URL。
- キー ページからの API キー、またはロールの割り当て。 検索サービス共同作成者、検索インデックスデータ共同作成者、および検索インデックスデータ閲覧者をお勧めします。
データのインポート ウィザードと検索エクスプローラーにはポータル アクセスをお勧めします。 ウィザードを実行するには、共同作成者以上である必要があります。
関連コンテンツ
サービス管理のプログラムによるサポートについては、次の API とモジュールを参照してください。
.NET、Python、Java、JavaScript のAzure SDKの管理クライアント ライブラリを使用することもできます。
プレビュー管理機能を除き、すべてのモダリティと言語に機能パリティがあります。 一般的なルールとして、プレビュー管理機能は最初に管理 REST API を通じてリリースされます。