Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Remarque
Recherche Azure AI est disponible via le portail Azure, les API REST et les SDK Azure. Il sous-tend également Foundry IQ, la couche de connaissances managée qui transforme le contenu d’entreprise en bases de connaissances réutilisables et prenant en charge les autorisations pour les agents dans le portail Microsoft Foundry.
Recherche Azure AI propose deux modèles tarifaires qui gèrent la capacité différemment :
Dédié : planifiez la capacité en dimensionnant les réplicas et les partitions et en sélectionnant un niveau de service.
- Préprovisionner la capacité directement à l’aide de réplicas et de partitions.
- Estimer le stockage nécessaire (partitions) et le débit nécessaire (répliques).
- Choisissez un niveau de service pour provisionner la capacité nécessaire en fonction de la demande maximale attendue.
- Une fois que vous avez configuré la capacité en amont, vous payez un taux horaire mesuré par unités de recherche (SUS), quelle que soit l’utilisation.
Serverless (préversion) : le service gère automatiquement la capacité en fonction des limites d’utilisation et de service. Vous n’avez pas besoin de préprovisionner la capacité. Au lieu de cela, optimisez l’efficacité de votre charge de travail pour gérer les coûts.
- La capacité est automatiquement mise à l’échelle avec la demande (peut être mise à l’échelle à zéro en cas d’inactivité).
- Vous êtes facturé en fonction de l’utilisation réelle mesurée par les unités de calcul et le stockage.
- Plutôt que l’infrastructure, la planification se concentre sur ces facteurs de coûts : modèles de requête, taille d’index et croissance, et modèles d’ingestion de données. Consultez Optimiser le coût du modèle serverless.
| Dimension | Dedicated | Serverless |
|---|---|---|
| Modèle de capacité | Approvisionné (répliques × partitions) | Basé sur la consommation |
| Scaling | Manuel | Automatique |
| Contrôle utilisateur | Explicite (configurer des réplicas et des partitions) | Indirect (influencé par les caractéristiques de la charge de travail) |
| Billing | Taux horaire fixe par unités de recherche (SUS) | Paiements basés sur la consommation pour les unités de calcul (UNITÉS de calcul) et le stockage |
| Coût inactif | Toujours engagé (capacité provisionnée minimale) | Passe à zéro lorsqu’il est inactif |
| Focus d’optimisation | Dimensionnement de l’infrastructure | Efficacité de la charge de travail |
| Idéal pour | Charges de travail prévisibles et stables | Charges de travail variables, en pics ou multilocataires, y compris les scénarios pilotés par des agents |
| Approche de planification de la capacité | Taille et mise à l’échelle de l’infrastructure (réplicas et partitions) | Optimiser l’efficacité de la charge de travail et les modèles d’utilisation |
| Impact sur l’inefficacité | Latence et pression de mise à l’échelle | Augmentation directe des coûts |
Important
Le niveau Développeur serverlessr est actuellement en préversion. Cette version préliminaire est fournie sans contrat de niveau de service et n’est pas recommandée pour les environnements de production. Certaines fonctionnalités peuvent ne pas être prises en charge ou avoir des fonctionnalités contraintes. Pour plus d’informations, consultez Conditions d'utilisation supplémentaires pour les versions préliminaires de Microsoft Azure.
La facturation de l’offre Développeur sans serveur a débuté le 13 septembre 2026. Les frais d’utilisation sur ou après cette date apparaissent sur votre facture Azure. Vous n’êtes pas facturé pour l’utilisation avant le 13 septembre 2026.
Le niveau Développeur serverless ne prend pas en charge la migration vers ou depuis d’autres niveaux tarifaires et certaines fonctionnalités disponibles sur d’autres niveaux ne sont pas prises en charge pendant la préversion publique. Les limites de service, les fonctionnalités prises en charge et les détails des tarifs peuvent changer avant la disponibilité générale.
Pendant la préversion, le modèle de tarification Serverless est pris en charge uniquement dans des régions spécifiques.
Pour en savoir plus, consultez comment :
- Planifier et gérer les coûts
- Choisir un modèle tarifaire et un niveau de service
- Optimiser les coûts avec le modèle de tarification Serverless
Planifier la capacité du modèle dédié
Dans le modèle dédié, vous approvisionnez la capacité à l’aide des unités de recherche (SU) :
- Unité de recherche (SU) = réplicas × partitions
- Réplicas : copies du moteur de recherche. Assure un débit de requêtes élevé et une haute disponibilité.
- Partition : unités de stockage. Assure le stockage et le débit d’indexation.
Chaque service démarre avec 1 réplica × 1 partition (1 SU). Vous pouvez ajouter ou supprimer des réplicas et des partitions indépendamment pour s’adapter à des charges de travail variables. L’ajout de capacité augmente le coût d’exécution d’un service de recherche.
| Concept | Définition |
|---|---|
| Unité de recherche | Incrément unique de la capacité totale disponible. Un minimum d’une unité de recherche est nécessaire pour exécuter le service. Selon votre niveau tarifaire, le nombre maximal varie d’un à 36 unités. Le nombre d’unités de recherche est égal au nombre de réplicas multiplié par le nombre de partitions : R × P = SU. Chaque service commence avec un réplica et une partition, ce qui consomme une unité : 1 × 1 = 1. L’ajout d’un deuxième réplica consomme deux unités : 2 × 1 = 2. Une unité de recherche est également l’unité de facturation d’un service de recherche. |
| Réplique | Instances du service de recherche, principalement utilisées pour équilibrer la charge des opérations de requête. Chaque réplica héberge une copie d’un index. Si vous allouez trois réplicas, vous avez trois copies d’un index disponibles pour traiter les demandes de requête. |
| Partition | Stockage physique et E/S pour les opérations de lecture/écriture (par exemple, pendant la reconstruction ou l’actualisation d’un index). Chaque partition contient une section de l’index total. Si vous allouez trois partitions, l’index est divisé en trois. |
Passez en revue la table des partitions et des réplicas pour connaître les combinaisons possibles qui restent sous la limite de 36 unités.
Les caractéristiques physiques des réplicas et des partitions, telles que la vitesse de traitement et les E/S de disque, varient selon le niveau de service. Sur un service de recherche standard, les réplicas et les partitions sont plus rapides et supérieurs à ceux d’un service de base.
Quand ajouter de la capacité pour le modèle dédié
Envisagez d’ajouter des réplicas ou des partitions quand :
- La latence des requêtes augmente ou les critères de contrat au niveau du service ne sont pas remplis.
- La fréquence des erreurs HTTP 503 (Service indisponible) augmente.
- La fréquence des erreurs HTTP 429 (Trop de requêtes) augmente, ce qui indique la limitation des requêtes.
- Un grand volume de requêtes est attendu.
- Les tâches d’indexation sont lentes ou prennent du retard.
- Le débit de stockage ou d’indexation est insuffisant.
Conseils de mise à l’échelle :
- Ajoutez réplicas pour augmenter le débit des requêtes et la disponibilité.
- Ajoutez des partitions pour augmenter les performances de stockage et d’indexation.
- Les charges de travail à forte intensité de requêtes nécessitent généralement davantage de réplicas.
- Les index volumineux peuvent nécessiter des réplicas supplémentaires pour maintenir les performances.
Important
Les opérations de mise à l’échelle peuvent prendre du temps et augmenter les coûts. Validez toujours les modifications à l’aide des tests de performances et des estimations de prix.
Le niveau de service que vous choisissez détermine la taille et la vitesse de partition. Chaque niveau est optimisé autour d’un ensemble de caractéristiques qui correspondent à différents scénarios. Si vous choisissez un niveau supérieur, vous devrez peut-être moins de partitions que si vous utilisez S1. L’une des questions que vous devez répondre par le biais de tests auto-dirigés est de savoir si une partition plus grande et plus coûteuse génère de meilleures performances que deux partitions moins coûteuses sur un service approvisionné à un niveau inférieur.
Un seul service doit avoir suffisamment de ressources pour gérer toutes les charges de travail (indexation et requêtes). Aucune charge de travail ne s’exécute en arrière-plan. Vous pouvez planifier l’indexation à des moments où les requêtes de requête sont naturellement moins fréquentes, mais le service ne hiérarchise pas une tâche par rapport à une autre. De plus, un certain degré de redondance lisse les performances des requêtes lorsque les services ou les nœuds sont mis à jour en interne.
En règle générale, les applications de recherche tendent à avoir besoin de plus de réplicas que de partitions, en particulier lorsque les opérations de service favorisent les charges de travail de requête. Chaque réplica est une copie de votre index, ce qui permet au service d’équilibrer la charge des requêtes sur plusieurs copies. Recherche Azure AI gère l’équilibrage de charge et la réplication d’un index. Vous pouvez modifier le nombre de réplicas alloués pour votre service à tout moment. Vous pouvez allouer jusqu'à 12 réplicas dans un service de recherche Standard, et 3 dans un service de recherche de base. Vous pouvez allouer des réplicas soit à partir du portail Azure, soit à l’aide de l’une des options programmatiques.
Les partitions supplémentaires sont utiles pour les charges de travail d’indexation intensives. Des partitions supplémentaires répartissent les opérations de lecture et d’écriture sur un plus grand nombre de ressources de calcul.
Enfin, plus les index sont grands, plus ils sont longs à interroger. Par conséquent, peut-être constaterez-vous que chaque augmentation des partitions nécessite une augmentation plus faible mais proportionnelle des répliques. La complexité de vos requêtes et le volume de celles-ci influencent la rapidité d'exécution des requêtes.
Pour connaître les limites de service et les plages de mise à l’échelle valides, consultez :
Remarque
L’ajout de réplicas ou de partitions augmente le coût d’exécution du service et peut introduire de légères variations dans l'ordre des résultats. Veillez à vérifier la calculatrice de prix pour comprendre les implications de facturation de l’ajout de nœuds supplémentaires. Le tableau des combinaisons de partitions et de réplicas peut vous aider à déterminer le nombre d’unités de recherche requises pour une configuration donnée. Pour plus d’informations sur la façon dont les réplicas supplémentaires affectent le traitement des requêtes, consultez le tri des résultats.
Comment gérer et ajuster la capacité
Le changement de capacité n’est pas instantané. Selon le volume de données et le type d’opération, la mise à l’échelle peut prendre de quelques minutes à plusieurs heures.
Durant la mise à l’échelle d’un service de recherche, vous avez le choix entre les approches et les outils suivants :
Remarque
Si votre service de recherche a été créé avant avril ou mai 2024, il peut être éligible à une mise à niveau ponctuelle vers une infrastructure plus récente avec des tailles de partition plus importantes sans coût supplémentaire. Cette mise à niveau peut augmenter le stockage disponible par partition et réduire le nombre de partitions requises pour votre charge de travail. Pour plus d’informations, consultez Mettre à niveau votre service de recherche.
Pour augmenter ou diminuer la capacité de votre service, vous avez deux options :
Ajouter ou supprimer des partitions et des répliques
Accédez à votre service de recherche dans le portail Azure.
Dans le volet gauche, sélectionnez Échelle des paramètres>.
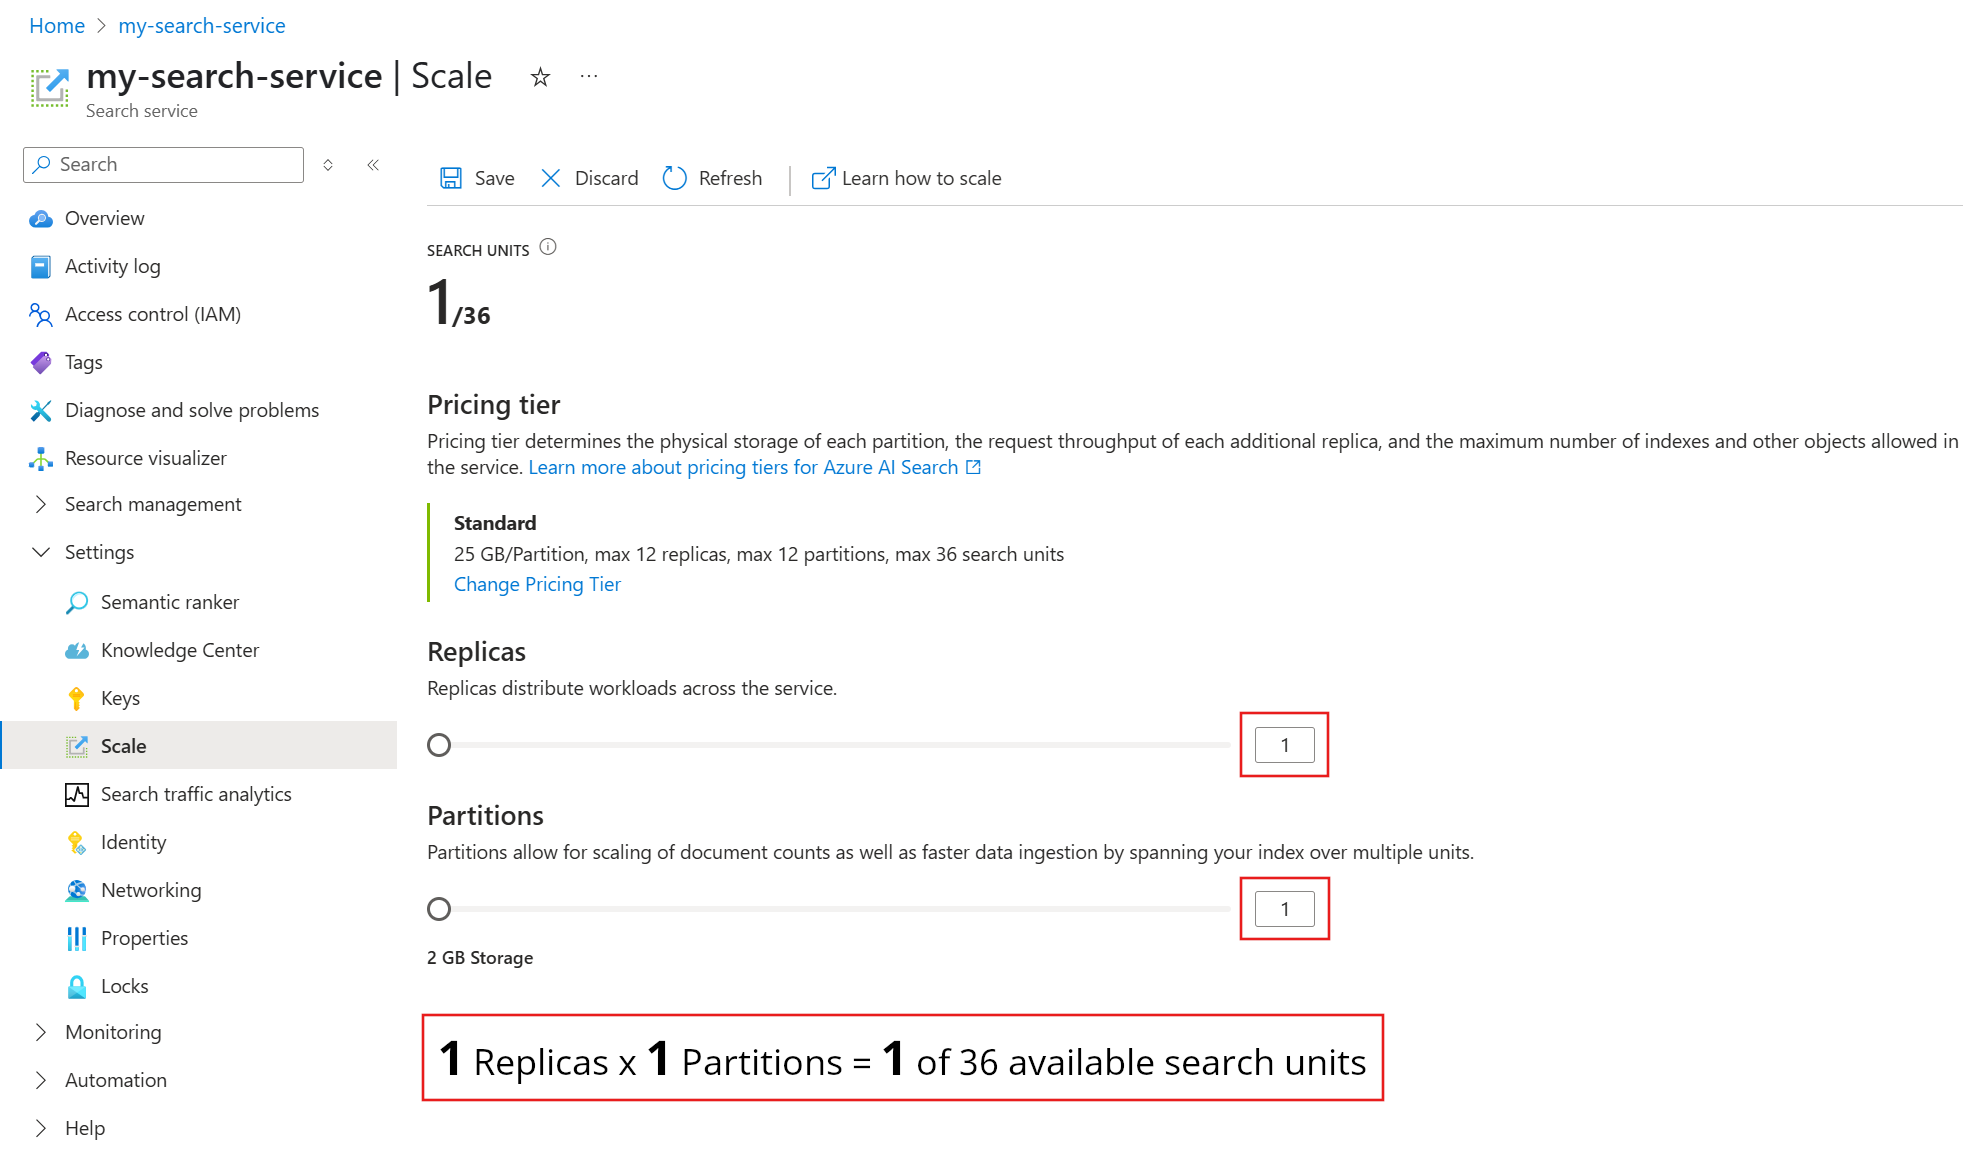
La capture d’écran suivante montre un service Standard provisionné avec une réplique et une partition. La formule en bas indique combien d’unités de recherche sont utilisées (1). Si le prix unitaire était de 100 (prix fictif), le coût mensuel de l’exécution de ce service serait de 100 en moyenne.
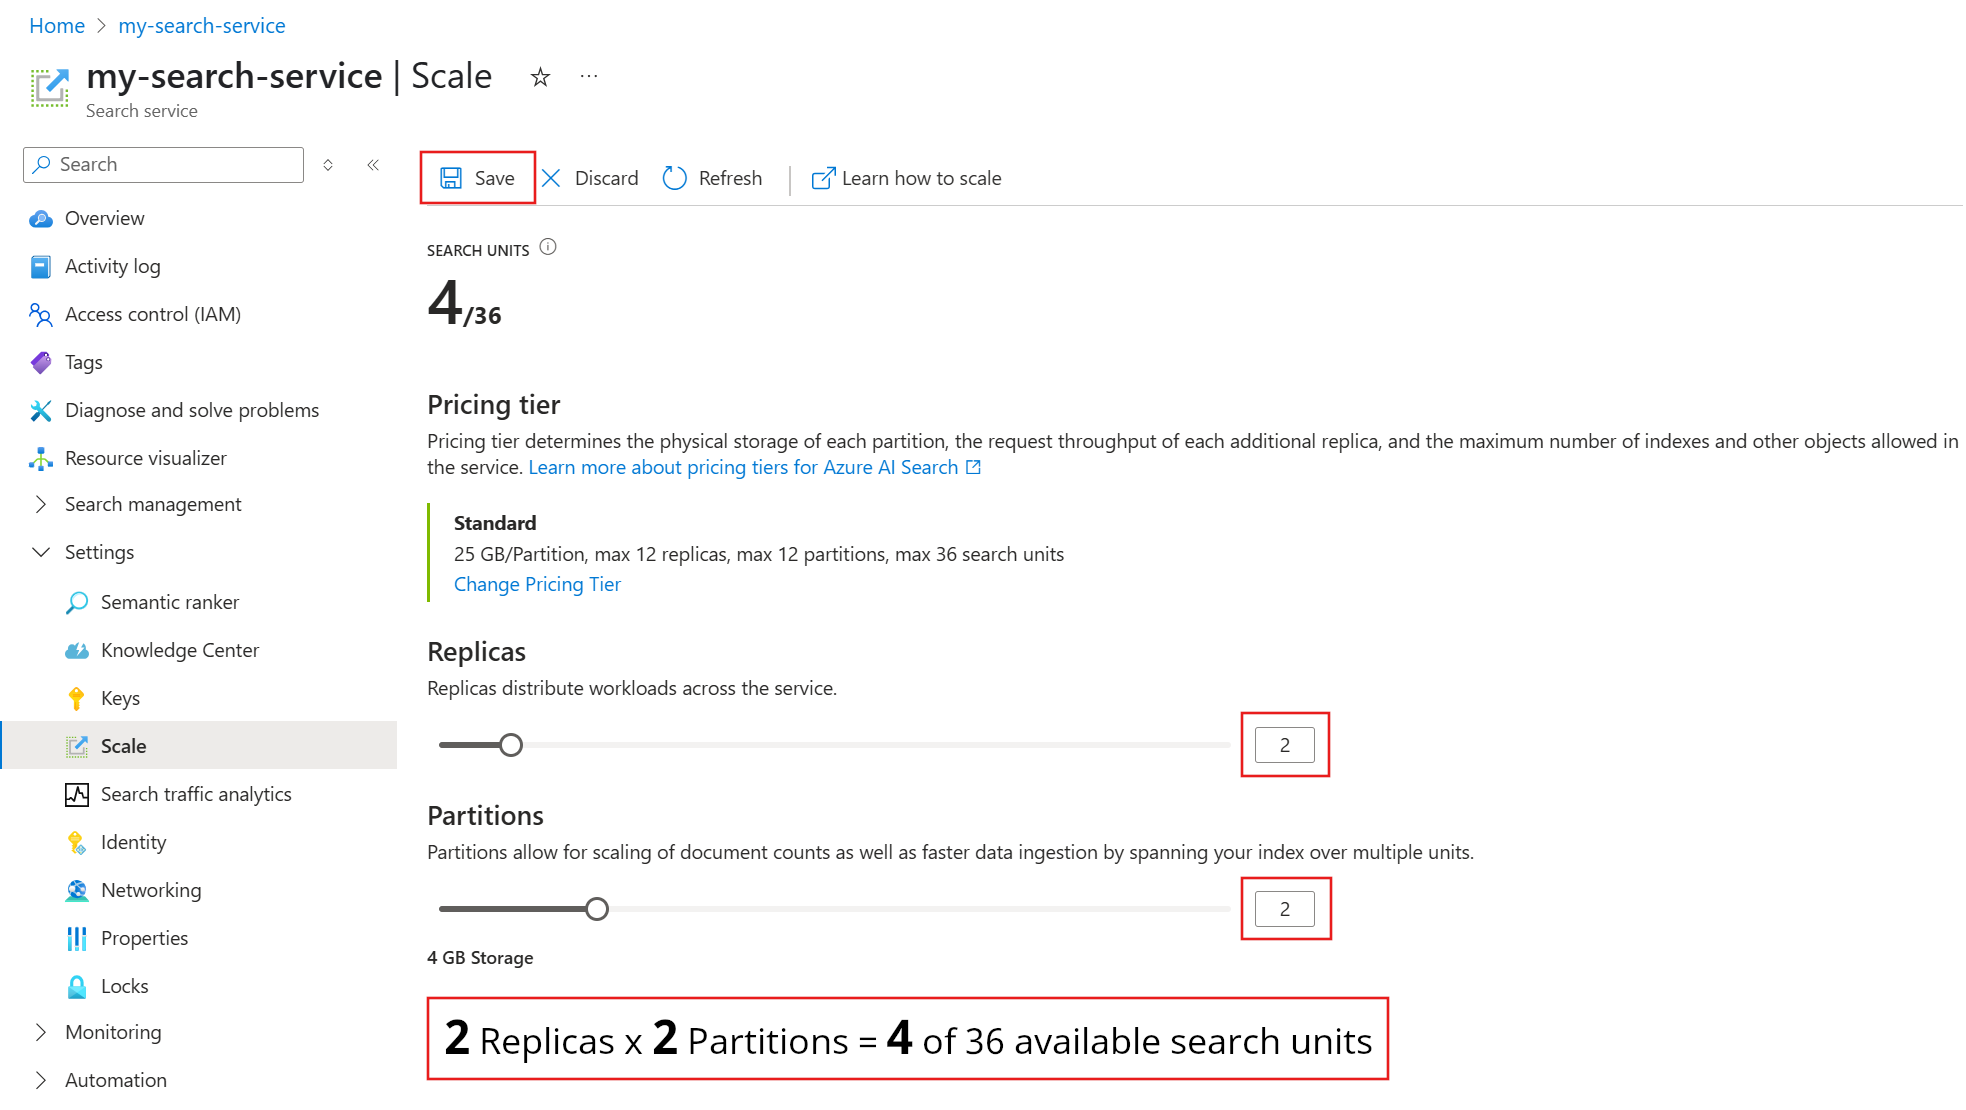
Utilisez le curseur pour augmenter ou diminuer le nombre de partitions, puis sélectionnez Enregistrer.
Cet exemple ajoute une deuxième réplique et une deuxième partition. Notez le nombre d’unités de recherche. Il est désormais de quatre, car la formule de facturation multiplie le nombre de réplicas par le nombre de partitions (2 x 2). Le doublement de la capacité fait plus que doubler le coût de l’exécution du service. Si le coût d’une unité de recherche était de 100, la nouvelle facture mensuelle serait désormais de 400.
Pour connaître les coûts actuels par niveau, consultez la page de tarification.
Vérifiez vos notifications pour confirmer que l’opération a démarré.
Cette opération peut prendre plusieurs heures. Il se produit en arrière-plan, de sorte que votre service de recherche reste entièrement opérationnel et disponible pour les opérations de lecture et d’écriture.
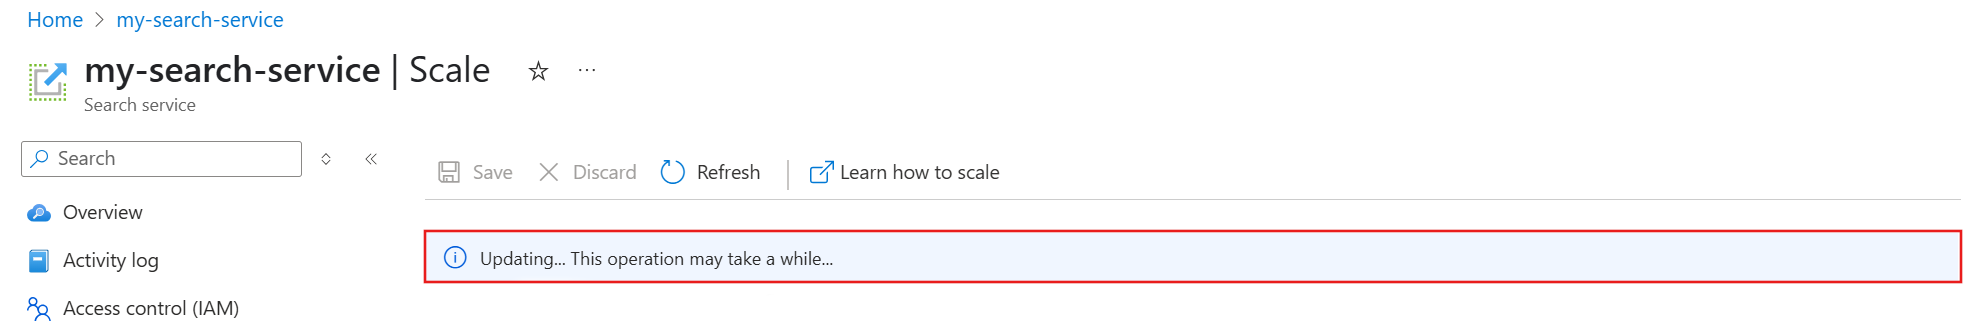
Vous ne pouvez pas annuler l’opération ou surveiller sa progression. Toutefois, le message suivant s’affiche pendant que les modifications sont en cours.
Modifier votre niveau tarifaire
Remarque
Le portail Azure et Services - Update (API REST) prennent en charge les modifications entre les niveaux De base et Standard (S1, S2 et S3). Vous pouvez mettre à niveau ou rétrograder les niveaux, à condition que votre configuration de service actuelle ne dépasse pas les limites du niveau cible. Votre région ne peut pas non plus avoir de contraintes de capacité sur le niveau cible.
Votre niveau tarifaire détermine le stockage maximal de votre service de recherche pour le modèle de tarification dédié. Si vous avez besoin de plus ou moins de capacité, vous pouvez basculer vers un autre niveau tarifaire qui répond à vos besoins de stockage. (Cela s’applique uniquement aux niveaux de modèle tarifaire dédié. Le niveau développeur du modèle serverless ne peut pas être modifié une fois sélectionné).
En plus de la capacité, les niveaux tarifaires déterminent les limites des index, des indexeurs et d’autres objets de recherche. Comparez les limites de service de votre niveau actuel et de votre niveau souhaité avant de continuer. En règle générale, le passage à un niveau supérieur augmente votre limite de stockage et votre limite de vecteur, augmente le débit des requêtes et diminue la latence, tout en basculant vers un niveau inférieur a l’effet inverse.
Le passage à un niveau tarifaire plus élevé augmente également le coût d’exécution de votre service de recherche. Pour plus d’informations, consultez la page relative aux prix appliqués.
Pour modifier votre niveau tarifaire :
Accédez à votre service de recherche dans le portail Azure.
Dans le volet gauche, sélectionnez Échelle des paramètres>.
Sous votre niveau actuel, sélectionnez Modifier le niveau tarifaire.
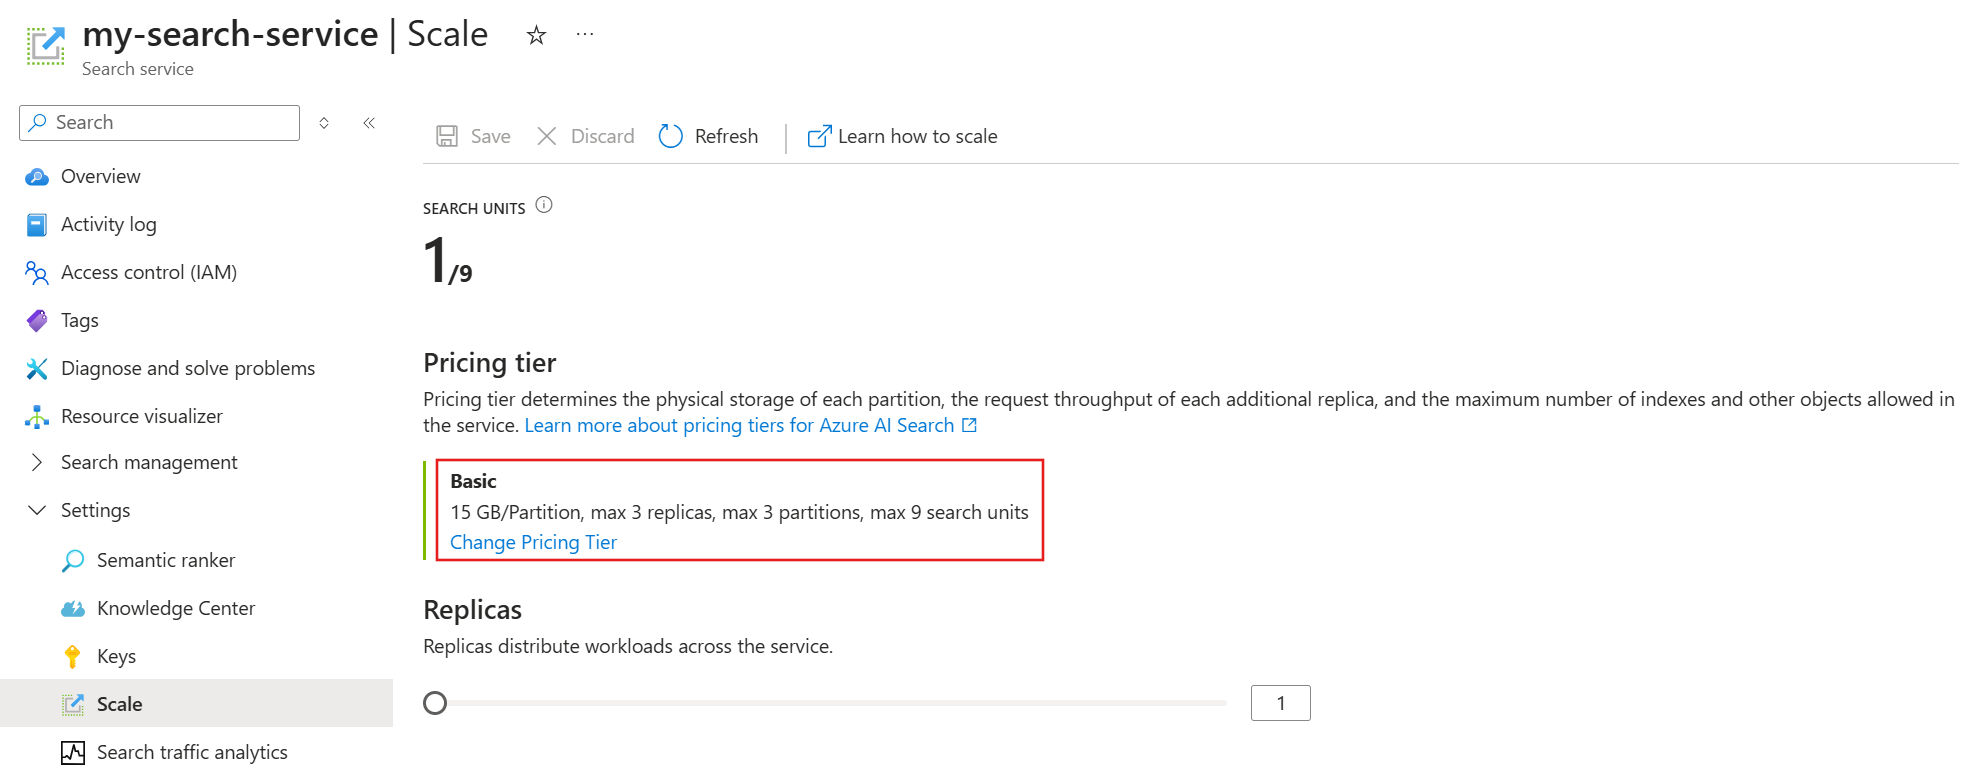
Dans la page Sélectionner le niveau tarifaire , choisissez un autre niveau dans la liste.
Vous pouvez basculer entre Basic, S1, S2 et S3, mais vous ne pouvez pas basculer vers ou depuis Free, S3HD, L1 ou L2. Ces niveaux ne sont pas sélectionnables et apparaissent grisés.
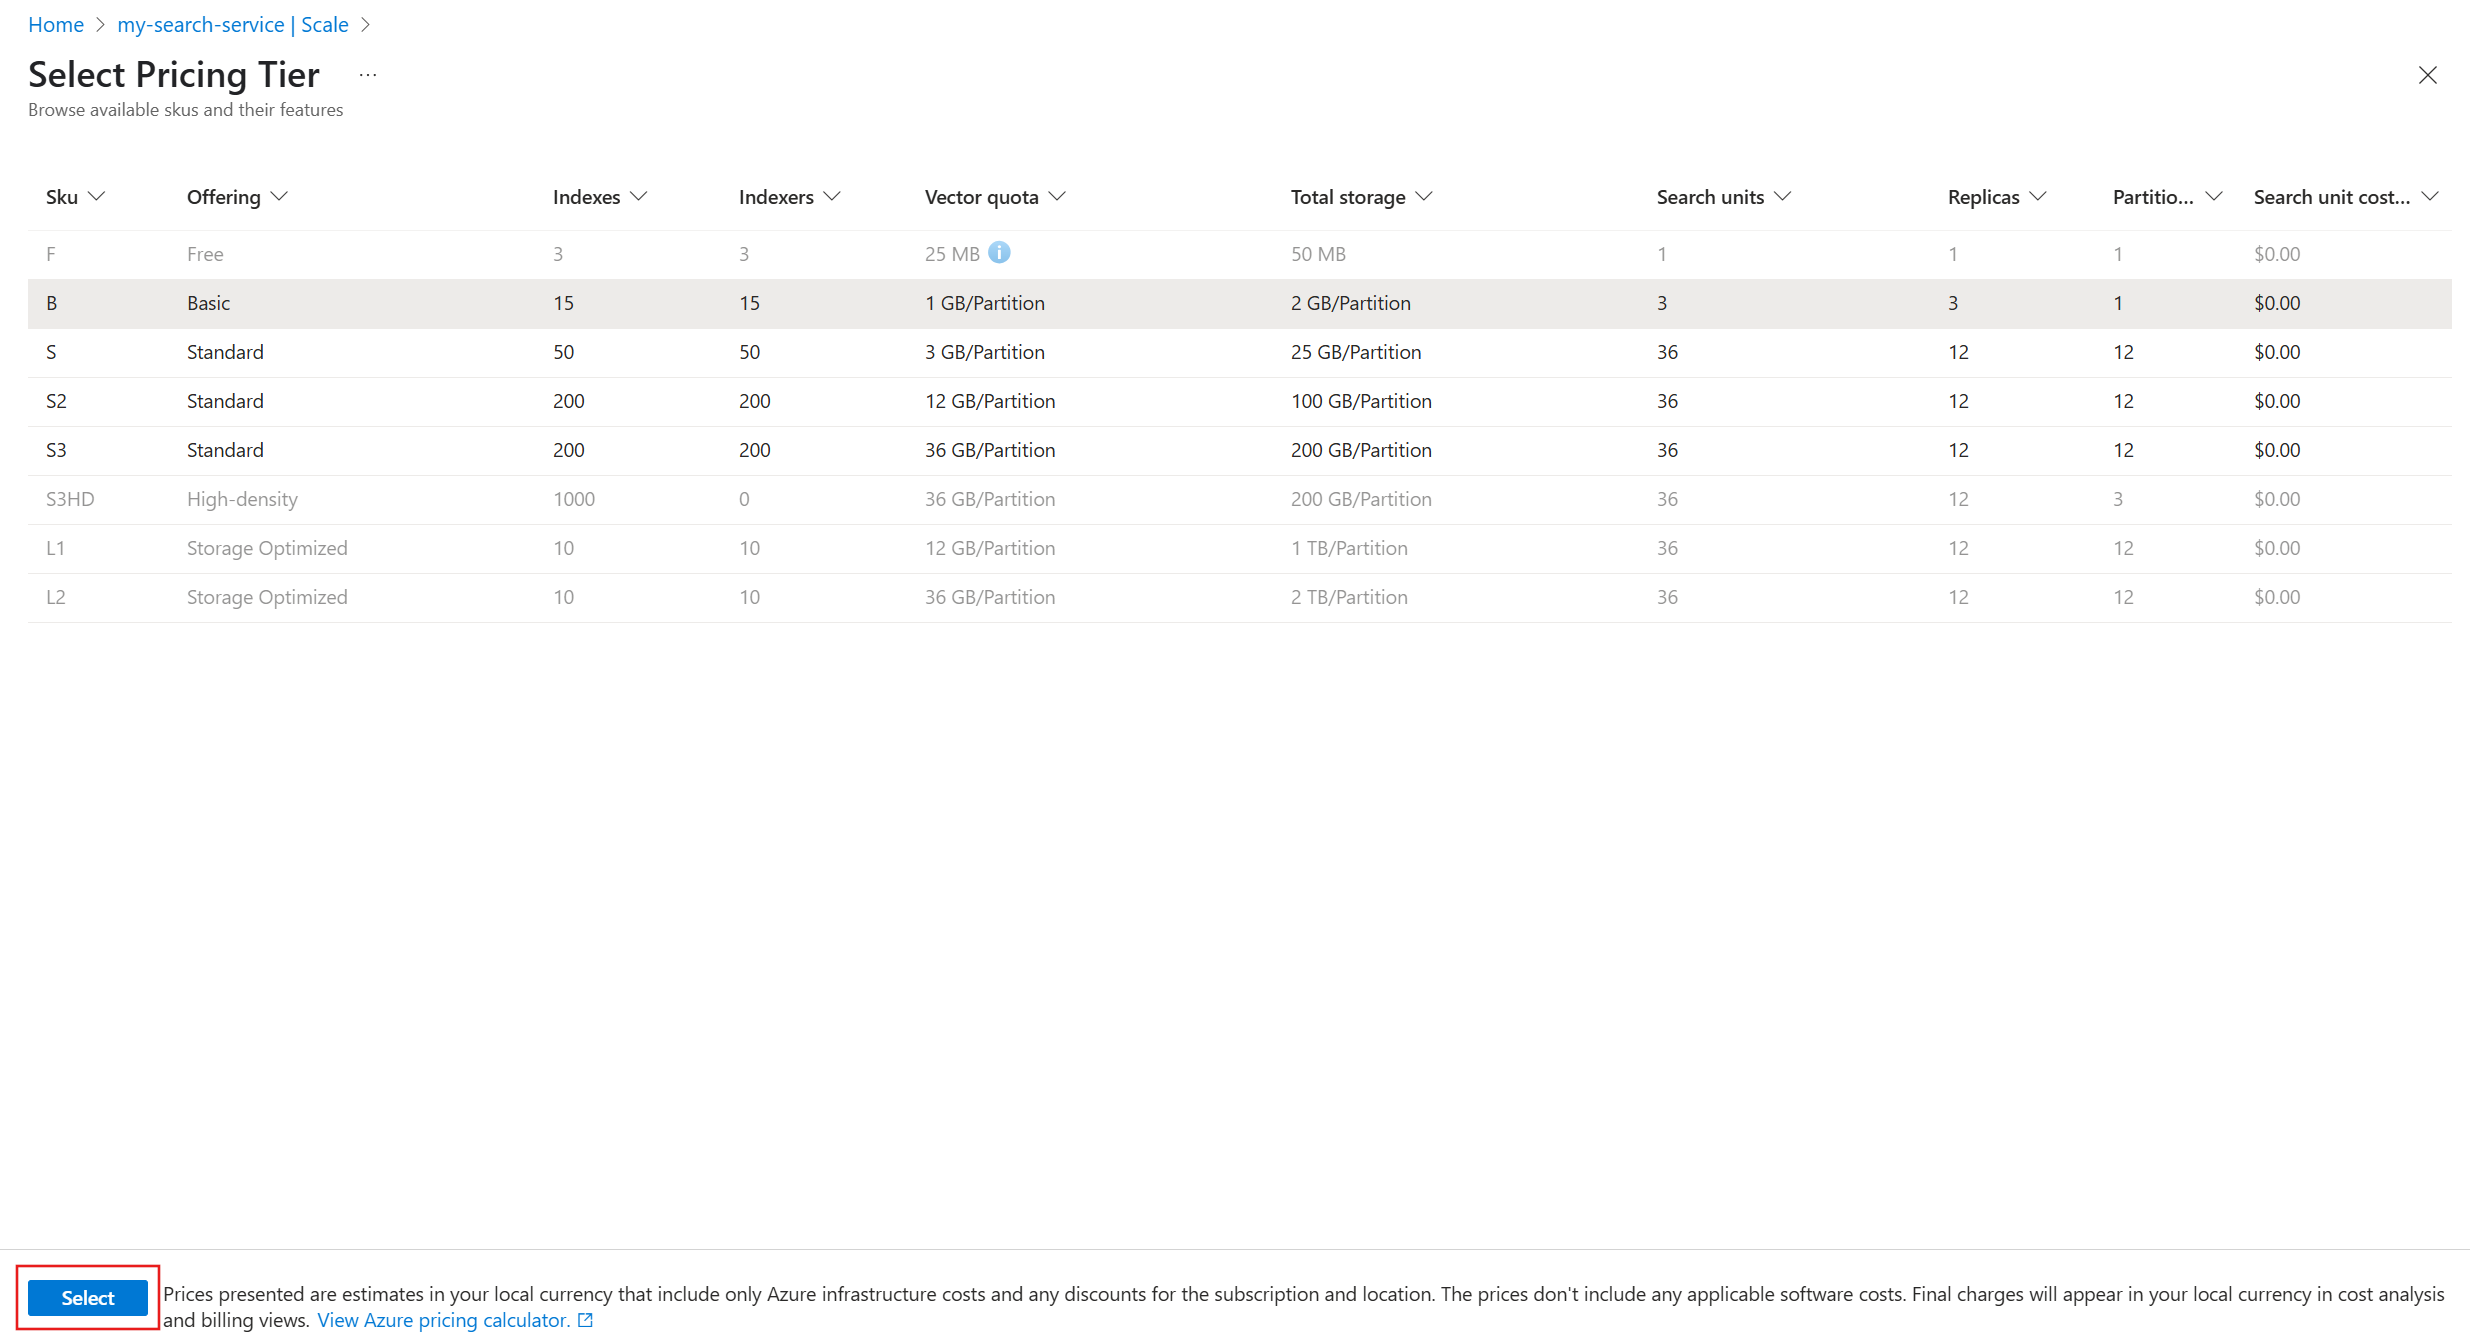
Pour démarrer l’opération de mise à l’échelle, sélectionnez Enregistrer.
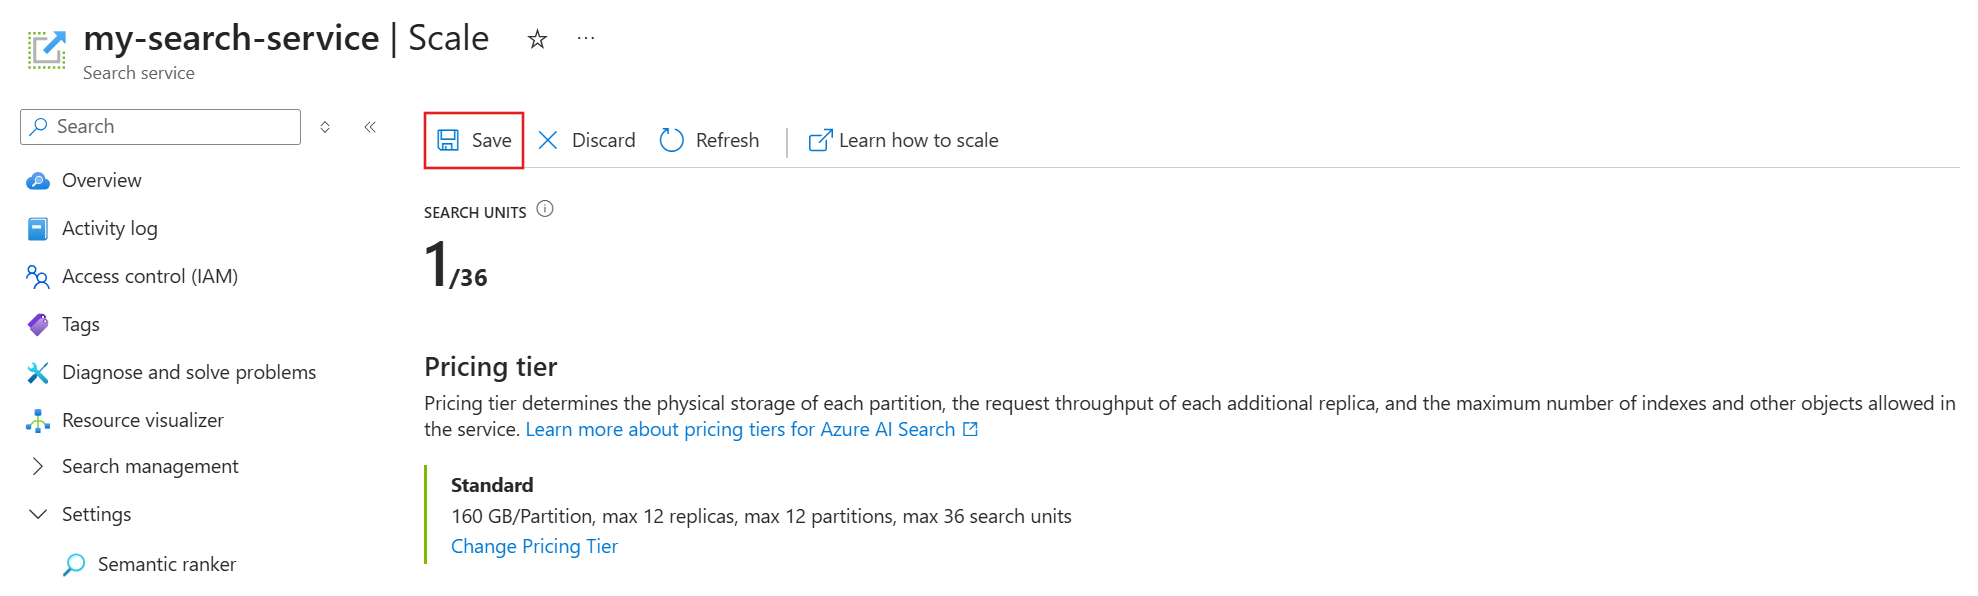
Cette opération peut prendre plusieurs heures. Il se produit en arrière-plan, de sorte que votre service de recherche reste entièrement opérationnel et disponible pour les opérations de lecture et d’écriture.
Vous ne pouvez pas annuler l’opération ou surveiller sa progression. Toutefois, le message suivant s’affiche pendant que les modifications sont en cours.
Comment les demandes de mise à l’échelle sont gérées pour le modèle dédié
Lorsque le service de recherche reçoit une demande de mise à l’échelle, elle :
- Vérifie si la requête est valide.
- Démarre la sauvegarde des données et des informations système.
- Vérifie si le service est déjà dans un état de provisionnement (ajout ou suppression de réplicas ou de partitions).
- Démarre le provisionnement.
La mise à l’échelle d’un service peut prendre plusieurs minutes à plusieurs heures, en fonction de la taille du service et de l’étendue de la requête. La durée de sauvegarde varie également en fonction de la quantité de données et du nombre de partitions et de réplicas.
Les étapes de gestion d’une demande de mise à l’échelle ne sont pas entièrement consécutives. Par exemple, le système démarre le provisionnement quand il peut le faire de manière sécurisée, ce qui peut avoir lieu au moment où la sauvegarde s’achève.
Erreurs durant la mise à l’échelle
Le tableau suivant répertorie les causes et solutions des erreurs qui peuvent se produire pendant les opérations de mise à l’échelle.
| Message d'erreur | La cause | Solution |
|---|---|---|
| « Les opérations de mise à jour de service ne sont pas autorisées pour l’instant, car nous traitons une demande précédente. » | Une autre opération de mise à l’échelle est en cours. | Consultez la page Overview dans le portail Azure ou utilisez l’API REST Search Management, Azure PowerShell ou Azure CLI pour obtenir l’état de votre service de recherche. Si l’état est « En cours de provisionnement », attendez qu’il devienne « Terminé avec succès » ou « Échoué » avant de tenter à nouveau. 1, 2 |
| Impossible de mettre à l’échelle le service de recherche nomduservice. Erreur : Le nombre d’objetsActualCount dépasse la limite autorisée : MaximumCount. » | Votre configuration de service actuelle dépasse les limites du niveau tarifaire cible. | Vérifiez que votre utilisation du stockage, l’utilisation vectorielle, les indexeurs et d’autres objets s’intègrent dans les limites de service du niveau inférieur. Par exemple, le niveau De base prend en charge jusqu’à 15 index. Vous ne pouvez donc pas passer de S1 à Basic si vous avez 16 index. Ajustez vos ressources avant de réessayer. |
1 Il n’existe aucun état pour les sauvegardes, qui sont des opérations internes qui ne sont pas susceptibles d’interrompre un exercice de mise à l’échelle.
2 Si votre service de recherche semble bloqué dans un état d’approvisionnement, recherchez les index orphelins qui ne sont pas utilisables, avec zéro volume de requête et aucune mise à jour d’index. Un index inutilisable peut bloquer les modifications apportées à la capacité de service. En particulier, recherchez les index chiffrés par CMK dont les clés ne sont plus valides. Supprimez l’index ou restaurez les clés pour rétablir l’index en ligne et débloquer votre opération de mise à l’échelle.
combinaisons de partitions et de répliques
Le graphique suivant s’applique au niveau Standard et supérieur. Il affiche toutes les combinaisons possibles de partitions et de réplicas, dans la limite de 36 unités de recherche par service.
| 1 partition | 2 partitions | 3 partitions | 4 partitions | 6 partitions | 12 partitions musicales | |
|---|---|---|---|---|---|---|
| 1 réplica | 1 unité de recherche | 2 unités de recherche | 3 unités de recherche | 4 unités de recherche | 6 unités de recherche | 12 unités de recherche |
| 2 répliques | 2 unités de recherche | 4 unités de recherche | 6 unités de recherche | 8 unités de recherche | 12 unités de recherche | 24 unités de recherche |
| 3 répliques | 3 unités de recherche | 6 unités de recherche | 9 unités de recherche | 12 unités de recherche | 18 unités de recherche | 36 unités de recherche |
| 4 réplicas | 4 unités de recherche | 8 unités de recherche | 12 unités de recherche | 16 unités de recherche | 24 unités de recherche | N/A |
| 5 répliques | 5 US | 10 SU | 15 unités de recherche | 20 unités de recherche | 30 unités de recherche | N/A |
| 6 répliques | 6 unités de recherche | 12 unités de recherche | 18 unités de recherche | 24 unités de recherche | 36 unités de recherche | N/A |
| 12 réplicas | 12 unités de recherche | 24 unités de recherche | 36 unités de recherche | N/A | N/A | N/A |
Les services de recherche Essentiel ont des nombres d’unités de recherche inférieurs.
Sur les services de recherche créés avant le 3 avril 2024, les services de base peuvent avoir exactement une partition et jusqu'à trois répliques pour une limite maximale de trois SUs. Les répliques sont les seules ressources ajustables. Toutefois, vous pouvez augmenter votre nombre de partitions en mettant à niveau votre service.
Sur les services de recherche créés après le 3 avril 2024 dans les régions prises en charge, les services de base peuvent avoir jusqu'à trois partitions et trois réplicas. La limite maximale d’unités de stockage (SU) est de neuf pour prendre en charge un ensemble complet de partitions et de réplicas.
Pour les services de recherche de tout niveau facturable, quelle que soit la date de création, vous avez besoin d’au moins deux réplicas pour assurer la haute disponibilité des requêtes.
Pour connaître les tarifs de facturation par niveau et devise, consultez la page de tarification Recherche Azure AI.
Estimer la capacité à l’aide d’un niveau de modèle tarifaire dédié
Vos besoins de stockage dépendent de la taille des index que vous prévoyez de générer. Il n’y a pas d’heuristique solide ou de directives générales qui aident à estimer les estimations. La seule façon de déterminer la taille d’un index consiste à en créer un. Sa taille dépend de la tokenisation et des incorporations, et de l’activation des suggesteurs, du filtrage et du tri, ou peut tirer parti de la compression vectorielle.
Estimer la capacité sur un niveau facturable, De base ou supérieur. Le niveau Gratuit s’exécute sur des ressources physiques partagées par plusieurs clients et il est soumis à des facteurs qui vous échappent. Seules des ressources dédiées de service de recherche facturable peuvent prendre en charge un échantillonnage et des temps de traitement plus conséquents pour produire des estimations plus réalistes de quantité d’index, de taille et de volume de requête durant le développement.
Passez en revue les limites de service à chaque niveau pour déterminer si les niveaux inférieurs peuvent prendre en charge le nombre d’index dont vous avez besoin. Déterminez votre besoin en copies d’un index pour des environnements actifs de développement, de test et de production.
Un service de recherche est soumis à des limites d’objet (nombre maximal d’index, d’indexeurs, d’ensembles de compétences, et ainsi de suite) et de limites de stockage. Quelle que soit la limite atteinte en premier, c’est la limite effective.
Créez un service à un niveau facturable. Niveaux optimisés pour certaines charges de travail. Par exemple, le niveau optimisé pour le stockage a une limite de 10 index, car il est conçu pour prendre en charge un faible nombre d’index volumineux.
Si vous n’êtes pas sûr de la charge projetée, commencez modestement, au niveau De base ou S1.
Commencez à un niveau élevé, à S2 ou même S3, si les tests comprennent des charges d’interrogation et d’indexation à grande échelle.
Enfin, si vous indexez une grande quantité de données et que la charge de requêtes est relativement faible, comme dans le cas d’une application métier interne, commencez par le niveau À stockage optimisé L1 ou L2.
Générez un index initial pour déterminer comment les données sources se traduisent en index. C’est l’unique façon d’estimer la taille de l’index. Les attributs des définitions de champ affectent les exigences de la mémoire physique :
Pour la recherche par mot clé, le marquage des champs comme filtrables et triables augmente la taille de l’index.
Pour la recherche vectorielle, vous pouvez définir des paramètres pour réduire la taille du vecteur.
Monitor storage, limites de service, volume de requêtes et latence dans le portail Azure. Le portail Azure affiche les requêtes par seconde, les requêtes limitées et la latence de recherche. Ces valeurs peuvent vous aider à décider si vous avez sélectionné le niveau approprié.
Ajoutez des réplicas pour une haute disponibilité ou pour atténuer les contre-performances des requêtes lentes.
Il n’existe aucune instruction sur le nombre de réplicas nécessaires pour prendre en charge les charges d’interrogation. Les performances des requêtes dépendent de la complexité des requêtes et des charges de travail concurrentes. Bien que l’ajout de réplicas entraîne clairement de meilleures performances, le résultat n’est pas strictement linéaire : l’ajout de trois réplicas ne garantit pas un débit multiplié par trois. Pour obtenir des conseils sur l’estimation de QPS pour votre solution, consultez Analyser les performances et surveiller les requêtes.
Pour un index inversé, la taille et la complexité sont déterminés par le contenu, pas nécessairement par la quantité de données que vous entrez dans celui-ci. Une source de données volumineuse avec un haut niveau de redondance peut générer un index plus restreint qu’un jeu de données plus modeste présentant un contenu extrêmement variable. Il est donc généralement impossible de déduire la taille de l’index d’après celle du jeu de données d’origine.
Les exigences de stockage peuvent être gonflées si vous incluez des données que vous ne recherchez jamais. Dans l’idéal, les documents contiennent uniquement les données dont vous avez besoin pour l’expérience de recherche.
Considérations liées au contrat de niveau de service
Les contrats de niveau de service (SLA) ne couvrent pas le niveau gratuit et les fonctionnalités en préversion. Pour tous les niveaux facturables, les SLA entrent en vigueur lorsque vous approvisionnez une redondance suffisante pour votre service.
Au moins deux réplicas répondent aux contrats SLA de requête (lecture).
Un SLA de requête et d’indexation (lecture-écriture) nécessite au moins trois réplicas.
Le nombre de partitions n’affecte pas les SLA.
Optimiser le coût du modèle serverless
Dans le modèle de tarification Serverless :
- Le service gère automatiquement la capacité.
- Vous n’avez pas besoin de configurer des réplicas, des partitions ou des unités de recherche.
- Les ressources de calcul s’adaptent dynamiquement en fonction de la charge de travail (volume de requêtes et besoins d’indexation) et peuvent être ramenées à zéro en cas d’inactivité.
Pour en savoir plus sur les limitations du modèle serverless, consultez Limites du service.
La facturation est basée sur deux dimensions :
- Utilisation du calcul (UC) : Facturé en fonction des opérations de requête et d’indexation.
- Stockage indexé : Facturé par Go par mois.
Étant donné que la facturation est basée sur la consommation, le coût est directement lié à l’utilisation :
- Les requêtes complexes consomment davantage de calcul.
- La conception de schéma inefficace augmente les coûts d’indexation et de requête.
- Les modèles de requête médiocres avec des index volumineux ou fréquemment mis à jour augmentent l’utilisation du stockage et du calcul.
Optimiser l’efficacité de la charge de travail
Étant donné que l’inefficacité s’affiche comme coût dans le modèle serverless, vous payez plus pour le même travail si vous ne pratiquez pas la conception prenant en charge la charge de travail. La meilleure façon de maîtriser les coûts liés au serverless est de concevoir efficacement vos index et vos requêtes dès le départ.
Pour concevoir des charges de travail pour une efficacité lors de l’utilisation du modèle tarifaire Serverless, envisagez les éléments suivants :
Conception des index
- Incluez uniquement les champs utilisés dans les requêtes.
- Réduisez les dimensions vectorielles dans la mesure du possible.
- Évitez les attributs filtrables, triables ou facetables inutiles.
Modèles de requête
- Permet
$selectde limiter les champs retournés. - Appliquez des filtres dès le départ pour réduire les jeux de résultats.
- Évitez la pagination approfondie (
$skip). - Préférez les requêtes ciblées sur les requêtes en texte intégral large.
- Utilisez soigneusement la recherche hybride en raison d’un coût de calcul plus élevé.
Monitoring
- Surveillez la consommation de CU pour identifier les requêtes coûteuses.
- Suivez la croissance du stockage et supprimez les données inutilisées.
Dans Serverless, l’amélioration des performances (requêtes plus rapides et plus ciblées) réduit généralement les coûts.
Pour plus d’informations, consultez Optimisez les coûts avec le modèle de tarification serverless dans Recherche Azure AI.
Considérations relatives à la capacité régionale
La capacité et la disponibilité peuvent varier selon la région prise en charge. Certaines régions peuvent avoir des contraintes sur l’approvisionnement de nouveaux services ou la mise à l’échelle des services existants.
Remarque
Pendant la préversion publique, le modèle de tarification Serverless est disponible uniquement dans des régions spécifiques.
Si votre région de Recherche Azure AI préférée n’est pas disponible en raison de contraintes de capacité, consultez How to handle regional capacity constraints in Recherche Azure AI.