Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Note
Recherche Azure AI est disponible via le portail Azure, les API REST et les SDK Azure. Il sous-tend également Foundry IQ, la couche de connaissances managée qui transforme le contenu d’entreprise en bases de connaissances réutilisables et prenant en charge les autorisations pour les agents dans le portail Microsoft Foundry.
Recherche Azure AI prend en charge deux modèles tarifaires, chacun conçu pour différents modèles de charge de travail :
Dédié : tarification fixe mesurée en unités de recherche (SUs). Vous sélectionnez un niveau de service et vous êtes facturé toutes les heures en fonction des unités approvisionnées.
Serverless (préversion) : tarification basée sur la consommation mesurée par unités de calcul par heure (CU/hr) et par Go/mois pour le stockage indexé.
Important
Le niveau Développeur serverlessr est actuellement en préversion. Cette version préliminaire est fournie sans contrat de niveau de service et n’est pas recommandée pour les environnements de production. Certaines fonctionnalités peuvent ne pas être prises en charge ou avoir des fonctionnalités contraintes. Pour plus d’informations, consultez Conditions d'utilisation supplémentaires pour les versions préliminaires de Microsoft Azure.
La facturation de l’offre Développeur sans serveur a débuté le 13 septembre 2026. Les frais d’utilisation sur ou après cette date apparaissent sur votre facture Azure. Vous n’êtes pas facturé pour l’utilisation avant le 13 septembre 2026.
Le niveau Développeur serverless ne prend pas en charge la migration vers ou depuis d’autres niveaux tarifaires et certaines fonctionnalités disponibles sur d’autres niveaux ne sont pas prises en charge pendant la préversion publique. Les limites de service, les fonctionnalités prises en charge et les détails des tarifs peuvent changer avant la disponibilité générale.
Pendant la préversion, le modèle de tarification Serverless est pris en charge uniquement dans des régions spécifiques.
Pour plus d’informations sur les différences entre le modèle de tarification et le niveau de service, consultez Choisir un modèle de tarification et un niveau de service.
Comment le coût est déterminé dans le modèle serverless
Les modèles tarifaires Dedicated et Serverless prennent en compte différemment le travail effectué au sein du service de recherche. Les services dédiés exécutent des requêtes, l’indexation et le traitement des résultats sur la capacité provisionnée que vous avez déjà achetée. Les services serverless mesurent les E/S de calcul, de mémoire et de disque que ces opérations consomment et convertissent cette utilisation en unités de calcul (UNITÉS de calcul). Par conséquent, l’optimisation des performances affecte directement les coûts serverless.
Les coûts du serverless sont liés à l’exécution de la charge de travail :
- Les requêtes et l’indexation consomment le calcul, mesurés en unités de calcul par heure (CU/h).
- Les index actifs consomment le calcul en fonction de leur utilisation des ressources et de la durée pendant laquelle ils restent actifs.
- Un index reste actif pendant 10 minutes après sa dernière requête ou requête d’indexation avant d’être inactif.
- Les index inactifs n’ont pas de frais de calcul minimum ou réservés. Les ressources de calcul des index inactifs sont ramenées à zéro. Il n’existe aucun frais de calcul minimal lorsqu’un index est inactif.
- Le stockage est facturé séparément, en fonction de la taille de l’index sur le disque, et cette facturation s’applique qu’un index soit utilisé ou non.
- La récupération pilotée par agent consomme des ressources de calcul pour les requêtes de recherche ainsi que pour l’orchestration effectuée au sein du service de recherche.
Les frais de stockage s’arrêtent uniquement lorsque vous supprimez l’index.
Pour afficher la répartition des coûts et les taux d’utilisation de votre cycle de facturation actuel, consultez l’onglet Échelle + Coût dans votre portail Azure.
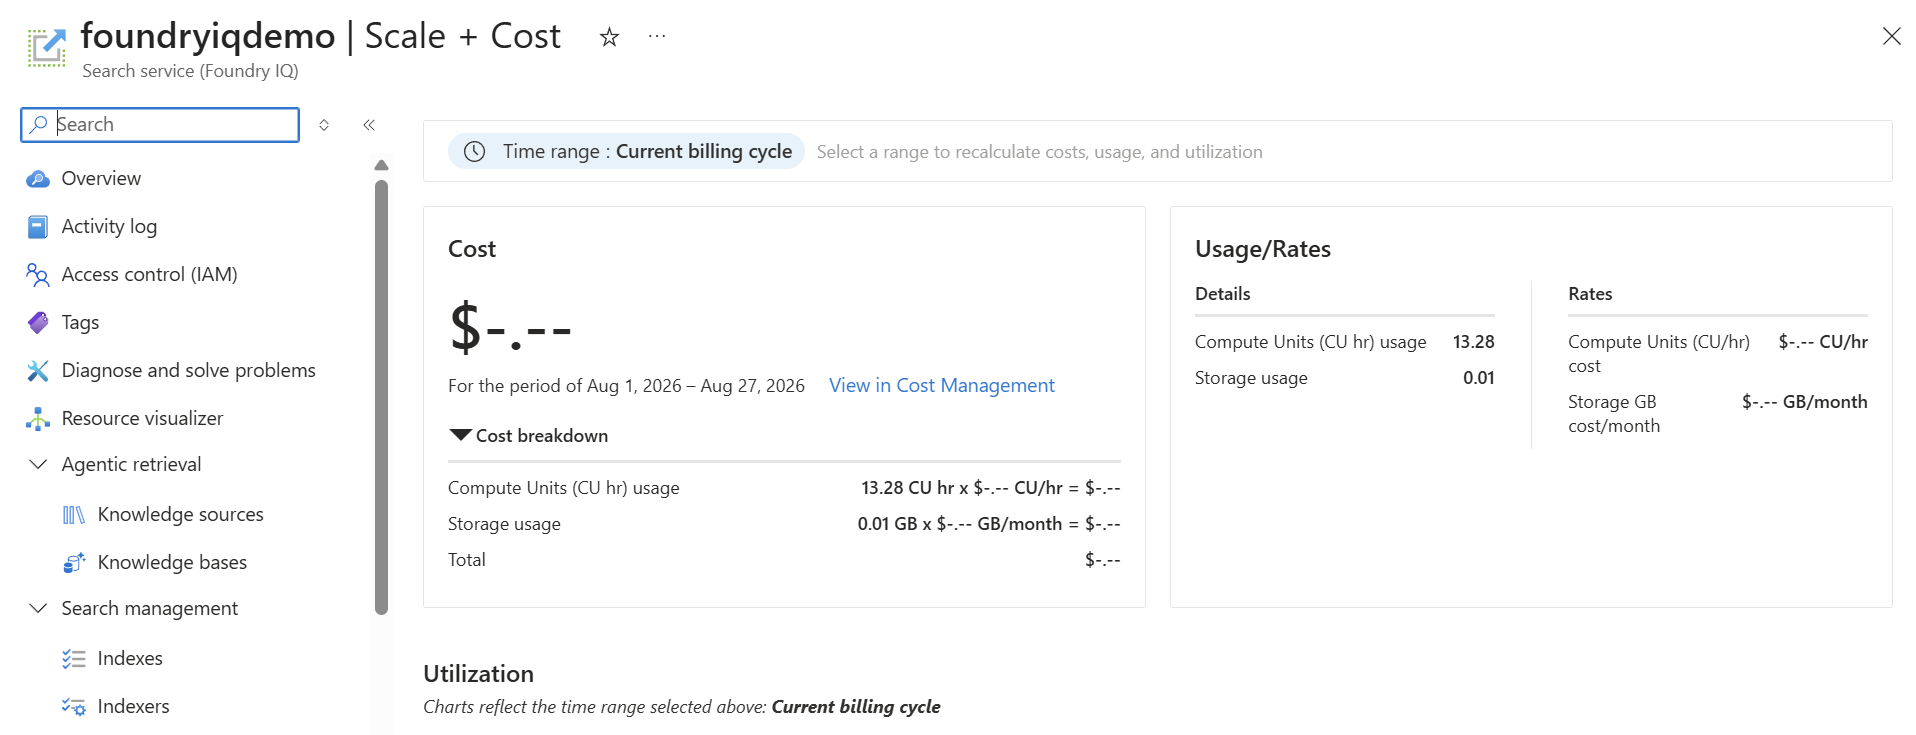
Impact de la taille de l’index sur l’utilisation du calcul
Bien qu’un index soit actif, Recherche Azure AI évalue deux ressources finies pour déterminer son utilisation de calcul :
- Taille totale de l’index : espace total occupé par l’index sur le disque, y compris le texte, les métadonnées et les vecteurs.
- Taille de l’index vectoriel : mémoire utilisée par l’index vectoriel. La mémoire est plus gourmande en ressources que le disque, de sorte que la taille de l’index vectoriel a une pondération plus élevée lorsqu’elle est convertie en unités de cluster.
Recherche Azure AI n'ajoute pas les deux valeurs de CU obtenues. L’utilisation des ressources de calcul est basée sur le montant le plus élevé. Par exemple, la taille de l’index vectoriel peut déterminer l’utilisation du calcul même si la taille totale de l’index sur le disque est relativement petite.
Pour réduire l’utilisation du calcul de l’index actif, identifiez la ressource qui génère la quantité de CU la plus élevée. Réduisez ensuite la taille totale de l’index, la taille de l’index vectoriel ou les deux. Le stockage indexé reste un frais distinct par Go/mois.
Le modèle de tarification serverless est le plus économique pour les charges de travail avec un trafic variable, intermittent ou imprévisible, où la capacité provisionnée serait sous-utilisée.
Important
Les frais des CU serverless couvrent les opérations effectuées au sein du service de recherche, notamment les requêtes, l’indexation, le traitement des résultats et l’orchestration de la récupération agentique. Les appels de modèle et d’autres travaux effectués en dehors du service de recherche continuent d’utiliser leurs compteurs de facturation existants. Les exemples incluent le classement sémantique, la réécriture des requêtes agentiques, l’extraction d’images et l’exécution des compétences.
Comprendre les unités de calcul (UC)
Une unité de calcul (CU) représente les ressources système mesurées requises pour effectuer des opérations de recherche et d’indexation dans le modèle serverless. Le coût des CU est déterminé principalement par l’utilisation du processeur, de la mémoire et des E/S, et, secondairement, par la taille de l’index et la taille de la charge utile des documents, l’utilisation étant facturée en unités de calcul par heure (CU/h).
Calcul des échelles de coût avec :
- Complexité des requêtes
- Taille de l’index (Go) et structure
- Taille de charge utile du document (Ko)
- Nombre de champs et résultats récupérés
Différentes opérations ont des profils de coût différents :
- Recherche : faible coût. La récupération d’un document unique par son ID est l’opération la plus efficace.
- Recherche de mots clés : faible coût. La recherche de texte utilise des index inversés, qui sont optimisés pour une vitesse et une faible utilisation du calcul.
- Recherche vectorielle : coût élevé. Les requêtes vectorielles sont coûteuses en calcul, car elles nécessitent des calculs de similarité entre les incorporations à haute dimension. Par rapport à la recherche par mot clé, ils consomment beaucoup plus de calcul.
- Recherche hybride : combine le coût de la recherche par mot-clé et de la recherche vectorielle, puisque les deux pipelines s’exécutent pour chaque requête, avec en plus une légère surcharge liée à la fusion des résultats par Reciprocal Rank Fusion (RRF).
Surveiller l’utilisation du calcul
La surveillance de la consommation de calcul vous permet d’identifier les opérations coûteuses, d’optimiser les modèles de requête et d’estimer les coûts. Le coût de l’unité de calcul (CU) de chaque requête est retourné dans l’en-tête x-ms-azs-compute-units-consumed de réponse HTTP sous forme de nombre à virgule flottante. Utilisez cet en-tête pour identifier les opérations coûteuses et optimiser les modèles de requête. Vous pouvez suivre le coût cu de chaque requête en inspectant les en-têtes de réponse HTTP et les événements d’opération dans Azure Monitor. Pour obtenir des conseils supplémentaires sur les types de données de surveillance disponibles et les méthodes d’analyse de ces données, consultez Surveiller Recherche Azure AI.
-
En-tête :
x-ms-azs-compute-units-consumed: <value> - Valeur : un nombre à virgule flottante représentant les CUs consommés.
Exemple :
Status: 200 OK
Content-Type: application/json
x-ms-azs-compute-units-consumed: 12.45
Dans cet exemple, la requête a consommé 12,45 unités de calcul. Vous pouvez utiliser cette valeur pour identifier les opérations à coût élevé et comparer le coût relatif des différents modèles de requête.
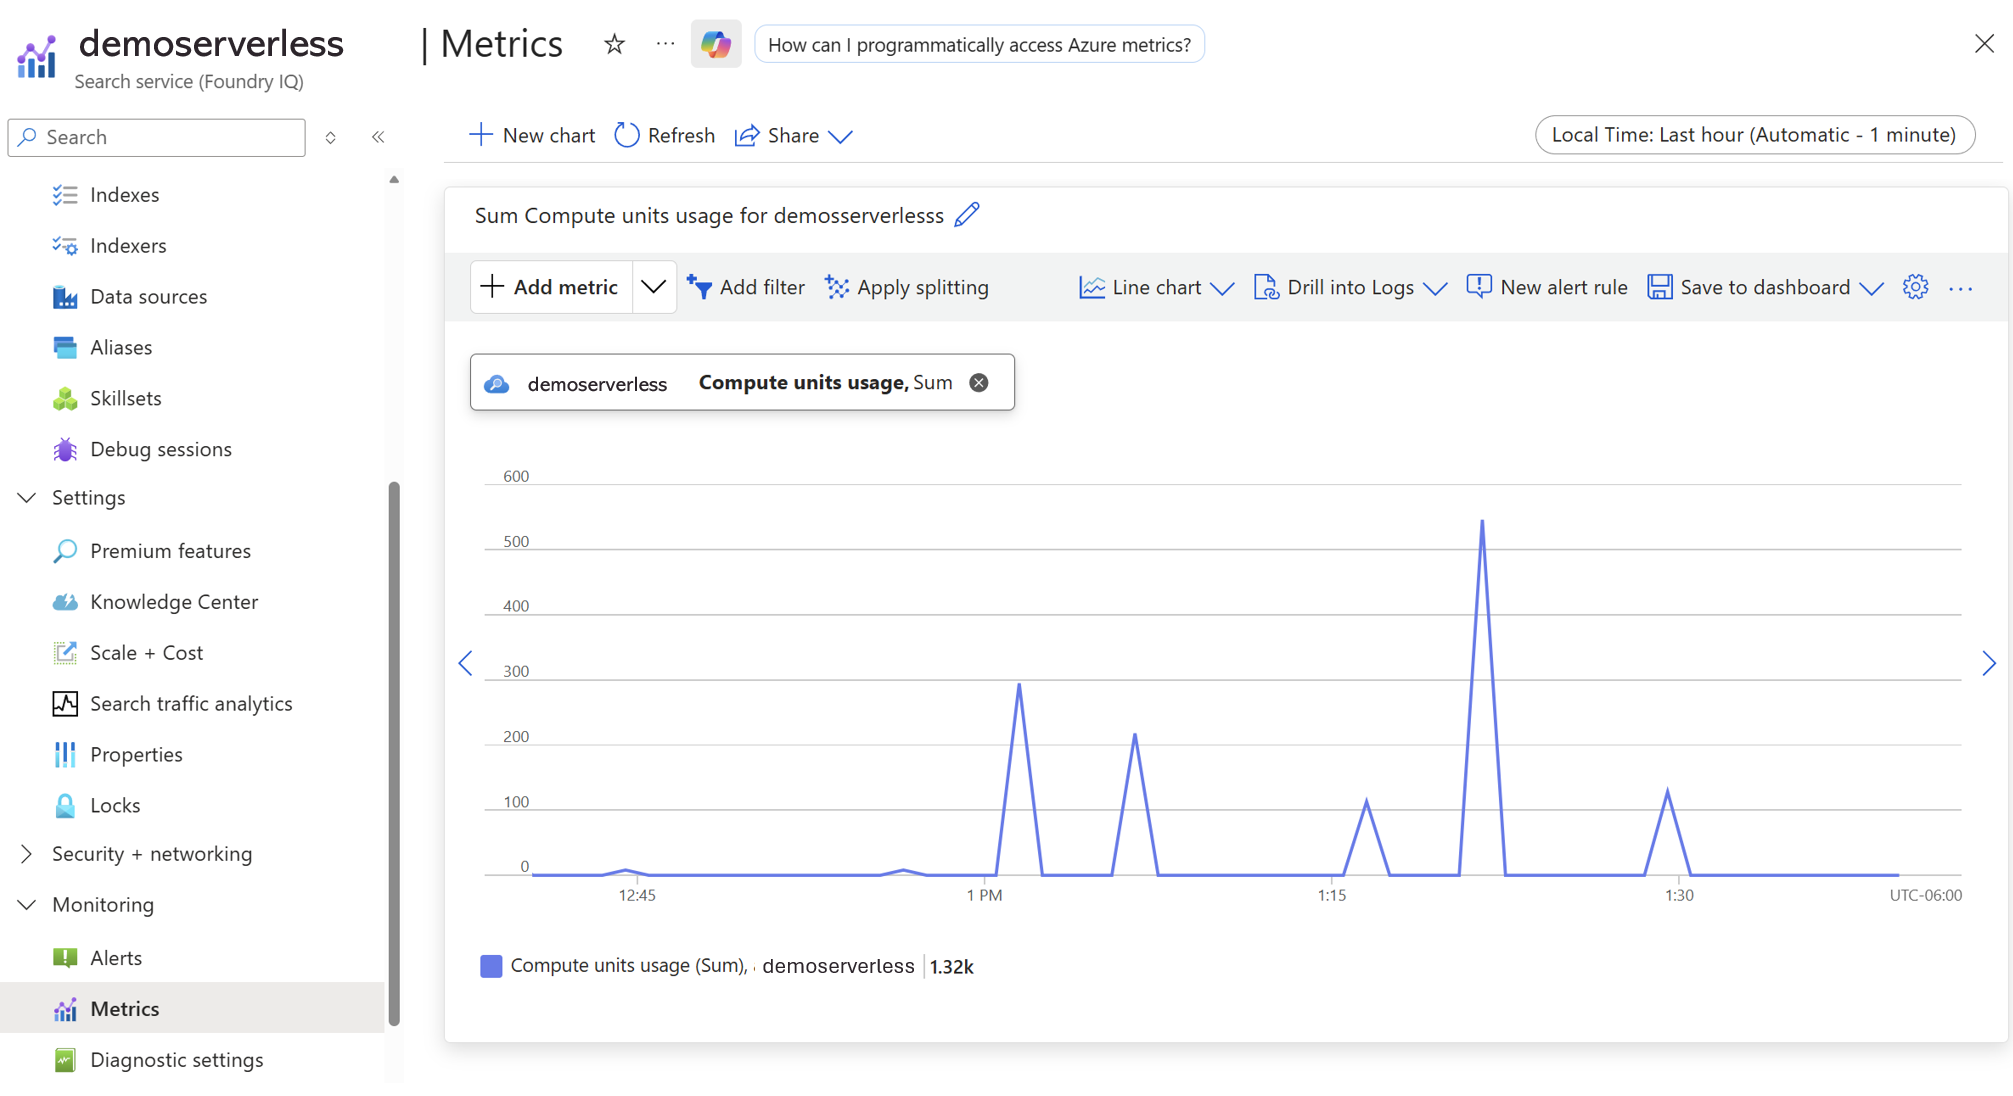
Pour passer en revue la consommation de calcul historique pour un service de recherche serverless, utilisez les métriques Azure Monitor dans le portail Azure :
- Accéder à votre service de recherche.
- Sélectionnez Métriques.
- Sélectionnez + Ajouter une métrique.
- Dans la liste des métriques, sélectionnez Utilisation des unités de calcul.
- Utilisez le graphique pour analyser les tendances d’utilisation et identifier les périodes d’augmentation de la consommation de calcul.
La surveillance de l’utilisation agrégée vous permet de comprendre les coûts globaux du service et d’identifier les charges de travail qui consomment le plus de ressources de calcul. Pour obtenir des descriptions des métriques de surveillance disponibles, consultez Informations de référence sur les données de surveillance. Vous pouvez utiliser les logs Azure Monitor pour suivre l’utilisation agrégée des CU au fil du temps et la mettre en corrélation avec l’évolution du volume de requêtes et de la charge de travail.
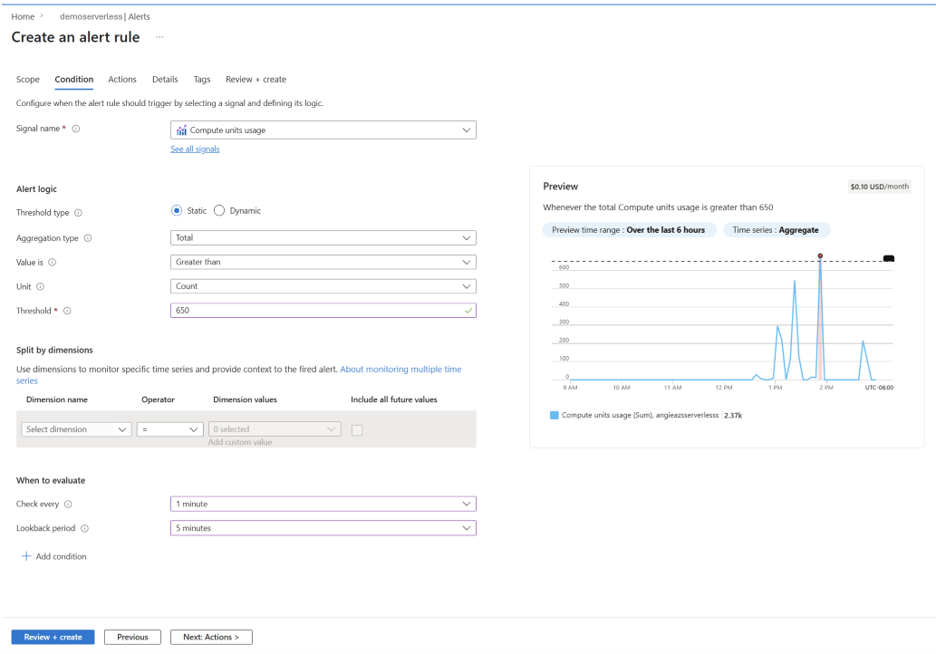
Configurer des alertes pour l’utilisation du calcul
Vous pouvez créer une règle d’alerte à avertir lorsque la consommation de calcul atteint un seuil spécifié dans le portail Azure.
- Accédez aux alertes dans votre service de recherche.
- Sélectionnez + Créer une règle d’alerte.
- Sous Condition, choisissez l’utilisation des unités de calcul comme signal.
- Définissez la logique d’alerte. Par exemple, déclenchez lorsque l’utilisation totale est supérieure à une valeur spécifiée.
- Configurez des actions, telles que les notifications par e-mail, SMS ou webhook.
- Effectuez les étapes restantes, puis sélectionnez Vérifier + créer.
Les alertes vous aident à répondre de manière proactive aux pics d’utilisation inattendus et à gérer les coûts.
Estimer les coûts serverless
Le calculateur de prix Azure et les recommandations de planification de capacité basées sur les unités de recherche (SU) ne s’appliquent pas aux services utilisant le modèle de tarification sans serveur.
Pour estimer les coûts d’une architecture sans serveur :
- Indexer des exemples de données représentatifs.
- Exécutez des charges de travail d’indexation et de requête classiques.
- Enregistrez la
x-ms-azs-compute-units-consumedvaleur retournée pour chaque opération. - Utilisez Azure Monitor métriques pour mesurer l’utilisation agrégée au fil du temps.
- Extrapoler les coûts en fonction du trafic de production attendu.
Utilisez l’onglet Échelle + Coût dans le portail Azure pour afficher votre utilisation actuelle et estimer les coûts.
Étant donné que la même requête exécutée sur les mêmes données produit généralement une consommation de calcul similaire, les charges de travail représentatives peuvent fournir une base fiable pour l’estimation des coûts.
L’utilisation serverless est mesurée en continu et agrégée pour la facturation. La consommation de calcul est suivie toutes les minutes et émise uniquement lorsque les ressources de calcul sont utilisées.
Lors de l’estimation des coûts, utilisez les valeurs de coût des requêtes pour comprendre le coût des opérations individuelles et les métriques Azure Monitor pour comprendre les tendances globales de consommation du service.
Utilisez les deux sources de données ensemble pour comprendre les coûts : les données de frais par demande vous aident à évaluer les opérations individuelles, tandis que les métriques Azure Monitor vous aident à comprendre la consommation de service agrégée au fil du temps. Pour obtenir une image complète des coûts, vous devez également tenir compte des fonctionnalités facturées séparément des unités de calcul.
La facturation est basée sur l’utilisation agrégée du calcul plutôt que sur des demandes individuelles. L’utilisation est mesurée dans des intervalles d’une minute et arrondie à 0,25 CU près par minute. Ces intervalles d’utilisation d’une minute s’accumulent au cours d’une heure pour déterminer le montant de cu/heure facturable. En interne, l’utilisation est agrégée des milli-unités de calcul (mCU) en unités de calcul (CU), puis convertie en utilisation horaire indiquée pour la facturation.
Différentes opérations consomment différentes quantités de calcul. En général :
- Les recherches de mots clés utilisent généralement les ressources de calcul minimales.
- Les recherches vectorielles utilisent généralement plus de ressources de calcul que les recherches par mot clé.
- Les recherches hybrides combinent l’exécution du mot clé et de la recherche vectorielle, de sorte qu’elles utilisent généralement plus de ressources de calcul que l’une ou l’autre technique.
La consommation réelle de calcul dépend de facteurs tels que la complexité des requêtes, la taille de l’index, le volume de données, la configuration vectorielle et le nombre de résultats retournés. La surveillance des frais de demande et des métriques d’utilisation agrégées peut vous aider à identifier les opportunités d’optimisation et à mieux prédire les coûts de production.
Réduire les coûts de calcul par le biais de l’optimisation
Les requêtes et la conception d’index efficaces réduisent la consommation de calcul et réduisent les coûts.
Optimiser votre schéma
Votre schéma d’index détermine les coûts de calcul et de stockage de référence :
- Limiter les attributs de champ : activez uniquement les attributs (pouvant faire l’objet d’une recherche, filtrables, facetables, triables) si nécessaire. Chaque attribut augmente la taille de l’index et le coût d’indexation.
- Aplatissez les types complexes : mappez les structures JSON imbriquées sur des champs ou des collections simples lorsque c’est possible.
-
Définissez récupérable=false pour les champs de filtrage uniquement ou de tri uniquement : si un champ est utilisé pour le filtrage ou le tri, mais n’a pas besoin d’être retourné dans les résultats, conservez-le indexé et définissez-le
retrievable=falsepour réduire le stockage sur disque et le coût de stockage par go/mois. - Utilisez les champs récupérables uniquement si possible : par exemple, les champs utilisés uniquement pour l’affichage (tels que les URL d’image) ne doivent pas être recherchés.
- Réduire les dimensions vectorielles : les vecteurs à dimension supérieure augmentent le stockage et le coût des requêtes. Utilisez des modèles d’incorporation plus petits ou la quantisation le cas échéant.
- Réduire la taille de la charge utile du document avant l’indexation : les documents plus volumineux coûtent plus cher à indexer. Supprimez les champs inutiles, supprimez le texte long et supprimez le code HTML avant d’envoyer des documents à l’index.
Optimiser les demandes d’indexation
La façon dont vous envoyez des données à l’index affecte à la fois le coût et le débit :
Utilisez des lots plus volumineux lorsque cela est possible : l’indexation par lot réduit la surcharge par demande en amortissant les coûts réseau et de traitement sur plus de documents. En général, des lots de jusqu’à ~1 000 documents ou ~16 Mo sont plus efficaces en termes de CU que de nombreuses petites requêtes. Toutefois, la taille de lot optimale dépend de votre charge de travail. Testez pour équilibrer le débit, la latence et la fiabilité.
Indexer uniquement les données nouvelles ou modifiées : évitez la réindexation complète lorsque cela est possible. L’envoi uniquement d’ajouts et de mises à jour réduit le nombre de documents traités, ce qui réduit le coût de calcul et améliore la vitesse d’ingestion.
Ignorez l’extraction d’images, sauf si vous en avez besoin : l’extraction d’images ajoute un travail de traitement supplémentaire et peut devenir un pilote de coût distinct. Activez-le uniquement pour les documents ou les flux de travail qui ont réellement besoin de contenu d’image.
Compte de la croissance de la taille de l’index : dans la cas où cela est possible, créez des index plus petits. À mesure qu’un index augmente, les coûts d’indexation augmentent, car davantage de données doivent être stockées et conservées, et les opérations nécessitent davantage de calcul. Pour les jeux de données très volumineux, envisagez de partitionner des données sur plusieurs index afin de gérer les performances et les coûts. Bien que les coûts augmentent avec la taille de l’index, l’augmentation est sous-linéaire. Les index plus volumineux coûtent plus cher par opération, mais pas proportionnellement plus.
Pour plus d’informations, consultez Tips pour obtenir de meilleures performances dans Recherche Azure AI.
Optimiser les opérations d’indexeur
La consommation de calcul de l’indexeur sans serveur dépend des opérations effectuées à chaque exécution de l’indexeur. Pour les sources orientées lignes, utilisez le nombre de documents traités comme indicateur du volume de charge de travail. Pour les sources basées sur des fichiers telles que Stockage Blob Azure et Azure Data Lake Storage Gen2, surveillez la quantité de données sources traitées. L’utilisation réelle du calcul dépend également des charges utiles de document, de la structure d’index, de l’enrichissement et d’autres traitements effectués pendant l’exécution.
Pour réduire l’utilisation du calcul de l’indexeur :
Utilisez la détection des modifications et l’indexation incrémentielle : traitez uniquement les données nouvelles ou modifiées au lieu d’indexer à plusieurs reprises la source de données complète.
Planifications de l’indexeur de taille appropriée : choisissez une planification qui répond aux exigences de fraîcheur des données. Utilisez la télémétrie de l’unité de calcul pour évaluer l’effet de la fréquence de planification.
Réduire le contenu inutile du document : supprimez le contenu qui n’a pas besoin d’être indexé et excluez les fichiers ou les types de fichiers qui ne sont pas obligatoires.
Limitez soigneusement le périmètre des compétences d’enrichissement : exécutez les compétences uniquement sur les champs et les documents qui nécessitent un enrichissement, et évitez de générer des résultats qui ne sont pas utilisés en aval. Les compétences facturables peuvent entraîner des frais de transaction distincts.
Surveillance des exécutions en échec et répétées: Un indexeur peut consommer des ressources de calcul pour le travail effectué avant son échec. Passez en revue l’historique d’exécution et l’utilisation de l’unité de calcul pour identifier les échecs récurrents et les modèles de nouvelle tentative.
Optimiser vos requêtes
La conception des requêtes est un facteur principal du coût variable :
Utilisez
$selectpour limiter les champs renvoyés : cela réduit la taille de la charge utile et les ressources de calcul nécessaires à la sérialisation.GET /docs?search=test&$select=id,title,urlPermet
searchFieldsde limiter l’emplacement où le texte est recherché : limitez la correspondance entre le temps de requête et les champs qui importent pour le scénario. Chaque champ interrogeable supplémentaire augmente la charge de requête et peut augmenter le nombre de CU/h.Préférez une correspondance exacte ou des requêtes de mot clé simples : les requêtes approximatives, génériques, regex et de style préfixe peuvent forcer les analyses d’index étendues et consommer beaucoup plus de CU/h. Utilisez-les uniquement lorsque vous avez besoin d’un comportement de correspondance partielle et choisissez une correspondance exacte ou des requêtes de mots clés plus simples dans la mesure du possible.
Utilisez des recherches plutôt que des recherches si possible : la récupération d’un document par ID est plus efficace que l’exécution d’une requête de recherche. Si vous connaissez l’ID de document, utilisez une recherche au lieu d’une requête de recherche. Les recherches sont plus efficaces, car elles récupèrent un document directement par clé, tandis que les requêtes de recherche appellent le pipeline de requête complet (analyse, traversée d’index, scoring et classement), ce qui augmente le coût de calcul.
Évitez la pagination approfondie (
$skip) : les valeurs volumineuses$skipaugmentent le calcul, car le moteur doit traiter, noter et classer les résultats qui précèdent la page demandée. Par exemple,$skip=5000nécessite que le moteur traite au moins 5 000 résultats qui ne sont pas retournés. Ce choix consomme des unités de calcul supplémentaires et peut augmenter les coûts. Utilisez plutôt des filtres pour affiner le résultatsetet$toplimiter le nombre de résultats retournés.$topTaille appropriée pour votre application ou votre interface utilisateur. Bien que$topne change pas le nombre de documents correspondants marqués, une valeur plus petite réduit le nombre de résultats qui doivent être collectés, triés et sérialisés. Demandez seulement autant de résultats que votre application en a besoin et évitez les modèles de pagination qui nécessitent que le moteur traite un grand nombre de résultats inutilisés.Réduire le nombre de facettes et l’étendue des facettes : demandez uniquement les facettes affichées dans votre interface utilisateur et conservez chaque valeur de facette
countaussi faible que pratique. Les facettes nécessitent des agrégations par requête et des nombres élevés augmentent le coût de calcul.Utiliser
search.inpour le filtrage : lors du filtrage par une liste d’ID ou de valeurs, utilisez lasearch.infonction au lieu de plusieursorconditions (par exemple).id eq '1' or id eq '2'Cette approche est plus efficace et réduit la surcharge de calcul. Vous devez également éviter de marquer les champs à cardinalité élevée (ceux qui comportent un grand nombre de valeurs uniques, comme des ID uniques ou des descriptions en texte libre) comme filtrables ou à facettes, sauf si nécessaire, car cela augmente la taille de l’index et le coût des requêtes.
Optimiser vos demandes d’administration
Outre les opérations d’interrogation et d’indexation, Recherche Azure AI inclut des opérations d’administration au niveau de l’objet et au niveau du service (telles que la récupération de schémas d’index ou de statistiques de service). Ces demandes ont un coût fixe par requête. Bien que chaque requête soit peu coûteuse, les appels répétés ou inutiles peuvent s’accumuler au fil du temps et augmenter l’utilisation globale du calcul.
- Évitez les demandes administratives excessives : métadonnées du cache, telles que les schémas d’index, côté client, au lieu de les récupérer à plusieurs reprises. Par exemple, l’extraction du schéma d’index avant chaque opération d’écriture entraîne des coûts inutiles. Dans le modèle serverless, ce modèle augmente directement les frais de calcul, tandis que dans les services dédiés, l’impact est souvent masqué par la facturation horaire fixe.
Optimiser les coûts de vecteur
Les charges de travail vectorielles sont généralement le composant le plus coûteux dans la recherche du modèle de tarification Serverless, car elles ont un impact sur les unités de calcul (requêtes et indexation) et le stockage (taille de vecteur sur le disque). Pour réduire les coûts, optimisez la façon dont les vecteurs sont stockés et la façon dont ils sont interrogés.
Optimiser le stockage et le schéma vectoriels
Les champs vectoriels peuvent augmenter considérablement la taille de l’index et le coût d’indexation. Utilisez les techniques suivantes pour réduire la surcharge de stockage :
Utilisez la compression pour réduire la taille du vecteur : appliquez la quantisation pour réduire l’empreinte de stockage avec un impact minimal sur la pertinence. Par exemple, la quantisation scalaire peut réduire le stockage vectoriel de jusqu’à 4× avec un impact minimal sur la qualité de la recherche.
Désactivez le stockage pour les vecteurs lorsqu’il n’est pas nécessaire : définissez stored=false sur les champs vectoriels si vous avez uniquement besoin de vecteurs pour la recherche, et non pour la récupération. Cela évite de stocker les vecteurs d’origine dans l’index, ce qui réduit le coût de stockage sans affecter le comportement des requêtes.
Utilisez des dimensions d’incorporation plus petites si possible : les vecteurs à dimension supérieure augmentent à la fois le stockage et le coût des requêtes. Pour les charges de travail non critiques, utilisez des modèles d’incorporation plus petits (par exemple, 384 ou 768 dimensions au lieu de 1536) pour réduire les coûts.
Optimiser l’exécution des requêtes vectorielles
Les requêtes vectorielles sont gourmandes en calcul, car elles nécessitent des calculs de similarité sur des structures de données à grande dimension.
Utilisez la recherche hybride de manière sélective : les requêtes hybrides exécutent à la fois le mot clé et la récupération de vecteurs. Utilisez uniquement si nécessaire pour la pertinence.
Réduire maxTextRecallSize pour les requêtes hybrides : Le paramètre
hybridSearch.maxTextRecallSizedétermine combien de résultats classés par BM25 sont transmis à la fusion de classement réciproque. La valeur par défaut est 1 000 (plage comprise entre 1 et 10 000). La consommation de calcul évolue de façon approximativement linéaire en fonction de cette valeur ; la réduire constitue donc l’un des leviers les plus directs pour réduire les coûts des charges de travail hybrides.Des valeurs autour de 500 réduisent souvent sensiblement les besoins de calcul, tout en entraînant peu de perte de pertinence.
La valeur inférieure peut supprimer des correspondances de mots clés qui manquent à la recherche vectorielle, telles que des termes exacts, des ID et des acronymes.
Contrôler les candidats vecteurs séparément avec k sur chaque requête vectorielle.
Testez les requêtes représentatives et comparez la pertinence, la latence et l’en-tête
x-ms-azs-compute-units-consumedavant de régler une valeur.Appliquez des filtres avant les requêtes vectorielles : limitez l’ensemble de candidats avant la recherche vectorielle pour réduire la quantité de données traitées. Découvrez comment fonctionne le filtrage dans les requêtes vectorielles.
Réduire les coûts en réduisant l’utilisation
Le modèle serverless facture uniquement les ressources consommées. En l’absence de demandes, l’utilisation du calcul diminue en conséquence.
Pour réduire les coûts d’utilisation :
- Exécutez des requêtes uniquement si nécessaire.
- Évitez les requêtes redondantes ou trop fréquentes.
- Surveillez l’utilisation et ajustez les charges de travail en fonction de la demande.
Conseil / Astuce
La même requête peut avoir des profils de latence et cu différents selon que le service est chaud ou froid. Après une période sans trafic en lecture ou en écriture, l’utilisation du calcul dans le modèle de tarification Serverless passe à zéro. La requête suivante peut avoir une latence plus élevée et consommer davantage d’unités de commande pendant que les chemins de données se réchauffent. Les indices de plus grande taille mettent généralement plus de temps à s’initialiser que les indices plus petits ; les effets d’un démarrage à froid sont donc souvent plus perceptibles sur les services de plus grande taille.
Optimiser les coûts de stockage
Le stockage est facturé par Go/mois en fonction de la taille d’index sur disque, qui peut dépasser la taille des données brutes. Pour réduire les coûts de stockage :
- Supprimez les index inutilisés.
- Réduisez les champs stockés.
- Concevoir des schémas avec une surcharge de stockage à l’esprit.
- Utilisez des suggesteurs de manière sélective, car ils peuvent augmenter considérablement la taille du stockage.
Pour connaître les techniques spécifiques aux vecteurs (compression, taille et paramètres de stockage), consultez Optimiser pour le stockage et le traitement vectoriels.
Pour plus d’informations sur les compromis entre le stockage et les performances des requêtes, consultez Tips pour obtenir de meilleures performances dans Recherche Azure AI.