Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Note
Recherche Azure AI est disponible via le portail Azure, les API REST et les SDK Azure. Il sous-tend également Foundry IQ, la couche de connaissances managée qui transforme le contenu d’entreprise en bases de connaissances réutilisables et prenant en charge les autorisations pour les agents dans le portail Microsoft Foundry.
Important
Les fonctionnalités, capacités ou propriétés marquées (préversion) ne sont pas couvertes par un accord de niveau de service, ne sont pas recommandées pour les workloads de production et peuvent être modifiées ou faire l’objet de restrictions avant leur mise à disposition générale. Les Recherche Azure AI termes de la préversion s'appliquent à toutes les fonctionnalités d'aperçu, qu'il s'agisse d'une fonctionnalité autonome ou d'une partie d'une fonctionnalité généralement disponible.
Dans Recherche Azure AI, vous pouvez utiliser une expression filter pour ajouter des critères d’inclusion ou d’exclusion à une requête vectorrice. Vous pouvez également spécifier un mode de filtrage qui applique le filtre :
- Avant l’exécution de la requête, appelée préfiltrage.
- Après l'exécution de la requête, on parle de postfiltrage.
- Une fois les résultats du top-
kglobal identifiés, ce processus est appelé postfiltrage strict (préversion).
Cet article utilise REST pour l’illustration. Pour obtenir des exemples de code dans d’autres langages et solutions de bout en bout qui incluent des requêtes vectorielles, consultez le référentiel azure-search-vector-samples GitHub.
Vous pouvez également utiliser Search Explorer dans le portail Azure pour interroger le contenu vectoriel. Dans la vue JSON, vous pouvez ajouter des filtres et spécifier le mode filtre.
Fonctionnement du filtrage dans les requêtes vectorielles
Recherche Azure AI utilise l’algorithme HNSW (Hierarchical Navigable Small World) pour la recherche approximative du voisin le plus proche (ANN), en stockant des graphiques HNSW sur plusieurs partitions. Chaque fragment contient une partie de l’index entier.
Les filtres s’appliquent aux filterable champs non-vecteurs, chaîne ou numérique, pour inclure ou exclure des documents de recherche en fonction des critères de filtre. Les champs vectoriels eux-mêmes ne sont pas filtrables, mais vous pouvez utiliser des filtres sur d’autres champs dans le même index pour affiner les documents pris en compte pour la recherche vectorielle. Si votre index ne dispose pas de champs texte ou numériques appropriés, recherchez les métadonnées de document qui peuvent vous aider à filtrer, telles que les propriétés LastModified ou CreatedBy.
Les vectorFilterMode contrôles de paramètre sur lesquels les opérations de filtre sont appliquées pendant les phases de recherche, ce qui affecte la façon dont les résultats sont filtrés sur un sous-ensemble d’éléments (par catégorie, balise ou autres attributs) et affecte la latence, le rappel et le débit. Il existe trois modes :
preFilterapplique le filtre pendant la traversée HNSW sur chaque fragment. Ce mode optimise le rappel, mais peut parcourir davantage le graphique, augmentant le processeur et la latence pour les filtres hautement sélectifs.postFilterexécute une traversée HNSW et un filtrage sur chaque partition de manière indépendante, intersecte les résultats au niveau de la partition, puis agrège les top-kde chaque partition pour former un top-kglobal. Ce mode peut créer des faux négatifs pour des filtres hautement sélectifs ou de petiteskvaleurs.strictPostFilter(aperçu) trouve leksommet global non filtré avant d’appliquer le filtre. Ce mode présente le risque le plus élevé de retourner des faux négatifs pour les filtres hautement sélectifs et les petiteskvaleurs.
Pour plus d’informations sur ces modes, consultez Définir le mode de filtre.
Définir un filtre
Les filtres déterminent l’étendue des requêtes vectorielles et sont définis à l’aide de Documents - Publication de recherche (API REST). Sauf si vous souhaitez utiliser une fonctionnalité en préversion, utilisez la dernière version stable des API REST du service de recherche pour formuler la requête.
Cette API REST fournit les éléments suivants :
-
filterpour les critères. -
vectorFilterModepour spécifier quand le filtre est appliqué pendant la requête vectorielle. Pour les modes pris en charge, consultez Définir le mode de filtre.
POST https://{search-endpoint}/indexes/{index-name}/docs/search?api-version={api-version}
Content-Type: application/json
api-key: {admin-api-key}

{
    "count": true,
    "select": "title, content, category",
    "filter": "category eq 'Databases'",
    "vectorFilterMode": "preFilter",
    "vectorQueries": [
        {
            "kind": "vector",
            "vector": [
                -0.009154141,
                0.018708462,
                . . . // Trimmed for readability
                -0.02178128,
                -0.00086512347
            ],
            "fields": "contentVector",
            "k": 50
        }
    ]
}
Dans cet exemple, l’incorporation de vecteurs cible le contentVector champ et les critères de filtre s’appliquent à category, un champ de texte filtrable. Étant donné que le preFilter mode est utilisé, le filtre est appliqué avant que le moteur de recherche exécute la requête, de sorte que seuls les documents de la Databases catégorie sont considérés pendant la recherche vectorielle.
Définir le mode de filtre
Le vectorFilterMode paramètre détermine quand et comment le filtre est appliqué par rapport à l’exécution de requête vectorielle. Vous pouvez utiliser les modes suivants :
-
preFilter(recommandé) postFilter-
strictPostFilter(préversion)
Note
preFilter est la valeur par défaut pour les index créés après environ le 15 octobre 2023. Pour les index créés avant cette date, postFilter est la valeur par défaut. Pour utiliser preFilter et d’autres fonctionnalités vectorielles avancées, telles que la compression vectorielle, vous devez recréer votre index.
Vous pouvez tester la compatibilité en envoyant une requête vectorielle avec "vectorFilterMode": "preFilter" la version de l’API 2023-10-01-preview REST ou une version ultérieure. Si la requête échoue, votre index ne prend pas en charge preFilter.
Le préfiltrage applique des filtres avant l’exécution de la requête, ce qui réduit l’ensemble de candidats pour l’algorithme de recherche vectorielle. Les résultats supérieursk sont ensuite sélectionnés à partir de cet ensemble filtré.
Dans une requête vectorielle, preFilter est le mode par défaut, car il favorise le rappel et la qualité par rapport à la latence.
Fonctionnement de ce mode
Sur chaque fragment, appliquez le prédicat de filtre pendant la traversée HNSW, en développant le graphe jusqu’à ce que
kcandidats soient trouvés.Produisez les résultats locaux top-
kpréfiltrés par fragment.Agréger les résultats filtrés dans un ensemble global des meilleurs résultats
k.
Effet de ce mode
Traversal étend la surface de recherche pour rechercher des candidats plus filtrés, en particulier si le filtre est sélectif. Cette action produit les principaux résultats k les plus similaires et importants sur toutes les partitions. Chaque fragment identifie les k résultats qui répondent au prédicat de filtre.
Le préfiltrage garantit que les résultats k sont renvoyés s’ils existent dans l’index. Pour les filtres hautement sélectifs, cela peut entraîner la traversée d’une partie significative du graphique, ce qui augmente le coût et la latence du calcul tout en réduisant le débit. Si votre filtre est très sélectif (a très peu de correspondances), envisagez d’effectuer exhaustive: true une recherche exhaustive.
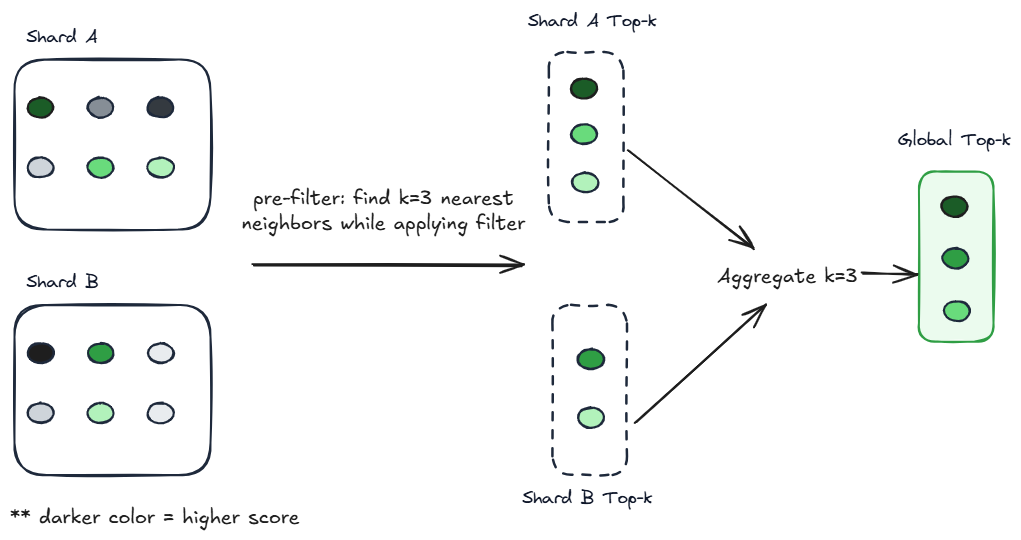
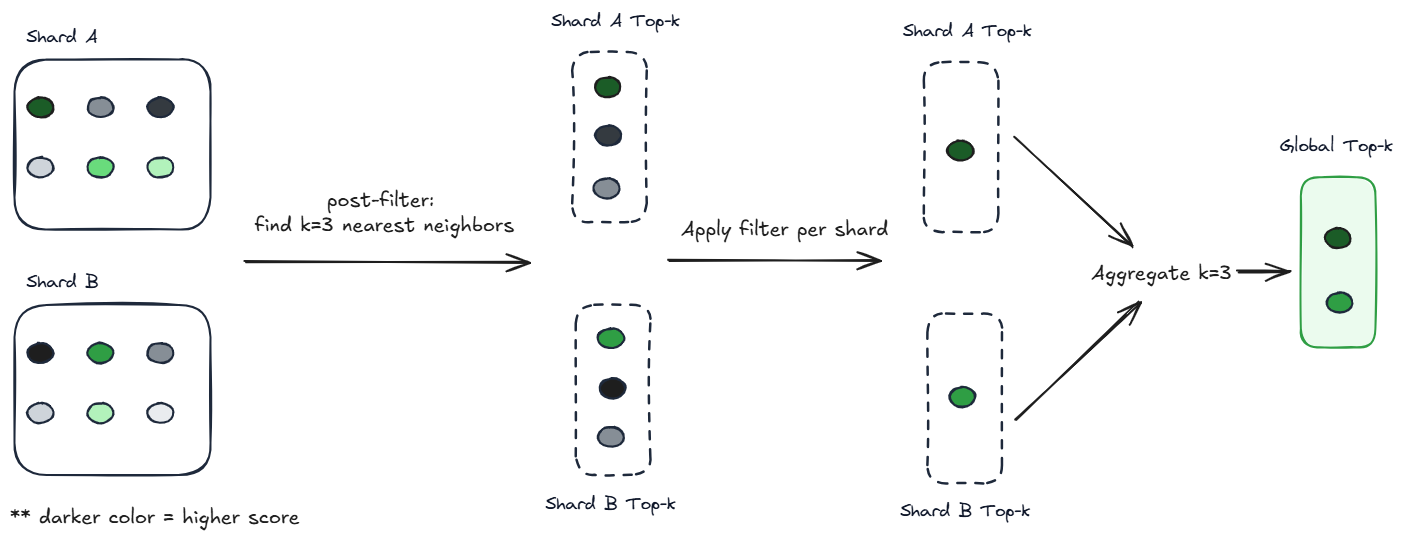
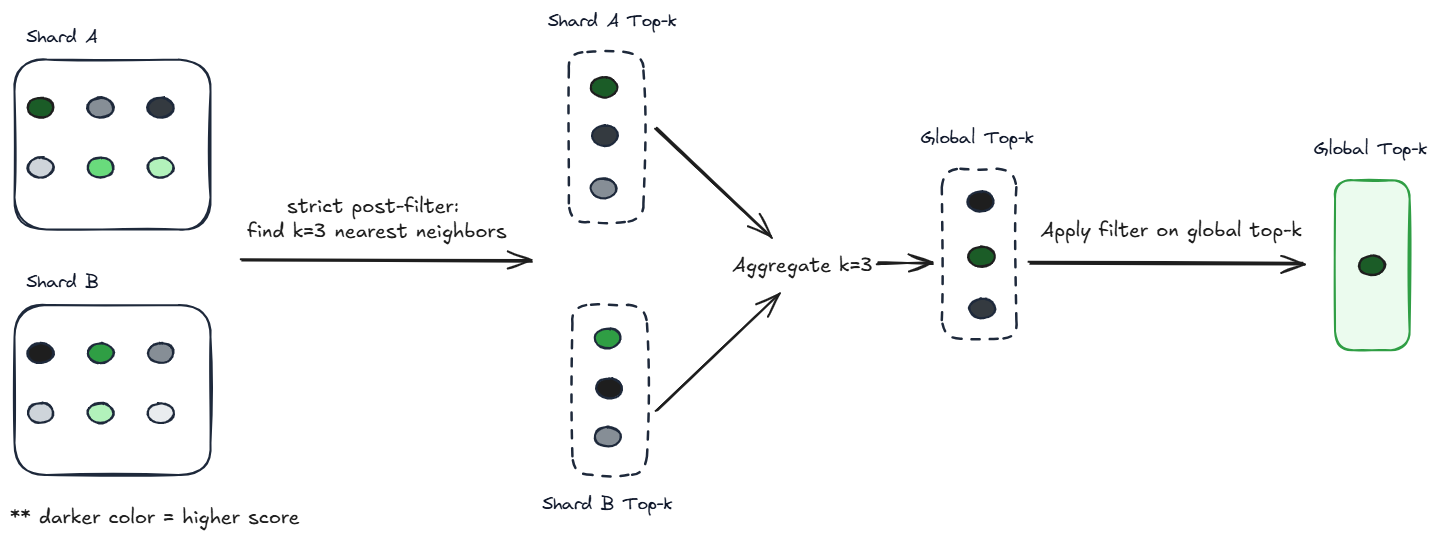
Tableau de comparaison
| Mode | Rappel (résultats filtrés) | Coût de calcul | Risque de faux négatifs | Quand utiliser |
|---|---|---|---|---|
preFilter |
Très élevé | Plus élevé (augmente avec la sélectivité et la complexité des filtres) | Aucun risque |
Recommandé par défaut pour tous les scénarios, en particulier lorsque le rappel est critique (domaines de recherche sensibles), lors de l’utilisation de filtres sélectifs ou lors de l’utilisation de petits k. |
postFilter |
Moyenne à élevée (diminue avec la sélectivité du filtre) | Similaire à un filtre non filtré, mais augmente avec la complexité du filtre | Modéré (peut manquer des correspondances par partition) | Option pour les filtres qui ne sont pas trop sélectifs et pour les requêtes supérieuresk . |
strictPostFilter |
Le plus bas (diminue le plus rapidement avec la sélectivité du filtre) | Similaire à non filtré | Le plus élevé (peut retourner zéro résultat pour des filtres sélectifs ou petits k) |
Option pour les applications de recherche à facettes où le fait de faire face à davantage de résultats après l’application de filtrage a un impact sur l’expérience utilisateur plus que le risque de faux négatifs. Ne pas utiliser avec de petits k. |
Test de référence du préfiltrage et du postfiltrage
Important
Cette section s’applique au préfiltrage et au postfiltrage, et non au postfiltrage strict.
Pour comprendre les conditions dans lesquelles un mode de filtre fonctionne mieux que l’autre, nous avons exécuté une série de tests pour évaluer les résultats des requêtes sur des index de petite, moyenne et grande taille.
- Petite (100 000 documents, index de 2,5 Go, 1 536 dimensions)
- Moyen (1 million de documents, index de 25 Go, 1 536 dimensions)
- Grand (1 milliard de documents, index de 1,9 To, 96 dimensions)
Pour les charges de travail petites et moyennes, nous avons utilisé un service Standard 2 (S2) avec une partition et une réplique. Pour un chargement de travail important, nous avons utilisé un service Standard 3 (S3) avec 12 partitions et une réplique.
Les index ont une construction identique : un champ clé, un champ vectoriel, un champ de texte et un champ filtrable numérique. L’index suivant est défini à l’aide de la 2023-11-01 syntaxe.
def get_index_schema(self, index_name, dimensions):
    return {
        "name": index_name,
        "fields": [
            {"name": "id", "type": "Edm.String", "key": True, "searchable": True},
            {"name": "content_vector", "type": "Collection(Edm.Single)", "dimensions": dimensions,
              "searchable": True, "retrievable": True, "filterable": False, "facetable": False, "sortable": False,
              "vectorSearchProfile": "defaulthnsw"},
            {"name": "text", "type": "Edm.String", "searchable": True, "filterable": False, "retrievable": True,
              "sortable": False, "facetable": False},
            {"name": "score", "type": "Edm.Double", "searchable": False, "filterable": True,
              "retrievable": True, "sortable": True, "facetable": True}
        ],
      "vectorSearch": {
        "algorithms": [
            {
              "name": "defaulthnsw",
              "kind": "hnsw",
              "hnswParameters": { "metric": "euclidean" }
            }
          ],
          "profiles": [
            {
              "name": "defaulthnsw",
              "algorithm": "defaulthnsw"
            }
        ]
      }
    }
Dans les requêtes, nous avons utilisé un filtre identique pour les opérations de préfiltrage et de post-filtre. Nous avons utilisé un filtre simple pour garantir que les variations de performances étaient dues au mode de filtrage, et non à la complexité du filtrage.
Les résultats ont été mesurés dans les requêtes par seconde (QPS).
Points clés
Le préfiltrage est presque toujours plus lent que le postfiltrage, sauf sur les petits index où les performances sont approximativement égales.
Sur les jeux de données plus volumineux, le préfiltrage est des ordres de grandeur plus lents.
Pourquoi le préfiltre est-il utilisé par défaut s’il est presque toujours plus lent ? Le préfiltrage garantit que les résultats
ksont retournés s’ils existent dans l’index, avec une priorité donnée au rappel et à la précision plutôt qu'à la vitesse.Utilisez le postfiltrage si vous :
Privilégier la vitesse plutôt que le choix (le postfiltrage peut retourner moins de
krésultats).Utilisez des filtres qui ne sont pas trop sélectifs.
Avoir des index de taille suffisante pour que les performances de préfiltrage soient inacceptables.
Détails
Compte tenu d’un jeu de données avec 100 000 vecteurs à 1 536 dimensions :
Lors du filtrage de plus de 30% du jeu de données, le préfiltrage et le postfiltrage étaient comparables.
Lors du filtrage inférieur à 0,1% du jeu de données, le préfiltrage était d’environ 50% plus lent que le postfiltrage.
Compte tenu d’un jeu de données avec 1 million de vecteurs à 1 536 dimensions :
Lors du filtrage de plus de 30% du jeu de données, le préfiltrage était d’environ 30% plus lent.
Lors du filtrage inférieur à 2% du jeu de données, le préfiltrage était environ sept fois plus lent.
Compte tenu d’un jeu de données avec 1 milliard de vecteurs à 96 dimensions :
Lors du filtrage de plus de 5% du jeu de données, le préfiltrage était d’environ 50% plus lent.
Lors du filtrage inférieur à 10% du jeu de données, le préfiltrage était environ sept fois plus lent.
Le graphique suivant montre le QPS relatif au préfiltre, calculé en tant que QPS préfiltré divisé par QPS postfilter.
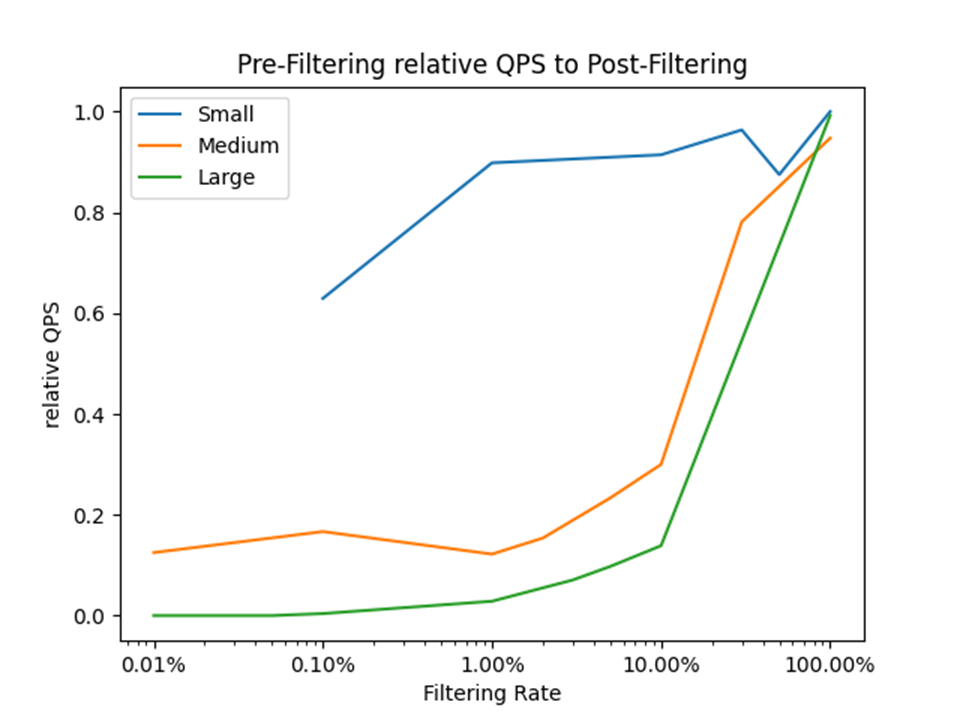
L’axe vertical représente les performances relatives du préfiltrage par rapport au postfiltrage, exprimée sous la forme d’un ratio de QPS (requêtes par seconde). Par exemple :
- Une valeur de
0.0signifie que le préfiltrage est 100 % plus lent que le postfiltrage. - Une valeur de
0.5signifie que le préfiltrage est 50 % plus lent. - Une valeur de
1.0signifie que le préfiltrage et le post-filtrage sont équivalents.
L’axe horizontal représente le taux de filtrage ou le pourcentage de documents candidats après l’application du filtre. Par exemple, un taux de 1.00% signifie que les critères de filtre ont sélectionné un pour cent du corpus de recherche.