Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Remarque
Recherche Azure AI est disponible via le portail Azure, les API REST et les SDK Azure. Il sous-tend également Foundry IQ, la couche de connaissances managée qui transforme le contenu d’entreprise en bases de connaissances réutilisables et prenant en charge les autorisations pour les agents dans le portail Microsoft Foundry.
Lorsque vous créez un service de recherche, vous devez choisir un modèle tarifaire et un niveau de service. Recherche Azure AI propose deux modèles tarifaires, chacun adapté à différents modèles de charge de travail, avec des niveaux de service associés qui déterminent la capacité et les fonctionnalités :
| Modèle de tarification | Idéal pour | Comment vous êtes facturé |
|---|---|---|
| Dedicated | Charges de travail stables, prévisibles et à utilisation élevée | Capacité fixe via des unités de recherche (SU) ; Taux horaire en fonction de la sélection d’un niveau de service |
| Serverless (préversion) | Charges de travail peu fréquentes, sporadiques ou très variables | Basé sur la consommation : mesuré par unités de calcul (UC) et stockage indexé (Go/mois) |
Remarque
Les unités de recherche de modèle dédiées et les unités de calcul de modèle serverless ne sont pas identiques et ne peuvent pas être utilisées de manière interchangeable. N’utilisez pas les calculateurs ou estimations de tarification basés sur les SU pour les charges de travail sans serveur.
Les deux modèles fournissent les mêmes fonctionnalités de recherche principales (avec quelques exceptions mineures pour la préversion serverless indiquée ci-dessous). La principale différence est le comportement de tarification et de mise à l’échelle, et non les fonctionnalités.
La sélection du modèle tarifaire dédié nécessite l’estimation des besoins de votre charge de travail, puis le choix d’un niveau de service avec la capacité préprovisionnée appropriée.
La sélection du modèle de tarification serverless ne nécessite pas de sélectionner un niveau de service préprovisionné, mais utilise la tarification basée sur la consommation. L’optimisation des performances affecte donc directement les coûts.
Modèle de tarification serverless (préversion)
Important
Le niveau Développeur serverlessr est actuellement en préversion. Cette version préliminaire est fournie sans contrat de niveau de service et n’est pas recommandée pour les environnements de production. Certaines fonctionnalités peuvent ne pas être prises en charge ou avoir des fonctionnalités contraintes. Pour plus d’informations, consultez Conditions d'utilisation supplémentaires pour les versions préliminaires de Microsoft Azure.
La facturation de l’offre Développeur sans serveur a débuté le 13 septembre 2026. Les frais d’utilisation sur ou après cette date apparaissent sur votre facture Azure. Vous n’êtes pas facturé pour l’utilisation avant le 13 septembre 2026.
Le niveau Développeur serverless ne prend pas en charge la migration vers ou depuis d’autres niveaux tarifaires et certaines fonctionnalités disponibles sur d’autres niveaux ne sont pas prises en charge pendant la préversion publique. Les limites de service, les fonctionnalités prises en charge et les détails des tarifs peuvent changer avant la disponibilité générale.
Pendant la préversion, le modèle de tarification Serverless est pris en charge uniquement dans des régions spécifiques.
Le modèle de tarification Serverless est une offre basée sur la consommation qui met automatiquement à l’échelle le calcul et le stockage en fonction de votre charge de travail. Il élimine la nécessité d’approvisionner la capacité en amont, ce qui vous permet de payer uniquement les ressources que vous utilisez.
Lorsque vous utilisez le modèle serverless, vous ne configurez pas de réplicas, de partitions ou d’unités de recherche. Au lieu de cela, le service gère dynamiquement la capacité en réponse au volume de requêtes, à l’activité d’indexation et à la complexité de la charge de travail.
La facturation est basée sur deux dimensions principales :
- Utilisation du calcul : mesurée en unités de calcul par heure (CU/h) et facturées en fonction du travail effectué (requêtes, indexation et autres opérations).
- Stockage indexé : facturé par Go par mois en fonction de la taille de vos index.
Ce modèle est conçu pour les charges de travail avec une demande variable, notamment le trafic en rafale et les applications multilocataires. Il prend en charge les mêmes fonctionnalités et API de recherche principales que les services dédiés, ce qui vous permet de créer et d’exécuter des applications de recherche sans réécrire du code.
Le niveau Développeur serverless est disponible en préversion publique et ne prend actuellement pas en charge les fonctionnalités suivantes :
- Alias d’index : non pris en charge
- Sessions de débogage : Non prises en charge
- Mise en réseau privée pour les indexeurs : non pris en charge
- Ressources de Private Link partagées : aucune prise en charge planifiée du modèle serverless
- Contrat de niveau de service (SLA) : non disponible pendant la préversion publique
Pour plus d’informations, consultez Service Limits in Recherche Azure AI.
Pour obtenir d’autres options de déploiement Serverless à grande échelle, contactez Microsoft à l’aide du formulaire d’inscription à la préversion privée d’Recherche Azure AI Serverless.
Modèle de tarification dédié
Le modèle tarifaire dédié est une offre de capacité provisionnée qui offre des performances et des coûts prévisibles en allouant une infrastructure fixe à votre charge de travail. Vous configurez la capacité en amont, ce qui permet au service de gérer les demandes d’indexation et de requête cohérentes avec des ressources garanties.
Avec les niveaux dédiés, vous configurez explicitement des réplicas, des partitions et des unités de recherche (SU). Les répliques assurent le débit des requêtes et la haute disponibilité, tandis que les partitions définissent la capacité de stockage et d’indexation. Ensemble, ils déterminent la capacité totale et les caractéristiques de performances de votre service de recherche.
La facturation est basée sur les points suivants :
- Niveau de service : capacité provisionnée pré-sélectionnée.
- Unités de recherche (SUs) : unité de facturation pour les services dédiés, calculée comme suit : réplicas × partitions. Vous payez un taux horaire fixe en fonction du nombre d’unités de recherche et du niveau de service sélectionné.
Ce modèle est conçu pour les charges de travail avec une demande stable et prévisible, où des performances cohérentes, une faible latence et une mise à l’échelle contrôlée sont importantes.
Dans le modèle de tarification dédié, le niveau de service sélectionné détermine :
- Nombre maximal d’index et d’autres objets autorisés sur le service.
- Taille et vitesse des partitions (stockage physique).
- Taux facturable en tant que coût mensuel fixe, mais également un coût incrémentiel si vous ajoutez de la capacité.
- Caractéristiques de la charge de travail. Certains niveaux sont optimisés pour des charges de travail spécifiques.
Dans certains cas, le niveau détermine également la disponibilité des fonctionnalités Premium.
Descriptions des niveaux
Les niveaux facturables les plus couramment utilisés comprennent :
Basic prend en charge les charges de travail de production et peut répondre aux exigences de SLA avec jusqu’à trois répliques.
Standard (S1, S2, S3) est le niveau par défaut. Il prend en charge la mise à l’échelle des partitions et des réplicas, ce qui permet de gérer des charges de travail plus importantes et d’améliorer les performances.
Certains niveaux sont conçus pour certains types de travaux :
Standard 3 haute densité (S3 HD) est un mode d’hébergement pour S3 optimisé pour le multilocataire. S3 HD a la même charge par unité que S3, mais prend en charge un grand nombre d’index plus petits et utilise du matériel optimisé pour les lectures de fichiers rapides et les scénarios de stockage à haute densité.
Les niveaux optimisés pour le stockage (L1, L2) fournissent un stockage à moindre coût par To et sont conçus pour les index volumineux et moins fréquemment mis à jour. Ces niveaux ont généralement une latence de requête plus élevée.
Il existe également un niveau de service de recherche gratuit et limité :
- Gratuit crée un service de recherche limité pour les petits projets, tels que les didacticiels et le développement. Les ressources sont partagées entre les locataires et la mise à l’échelle n’est pas prise en charge. Certaines fonctionnalités Premium ne sont pas disponibles et le service peut être supprimé après des périodes d’inactivité. Vous ne pouvez avoir qu’un seul service de recherche gratuit par abonnement Azure.
Vous voyez les tarifs de facturation dans le portail Azure lorsque vous créez un service Recherche Azure AI dans la page Sélectionner le niveau tarifaire.
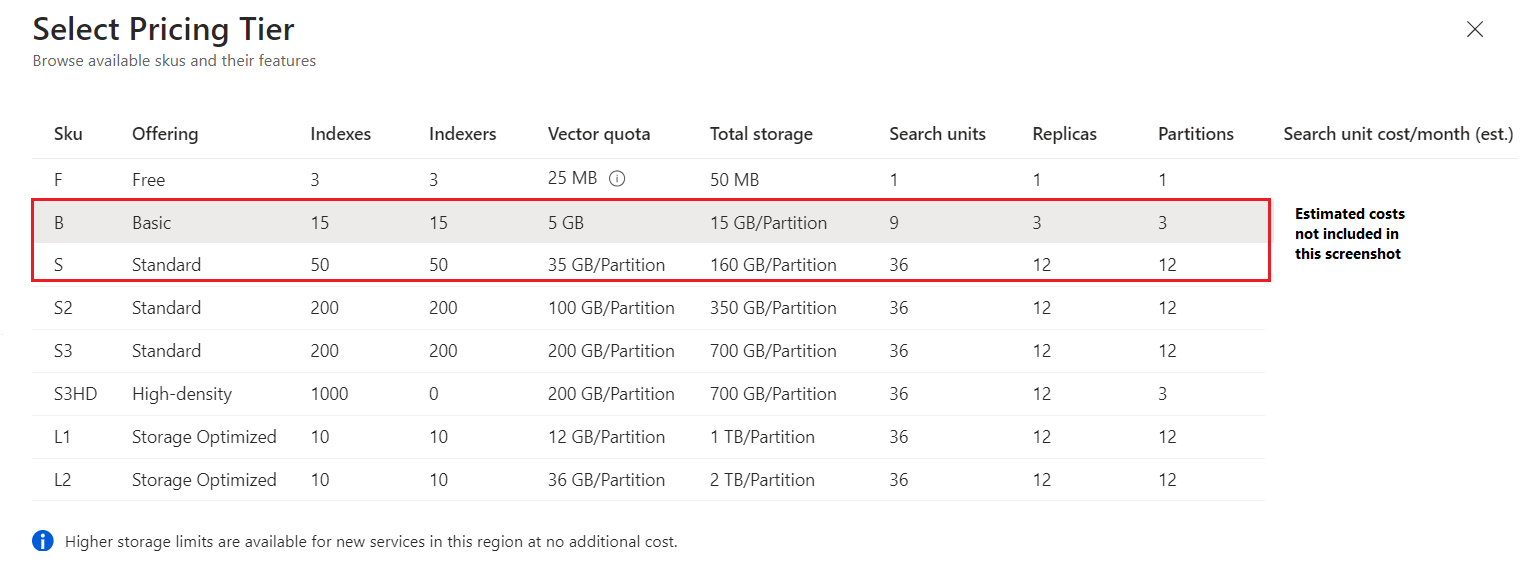
Vous pouvez consulter la page de tarification des tarifs régionaux.
Passez en revue le plan et gérez les coûts pour en savoir plus sur le modèle tarifaire dédié et la façon dont il se compare au modèle serverless.
Vérifiez les limites Service dans Recherche Azure AI ou les limites du stockage, des charges de travail et des nombres d’objets par niveau.
Comment sélectionner un niveau
Dans le portail Azure, les niveaux de service sont spécifiés dans la page Select Pricing Tier lorsque vous créez le service.
Dans PowerShell ou Azure CLI, le niveau est spécifié via le paramètre -Sku.
Disponibilité des régions par niveau
La liste des régions fournit les emplacements où Recherche Azure AI est proposée. Certaines régions peuvent avoir des contraintes de capacité pour certains niveaux, ce qui empêche la création de nouveaux services de recherche sur ces niveaux. La liste utilise des notes de bas de page pour indiquer les régions et niveaux contraints.
Lorsque vous créez un service de recherche dans le portail Azure, les combinaisons de niveau région non disponibles sont automatiquement exclues.
Disponibilité des fonctionnalités par niveau
La plupart des fonctionnalités sont disponibles sur tous les niveaux. Dans certains cas, la disponibilité des fonctionnalités dépend du niveau sélectionné :
| Fonctionnalité | Considérations sur les niveaux |
|---|---|
| indexeurs | Les indexeurs sont disponibles sur S3 HD, avec un quota d’exécution quotidien pour l’ensemble des indexeurs et d’autres considérations (version préliminaire). Les indexeurs ont davantage de limitations sur le niveau gratuit. |
paramètre de configuration de l'indexeurexecutionEnvironment |
La capacité de fixer tout le traitement de l'indexeur aux clusters de recherche alloués à votre service de recherche requiert S2 ou une version supérieure. |
| Enrichissement par IA | Fonctionne avec le niveau gratuit, mais n'est pas recommandé pour les charges de travail importantes. |
| Identités managées ou approuvées pour l’accès sortant (indexeur) | Non disponibles au niveau Gratuit. |
| Clés de chiffrement gérées par le client | Non disponibles au niveau Gratuit. |
| Accès au pare-feu IP | Non disponibles au niveau Gratuit. |
| Point de terminaison privé (intégration à Azure Private Link) | Pour les connexions entrantes à un service de recherche ; non disponible au niveau Gratuit. Pour les connexions sortantes établies par des indexeurs vers d'autres ressources Azure, cette option n'est pas disponible pour les niveaux Gratuit et S3 HD. Pour les indexeurs qui utilisent des ensembles de compétences ; non disponible aux niveaux Gratuit, De base, S1 et S3 HD. |
| Zones de disponibilité | Non disponibles au niveau Gratuit. |
| Classeur sémantique | Fonctionne avec le niveau gratuit, mais n'est pas recommandé pour les charges de travail importantes. |
Les fonctionnalités gourmandes en ressources risquent de ne pas fonctionner correctement si vous ne leur attribuez pas une capacité suffisante. Par exemple, l’enrichissement par IA propose des fonctionnalités à longue durée qui expirent sur un service gratuit, sauf si le jeu de données est restreint.
Limites supérieures
Les niveaux déterminent le stockage maximal du service proprement dit, ainsi que le nombre maximal d’index, d’indexeurs, de sources de données, d’ensembles de compétences et de cartes de synonymes que vous pouvez créer. Pour connaître toutes les limites, consultez Limites de service de recherche Azure AI.
Taille et vitesse de la partition
La tarification par niveau comprend des détails sur le stockage par partition qui va de 15 Go pour le niveau de base, jusqu’à 2 To pour les niveaux de stockage optimisé (L2). D’autres caractéristiques matérielles, telles que la vitesse des opérations, la latence et les taux de transfert, ne sont pas publiées, mais les niveaux conçus pour des architectures de solution spécifiques sont basés sur du matériel qui possède les caractéristiques nécessaires pour prendre en charge ces scénarios. Pour plus d’informations sur les partitions, consultez Estimer et gérer la capacité et Fiabilité dans la recherche Azure AI.
Remarque
Les partitions à plus grande capacité sont devenues disponibles dans certaines régions en avril 2024. Une deuxième vague de partitions à plus grande capacité a été publiée en mai 2024. Si vous avez un service de recherche plus ancien, vous pouvez peut-être mettre à niveau votre service pour bénéficier d’une plus grande capacité au même taux de facturation.
Tarifs de facturation
Les niveaux ont des tarifs de facturation différents, avec des tarifs plus élevés pour les niveaux qui s’exécutent sur du matériel plus onéreux ou qui offrent des fonctionnalités plus coûteuses. Le taux de facturation par niveau est disponible dans les pages de tarification Azure pour la Recherche Azure AI.
Une fois que vous avez créé un service, le taux de facturation devient à la fois un coût fixe d’exécution du service autour de l’horloge et un coût incrémentiel si vous choisissez d’ajouter plus de capacité.
Dans le modèle dédié, la facturation repose sur des unités de recherche (SUs), qui combinent des partitions (stockage) et des répliques (capacité de traitement des requêtes).
- Un service démarre avec une partition et une réplique (une SU)
- L’ajout de partitions ou de répliques augmente les coûts de façon linéaire avec le nombre de SUs
Par exemple, l’ajout de répliques pour améliorer la disponibilité ou le débit augmente proportionnellement le coût mensuel.
Pour plus d’informations, consultez Planifier et gérer les coûts.
Exemple de taux de facturation
L'exemple suivant illustre cette situation. Supposons un tarif de facturation hypothétique de 100 USD par mois. Si vous conservez le service de recherche à sa capacité initiale d’une partition et d’un réplica, vous pouvez alors vous attendre à payer la somme de 100 USD à la fin du mois. Toutefois, si vous ajoutez deux réplicas supplémentaires pour obtenir une haute disponibilité, la facture mensuelle s’élève à 300 USD (100 USD pour la première paire réplica-partition, puis 200 USD pour les deux réplicas).
Modifications de niveau
Remarque
Les services de recherche existants peuvent basculer entre les niveaux De base et Standard (S1, S2 et S3). Votre configuration de service actuelle ne peut pas dépasser les limites du niveau cible et votre région ne peut pas avoir de contraintes de capacité sur le niveau cible. Pour plus d’informations, consultez Modifier votre niveau tarifaire.
Pour basculer vers un niveau différent de celui précédemment répertorié :
- Créez un service de recherche sur le nouveau niveau.
- Déployez votre contenu de recherche sur le nouveau service. Suivez cette liste de contrôle pour vous assurer que vous disposez de tout le contenu.
- Supprimez l’ancien service lorsque vous êtes sûr qu’il n’est plus nécessaire.
Pour les grands index que vous ne souhaitez pas reconstruire à partir de zéro, utilisez l’un des exemples de sauvegarde et de restauration suivants :
- Exemple de sauvegarde et de restauration (C#)
- Exemple de sauvegarde et de restauration (Python)
- Exemple de sauvegarde et de restauration pour des index très volumineux (Python)
Étapes suivantes
La meilleure façon de choisir un niveau tarifaire consiste à commencer par un niveau de coût minimum, puis à autoriser l’expérience et les tests pour informer votre décision de conserver le service ou de passer à un niveau supérieur.
Pour les étapes suivantes, nous vous recommandons de créer un service de recherche à un niveau qui peut prendre en charge le niveau de test que vous proposez, puis de passer en revue les instructions suivantes sur l’estimation du coût et de la capacité :