Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Note
Azure AI Vyhledávač je k dispozici prostřednictvím portálu Azure, rozhraní REST API a Sady Azure SDK. Podporuje také Foundry IQ, spravovanou znalostní vrstvu, která transformuje podnikový obsah na opakovaně použitelné znalostní báze s podporou oprávnění pro agenty na portálu Microsoft Foundry.
Azure AI Vyhledávač podporuje dva cenové modely, které jsou navržené pro různé vzory úloh:
Dedikované: Fixní cena stanovená podle vyhledávacích jednotek (SU). Vyberete úroveň služby a je vám účtováno po hodinách na základě zřízených jednotek.
Bezserverová verze (Preview):Ceny založené na spotřebě měřené podle výpočetních jednotek za hodinu (CU/hr) a za GB za měsíc pro indexované úložiště.
Important
Bezserverová úroveň Developer je aktuálně ve verzi Preview. Tato verze Preview je poskytována bez smlouvy o úrovni služeb a nedoporučuje se pro produkční úlohy. Některé funkce nemusí být podporované nebo můžou mít omezené možnosti. Další informace najdete v dodatečných podmínkách použití pro verze Preview v Microsoft Azure.
Fakturace pro bezserverovou úroveň Developer začala 13. září 2026. Na faktuře za Azure se zobrazí poplatky za využívání k tomuto datu nebo po něm. Za využití se vám neúčtuje před 13. zářím 2026.
Bezserverová úroveň Developer nepodporuje migraci do jiných cenových úrovní ani z jiných cenových úrovní a některé funkce, které jsou k dispozici na jiných úrovních, se ve verzi Public Preview nepodporují. Limity služeb, podporované funkce a podrobnosti o cenách se můžou před obecnou dostupností změnit.
Ve verzi Preview se cenový model bez serveru podporuje jenom v konkrétních oblastech.
Další informace o cenových modelech a rozdílech úrovní služeb najdete v tématu Volba cenového modelu a úrovně služby.
Určení nákladů v bezserverovém modelu
Cenové modely Dedicated a Serverless zohledňují práci v rámci služby vyhledávání odlišně. Vyhrazené služby spouštějí dotazy, indexování a zpracování výsledků na zřízené kapacitě, kterou jste už zakoupili. Bezserverové služby měří výpočetní prostředky, paměť a vstupně-výstupní operace, které tyto operace spotřebovávají, a převádějí toto využití na výpočetní jednotky (CU). Díky tomu optimalizace výkonu přímo ovlivňuje náklady bez serveru.
Bezserverové náklady jsou svázané se spouštěním úloh:
- Dotazy a indexování spotřebovávají výpočetní prostředky měřené v výpočetních jednotkách za hodinu (CU/h).
- Aktivní indexy spotřebovávají výpočetní prostředky na základě využití prostředků a doby, po kterou zůstanou aktivní.
- Index zůstane aktivní po dobu 10 minut od posledního dotazu nebo požadavku na indexování, než přestane fungovat.
- Neaktivní indexy nemají žádné minimální ani rezervované poplatky za výpočetní prostředky. Využití výpočetních prostředků pro neaktivní indexy se škáluje na nulu. Pokud je index neaktivní, není účtován žádný minimální poplatek za výpočetní prostředky.
- Úložiště se účtuje samostatně podle velikosti indexu na disku a účtování pokračuje bez ohledu na to, zda se index používá, či nikoli.
- Agentní vyhledávání spotřebovává výpočetní prostředky na vyhledávací dotazy a orchestraci prováděné v rámci vyhledávací služby.
Poplatky za úložiště se zastaví jenom při odstranění indexu.
Pokud chcete zobrazit rozpis nákladů a sazby využití pro aktuální fakturační cyklus, podívejte se na kartu Škálování a náklady na portálu Azure.
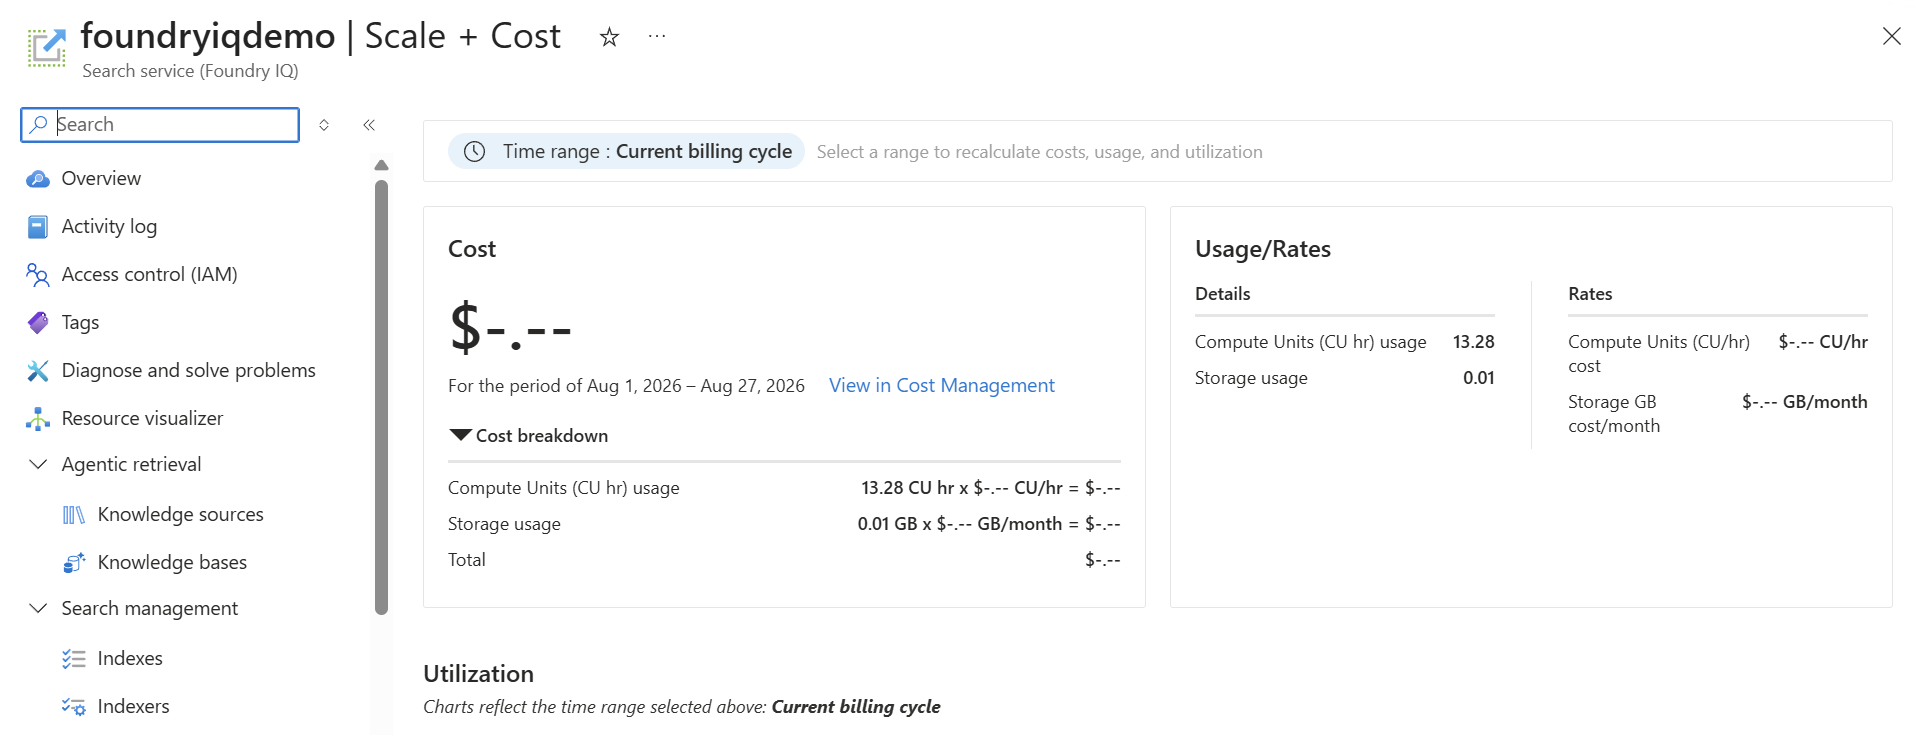
Vliv velikosti indexu na využití výpočetních prostředků
Zatímco je index aktivní, Azure AI Vyhledávač vyhodnotí dva konečné prostředky k určení využití výpočetních prostředků:
- Celková velikost indexu: Celkový prostor, který index zabírá na disku, včetně textu, metadat a vektorů.
- Velikost vektorového indexu: Paměť používaná indexem vektoru. Paměť je náročnější na prostředky než disk, takže velikost vektorového indexu má při převodu na jednotky CU vyšší váhu.
Azure AI Vyhledávač nepřidá dohromady dvě výsledné částky CU. Využití výpočetních prostředků vychází z toho, která částka je vyšší. Například velikost vektorového indexu může určit využití výpočetních prostředků, i když je celková velikost indexu na disku relativně malá.
Pokud chcete snížit využití výpočetního výkonu aktivního indexu, zjistěte, který prostředek generuje vyšší počet CU. Potom zmenšete celkovou velikost indexu, velikost vektoru nebo obojí. Indexované úložiště zůstává samostatným poplatkem za GB za měsíc.
Cenový model bezserverové architektury je nákladově nejefektivnější pro úlohy s proměnlivým, přerušovaným nebo nepředvídatelným provozem, kdy by zřízená kapacita byla nedostatečně využita.
Important
Poplatky za serverless CU pokrývají práci prováděnou v rámci vyhledávací služby, včetně zpracování dotazů, indexování, zpracování výsledků a orchestrace agentního vyhledávání. Volání modelů a ostatní operace prováděné mimo vyhledávací službu nadále používají stávající fakturační měřiče. Mezi příklady patří sémantické řazení, přepis dotazů agentů, extrakce obrázků a provádění dovedností.
Porozumění výpočetním jednotkám (CU)
Výpočetní jednotka (CU) představuje měřené systémové prostředky potřebné k provádění operací vyhledávání a indexování v bezserverovém modelu. Náklady na CU jsou určovány především využitím procesoru, paměti a V/V operací a v menší míře velikostí indexu a velikostí datové části dokumentu, přičemž využití se účtuje v jednotkách Compute Unit za hodinu (CU/h).
Náklady na výpočetní výkon se odvíjejí od:
- Složitost dotazů
- Velikost indexu (GB) a struktura
- Velikost datové části dokumentu (KB)
- Počet polí a načtených výsledků
Různé operace mají různé profily nákladů:
- Vyhledávání: Nízké náklady. Načtení jednoho dokumentu podle ID je nejefektivnější operací.
- Hledání klíčových slov: Nízké náklady. Vyhledávání textu používá invertované indexy, které jsou optimalizované pro rychlost a nízké využití výpočetních prostředků.
- Vektorové vyhledávání: Vysoké náklady. Vektorové dotazy jsou výpočetně náročné, protože vyžadují výpočty podobnosti napříč vysokodimenzionálními vkládáními. Ve srovnání s vyhledáváním klíčových slov spotřebovávají výrazně více výpočetních prostředků.
- Hybridní vyhledávání: Kombinuje náklady na vyhledávání podle klíčových slov a vektorové vyhledávání, protože při každém dotazu běží oba procesy, plus malé dodatečné režijní náklady na Reciprocal Rank Fusion (RRF) pro sloučení výsledků.
Monitorování využití výpočetních prostředků
Monitorování spotřeby výpočetních prostředků pomáhá identifikovat nákladné operace, optimalizovat vzory dotazů a odhadnout náklady. Cena v jednotkách Compute Unit (CU) u každého požadavku se vrací v hlavičce odpovědi HTTP x-ms-azs-compute-units-consumed jako číslo s pohyblivou desetinnou čárkou. Tato hlavička slouží k identifikaci drahých operací a optimalizaci vzorů dotazů. Náklady na CU každého požadavku můžete sledovat kontrolou hlaviček odpovědí HTTP a událostí operací v Azure Monitor. Další pokyny k typům dostupných dat monitorování a metod analýzy těchto dat najdete v tématu Monitorování Azure AI Vyhledávač.
-
Hlavička:
x-ms-azs-compute-units-consumed: <value> - Hodnota: Číslo s plovoucí desetinnou čárkou představující spotřebované CU.
Příklad:
Status: 200 OK
Content-Type: application/json
x-ms-azs-compute-units-consumed: 12.45
V tomto příkladu spotřeboval požadavek 12,45 výpočetních jednotek. Tuto hodnotu můžete použít k identifikaci vysoce nákladných operací a porovnání relativních nákladů na různé vzory dotazů.
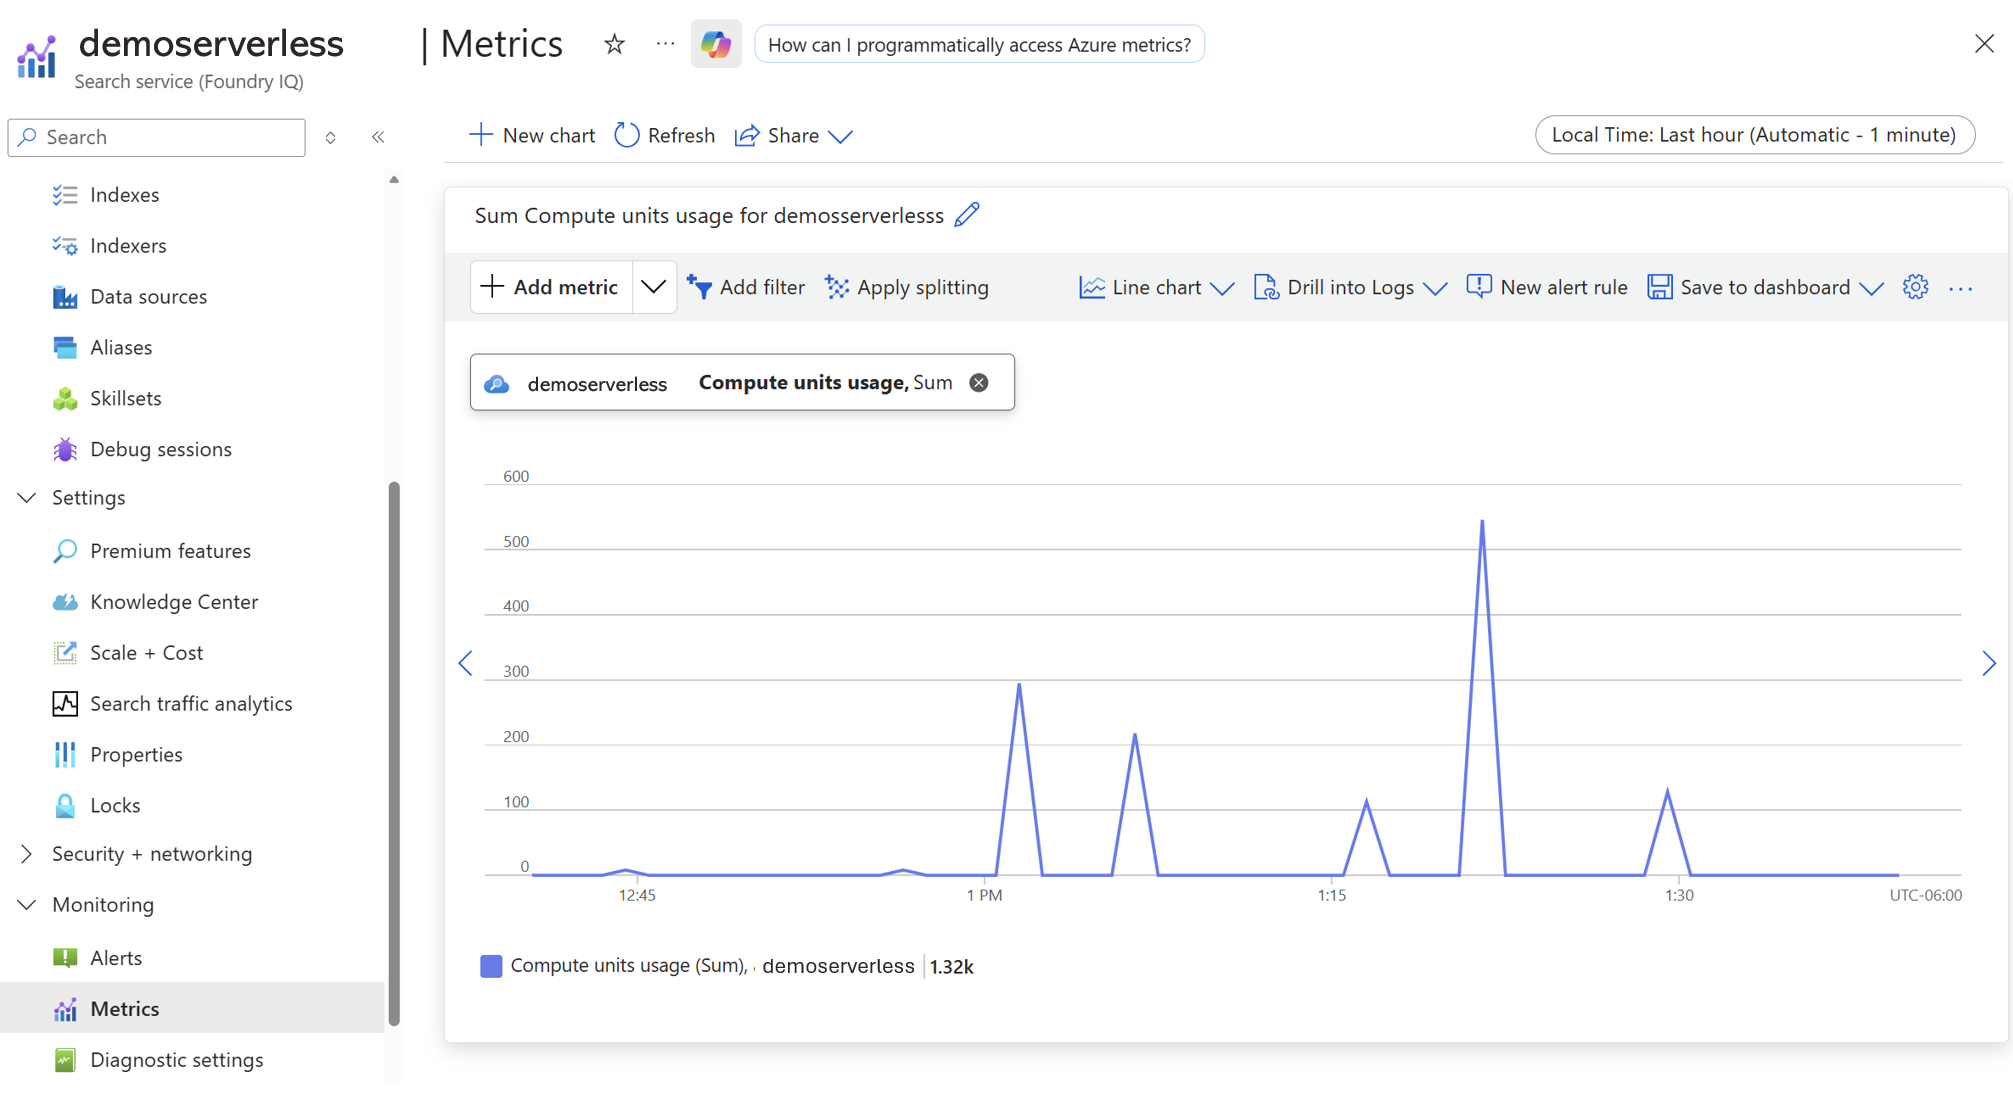
Pokud chcete zkontrolovat historickou spotřebu výpočetních prostředků pro bezserverovou vyhledávací službu, použijte metriky Azure Monitor na portálu Azure:
- Přejděte do vyhledávací služby.
- Vyberte Metriky.
- Vyberte + Přidat metriku.
- V seznamu metrik vyberte Využití výpočetních jednotek.
- Pomocí grafu můžete analyzovat trendy využití a identifikovat období zvýšené spotřeby výpočetních prostředků.
Monitorování agregovaného využití vám pomůže pochopit celkové náklady na služby a identifikovat úlohy, které spotřebovávají nejvíce výpočetních prostředků. Popis dostupných metrik monitorování najdete v tématu Referenční informace k datům monitorování. Pomocí protokolů Azure Monitor můžete sledovat agregované využití CU v průběhu času a korelovat ho se změnami objemu dotazů a úloh.
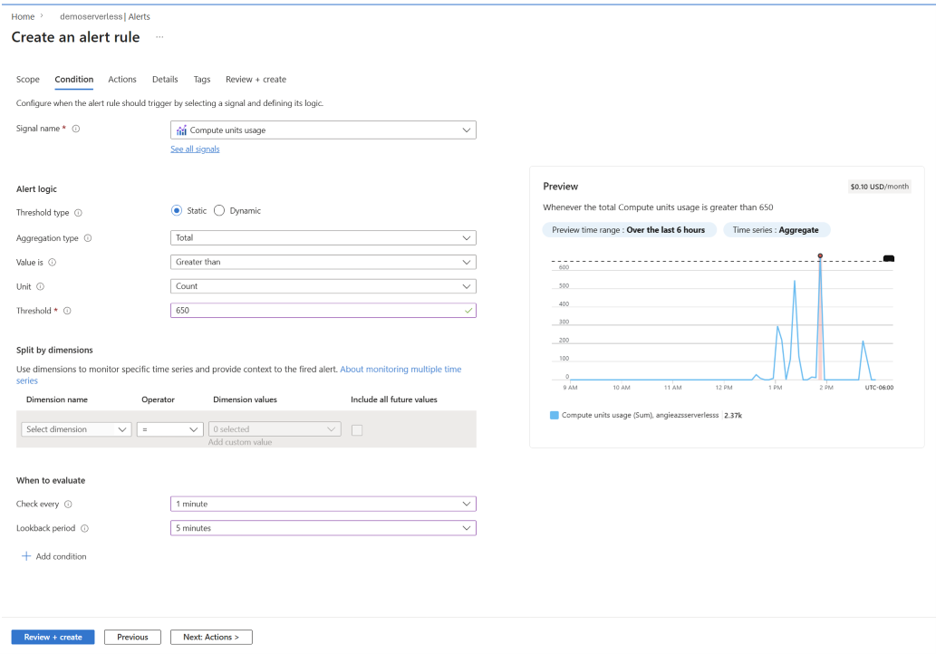
Konfigurace upozornění na využití výpočetních prostředků
Můžete vytvořit pravidlo upozornění, které bude upozorněno, když spotřeba výpočetních prostředků dosáhne zadané prahové hodnoty na portálu Azure.
- Ve vyhledávací službě přejděte na Upozornění .
- Vyberte + Vytvořit pravidlo výstrahy.
- V části Podmínka zvolte jako signál využití výpočetních jednotek .
- Definujte logiku upozornění. Například spustit, když je celkové využití vyšší než zadaná hodnota.
- Konfigurace akcí, jako jsou e-maily, SMS nebo oznámení webhooku
- Dokončete zbývající kroky a vyberte Zkontrolovat a vytvořit.
Výstrahy pomáhají aktivně reagovat na neočekávané špičky využití a spravovat náklady.
Odhad nákladů na bezserverovou architekturu
Pokyny k plánování kapacity založené na Azure cenové kalkulačce a jednotce vyhledávání se nevztahují na služby, které používají cenový model bez serveru.
Odhad nákladů na bezserverovou architekturu:
- Indexovat reprezentativní vzorová data.
- Spusťte typické úlohy indexování a dotazování.
- Zaznamená hodnotu vrácenou
x-ms-azs-compute-units-consumedpro každou operaci. - K měření agregovaného využití v průběhu času použijte metriky Azure Monitor.
- Extrapolovat náklady na základě očekávaného produkčního provozu.
Na kartě Škálování a náklady na portálu Azure zobrazte aktuální využití a odhad nákladů.
Vzhledem k tomu, že stejná žádost spuštěná na stejných datech obecně vytváří podobnou spotřebu výpočetních prostředků, můžou reprezentativní úlohy poskytnout spolehlivý základ odhadu nákladů.
Bezserverové využití se měří nepřetržitě a agreguje pro fakturaci. Spotřeba výpočetních prostředků se sleduje po celou každou minutu a vygeneruje se pouze v případech, kdy se používají výpočetní prostředky.
Při odhadu nákladů využijte hodnoty poplatků za požadavky, abyste porozuměli nákladům na jednotlivé operace a Azure Monitor metrikám, abyste porozuměli schématům celkové spotřeby služeb.
Pomocí obou zdrojů dat můžete porozumět nákladům: data poplatků za jednotlivé žádosti pomáhají vyhodnotit jednotlivé operace, zatímco Azure Monitor metriky pomáhají pochopit agregovanou spotřebu služeb v průběhu času. Pro kompletní obrázek nákladů se také započítávají funkce, které se účtují odděleně od výpočetních jednotek.
Fakturace je založená na agregovaném využití výpočetních prostředků, nikoli na jednotlivých požadavcích. Využití se měří v minutových intervalech a zaokrouhluje se nahoru na nejbližší 0,25 CU za minutu. Tyto minutové intervaly využití se shromáždí v průběhu hodiny, aby bylo možné určit fakturovatelnou částku CU/hodinu. Interně se využití agreguje z mili výpočetních jednotek (mCU) na výpočetní jednotky (CU) a převádí se na hodinové využití vykazované pro účely fakturace.
Různé operace spotřebovávají různé objemy výpočetních prostředků. Obvykle:
- Hledání klíčových slov obvykle používá nejméně výpočetní prostředky.
- Vektorové vyhledávání obvykle používají více výpočetních prostředků než hledání klíčových slov.
- Hybridní vyhledávání kombinují spouštění klíčového slova a vektoru hledání, takže obvykle používají více výpočetních prostředků než technika sama.
Skutečná spotřeba výpočetních prostředků závisí na faktorech, jako je složitost dotazů, velikost indexu, objem dat, konfigurace vektoru a počet vrácených výsledků. Monitorování poplatků za požadavky a agregované metriky využití vám může pomoct identifikovat příležitosti optimalizace a lépe předpovědět provozní náklady.
Snížení nákladů na výpočetní prostředky prostřednictvím optimalizace
Efektivní dotazy a návrh indexu snižují spotřebu výpočetních prostředků a snižují náklady.
Optimalizace schématu
Schéma indexu určuje základní náklady na výpočetní prostředky a úložiště:
- Omezit atributy pole: V případě potřeby povolte pouze atributy (prohledávatelné, filtrovatelné, fasetovatelné, řaditelné). Každý atribut zvyšuje velikost indexu a náklady na indexování.
- Zploštěné komplexní typy: Pokud je to možné, namapujte vnořené struktury JSON na jednoduchá pole nebo kolekce.
-
Nastavte retrievable=false pro pole určená pouze k filtrování nebo řazení: Pokud se pole používá k filtrování nebo řazení, ale nemusí se vracet ve výsledcích, ponechte ho indexované a nastavte
retrievable=false, čímž snížíte využití místa na disku a náklady na úložiště za GB/měsíc. - Pokud je to možné, používejte pole jen pro načtení: Například pole použitá pouze pro zobrazení (například adresy URL obrázků) by neměla být prohledávatelná.
- Snížit rozměry vektorů: Vyšší dimenzionální vektory zvyšují náklady na úložiště a dotazy. Pokud je to vhodné, použijte menší modely vkládání nebo kvantování.
- Minimalizace velikosti datové části dokumentu před indexováním: Větší dokumenty jsou pro indexování nákladnější. Před odesláním dokumentů do indexu odeberte nepotřebná pole, oříznout dlouhý text a vyjmout kód HTML.
Optimalizace požadavků indexování
Způsob odesílání dat do indexu ovlivňuje náklady i propustnost:
Pokud je to možné, používejte větší dávky: Dávkové indexování snižuje režijní náklady na požadavky tím, že amortizuje náklady na síť a zpracování napříč více dokumenty. Obecně platí, že dávky o velikosti až ~1 000 dokumentů nebo ~16 MB jsou z hlediska CU efektivnější než mnoho malých požadavků. Optimální velikost dávky ale závisí na vaší úloze. Otestujte vyrovnávání propustnosti, latence a spolehlivosti.
Indexovat pouze nová nebo změněná data: Pokud je to možné, vyhněte se úplnému přeindexování. Odesílání jenom doplňků a aktualizací snižuje počet zpracovaných dokumentů, snižuje náklady na výpočetní prostředky a zlepšuje rychlost příjmu dat.
Přeskočte extrakci obrázků, pokud ji nepotřebujete: Extrahování obrázků přidává další zpracování a může se stát samostatným nákladovým faktorem. Zapněte ho jenom pro dokumenty nebo pracovní postupy, které skutečně potřebují obsah obrázku.
Účet pro růst velikosti indexu: Pokud je to možné, vytvořte menší indexy. S rostoucím indexem se zvyšují náklady na indexování, protože je potřeba uložit a udržovat více dat a operace vyžadují větší výpočetní výkon. U velmi velkých datových sad zvažte rozdělení dat mezi více indexů, abyste mohli spravovat výkon a náklady. I když se náklady zvyšují s velikostí indexu, zvýšení je podlineární. Větší indexy stojí více na operaci, ale ne úměrně více.
Další pokyny najdete v tématu Tipy pro lepší výkon v Azure AI Vyhledávač.
Optimalizace operací indexeru
Využití výpočetních prostředků bezserverového indexeru závisí na práci prováděné během každého spuštění indexeru. U zdrojů orientovaných na řádky použijte počet dokumentů zpracovaných jako ukazatel objemu úloh. U souborových zdrojů, jako jsou Azure Blob Storage a Azure Data Lake Storage Gen2, monitorujte množství zpracovaných zdrojových dat. Skutečné využití výpočetních prostředků také závisí na datových částech dokumentu, struktuře indexu, rozšiřování a dalším zpracování prováděném během spuštění.
Chcete-li snížit využití výpočetních prostředků indexeru:
Používejte detekci změn a přírůstkové indexování: Místo opakovaného indexování úplného zdroje dat zpracujte pouze nová nebo změněná data.
Plány indexeru správné velikosti: Zvolte plán, který splňuje požadavky na aktuálnost dat. Pomocí telemetrie výpočetních jednotek vyhodnoťte dopad frekvence plánování.
Snižte nepotřebný obsah dokumentu: Odeberte obsah, který není potřeba indexovat, a vylučte soubory nebo typy souborů, které nejsou potřeba.
Pečlivě určete rozsah použití dovedností obohacení: Spouštějte dovednosti pouze u polí a dokumentů, které vyžadují obohacení, a vyhněte se generování výstupů, které se v dalších krocích zpracování nepoužijí. Za zpoplatněné dovednosti mohou být účtovány samostatné transakční poplatky.
Monitorování neúspěšných a opakovaných spuštění: Indexer může využívat výpočetní výkon pro práci dokončenou dříve, než selže. Zkontrolujte historii spouštění a využití výpočetních jednotek a identifikujte opakující se selhání a vzory opakování.
Optimalizace dotazů
Návrh dotazu je primárním faktorem proměnných nákladů:
Použijte
$selectk omezení vracených polí: Tím se zmenší velikost přenášených dat a výpočetní výkon potřebný pro serializaci.GET /docs?search=test&$select=id,title,urlPoužijte
searchFieldsk omezení, kde se text vyhledává: Omezte shodu při zpracování dotazu na pole relevantní pro daný scénář. Každé další prohledávatelné pole zvyšuje práci dotazu a může zvýšit CU/h.Upřednostňujte přesnou shodu nebo dotazy na jednoduchá klíčová slova: Dotazy s přibližnou shodou, se zástupnými znaky, regulárními výrazy a s prefixem mohou vynutit rozsáhlé prohledávání indexu a spotřebovávat výrazně více CU/h. Používejte je jenom v případě, že potřebujete částečné odpovídající chování a pokud je to možné, zvolte přesné shody nebo jednodušší dotazy na klíčová slova.
Vyhledávání používejte místo hledání, pokud je to možné: Načtení dokumentu podle ID je efektivnější než spuštění vyhledávacího dotazu. Pokud znáte ID dokumentu, použijte vyhledání místo vyhledávacího dotazu. Vyhledávání jsou efektivnější, protože načítají dokument přímo podle klíče, zatímco vyhledávací dotazy vyvolávají celý kanál dotazu (parsování, procházení indexů, bodování a hodnocení), což zvyšuje náklady na výpočetní prostředky.
Vyhněte se hlubokému stránkování (
$skip): Velké$skiphodnoty zvyšují výpočetní výkon, protože modul musí zpracovat, určit skóre a zařadit výsledky, které předchází požadované stránce. Například$skip=5000vyžaduje, aby jádro zpracovalo alespoň 5 000 výsledků, které nejsou vráceny. Tato volba spotřebovává další výpočetní jednotky (CU) a může zvýšit náklady. Místo toho pomocí filtrů zúžíte výsledekseta$topomezíte počet vrácených výsledků. Správná velikost$toppro vaši aplikaci nebo uživatelské rozhraní Přestože$topnemění počet odpovídajících dokumentů, které se vyhodnocují, menší hodnota snižuje počet výsledků, které je potřeba shromáždit, seřadit a serializovat. Vyžádejte si jenom tolik výsledků, kolik vaše aplikace potřebuje, a vyhněte se stránkovacím vzorům, které vyžadují, aby modul zpracovával velký počet nepoužívaných výsledků.Minimalizovat počet faset a jejich rozsah: Požadujte pouze fasety, které se zobrazují ve vašem uživatelském rozhraní, a hodnotu každé fasety
countudržujte na co nejnižší praktické úrovni. Fasety vyžadují agregace pro každý dotaz a vysoké počty zvyšují výpočetní náklady.Slouží
search.ink filtrování: Při filtrování podle seznamu ID nebo hodnot použijtesearch.infunkci místo víceorpodmínek (napříkladid eq '1' or id eq '2'). Tento přístup je efektivnější a snižuje režijní náklady na výpočetní prostředky. Měli byste se také vyhnout označování polí s vysokou kardinalitou (tedy těch s velkým počtem jedinečných hodnot, jako jsou jedinečná ID nebo volně psané popisy) jako filtrovatelných nebo fasetovatelných, pokud to není nutné, protože to zvyšuje velikost indexu a náklady na dotazy.
Optimalizace žádostí o správu
Kromě operací dotazování a indexování zahrnuje Azure AI Vyhledávač operace správy na úrovni objektů a služeb (například načítání schémat indexů nebo statistiky služby). Tyto žádosti mají pevný poplatek za každou žádost. I když je každý požadavek levný, opakované nebo nepotřebné volání se můžou v průběhu času hromadit a zvýšit celkové využití výpočetních prostředků.
- Vyhněte se nadměrným administrativním požadavkům: Metadata, jako jsou schémata indexů, ukládejte do mezipaměti na straně klienta, namísto jejich opakovaného načítání. Například načtení schématu indexu před každou operací zápisu představuje zbytečné náklady. V bezserverovém modelu tento model přímo zvyšuje poplatky za výpočetní prostředky, zatímco ve vyhrazených službách je dopad často skrytý pevnou hodinovou fakturací.
Optimalizace nákladů na vektory
Vektorové úlohy jsou obvykle nejnákladovou komponentou při hledání cenového modelu bez serveru, protože mají vliv na výpočetní jednotky (dotazy i indexování) a úložiště (velikost vektoru na disku). Pokud chcete snížit náklady, optimalizujte způsob ukládání vektorů a jejich dotazování.
Optimalizace úložiště vektorů a schématu
Vektorová pole mohou výrazně zvýšit velikost indexu a náklady na indexování. Pomocí následujících technik můžete snížit režijní náklady na úložiště:
Pomocí komprese zmenšete velikost vektoru: Použijte kvantování, abyste snížili nároky na úložiště s minimálním dopadem na relevanci. Skalární kvantování může například snížit velikost úložiště vektorů až o 4× s minimálním dopadem na kvalitu vyhledávání.
V případě potřeby zakažte ukládání vektorů: Nastavte u vektorových polí hodnotu stored=false, pokud potřebujete pouze vektory pro hledání, ne načtení. Tím se zabrání ukládání původních vektorů v indexu, což snižuje náklady na úložiště, aniž by to ovlivnilo chování dotazů.
Pokud je to možné, použijte menší rozměry vkládání: Vyšší rozměrové vektory zvyšují náklady na úložiště i dotazy. Pro méně důležité úlohy použijte menší modely vkládání (například 384 nebo 768 dimenzí místo 1536) a snižte tak náklady.
Optimalizace provádění vektorových dotazů
Vektorové dotazy jsou náročné na výpočetní výkon, protože vyžadují výpočty podobnosti nad vysoce dimenzionálními datovými strukturami.
Používejte hybridní vyhledávání selektivně: Hybridní dotazy spouštějí vyhledávání podle klíčových slov i vektorové vyhledávání. Používejte pouze v případě, že je to nezbytné pro relevanci.
Snižte maxTextRecallSize pro hybridní dotazy: Nastavení
hybridSearch.maxTextRecallSizeurčuje, kolik výsledků seřazených podle BM25 vstupuje do Reciprocal Rank Fusion. Výchozí hodnota je 1 000 (rozsah 1 až 10 000). Spotřeba výpočetních prostředků se škáluje zhruba lineárně s touto hodnotou, takže její snížení je jedním z nejpřímějších nákladů na hybridní úlohy.Hodnoty kolem 500 často výrazně sníží výpočetní výkon s malou ztrátou relevance.
Nastavení nižší hodnoty může vést ke ztrátě shod klíčových slov, které vektorové vyhledávání přehlédne, například přesných výrazů, ID a zkratek.
Řiďte kandidáty vektorů samostatně pomocí parametru k pro každý vektorový dotaz.
Před vyrovnáním hodnoty otestujte reprezentativní dotazy a porovnejte relevanci, latenci a hlavičku
x-ms-azs-compute-units-consumed.Použijte filtry před vektorovými dotazy: Zužte kandidátské množiny před vektorové vyhledávání, abyste snížili množství zpracovaných dat. Podívejte se, jak funguje filtrování ve vektorových dotazech.
Snížení nákladů minimalizací využití
Bezserverový model se účtuje jenom za spotřebované prostředky. Pokud neexistují žádné požadavky, využití výpočetních prostředků odpovídajícím způsobem klesne.
Minimalizace nákladů na využití:
- Spouštět dotazy pouze v případě potřeby.
- Vyhněte se redundantním nebo příliš častým požadavkům.
- Monitorujte využití a vylaďte úlohy na základě poptávky.
Tip
Stejný dotaz může mít různé profily latence a CU v závislosti na tom, jestli je služba teplá nebo studená. Po uplynutí období bez provozu čtení nebo zápisu se využití výpočetních prostředků v cenovém modelu bez serveru sníží na nulu. Další požadavek může mít vyšší latenci a spotřebovat více CU, než se datové cesty inicializují. Větší indexy se obvykle zahřívají déle než menší indexy, takže dopady studeného startu jsou často výraznější u větších služeb.
Optimalizace nákladů na úložiště
Úložiště se účtuje za GB za měsíc na základě velikosti indexu na disku, která může překročit nezpracovanou velikost dat. Snížení nákladů na úložiště:
- Odeberte nepoužívané indexy.
- Minimalizujte uložená pole.
- Schémata návrhu s ohledem na režii úložiště
- Používejte návrhy selektivně, protože můžou výrazně zvětšit velikost úložiště.
Techniky specifické pro vektory (komprese, vyřezávání a nastavení úložiště) najdete v tématu Optimalizace pro ukládání a zpracování vektorů.
Další pokyny k kompromisům výkonu úložiště a dotazů najdete v tématu Tipy pro lepší výkon v Azure AI Vyhledávač.