Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Poznámka
Azure AI Vyhledávač je k dispozici prostřednictvím portálu Azure, rozhraní REST API a Sady Azure SDK. Podporuje také Foundry IQ, spravovanou znalostní vrstvu, která transformuje podnikový obsah na opakovaně použitelné znalostní báze s podporou oprávnění pro agenty na portálu Microsoft Foundry.
Důležité
Na funkce, možnosti nebo vlastnosti označené jako (Preview) se nevztahuje smlouva o úrovni služeb, nejsou doporučené pro produkční úlohy a mohou se změnit nebo být omezeny dříve, než budou obecně k dispozici. Podmínky Azure AI Vyhledávač Preview platí pro všechny funkce ve verzi Preview, ať už jsou samostatné nebo součástí obecně dostupné funkce.
V Azure AI Vyhledávač můžete pomocí výrazu filtr přidat kritéria zahrnutí nebo vyloučení do dotazu vector. Můžete také zadat režim filtrování, který filtr použije:
- Před provedením dotazu se označuje jako předfiltrování.
- Po spuštění dotazu se označuje jako postfiltering.
- Po zjištění globálních nejlepších
kvýsledků je proces označován jako strict postfiltering (náhled).
Tento článek používá REST pro ilustraci. Ukázky kódu v jiných jazycích a ucelených řešeních, která obsahují vektorové dotazy, najdete v úložišti azure-search-vector-samples GitHub.
K dotazování obsahu vektoru můžete také použít Explorer na portálu Azure. V zobrazení JSON můžete přidat filtry a zadat režim filtru.
Jak funguje filtrování ve vektorových dotazech
Azure AI Vyhledávač používá pro vyhledávání přibližného nejbližšího souseda (ANN) algoritmus Hierarchical Navigable Small World (HNSW), který uchovává grafy HNSW na více shardech. Každý fragment obsahuje část celého indexu.
Filtry se vztahují na filterablenevectorová pole, ať už řetězec nebo číselná, aby zahrnovaly nebo vyloučily vyhledávací dokumenty na základě kritérií filtru. Vektorová pole nejsou filtrovatelná, ale můžete použít filtry u jiných polí ve stejném indexu, abyste zúžili dokumenty, které se považují za vektorové vyhledávání. Pokud index nemá vhodná textová nebo číselná pole, zkontrolujte metadata dokumentu, která mohou pomoci s filtrováním, například vlastnosti LastModified nebo CreatedBy.
Parametr vectorFilterMode řídí, kde se operace filtrování použijí během fází hledání, což ovlivňuje filtrování výsledků na podmnožinu položek (například podle kategorie, značky nebo jiných atributů) a ovlivňuje latenci, úplnost a propustnost. Existují tři režimy:
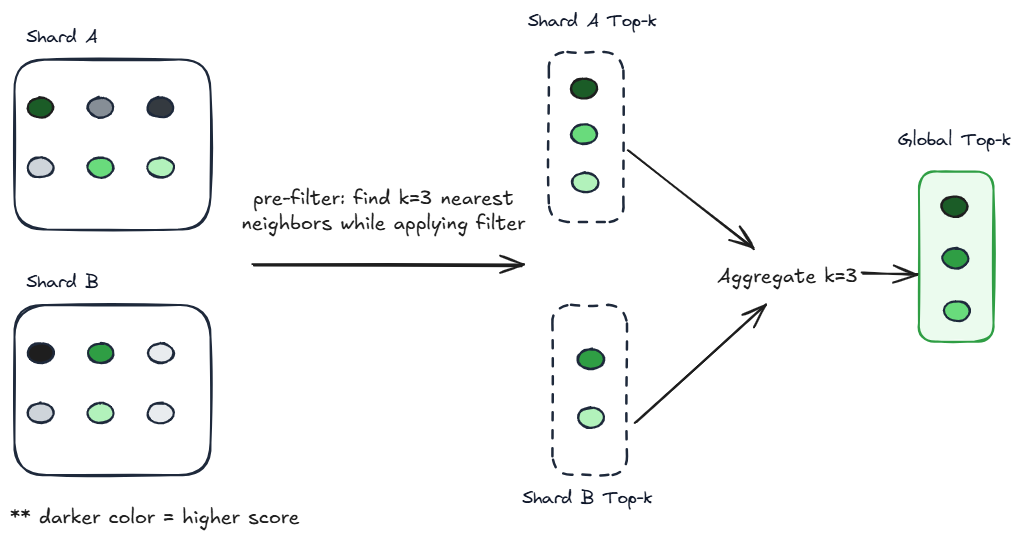
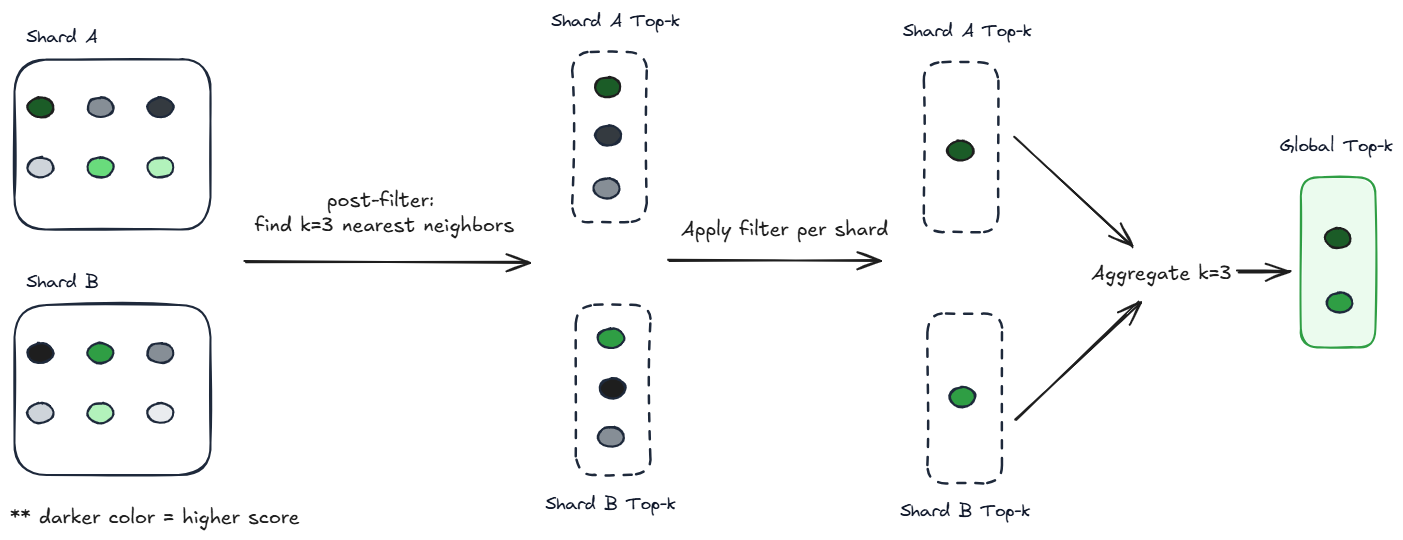
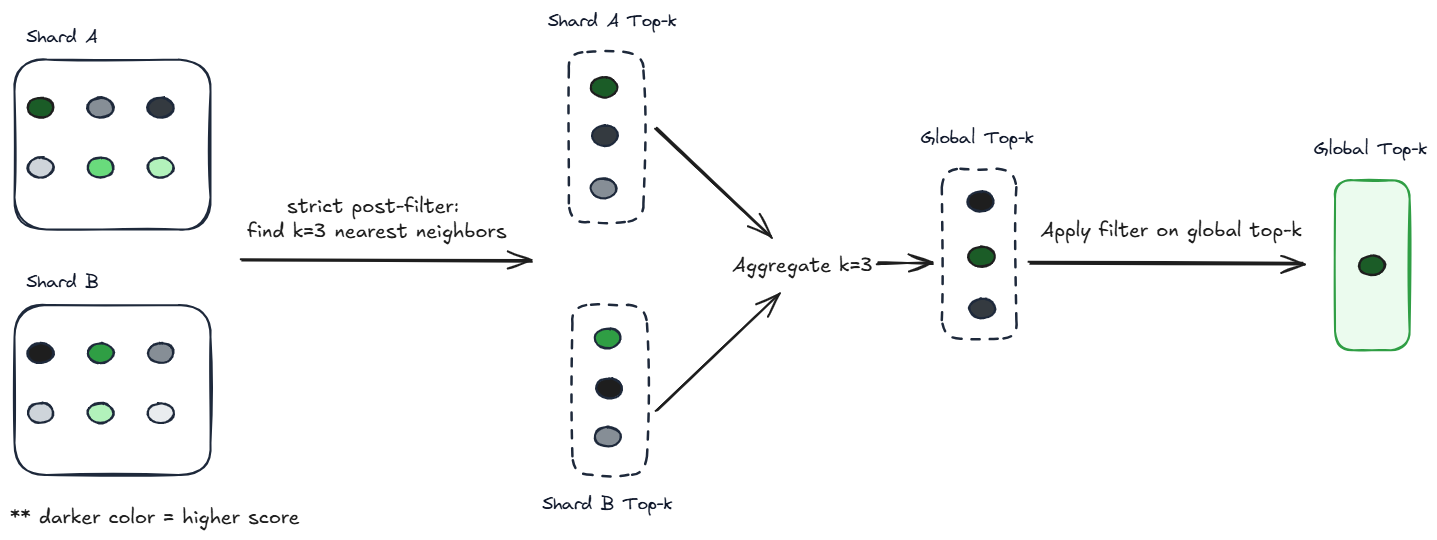
preFilterpoužije filtr během procházení HNSW na každém fragmentu. Tento režim maximalizuje zapamatování, ale může procházet více částí grafu, což zvyšuje zátěž procesoru a zpoždění pro velmi selektivní filtry.postFilterspouští procházení a filtrování HNSW na jednotlivých shardech nezávisle, protíná výsledky na úrovni shardů a pak agreguje nejlepšíkz každého shardu do globální nejlepšík. Tento režim může vytvořit falešně negativní hodnoty pro vysoce selektivní filtry nebo malékhodnoty.strictPostFilter(preview) vyhledá nefiltrovaný globální topkpřed použitím filtru. Tento režim má nejvyšší riziko vrácení falešně negativních výsledků pro vysoce selektivní filtry a malékhodnoty.
Další informace o těchto režimech naleznete v tématu Nastavení režimu filtru.
Definování filtru
Filtry určují rozsah vektorových dotazů a jsou definovány pomocí Documents - Search Post (REST API). Pokud nechcete použít funkci Preview, použijte k formulování požadavku nejnovější stabilní verzi rozhraní REST API vyhledávací služby .
Toto rozhraní REST API poskytuje:
-
filterpro kritéria. -
vectorFilterModeurčit, kdy se filtr použije během vektorového dotazu. Podporované režimy najdete v tématu Nastavení režimu filtru.
POST https://{search-endpoint}/indexes/{index-name}/docs/search?api-version={api-version}
Content-Type: application/json
api-key: {admin-api-key}

{
    "count": true,
    "select": "title, content, category",
    "filter": "category eq 'Databases'",
    "vectorFilterMode": "preFilter",
    "vectorQueries": [
        {
            "kind": "vector",
            "vector": [
                -0.009154141,
                0.018708462,
                . . . // Trimmed for readability
                -0.02178128,
                -0.00086512347
            ],
            "fields": "contentVector",
            "k": 50
        }
    ]
}
V tomto příkladu vektor vkládání cílí na contentVector pole a kritéria filtru platí pro categoryfiltrovatelné textové pole. Vzhledem k tomu, že se režim preFilter používá, je filtr aplikován před spuštěním dotazu vyhledávačem, takže během vektorového vyhledávání jsou zvažovány pouze dokumenty v kategorii Databases.
Nastavení režimu filtru
Parametr vectorFilterMode určuje, kdy a jak se filtr použije vzhledem ke spuštění vektorového dotazu. Můžete použít následující režimy:
-
preFilter(doporučeno) postFilter-
strictPostFilter(Preview)
Poznámka
preFilter je výchozí hodnota pro indexy vytvořené přibližně po 15. říjnu 2023. U indexů vytvořených před tímto datem postFilter je výchozí hodnota. Pokud chcete použít preFilter a další pokročilé vektorové funkce, jako je komprese vektorů, musíte znovu vytvořit index.
Kompatibilitu můžete otestovat odesláním vektorového dotazu s "vectorFilterMode": "preFilter"2023-10-01-preview verzí rozhraní REST API nebo novější. Pokud dotaz selže, index nepodporuje preFilter.
Předfiltrování použije filtry před spuštěním dotazu, což snižuje kandidátskou sadu pro algoritmus vektorového vyhledávání. Z této filtrované sady se pak vyberou nejlepšík výsledky.
Ve vektorovém dotazu je výchozí režim, preFilter protože upřednostňuje úplnost a kvalitu před latencí.
Jak tento režim funguje
Na každém shardu použijte predikát filtru během procházení HNSW, rozšiřujte graf, dokud nejsou nalezeni kandidáti.
Vygenerujte předem filtrované místní nejlepší
kvýsledky pro každý fragment.Agregujte filtrované výsledky do globální sady výsledků nejvyšší úrovně
k.
Účinek tohoto režimu
Procházení rozšiřuje vyhledávací prostor, aby nalezlo více filtrovaných kandidátů, zejména pokud je filtr selektivní. Výsledkem jsou nejpodobnější výsledkyk ve všech shardech. Každý horizontální oddíl identifikuje k výsledky, které splňují predikát filtru.
Předfiltrování zaručuje, že pokud výsledky existují v indexu, k se vrátí. U vysoce selektivních filtrů to může způsobit, že bude procházen významný počet grafů, což zvýší výpočetní náklady a latenci a zároveň sníží propustnost. Pokud je filtr vysoce selektivní (má velmi málo shod), zvažte použití exhaustive: true k provádění vyčerpávajícího vyhledávání.
Srovnávací tabulka
| Režim | Odvolání (filtrované výsledky) | Výpočetní náklady | Riziko falešně negativních výsledků | Kdy použít |
|---|---|---|---|---|
preFilter |
Velmi vysoká | Vyšší (zvyšuje selektivitu filtru a složitost) | Bez rizika |
Doporučené výchozí nastavení pro všechny scénáře, zejména pokud je relevantnost kritická (citlivé/kontextové domény vyhledávání), při použití selektivních filtrů nebo při použití malých k. |
postFilter |
Střední až vysoká (s rostoucí selektivitou filtru) | Podobá se nefiltrovanému stavu, ale zvyšuje se s rostoucí složitostí filtru. | Střední (mohou chybět shody na fragment) | Možnost pro filtry, které nejsou příliš selektivní a pro dotazy vyšší.k |
strictPostFilter |
Nejnižší (snižuje se nejrychleji s volbou selektivity filtru) | Podobně jako nefiltrované | Nejvyšší (může vrátit nulové výsledky pro selektivní filtry nebo malé k) |
Možnost fasetových vyhledávacích aplikací, kde zobrazování více výsledků po aplikaci filtru ovlivňuje uživatelskou zkušenost více než riziko falešně negativních výsledků. Nepoužívejte s malými k. |
Srovnávací testování předfiltrování a následného filtrování
Důležité
Tato část se týká předfiltrování a následného filtrování, nikoli striktního pofiltrování.
Abychom pochopili podmínky, za kterých jeden režim filtru funguje lépe než druhý, spustili jsme řadu testů pro vyhodnocení výsledků dotazu v malých, středních a velkých indexech.
- Malé (100 000 dokumentů, index 2,5 GB, 1 536 dimenzí)
- Střední (1 milion dokumentů, index 25 GB, 1 536 dimenzí)
- Velké (1 miliarda dokumentů, index 1,9 TB, 96 dimenzí)
Pro malé a střední úlohy jsme použili službu Standard 2 (S2) s jedním oddílem a jednou replikou. Pro velké úlohy jsme použili službu Standard 3 (S3) s 12 oddíly a jednou replikou.
Indexy měly identickou konstrukci: jedno klíčové pole, jedno vektorové pole, jedno textové pole a jedno číselné filtrovatelné pole. Následující index je definován pomocí 2023-11-01 syntaxe.
def get_index_schema(self, index_name, dimensions):
    return {
        "name": index_name,
        "fields": [
            {"name": "id", "type": "Edm.String", "key": True, "searchable": True},
            {"name": "content_vector", "type": "Collection(Edm.Single)", "dimensions": dimensions,
              "searchable": True, "retrievable": True, "filterable": False, "facetable": False, "sortable": False,
              "vectorSearchProfile": "defaulthnsw"},
            {"name": "text", "type": "Edm.String", "searchable": True, "filterable": False, "retrievable": True,
              "sortable": False, "facetable": False},
            {"name": "score", "type": "Edm.Double", "searchable": False, "filterable": True,
              "retrievable": True, "sortable": True, "facetable": True}
        ],
      "vectorSearch": {
        "algorithms": [
            {
              "name": "defaulthnsw",
              "kind": "hnsw",
              "hnswParameters": { "metric": "euclidean" }
            }
          ],
          "profiles": [
            {
              "name": "defaulthnsw",
              "algorithm": "defaulthnsw"
            }
        ]
      }
    }
Ve dotazech jsme použili identický filtr pro operace předfiltrování i postfiltrování. Pomocí jednoduchého filtru jsme zajistili, že varianty výkonu byly způsobené režimem filtrování, nikoli složitostí filtru.
Výsledky se měří v dotazech za sekundu (QPS).
Klíčové poznatky
Předfiltrování je téměř vždy pomalejší než následné filtrování, s výjimkou malých indexů, kde je výkon přibližně stejný.
U větších datových sadách je předfiltrování řádově pomalejší.
Proč je předfiltrování výchozí, když je téměř vždy pomalejší? Předfiltrování zaručuje, že
kse výsledky vrátí, pokud existují v indexu, kde sklon upřednostňuje úplnost a přesnost nad rychlostí.Postfiltering použijte v následujících případech:
Upřednostněte rychlost před výběrem (postfiltrace může vrátit méně než
kvýsledků).Používejte filtry, které nejsou příliš selektivní.
Aby indexy měly dostatečnou velikost a výkon předfiltrování byl nepřijatelný.
Podrobnosti
Datová sada s 100 000 vektory o 1 536 rozměrech:
Při filtrování více než 30% datové sady byly předběžné filtrování a pofiltrování srovnatelné.
Při filtrování menší než 0,1% datové sady bylo předfiltrování přibližně 50% pomalejší než následné filtrování.
Datová sada s 1 miliony vektorů s 1 536 dimenzemi:
Při filtrování více než 30% datové sady bylo předfiltrování přibližně 30% pomalejší.
Při filtrování menší než 2% datové sady bylo předfiltrování asi sedmkrát pomalejší.
Datová sada s 1 miliardami vektorů s 96 dimenzemi:
Při filtrování více než 5% datové sady bylo předfiltrování přibližně 50% pomalejší.
Při filtrování méně než 10% datové sady bylo předfiltrování asi sedmkrát pomalejší.
Následující graf ukazuje předfiltrovaný relativní QPS vypočítaný jako předfiltrovaný QPS dělený postfilterem QPS.
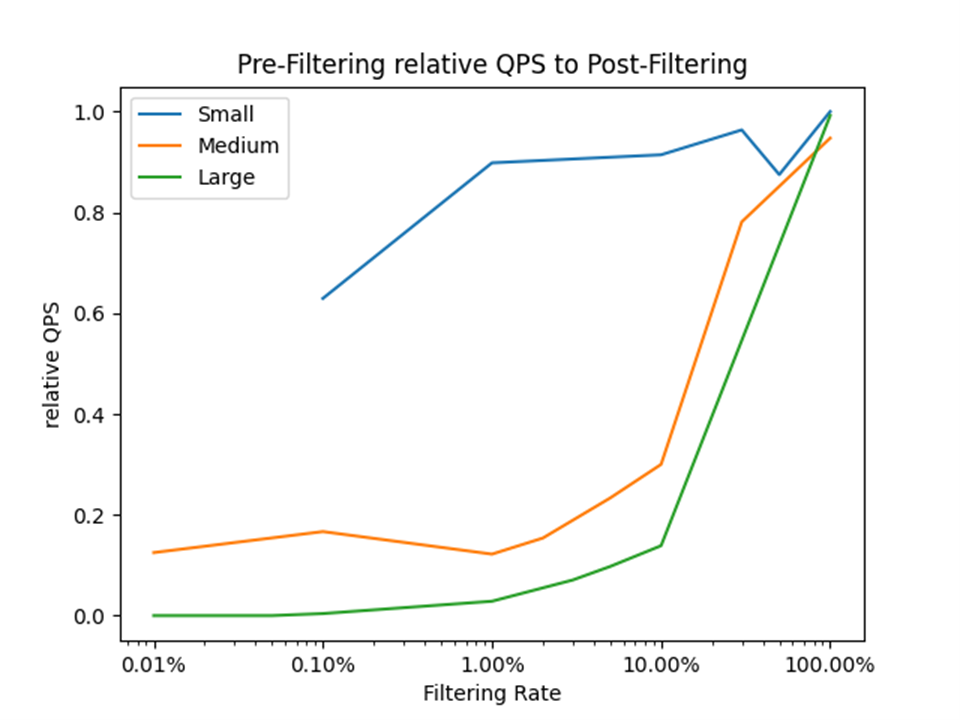
Svislá osa představuje relativní výkon předfiltrování v porovnání s postfilteringem vyjádřeným poměrem QPS (dotazy za sekundu). Příklad:
- Hodnota
0.0znamená, že předfiltrování je o 100 % pomalejší než postfiltrování. - Hodnota
0.5znamená, že předfiltrování je o 50 % pomalejší. - Hodnota
1.0znamená, že předfiltrování a postfiltrování jsou ekvivalentní.
Vodorovná osa představuje míru filtrování nebo procento kandidátských dokumentů po použití filtru. Například míra 1.00% znamená, že kritéria filtru vybrali jedno procento vyhledávacího korpusu.