Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Poznámka:
Azure AI Vyhledávač je k dispozici prostřednictvím portálu Azure, rozhraní REST API a Sady Azure SDK. Podporuje také Foundry IQ, spravovanou znalostní vrstvu, která transformuje podnikový obsah na opakovaně použitelné znalostní báze s podporou oprávnění pro agenty na portálu Microsoft Foundry.
Pro každé vektorové pole Azure AI Vyhledávač vytvoří interní vektorový index pomocí parametrů algoritmu zadaných v poli. Vzhledem k tomu, že Azure AI Vyhledávač ukládá kvóty na velikost vektorového indexu, měli byste vědět, jak odhadnout a monitorovat velikost vektoru, abyste měli jistotu, že zůstanete pod limity.
Fyzická datová struktura indexu vyhledávání interně zahrnuje:
- Nezpracovaný obsah (používá se k načítání vzorů vyžadujících nezpracovaný obsah)
- Invertované indexy (používané pro prohledávatelná textová pole)
- Vektorové indexy (používané pro prohledávatelná vektorová pole)
Tento článek vysvětluje limity pro interní vektorové indexy, které podporují každé z vašich vektorových polí.
Návod
Techniky optimalizace vektorů jsou obecně dostupné. Využijte funkce, jako jsou úzké datové typy, skalární a binární kvantování a eliminace redundantního úložiště, abyste snížili kvótu vektorů a spotřebu kvót úložiště.
Klíčové body týkající se velikosti kvót a vektorových indexů
Velikost vektorových indexů se měří v bajtech.
Celkové úložiště vaší služby obsahuje všechny soubory vektorového indexu. Azure AI Vyhledávač udržuje různé kopie souborů vektorového indexu pro různé účely. Nabízíme další možnosti, jak snížit režijní náklady na úložiště vektorových indexů odstraněním některých těchto kopií.
Kvóty vektorů se u vyhledávací služby vynucují jako celek na každou část. Pokud přidáte oddíly, zvýší se také kvóta vektorů. Kvóty vektorů pro jednotlivé oddíly jsou u novějších služeb vyšší. Další informace naleznete v tématu Omezení velikosti vektorových indexů.
Ne všechny algoritmy využívají kvótu velikosti vektorových indexů. Kvóty vektorů jsou vytvořeny na základě požadavků na paměť při hledání přibližného nejbližšího souseda (ANN). Vektorová pole vytvořená pomocí algoritmu Hierarchical Navigable Small World (HNSW) se musí při provádění dotazů nacházet v paměti kvůli povaze procházení grafů založených na náhodném přístupu. Vektorová pole využívající vyčerpávající algoritmus K-Nearest Neighbors (KNN) se načítají do paměti dynamicky na stránkách během provádění dotazu, a proto nevyužívají kvótu vektorů.
Zkontrolujte velikost a počet oddílů
Pokud si nejste jistí, jaké jsou limity vyhledávací služby, můžete získat informace dvěma způsoby:
Na webu Azure Portal na stránce Přehled vyhledávací služby se na kartě Vlastnosti i na kartě Využití zobrazují velikost oddílu a úložiště a také velikost vektorové kvóty a vektorového indexu.
Na portálu Azure na stránce Škálování můžeme zkontrolovat počet a velikost oddílů.
Limit vektoru se liší v závislosti na datu vytvoření služby.
Kontrola velikosti vektorových indexů
Požadavek na vektorové metriky je operace roviny dat. Pomocí webu Azure Portal, rozhraní REST API nebo sad Azure SDK můžete získat vektorové využití na úrovni služby prostřednictvím statistik služby a pro jednotlivé indexy.
Velikost vektoru pro index
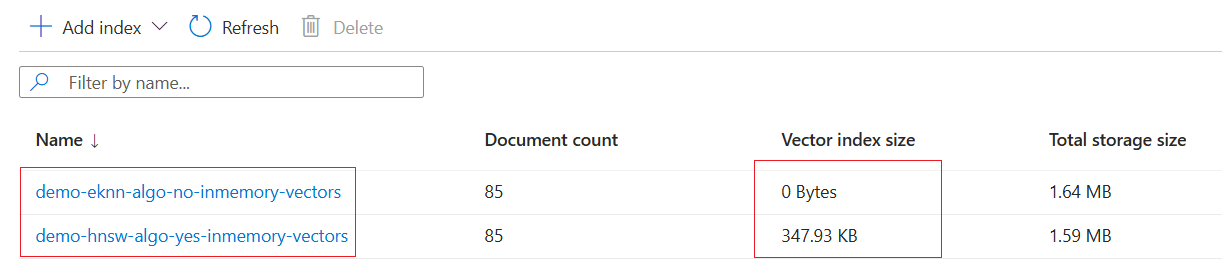
Pokud chcete získat velikost vektorového indexu pro každý index, vyberte Správa vyhledávání>Indexy a zobrazte seznam indexů, počet dokumentů, velikost vektorových indexů v paměti a celkovou velikost indexu uloženou na disku.
Vzpomeňte si, že kvóta vektorů je založená na omezení paměti. U vektorových indexů vytvořených pomocí algoritmu HNSW se všechny prohledávatelné vektorové indexy trvale načtou do paměti. U indexů vytvořených pomocí vyčerpávajícího algoritmu KNN se vektorové indexy načítají do bloků dat postupně během doby dotazu. Neexistuje žádný požadavek na rezidenci paměti pro vyčerpávající indexy KNN. Životnost načtených stránek v paměti se podobá vyhledávání textu a neexistují žádné další metriky platné pro vyčerpávající indexy KNN kromě celkového úložiště.
Následující snímek obrazovky ukazuje dvě verze stejného vektorového indexu. Jedna verze se vytvoří pomocí algoritmu HNSW, kde je vektorový graf rezidentní paměti. Jiná verze se vytvoří pomocí vyčerpávajícího algoritmu KNN. Díky vyčerpávajícímu KNN neexistuje žádný specializovaný vektorový index v paměti, takže portál zobrazuje velikost vektorového indexu o velikosti 0 MB. Tyto vektory stále existují a započítávají se do celkové velikosti úložiště, ale nezabírají prostředky v paměti, které metrika velikosti vektorového indexu sleduje.
Velikost vektoru pro službu
Pokud chcete získat velikost vektorového indexu pro vyhledávací službu jako celek, vyberte kartu Využití stránky Přehled. Stránky portálu se aktualizují každých několik minut, takže pokud jste index nedávno aktualizovali, chvíli počkejte, než zkontrolujete výsledky.
Následující snímek obrazovky je pro starší vyhledávací službu Standard 1 (S1) nakonfigurovanou pro jeden oddíl a jednu repliku.
Kvóta úložiště je omezení úložiště a zahrnuje všechny indexy (vektorové a nevektorové) ve vyhledávací službě.
Kvóta velikosti vektorového indexu je omezení paměti. Je to množství paměti potřebné k načtení všech interních vektorových indexů vytvořených pro každé vektorové pole ve vyhledávací službě.
Snímek obrazovky ukazuje, že indexy (vektor a nevector) spotřebovávají téměř 460 megabajtů dostupného diskového úložiště. Vektorové indexy spotřebovávají na úrovni služby téměř 93 megabajtů paměti.
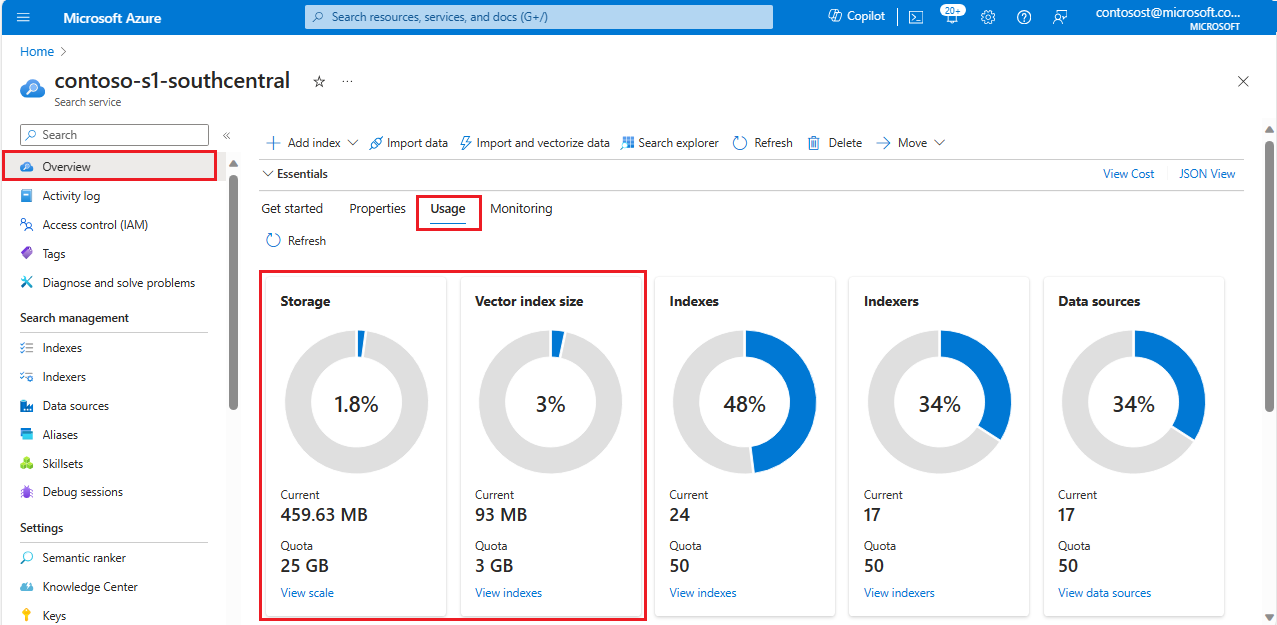
Kvóty pro velikost úložiště a velikost indexu vektoru se zvětšují nebo zmenšují při přidávání nebo odebírání oddílů. Pokud změníte počet oddílů, zobrazí se na dlaždici odpovídající změna v úložišti a kvótě vektorů.
Poznámka:
Na disku nemají vektorové indexy velikost 93 megabajtů. Vektorové indexy na disku zabírají přibližně třikrát více místa než vektorové indexy v paměti. Podrobnosti najdete v tématu Vliv vektorových polí na diskové úložiště .
Faktory ovlivňující velikost vektorových indexů
Existují tři hlavní komponenty, které ovlivňují velikost interního vektorového indexu:
- Nezpracovaná velikost dat
- Přídavné zatížení způsobené vybraným algoritmem
- Režie spojené s odstraněním nebo aktualizací dokumentů v indexu
Nezpracovaná velikost dat
Každý vektor je obvykle pole čísel v pohyblivé řádové čárce s jednoduchou přesností v poli typu Collection(Edm.Single).
Vektorové datové struktury vyžadují úložiště reprezentované v následujícím výpočtu jako "nezpracovaná velikost" vašich dat. Pomocí této nezpracované velikosti můžete odhadnout požadavky na velikost vektorového indexu vektorových polí.
Rozměrnost jednoho vektoru určuje velikost úložiště. Vynásobte velikost jednoho vektoru počtem dokumentů obsahujících toto vektorové pole, abyste získali nezpracovanou velikost:
raw size = (number of documents) * (dimensions of vector field) * (size of data type)
| Datový typ EDM | Velikost datového typu |
|---|---|
Collection(Edm.Single) |
4 bajty |
Collection(Edm.Half) |
2 bajty |
Collection(Edm.Int16) |
2 bajty |
Collection(Edm.SByte) |
1 bajt |
Paměťová režie vybraného algoritmu
Každý algoritmus ANN generuje v paměti další datové struktury, které umožňují efektivní vyhledávání. Tyto struktury spotřebovávají více místa v paměti.
U algoritmu HNSW se režie paměti pohybuje mezi 1% a 20% pro nekomprimované vektory float32 (Edm.Single).
S nárůstem rozměrnosti se snižuje procento režie paměti. K tomu dochází, protože hrubá velikost vektorů se zvětšuje, zatímco ostatní datové struktury ukládající informace o propojení grafu zůstávají pevné velikosti pro danou hodnotu m. V důsledku toho se relativní dopad těchto dodatečných datových struktur sníží vzhledem k celkové velikosti vektoru.
Režie paměti se zvyšuje u větších hodnot parametru mHNSW, který určuje počet vytvořených obousměrných odkazů pro každý nový vektor během sestavování indexu. K tomu dochází, protože každý odkaz přispívá přibližně 8 až 10 bajtů na dokument a celkové režijní náklady se úměrně škálují s m.
Následující tabulka shrnuje procentuální režijní náklady zjištěné v interních testech pro nekomprimovaná vektorová pole:
| Dimenze | Parametr HNSW (m) | Procento režijních nákladů |
|---|---|---|
| 96 | 4 | 20 % |
| 200 | 4 | 8 % |
| 768 | 4 | 2 % |
| 1536 | 4 | 1 % |
| 3072 | 4 | 0,5 % |
Tyto výsledky ukazují vztah mezi dimenzemi, parametrem mHNSW a režií paměti pro algoritmus HNSW.
U vektorových polí, která používají techniky komprese, jako je skalární nebo binární kvantování, se zdá, že režijní procento spotřebuje větší procento celkové velikosti indexu vektoru. S tím, jak se velikost dat zmenšuje, je relativní dopad datových struktur s pevnou velikostí, které se používají k ukládání informací o připojení grafu, významnější.
Režie spojené s odstraněním nebo aktualizací dokumentů v indexu
Pokud je dokument s vektorovým polem odstraněn nebo aktualizován (aktualizace jsou interně reprezentovány jako operace odstranění a vložení), podkladový dokument se označí jako odstraněný a přeskočí během dalších dotazů. Jakmile jsou indexovány nové dokumenty a interní vektorový index se zvětšuje, systém odstraní tyto smazané dokumenty a uvolní obsazené prostředky. To znamená, že pravděpodobně uvidíte prodlevu mezi odstraněním dokumentů a uvolněním podkladových prostředků.
Označujeme to jako poměr odstraněných dokumentů. Vzhledem k tomu, že poměr odstraněných dokumentů závisí na charakteristikách indexování vaší služby, neexistuje žádný univerzální heuristický odhad tohoto parametru a neexistuje žádné rozhraní API ani skript, které vrací poměr, který se pro vaši službu projeví. Vidíme, že polovina našich zákazníků má podíl smazaných dokumentů menší než 10 %. Pokud máte tendenci provádět odstranění nebo aktualizace s vysokou frekvencí, můžete pozorovat vyšší poměr odstraněných dokumentů.
To je další faktor ovlivňující velikost vektorového indexu. Bohužel nemáme mechanismus pro zobrazení aktuálního poměru odstraněných dokumentů.
Odhad celkové velikosti dat v paměti
Při zohlednění výše popsaných faktorů použijte k odhadu celkové velikosti vektorového indexu následující výpočet:
(raw_size) * (1 + algorithm_overhead (in percent)) * (1 + deleted_docs_ratio (in percent))
Pokud chcete například vypočítat raw_size, předpokládejme, že používáte oblíbený model Azure OpenAI s text-embedding-ada-002 1 536 dimenzemi. To znamená, že jeden dokument by spotřeboval 1 536 Edm.Single (float) nebo 6 144 bajtů, protože každý Edm.Single z nich je 4 bajty. 1 000 dokumentů s jedním, 1 536rozměrným vektorovým polem by spotřebovalo celkem 1000 dokumentů x 1536 float/doc = 1 536 000 float nebo 6 144 000 bajtů.
Pokud máte více vektorových polí, musíte tento výpočet provést pro každé vektorové pole v indexu a přidat je všechny dohromady. Například 1 000 dokumentů se dvěma 1 536rozměrnými vektorovými poli, spotřebuje 1000 dokumentů x 2 pole x 1536 floats/doc x 4 bajty/float = 12 288 000 bajtů.
Pokud chcete získat velikost vektorového indexu, vynásobte tuto raw_size režií algoritmu a odstraněným poměrem dokumentů. Pokud je režie vašeho algoritmu pro zvolené parametry HNSW 10 % a poměr odstraněných dokumentů je 10 %, získáme: 6.144 MB * (1 + 0.10) * (1 + 0.10) = 7.434 MB.
Vliv vektorových polí na diskové úložiště
Většina tohoto článku obsahuje informace o velikosti vektorů v paměti. Informace o režii úložiště vektorových indexů naleznete v tématu Vyloučení volitelných vektorových instancí z úložiště.