Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Poznámka
Azure AI Vyhledávač je k dispozici prostřednictvím portálu Azure, rozhraní REST API a Sady Azure SDK. Podporuje také Foundry IQ, spravovanou znalostní vrstvu, která transformuje podnikový obsah na opakovaně použitelné znalostní báze s podporou oprávnění pro agenty na portálu Microsoft Foundry.
Tento článek je kolekce tipů a osvědčených postupů pro zvýšení výkonu dotazů a indexování pro vyhledávání klíčových slov. Znalost faktorů, které mají největší pravděpodobnost vliv na výkon vyhledávání, vám může pomoct vyhnout se neektivosti a využít vyhledávací službu na maximum. Mezi klíčové faktory patří:
- Složení indexu (schéma a velikost)
- Návrh dotazu
- Kapacita služby (vrstva a počet replik a oddílů)
Poznámka
Hledáte strategie pro indexování velkých objemů? Viz Indexování velkých datových sad ve službě Azure AI Vyhledávač.
Velikost a schéma indexu
Dotazy běží rychleji na menších indexech. Je to částečně funkce menšího počtu polí ke kontrole, ale je to také kvůli tomu, jak systém ukládá obsah do mezipaměti pro budoucí dotazy. Po prvním dotazu zůstane některý obsah v paměti, kde je prohledáván efektivněji. Vzhledem k tomu, že velikost indexu v průběhu času roste, jedním z osvědčených postupů je pravidelné opakování složení indexů, jak schémata, tak dokumenty, aby se vyhledaly příležitosti ke snížení obsahu. Pokud je ale index správně velký, jedinou další kalibrací, kterou můžete provést, je zvýšit kapacitu upgradem služby, přidáním replik nebo přepnutím na vyšší cenovou úroveň. Část Tip: Přepnutí na úroveň Standard S2 popisuje rozhodnutí mezi škálováním nahoru a škálováním do šířky.
Složitost schématu může také nepříznivě ovlivnit výkon indexování a dotazů. Nadměrné přisuzování polí vytváří omezení a stanovuje požadavky na zpracování. Indexování a dotazování složitých typů trvá déle. V dalších několika částech se seznámíte s každou podmínkou.
Tip: Přisuzovat pole selektivně
Běžnou chybou, kterou správci a vývojáři dělají při vytváření indexu vyhledávání, je výběr všech dostupných vlastností pro pole, a ne jen výběru potřebných vlastností. Pokud například pole nemusí být prohledávatelné fulltextově, při nastavování prohledávatelného atributu toto pole přeskočte.
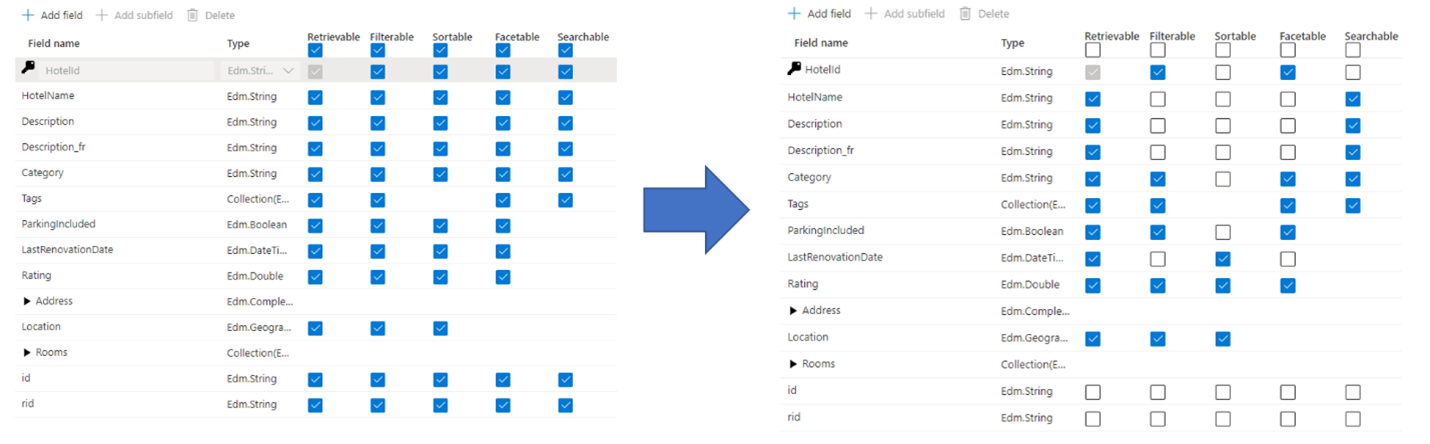
Podpora filtrů, omezujících znaků a řazení může násobit požadavky na úložiště. Pokud přidáte nástroje návrhů, požadavky na úložiště se ještě více zvýší. Obrázek o dopadu atributů na úložiště najdete v tématu Atributy a velikost indexu.
Shrnutí, důsledky nadměrného přisuzování zahrnují:
Snížení výkonu indexování kvůli nadbytečné práci potřebné ke zpracování obsahu v poli a jeho následnému uložení do invertovaného indexu vyhledávání (nastavte atribut "prohledávatelný" pouze u polí, která obsahují prohledávatelný obsah).
Vytvoří větší plochu, kterou každý dotaz musí pokrýt. Všechna pole označená jako prohledávatelná se prohledávají v fulltextovém vyhledávání.
Zvyšuje provozní náklady kvůli dodatečnému úložišti. Filtrování a řazení vyžaduje další místo pro ukládání původních (neanalyzovaných) řetězců. Vyhněte se nastavení filtrování nebo řazení u polí, která je nepotřebují.
V mnoha případech přemíra přisouzení omezuje možnosti pole. Pokud je například pole tabulkovatelné, filtrovatelné a prohledávatelné, můžete do pole uložit pouze 16 kB textu, zatímco prohledávatelné pole může obsahovat až 16 MB textu.
Poznámka
Poznámka
Vyhněte se nepotřebným přisuzování polí, ale neodstraňujte funkce, které jsou pro vyhledávání nezbytné. Filtry a omezující vlastnosti jsou často základními funkcemi a při filtrování se obvykle k vytváření seřazených výsledků vyžaduje řazení. Používejte atributy záměrně, pouze pokud podporují skutečné požadavky na dotazy nebo uživatelské rozhraní.
Tip: Zvažte alternativy ke složitým typům
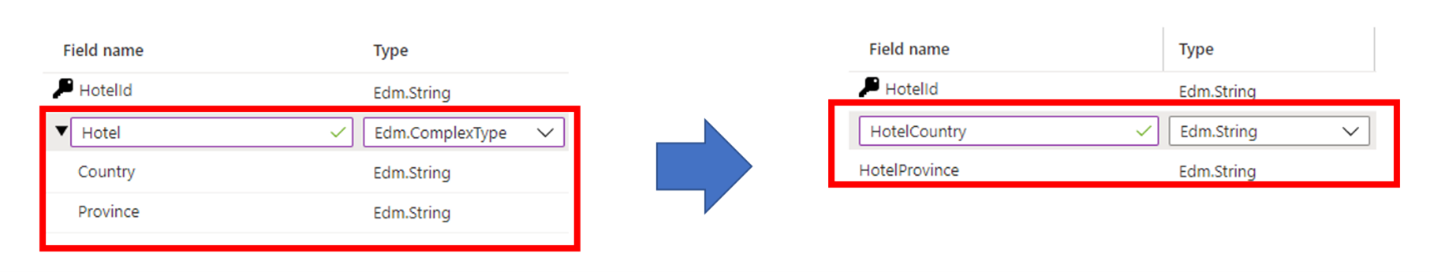
Složité datové typy jsou užitečné v případě, že data mají složitou vnořenou strukturu, například elementy nadřazené-podřízené nalezené v dokumentech JSON. Nevýhodou složitých typů jsou dodatečné požadavky na úložiště a další prostředky potřebné k indexování obsahu v porovnání s nesložitým datovým typem.
V některých případech se můžete těmto kompromisům vyhnout tím, že namapujete složitou datovou strukturu na jednodušší typ pole, například kolekci. Alternativně můžete zvolit zplošťování hierarchie polí do jednotlivých polí kořenové úrovně.
Návrh dotazu
Složení a složitost dotazů jsou jedním z nejdůležitějších faktorů výkonu a optimalizace dotazů může výrazně zlepšit výkon. Při navrhování dotazů se zamyslete nad následujícími body:
Počet prohledávatelných polí Každé další prohledávatelné pole znamená více práce pro vyhledávací službu. Pole, která se prohledávají v době dotazu, můžete omezit pomocí parametru "searchFields". Nejlepší je zadat pouze pole, která vás zajímají, aby se zlepšil výkon.
Množství vrácených dat Načítání velkého množství obsahu může zpomalit dotazy. Při strukturování dotazu vrátíte pouze ta pole, která potřebujete k vykreslení stránky výsledků, a poté načtete zbývající pole pomocí Lookup API, jakmile uživatel vybere shodu.
Použití částečného hledání termínůČástečné hledání termínů, jako je vyhledávání předpon, přibližné vyhledávání a vyhledávání regulárních výrazů, jsou výpočetně dražší než typické vyhledávání klíčových slov, protože k vytvoření výsledků vyžadují úplné prohledávání indexu.
Počet facet Přidání facety k dotazům vyžaduje pro každý dotaz agregace. Žádost o vyšší 'count' pro facetu také znamená další práci pro službu. Obecně platí, že přidávejte pouze ty facety, které plánujete vykreslit ve své aplikaci, a vyhněte se požadování vysokého počtu facet, není-li to nutné.
Vysoké hodnoty přeskoků. Nastavení parametru
$skipna vysokou hodnotu (například v tisících) zvyšuje latenci vyhledávání, protože modul načítá a řadí větší objem dokumentů pro každý požadavek. Z důvodů výkonu je nejlepší se vyhnout vysokým$skiphodnotám a místo toho použít jiné techniky, jako je filtrování, k načtení velkého počtu dokumentů.Omezte pole s vysokou kardinalitou. Pole s vysokou kardinalitou odkazuje na facetable nebo filtrovatelné pole, které má významný počet jedinečných hodnot, a v důsledku toho spotřebovává významné zdroje při výpočtu výsledků. Například nastavení pole ID produktu nebo popisu jako facetuální a filtrovatelný se počítá jako s vysokou kardinalitou, protože většina z hodnot z dokumentu do dokumentu je jedinečná.
Tip: Použití vyhledávacích funkcí místo přetížení kritérií filtru
Vzhledem k tomu, že dotaz používá stále složitější kritéria filtru, výkon vyhledávacího dotazu se sníží. Podívejte se na následující příklad, který ukazuje použití filtrů k oříznutí výsledků na základě identity uživatele:
$filter= userid eq 123 or userid eq 234 or userid eq 345 or userid eq 456 or userid eq 567
V tomto případě se výrazy filtru používají ke kontrole, jestli se jedno pole v každém dokumentu rovná jedné z mnoha možných hodnot identity uživatele. Tento vzor pravděpodobně najdete v aplikacích, které implementují omezení na základě zabezpečení (kontrola pole obsahující jedno nebo více ID uživatele nebo objektu zabezpečení oproti seznamu těchto ID představujících uživatele, který dotaz provádí).
Efektivnější způsob, jak spustit filtry obsahující velký počet hodnot, je použít search.in funkci, jak je znázorněno v tomto příkladu:
search.in(userid, '123,234,345,456,567', ',')
Tip: Přidejte oddíly pro jednotlivé pomalé dotazy
Pokud se obecně zpomaluje výkon dotazů, často problém řeší přidávání dalších replik. Ale co když je problém jediný dotaz, který trvá příliš dlouho? V tomto scénáři vám přidání replik nepomůže, ale více particí by mohlo. Partice rozděluje data mezi další výpočetní zdroje. Dva oddíly rozdělí data na poloviny, třetí oddíl je rozdělí na třetiny, a tak dále.
Jedním z pozitivních vedlejších účinků přidávání oddílů je, že pomalejší dotazy se někdy vykonávají rychleji díky paralelnímu zpracování. Poznamenali jsme paralelizaci dotazů s nízkou selektivitou, jako jsou dotazy, které odpovídají mnoha dokumentům, a fasety poskytující počty nad velkým množstvím dokumentů. Vzhledem k tomu, že k určení skóre relevance dokumentů nebo ke spočítání počtu dokumentů se vyžaduje významné výpočty, přidání dalších oddílů pomáhá dotazy dokončit rychleji.
Pokud chcete přidat oddíly, použijte Azure Portal, PowerShell, Azure CLI nebo sadu SDK pro správu.
Kapacita služby
Služba se přetíží, když dotazy trvají příliš dlouho nebo když služba zahazuje žádosti. V takovém případě můžete problém vyřešit upgradem služby nebo přidáním kapacity.
Úroveň vaší vyhledávací služby a počet replik/oddílů mají také velký dopad na výkon. Každá postupně vyšší úroveň poskytuje rychlejší procesory a více paměti, z nichž obě mají pozitivní dopad na výkon.
Tip: Vytvoření nové vyhledávací služby s vysokou kapacitou
Služby Basic a Standard vytvořené v podporovaných oblastech po 3. dubnu 2024 mají více úložiště na oddíl než starší služby. Pokud máte starší službu, zkontrolujte, jestli můžete upgradovat službu tak, aby využívala větší kapacitu se stejnou fakturační sazbou. Pokud upgrade není k dispozici, zkontrolujte limity úrovní služeb a zjistěte, jestli stejná úroveň novější služby poskytuje potřebné úložiště.
Tip: Přepnutí na úroveň Standard S2
Vyhledávací úroveň Standard S1 je často tam, kde zákazníci začínají. Běžným vzorem pro služby S1 je, že se indexy postupem času zvětšují, což vyžaduje více parcel. Další oddíly vedou k pomalejší době odezvy, takže se přidá více replik pro zpracování zatížení dotazu. Jak si můžete představit, náklady na provoz služby S1 se teď dostaly na úrovně nad rámec počáteční konfigurace.
V této chvíli je důležitá otázka, kterou je potřeba položit, jestli by bylo výhodné přejít na vyšší cenovou úroveň, a ne postupně zvýšit počet oddílů nebo replik aktuální služby.
Představte si následující topologii jako příklad služby, která zvládá zvyšující se úroveň kapacity.
- Úroveň Standard S1
- Velikost indexu: 190 GB
- Počet oddílů: 8 (v S1, velikost oddílu je 25 GB na oddíl)
- Počet replik: 2
- Celkový počet jednotek vyhledávání: 16 (8 oddílů x 2 replik)
- Hypotetická maloobchodní cena: ~4 000 USD / měsíc (předpokládejme 250 USD x 16 jednotek hledání)
Předpokládejme, že správce služby stále vidí vyšší latenci a zvažuje přidání další repliky. To by změnilo počet replik z 2 na 3 a v důsledku toho se počet jednotek vyhledávání změnil na 24 a výslednou cenu 6 000 USD za měsíc.
Pokud se ale správce rozhodl přejít na úroveň Standard S2, bude topologie vypadat takto:
- Úroveň Standard S2
- Velikost indexu: 190 GB
- Počet oddílů: 2 (v S2, velikost oddílu je 100 GB na oddíl)
- Počet replik: 2
- Celkový počet jednotek vyhledávání: 4 (2 oddíly x 2 repliky)
- Hypotetická maloobchodní cena: ~4 000 USD / měsíc (1 000 USD x 4 vyhledávací jednotky)
Jak ukazuje tento hypotetický scénář, můžete mít konfigurace na nižších úrovních, které vedou k podobným nákladům, jako kdybyste se na prvním místě rozhodli pro vyšší úroveň. Vyšší úrovně jsou ale součástí premium storage, což zrychlová indexování. Vyšší úrovně mají také mnohem větší výpočetní výkon a také další paměť. U stejných nákladů můžete mít výkonnější infrastrukturu, která zálohuje stejný index.
Důležitou výhodou přidané paměti je, že větší část indexu se dá ukládat do mezipaměti, což vede k nižší latenci vyhledávání a většímu počtu dotazů za sekundu. S tímto dodatečným výkonem nemusí správce ani potřebovat zvýšit počet replik a mohl by potenciálně zaplatit méně než tím, že zůstane ve službě S1.
Tip: Zvažte alternativy k dotazům regulárních výrazů.
Dotazy regulárních výrazů nebo regexp můžou být zvláště nákladné. I když můžou být velmi užitečné pro pokročilá hledání, provádění může vyžadovat velké množství výpočetního výkonu, zejména pokud je regulární výraz komplikovaný nebo když hledáte velké množství dat. Všechny tyto faktory přispívají k vysoké latenci vyhledávání. Jako zmírnění rizik zkuste zjednodušit regulární výraz nebo rozdělit složitý dotaz na menší a lépe spravovatelné dotazy.
Další kroky
Projděte si tyto další články týkající se výkonu služby: