Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Poznámka
Azure AI Vyhledávač je k dispozici prostřednictvím portálu Azure, rozhraní REST API a Sady Azure SDK. Podporuje také Foundry IQ, spravovanou znalostní vrstvu, která transformuje podnikový obsah na opakovaně použitelné znalostní báze s podporou oprávnění pro agenty na portálu Microsoft Foundry.
Tento článek vysvětluje, jak aktualizovat existující index v Azure AI Vyhledávač změnami schématu nebo změnami obsahu prostřednictvím přírůstkového indexování.
Tip
Pokud chcete dokumenty aktualizovat okamžitě, přejděte na aktualizovat obsah. Změny schématu naleznete v tématu Aktualizace schématu indexu.
Požadavky
Služba Azure AI Vyhledávač (libovolná úroveň). Vytvořte službu nebo najděte existující.
Existující index vyhledávání s dokumenty. Tento článek předpokládá, že jste už vytvořili index a načetli dokumenty.
Oprávnění k aktualizaci nebo opětovnému sestavení indexů:
- Ověřování na základě klíčů: Klíč rozhraní API správce pro vaši vyhledávací službu.
- Ověřování na základě role: Role Přispěvatel dat indexu vyhledávání pro aktualizace dokumentů nebo Přispěvatel vyhledávací služby pro změny schématu.
Pro vývoj sady SDK nainstalujte klientskou knihovnu Azure Search:
- Python: azure-search-documents
- .NET: Azure. Search.Documents
- JavaScript: @azure/search-documents
- Java: azure-search-documents
Tip
Během aktivního vývoje se při iterování návrhu indexů běžně odstraňují a znovu sestavují indexy. Pracujte s malým reprezentativním vzorkem dat, aby opětovné indexování bylo rychlejší. Pro změny produkčního schématu vytvořte a otestujte nový index vedle sebe a pak pomocí aliasu indexu prohoďte indexy beze změny kódu aplikace.
Aktualizace obsahu
Přírůstkové indexování a synchronizace indexu proti změnám zdrojových dat je zásadní pro většinu vyhledávacích aplikací. Tato část vysvětluje pracovní postup pro přidání, odebrání nebo přepsání obsahu indexu vyhledávání prostřednictvím rozhraní REST API, ale Sady Azure SDK poskytují ekvivalentní funkce.
Text požadavku obsahuje jeden nebo více dokumentů, které se mají indexovat. V rámci požadavku je každý dokument v indexu následující:
- Identifikovaný jedinečným klíčem rozlišující malá a velká písmena.
- Přidruženo k akci: "upload", "delete", "merge" nebo "mergeOrUpload".
- Naplněno sadou párů název/hodnota pro každé pole, které přidáváte nebo aktualizujete.
{
  "value": [
    {
      "@search.action": "upload (default) | merge | mergeOrUpload | delete",
      "key_field_name": "unique_key_of_document", (key/value pair for key field from index schema)
      "field_name": field_value (name/value pairs matching index schema)
        ...
    },
    ...
  ]
}
Reference:Documents – index
Nejprve použijte rozhraní API pro načítání dokumentů, jako jsou Documents – Index (REST) nebo ekvivalentní rozhraní API v Sady Azure SDK. Další informace o technikách indexování naleznete v tématu Načtení dokumentů.
U velké aktualizace se doporučuje dávkování (až 1 000 dokumentů na dávku, nebo přibližně 16 MB na dávku, podle toho, co nastane dříve), což výrazně zvyšuje výkon indexování.
@search.actionNastavte parametr rozhraní API tak, aby určil vliv na existující dokumenty. SloužímergeOrUploadk přírůstkovým aktualizacím (nejběžnějším)deletek odebrání dokumentů nebomergek částečným aktualizacím polí u existujících dokumentů.Úloha Účinek odstranit Odebere celý dokument z indexu. Pokud chcete odebrat jednotlivá pole, použijte místo toho sloučení a nastavujte příslušné pole na hodnotu null. Odstraněné dokumenty a pole okamžitě nezabírají místo v indexu. Proces na pozadí provede fyzické odstranění každých několik minut. Ať už k vrácení statistik indexu používáte portál Azure nebo rozhraní API, můžete očekávat malé zpoždění před tím, než se odstranění projeví na portálu Azure a prostřednictvím rozhraní API. Další informace najdete v tématu Odstranění dokumentů v indexu vyhledávání. sloučení Aktualizuje existující dokument a selže, pokud dokument nelze najít. Sloučení nahradí existující hodnoty. Z tohoto důvodu nezapomeňte zkontrolovat pole kolekce, která obsahují více hodnot, například pole typu Collection(Edm.String). Pokud napříkladtagspole začíná hodnotou["budget"]a provedete sloučení s["economy", "pool"], konečná hodnotatagspole je["economy", "pool"].["budget", "economy", "pool"]to nebude.
Stejné chování platí pro složité kolekce. Pokud dokument obsahuje komplexní pole kolekce s názvem Místnosti s hodnotou[{ "Type": "Budget Room", "BaseRate": 75.0 }], a provedete sloučení s hodnotou[{ "Type": "Standard Room" }, { "Type": "Budget Room", "BaseRate": 60.5 }], bude konečná hodnota pole Místnosti[{ "Type": "Standard Room" }, { "Type": "Budget Room", "BaseRate": 60.5 }]. Nepřidá nebo sloučí nové a existující hodnoty.mergeOrUpload Funguje jako sloučení, pokud dokument existuje, a jako nahrání, pokud je dokument nový. Toto je nejběžnější akce pro přírůstkové aktualizace. nahrání Podobně jako "upsert", kde se dokument vloží, pokud je nový, a pokud již existuje, je aktualizován nebo nahrazen. Pokud v dokumentu chybí hodnoty, které index vyžaduje, je hodnota pole dokumentu nastavená na hodnotu null.
Dotazy se budou dál spouštět během indexování, ale pokud aktualizujete nebo odebíráte existující pole, můžete očekávat smíšené výsledky a vyšší výskyt omezování.
Poznámka
Neexistují žádné záruky ohledně pořadí, ve kterém jsou akce v textu požadavku spuštěny jako první. Nedoporučuje se mít více akcí sloučení přidružených ke stejnému dokumentu v jednom textu požadavku. Pokud pro stejný dokument vyžaduje více akcí sloučení, před aktualizací dokumentu v indexu vyhledávání proveďte sloučení na straně klienta.
Reakce
Stavový kód 200 se vrátí pro úspěšnou odpověď, což znamená, že všechny položky byly uloženy trvale a začnou být indexovány. Indexování běží na pozadí a zpřístupní nové dokumenty (tj. dotazovatelné a prohledávatelné) několik sekund po dokončení operace indexování. Konkrétní zpoždění závisí na zatížení služby.
Úspěšné indexování označuje vlastnost stavu nastavená na hodnotu True pro všechny položky a statusCode vlastnost nastavenou na hodnotu 201 (pro nově nahrané dokumenty) nebo 200 (pro sloučené nebo odstraněné dokumenty):
{
  "value": [
    {
      "key": "unique_key_of_new_document",
      "status": true,
      "errorMessage": null,
      "statusCode": 201
    },
    {
      "key": "unique_key_of_merged_document",
      "status": true,
      "errorMessage": null,
      "statusCode": 200
    },
    {
      "key": "unique_key_of_deleted_document",
      "status": true,
      "errorMessage": null,
      "statusCode": 200
    }
  ]
}
Stavový kód 207 se vrátí, pokud alespoň jedna položka nebyla úspěšně indexována. Položky, které nebyly indexovány, mají pole stavu nastaveno na false. Vlastnosti errorMessage a statusCode indikují důvod chyby indexování:
{
  "value": [
    {
      "key": "unique_key_of_document_1",
      "status": false,
      "errorMessage": "The search service is too busy to process this document. Please try again later.",
      "statusCode": 503
    },
    {
      "key": "unique_key_of_document_2",
      "status": false,
      "errorMessage": "Document not found.",
      "statusCode": 404
    },
    {
      "key": "unique_key_of_document_3",
      "status": false,
      "errorMessage": "Index is temporarily unavailable because it was updated with the 'allowIndexDowntime' flag set to 'true'. Please try again later.",
      "statusCode": 422
    }
  ]
}
Vlastnost errorMessage označuje důvod chyby indexování, pokud je to možné.
Následující tabulka vysvětluje různé stavové kódy jednotlivých dokumentů, které lze vrátit v odpovědi. Některé stavové kódy označují problémy se samotným požadavkem, zatímco jiné označují dočasné chybové stavy. Druhý pokus byste měli opakovat po zpoždění.
| Stavový kód | Význam | Opakovatelné | Poznámky |
|---|---|---|---|
| 200 | Dokument byl úspěšně změněn nebo odstraněn. | N/a | Operace odstranění jsou idempotentní. To znamená, že i když klíč dokumentu v indexu neexistuje, při pokusu o operaci odstranění s tímto klíčem vznikne stavový kód 200. |
| 201 | Dokument byl úspěšně vytvořen. | N/a | |
| 400 | V dokumentu došlo k chybě, která zabránila indexování. | Ne | Chybová zpráva v odpovědi označuje, co je v dokumentu špatně. |
| 404 | Dokument nelze sloučit, protože daný klíč v indexu neexistuje. | Ne | K této chybě nedochází při nahrávání, protože vytvářejí nové dokumenty, a nedochází k ní ani při mazání, protože jsou idempotentní. |
| 409 | Při pokusu o indexování dokumentu došlo ke konfliktu verzí. | Ano | K tomu může dojít, když se pokoušíte indexovat stejný dokument více než jednou současně. |
| 422 | Index je dočasně nedostupný, protože byl aktualizován příznakem allowIndexDowntime nastaveným na true. | Ano | |
| 429 | Příliš mnoho požadavků | Ano | Pokud se vám při indexování zobrazí tento kód chyby, obvykle to znamená, že máte málo úložiště. Když se blížíte limitům úložiště, může služba zadat stav, ve kterém nemůžete přidávat ani aktualizovat, dokud neodstraníte některé dokumenty. Další informace najdete v tématu Plánování a správa kapacity , pokud chcete více úložiště nebo uvolnit místo odstraněním dokumentů. |
| 503 | Vaše vyhledávací služba je dočasně nedostupná, pravděpodobně kvůli vysokému zatížení. | Ano | Váš kód by měl v tomto případě počkat před opakováním, jinak riskujete prodloužení nedostupnosti služby. |
Pokud váš klientský kód často narazí na odpověď 207, je jedním z možných důvodů, proč je systém zatížený. Můžete to potvrdit tak, že zkontrolujete vlastnost statusCode pro 503. Pokud je stavOvý kód 503, doporučujeme požadavky indexování omezovat. Jinak jestliže indexovací provoz neustává, může systém začít odmítat všechny požadavky s chybou 503.
Stavový kód 429 označuje, že jste překročili kvótu počtu dokumentů na index. Musíte buď upgradovat na vyšší limity kapacity , nebo vytvořit nový index.
Poznámka
Když nahrajete hodnoty DateTimeOffset s informacemi o časovém pásmu do indexu, Azure AI Vyhledávač tyto hodnoty normalizuje do standardu UTC. Například 2024-01-13T14:03:00-08:00 je uložen jako 2024-01-13T22:03:00Z. Pokud potřebujete uložit informace o časovém pásmu, přidejte do indexu pro tento datový bod další sloupec.
Tipy pro přírůstkové indexování
Indexery automatizují přírůstkové indexování. Pokud můžete použít indexer a pokud zdroj dat podporuje sledování změn, můžete indexer spustit podle plánu opakování a přidat, aktualizovat nebo přepsat prohledávatelný obsah tak, aby se synchronizoval s vašimi externími daty.
Pokud provádíte volání indexu přímo prostřednictvím push API, použijte
mergeOrUploadjako akci vyhledávání.Datová část musí obsahovat klíče nebo identifikátory každého dokumentu, který chcete přidat, aktualizovat nebo odstranit.
Pokud index obsahuje vektorová pole a vlastnost nastavíte
storedna false, ujistěte se, že jste v částečné aktualizaci dokumentu zadali vektor, i když se hodnota nezmění. Vedlejším účinkem nastavenístoredna false je, že vektory se při přeindexaci odstraní. Poskytnutí vektoru v datové části dokumentů zabrání tomu, aby k tomu došlo.Chcete-li aktualizovat obsah jednoduchých polí a dílčích polí ve složitých typech, uveďte pouze pole, která chcete změnit. Pokud například potřebujete aktualizovat pole popisu, datová část by se měla skládat z klíče dokumentu a upraveného popisu. Vynechání jiných polí zachová jejich stávající hodnoty.
Pokud chcete sloučit vložené změny do kolekce řetězců, zadejte celou hodnotu. Vzpomeňte si příklad
tagspole z předchozí části. Nové hodnoty přepíší staré hodnoty pro celé pole, aniž by došlo ke sloučení v obsahu pole.
Tady je příklad rozhraní REST API , který ukazuje tyto tipy:
### Get Stay-Kay City Hotel by ID
GET  {{baseUrl}}/indexes/hotels-vector-quickstart/docs('1')?api-version=2026-04-01  HTTP/1.1
    Content-Type: application/json
    api-key: {{apiKey}}

### Change the description, city, and tags for Stay-Kay City Hotel
POST {{baseUrl}}/indexes/hotels-vector-quickstart/docs/search.index?api-version=2026-04-01  HTTP/1.1
  Content-Type: application/json
  api-key: {{apiKey}}

    {
        "value": [
            {
            "@search.action": "mergeOrUpload",
            "HotelId": "1",
            "Description": "I'm overwriting the description for Stay-Kay City Hotel.",
            "Tags": ["my old item", "my new item"],
            "Address": {
                "City": "Gotham City"
                }
            }
        ]
    }

### Retrieve the same document, confirm the overwrites and retention of all other values
GET  {{baseUrl}}/indexes/hotels-vector-quickstart/docs('1')?api-version=2026-04-01  HTTP/1.1
    Content-Type: application/json
    api-key: {{apiKey}}
Reference:Documents - Index, Lookup Document
Příklady sady SDK
Následující příklady ukazují, jak aktualizovat dokumenty pomocí Sady Azure SDK.
from azure.core.credentials import AzureKeyCredential
from azure.search.documents import SearchClient

# Set up the client
service_name = "<your-search-service-name>"
index_name = "hotels-sample"
api_key = "<your-admin-api-key>"

endpoint = f"https://{service_name}.search.windows.net"
credential = AzureKeyCredential(api_key)
client = SearchClient(endpoint=endpoint, index_name=index_name, credential=credential)

# Update documents using merge_or_upload
documents = [
    {
        "HotelId": "1",
        "Description": "Updated description for the hotel.",
        "Tags": ["updated", "renovated"]
    }
]

result = client.merge_or_upload_documents(documents=documents)
print(f"Updated {len(result)} document(s)")
Reference:SearchClient, merge_or_upload_documents
Aktualizace schématu indexu
Schéma indexu definuje fyzické datové struktury vytvořené ve vyhledávací službě, takže neexistuje mnoho změn schématu, které můžete provést bez nutnosti úplné opětovné sestavení.
Aktualizace bez opětovného sestavení
Následující seznam uvádí změny schématu, které lze bezproblémově zavést do existujícího indexu. Obecně platí, že seznam obsahuje nová pole a funkce používané při provádění dotazů.
- Přidání popisu indexu
- Přidání nového pole
- Nastavení atributu
retrievableu existujícího pole - Aktualizujte
searchAnalyzeru pole, které má existujícíindexAnalyzer. - Přidání nové definice analyzátoru do indexu (které lze použít pro nová pole)
- Přidání, aktualizace nebo odstranění hodnoticího profilu
- Přidejte, aktualizujte nebo odstraňte mapy synonym
- Přidání, aktualizace nebo odstranění sémantických konfigurací
- Přidání, aktualizace nebo odstranění nastavení CORS
Pořadí operací je:
Upravte schéma podle aktualizací z předchozího seznamu.
Aktualizujte schéma indexu ve vyhledávací službě.
Pokud jste přidali nové pole, aktualizujte obsah indexu tak, aby odpovídal upravenému schématu. Pro všechny ostatní změny se použije existující indexovaný obsah as-is.
Když aktualizujete schéma indexu tak, aby zahrnovalo nové pole, stávající dokumenty v indexu mají pro toto pole hodnotu null. V další úloze indexování nahradí hodnoty z externích zdrojových dat hodnoty null přidané Azure AI Vyhledávač.
Během aktualizací by nemělo dojít k přerušení dotazů, ale výsledky dotazů se budou lišit, jak se aktualizace projeví.
Aktualizace vyžadující opětovné sestavení
Některé úpravy vyžadují vyřazení a opětovné sestavení indexu a nahrazení aktuálního indexu novým indexem.
| Úloha | Popis |
|---|---|
| Odstraňte pole | Pokud chcete fyzicky odebrat všechny stopy pole, musíte index znovu sestavit. Pokud okamžité opětovné sestavení není praktické, můžete upravit kód aplikace tak, aby přesměroval přístup mimo zastaralé pole, nebo použít vyhledávací pole a vybrat parametry dotazu, abyste zvolili, která pole se prohledávají a vrací. Definice a obsah pole fyzicky zůstanou v indexu až do dalšího opětovného sestavení, když použijete schéma, které dané pole vynechá. |
| Změna definice pole | Revize názvu pole, datového typu nebo konkrétních atributů indexu (prohledávatelné, filtrovatelné, řaditelné, omezující) vyžadují úplné opětovné sestavení. |
| Přiřazení analyzátoru k poli | Analyzátory jsou definovány v indexu, přiřazeny k polím a následně vyvolány během indexování, aby informovaly, jak se tokeny vytvářejí. Do indexu můžete kdykoli přidat novou definici analyzátoru, ale při vytváření pole můžete přiřadit pouze analyzátor. To platí pro vlastnosti analyzátoru i indexAnalyzeru . Vlastnost searchAnalyzer je výjimka (tuto vlastnost můžete přiřadit existujícímu poli). |
| Aktualizace nebo odstranění definice analyzátoru v indexu | Existující konfiguraci analyzátoru (analyzátor, tokenizátor, filtr tokenů nebo znakový filtr) v indexu nemůžete odstranit ani změnit, pokud znovu neskonstruujete celý index. |
| Přidejte pole do návrhového nástroje | Pokud pole již existuje a chcete ho přidat do konstruktoru Návrhy, znovu vytvořte index. |
| Upgradujte vaši službu nebo úroveň | Pokud potřebujete větší kapacitu, zkontrolujte, jestli můžete upgradovat službu nebo přejít na vyšší cenovou úroveň. Pokud ne, musíte vytvořit novou službu a znovu sestavit indexy od začátku. K automatizaci tohoto procesu můžete použít vzorový kód, který zálohuje index do řady souborů JSON. Pak můžete index vytvořit znovu ve vyhledávací službě, kterou zadáte. |
Pořadí operací je:
Získejte definici indexu pro případ, že ji potřebujete pro budoucí referenci, nebo ji použít jako základ pro novou verzi.
Zvažte použití řešení zálohování a obnovení k zachování kopie obsahu indexu. V C# a v Python existují řešení. Doporučujeme Python verzi, protože je aktuální.
Pokud máte ve vyhledávací službě kapacitu, ponechte stávající index při vytváření a testování nového indexu.
Odstraňte existující index. Dotazy, které cílí na index, se okamžitě zahodí. Mějte na paměti, že odstranění indexu je nevratné, což zničí fyzické úložiště pro kolekci polí a dalších konstrukcí.
Publikuje revidovaný index, kde text požadavku obsahuje změněné nebo upravené definice polí a konfigurace.
Načtěte dokumenty do indexu z externího zdroje. Dokumenty se indexují pomocí definic polí a konfigurací nového schématu.
Při vytváření indexu je fyzické úložiště přiděleno pro každé pole ve schématu indexu s invertovaným indexem vytvořeným pro každé prohledávatelné pole a vektorový index vytvořený pro každé vektorové pole. Pole, která nejsou prohledávatelná, je možné použít ve filtrech nebo výrazech, ale nemají invertované indexy a nejsou prohledávatelná fulltextově nebo pomocí přibližného vyhledávání. Při opětovném sestavení indexu se tyto invertované indexy a vektorové indexy odstraní a znovu vytvoří na základě zadaného schématu indexu.
Pokud chcete minimalizovat přerušení kódu aplikace, zvažte vytvoření aliasu indexu. Kód aplikace odkazuje na alias, ale můžete aktualizovat název indexu, na který alias odkazuje.
Přidání popisu indexu
Index má description vlastnost, kterou můžete zadat a použít, když systém musí přistupovat k několika indexům a rozhodovat se na základě popisu. Vezměte v úvahu server MCP (Model Context Protocol), který musí vybrat správný index za běhu. Rozhodnutí může být založeno na popisu, nikoli na samotném názvu indexu.
Popis indexu je aktualizace schématu a můžete ji přidat, aniž byste museli znovu sestavit celý index.
- Délka řetězce je maximálně 4 000 znaků.
- Obsah musí být čitelný pro člověka v kódování Unicode. Váš případ použití by měl určit, který jazyk se má použít.
Popis indexu můžete přidat prostřednictvím portálu Azure, nejnovějšího stabilního rozhraní REST API nebo balíčku Azure SDK, který tuto funkci poskytuje.
Portál Azure podporuje nejnovější rozhraní API ve verzi Preview.
Přejděte do vyhledávací služby na portálu Azure.
Pod položkou Správa vyhledávání>Indexy vyberte index.
Vyberte Upravit JSON.
Vložte
"description"a za ním popis. Hodnota musí být menší než 4 000 znaků a v unicode.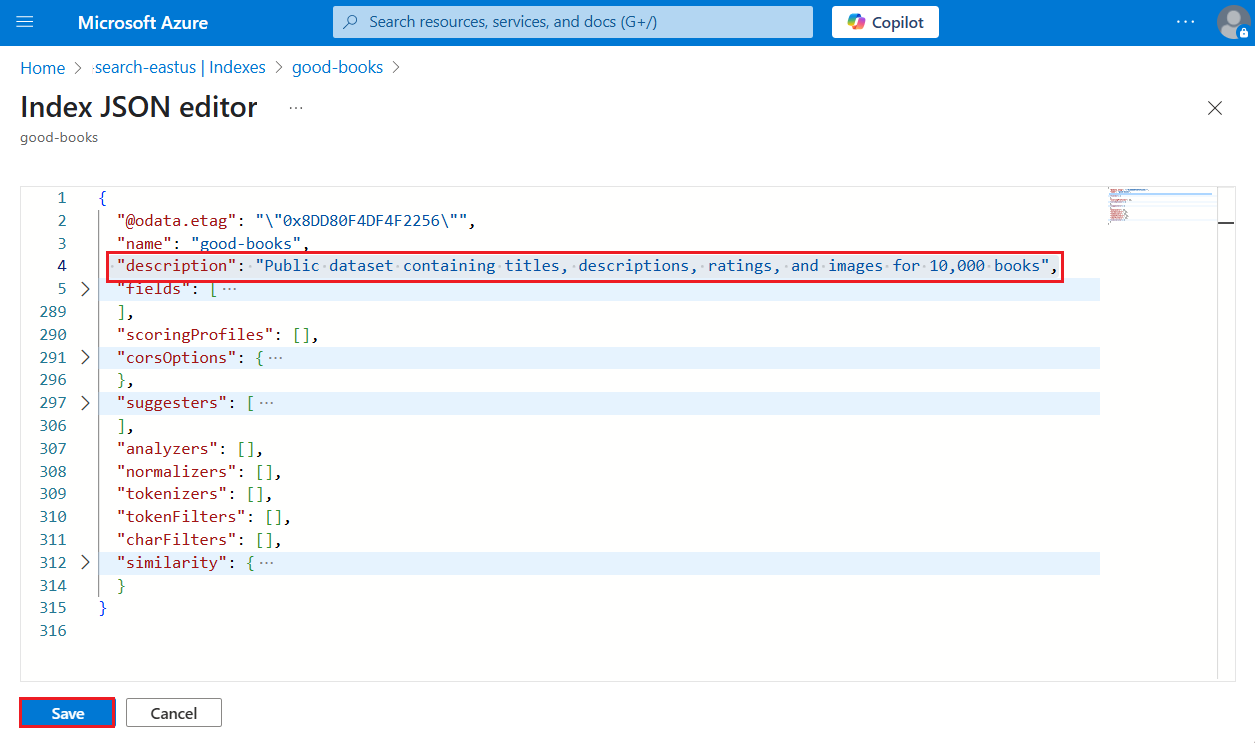
Uložte index.
Vyrovnávání zatížení
Indexování se nespustí na pozadí, ale vyhledávací služba vyrovnává všechny úlohy indexování s průběžnými dotazy. Během indexování můžete monitorovat požadavky na dotazy na portálu Azure, abyste zajistili včasné dokončení dotazů.
Pokud úlohy indexování představují nepřijatelné úrovně latence dotazů, proveďte analýzu výkonu a projděte si tyto tipy k výkonu , které vám pomůžou potenciální zmírnění rizik.
Kontrola aktualizací
Jakmile se načte první dokument, můžete začít dotazovat index. Pokud znáte ID dokumentu, vrátí rozhraní REST API pro vyhledávání dokumentu konkrétní dokument. Pro širší testování byste měli počkat, až se index plně načte, a pak pomocí dotazů ověřte kontext, který očekáváte.
K vyhledání aktualizovaného obsahu můžete použít Průzkumníka služby Search nebo klienta REST .
Pokud jste pole přidali nebo přejmenovali, použijte výběr k vrácení daného pole:
"search": "*",
"select": "document-id, my-new-field, some-old-field",
"count": true
Portál Azure poskytuje velikost indexu a velikost vektorového indexu. Tyto hodnoty můžete zkontrolovat po aktualizaci indexu, ale nezapomeňte, že můžete očekávat malé zpoždění, protože služba zpracovává změnu a je třeba brát v úvahu rychlosti obnovování portálu, což může trvat několik minut.
Řešení potíží s přeindexováním
Následující tabulka uvádí běžné problémy při aktualizaci nebo opětovném sestavení indexů a jejich řešení.
| Problém | Příčina | Rozlišení |
|---|---|---|
| Odpověď 207 se smíšenými výsledky | Některé dokumenty byly úspěšné, jiné selhaly. | Zkontrolujte statusCode pro každý dokument v odpovědi. Pokud 503, omezte požadavky a zkuste to znovu. |
| Konflikt verzí 409 | Souběžné aktualizace stejného dokumentu | Serializace aktualizací stejného dokumentu nebo implementace opakování s exponenciálním zpožněním. |
| 429 Příliš mnoho požadavků | Kvóta úložiště byla překročena nebo je příliš mnoho současných požadavků. | Odstraňte dokumenty a uvolněte místo nebo upgradujte úroveň služby pro větší kapacitu. |
| 503 Služba není k dispozici | Služba s velkým zatížením. | Počkejte a opakujte akci s exponenciálním zpožděním. Zvažte zmenšení velikosti dávky. |
| Počet dokumentů beze změny po odstranění | Odstranění je asynchronní. | Počkejte 2 až 3 minuty, než proces na pozadí dokončí fyzické odstranění. |
| Nové pole vrátí hodnotu null. | Pole přidané do schématu, ale dokumenty se nepřeindexují. | Spusťte indexer nebo nasdílejte aktualizované dokumenty, aby se nové pole naplnilo. |
| Zamítnutá změna schématu | Došlo k pokusu o nekompatibilní změnu (přejmenování, změna typu). | Odstraňte a znovu sestavte index. K minimalizaci výpadků použijte alias indexu. |
Viz také
- Přehled indexeru
- Odstranění dokumentů z indexu vyhledávání
- Indexování velkých datových sad ve velkém měřítku
- Indexování na portálu Azure
- indexer služby Azure SQL Database
- Azure Cosmos DB pro indexer NoSQL
- Azure indexer objektů blob
- indexer tabulek Azure
- Ochrana dat, ochrany osobních údajů a integrovaná ochrana