Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Poznámka:
Azure AI Vyhledávač je k dispozici prostřednictvím portálu Azure, rozhraní REST API a Sady Azure SDK. Podporuje také Foundry IQ, spravovanou znalostní vrstvu, která transformuje podnikový obsah na opakovaně použitelné znalostní báze s podporou oprávnění pro agenty na portálu Microsoft Foundry.
Important
Tyto funkce podporují připojení k jiným služby Microsoft a službám třetích stran. Použití těchto služeb podléhá vlastním podmínkám jednotlivých služeb a může vést ke zpracování nebo ukládání dat mimo hranici souladu Azure, stejně jako k toku dat do hranice souladu Azure.
Je vaší zodpovědností spravovat, jestli budou vaše data přetékat mimo dodržování předpisů a geografické hranice vaší organizace a případné související důsledky a že se zřídí příslušná oprávnění, hranice a schválení.
Zodpovídáte za pečlivou kontrolu a testování aplikací, které vytváříte v kontextu konkrétních případů použití, a za veškerá vhodná rozhodnutí a přizpůsobení. To zahrnuje implementaci vlastního zodpovědného zmírnění rizik umělé inteligence, jako jsou metaprompty, filtry obsahu nebo jiné bezpečnostní systémy, a zajištění toho, aby vaše aplikace splňovaly příslušné standardy kvality, spolehlivosti, zabezpečení a důvěryhodnosti. Další informace najdete v informacích o transparentnosti Azure AI Vyhledávač.
Indexer tabulky Azure importuje obsah z Azure Table Storage do indexu Azure AI Vyhledávač. Vstupy indexeru jsou vaše entity v jedné tabulce. Výstup je index vyhledávání s prohledávatelným obsahem a metadaty uloženými v jednotlivých polích.
Tento článek doplňuje vytvoření indexeru informacemi, které jsou specifické pro indexování z Azure Table Storage. Pomocí webu Azure Portal a rozhraní REST API demonstruje třídílný pracovní postup společný pro všechny indexery: vytvoření zdroje dat, vytvoření indexu, vytvoření indexeru. Extrakce dat nastane, když odešlete požadavek Create Indexer.
Požadavky
Tabulky obsahující text Pokud máte binární data, zvažte rozšíření AI pro analýzu obrázků.
Oprávnění ke čtení ve službě Azure Storage Připojovací řetězec s plným přístupem obsahuje klíč, který poskytuje přístup k obsahu, ale pokud používáte role v Azure, ujistěte se, že spravovaná identita vyhledávací služby má oprávnění čtenář dat tabulky úložiště.
Abyste mohli projít příklady v tomto článku, potřebujete Azure Portal nebo klienta REST. Pokud používáte Azure Portal, ujistěte se, že je povolený přístup ke všem veřejným sítím. Další přístupy k vytvoření indexeru tabulek Azure zahrnují sady Azure SDK.
Vyzkoušení s ukázkovými daty
Pomocí těchto pokynů vytvořte tabulku ve službě Azure Storage pro účely testování.
Přihlaste se k webu Azure Portal, přejděte do svého účtu úložiště a vytvořte tabulku s názvem hotely.
Stáhněte si HotelsData_toAzureSearch.csv z GitHubu. Tento soubor je podmnožinou předdefinované ukázkové datové sady hotelů. Vynechá kolekci místností, přeložené popisy a zeměpisné souřadnice.
V průzkumníku služby Azure Storage se přihlaste do Azure, vyberte své předplatné a pak vyberte svůj účet úložiště.
Otevřete Tabulky a vyberte hotely.
Na panelu příkazů vyberte Importovat a pak vyberte HotelsData_toAzureSearch.csv soubor.
Přijměte výchozí hodnoty. Výběrem možnosti Importovat načtěte data.
V tabulce byste měli mít 50 záznamů hotelů s automaticky vygenerovaným partitionKey, rowKey a timestamp. Tento obsah teď můžete použít k indexování na webu Azure Portal, klientovi REST nebo sadě Azure SDK.
Pole Popis poskytuje nejrozsáhodnější obsah. Toto pole byste měli cílit na fulltextové vyhledávání a volitelné vektorové dotazy.
Použití portálu Azure Portal
Pomocí Průvodce importem dat můžete automatizovat indexování z tabulky nebo zobrazení databáze SQL.
V části Připojit k datům vyberte nebo ověřte, že typ zdroje dat je Azure Table Storage nebo že pole výběru dat zobrazí výzvu k zadání tabulek.
Název zdroje dat odkazuje na objekt připojení zdroje dat ve službě Azure AI Vyhledávač. Název zdroje dat se automaticky vygeneruje pomocí vlastní předpony, kterou zadáte na konci pracovního postupu průvodce.
Zadejte název účtu pro úložiště a tabulky. Dotaz je nepovinný. Je užitečné, pokud máte konkrétní sloupce, které chcete importovat.
Zadejte metodu ověřování, a to buď spravovanou identitu, nebo integrovaný klíč rozhraní API. Pokud nezadáte připojení spravované identity, azure Portal tento klíč použije.
Pokud nakonfigurujete Azure AI Vyhledávač tak, aby používaly spravovanou identitu, a vytvoříte přiřazení role na Azure Storage, která identitě udělí roli Čtenář dat tabulky úložiště, může se indexer připojit k úložišti tabulek pomocí Microsoft Entra ID.
Můžete zadat možnosti detekce odstranění.
Detekce odstranění vyžaduje, abyste v tabulce měli existující pole, které se dá použít jako příznak soft-deletion. Mělo by to být logické pole (můžete ho pojmenovat IsDeleted). Zadejte hodnotu
truepro soft-delete. Do indexu vyhledávání přidejte odpovídající vyhledávací pole s názvem IsDeleted nastaveno na načtení a filtrování.Pokračujte zbývajícími kroky k dokončení průvodce.
Použití rozhraní REST API
Tato část ukazuje volání rozhraní REST API, která vytvářejí zdroj dat, index a indexer.
Definování zdroje dat
Definice zdroje dat určuje zdrojová data pro indexování, přihlašovací údaje a zásady pro detekci změn. Zdroj dat je nezávislý prostředek, který může používat více indexerů.
Vytvořte nebo aktualizujte zdroj dat a nastavte jeho definici:
 POST https://[service name].search.windows.net/datasources?api-version=2026-04-01
 {
     "name": "my-table-storage-ds",
     "description": null,
     "type": "azuretable",
     "subtype": null,
     "credentials": {
        "connectionString": "DefaultEndpointsProtocol=https;AccountName=<account name>"
     },
     "container": {
        "name": "my-table-in-azure-storage",
        "query": ""
     },
     "dataChangeDetectionPolicy": null,
     "dataDeletionDetectionPolicy": null,
     "encryptionKey": null,
     "identity": null
 }
Nastavte "typ" na
"azuretable"(povinné).Nastavte přihlašovací údaje na připojovací řetězec služby Azure Storage. Následující část popisuje podporované formáty.
Nastavte "kontejner" na název tabulky.
Volitelně můžete nastavit dotaz na filtr pro PartitionKey. Nastavení této vlastnosti je osvědčeným postupem, který zlepšuje výkon. Pokud má parametr "query" hodnotu null, spustí indexer úplnou kontrolu tabulky, což může vést k nízkému výkonu, pokud jsou tabulky velké.
Definice zdroje dat může také zahrnovat zásady měkkého odstranění, pokud chcete, aby indexer odstranil vyhledávací dokument, když je zdrojový dokument označen příznakem pro odstranění.
Podporované přihlašovací údaje a připojovací řetězec
Indexery se můžou připojit k tabulce pomocí následujících připojení.
| Připojovací řetězec účtu úložiště s úplným přístupem |
|---|
{ "connectionString" : "DefaultEndpointsProtocol=https;AccountName=<your storage account>;AccountKey=<your account key>;" } |
| Připojovací řetězec můžete získat ze stránky účtu úložiště na webu Azure Portal výběrem přístupových klíčů v levém podokně. Nezapomeňte vybrat úplný připojovací řetězec a ne jenom klíč. |
| Připojovací řetězec spravované identity |
|---|
{ "connectionString" : "ResourceId=/subscriptions/<your subscription ID>/resourceGroups/<your resource group name>/providers/Microsoft.Storage/storageAccounts/<your storage account name>/;" } |
| Tato připojovací řetězec nevyžaduje klíč účtu, ale musíte mít vyhledávací službu již nakonfigurovanou pro připojení pomocí spravované identity. |
| Připojovací řetězec sdíleného přístupového podpisu (SAS) účtu úložiště |
|---|
{ "connectionString" : "BlobEndpoint=https://<your account>.blob.core.windows.net/;SharedAccessSignature=?sv=2016-05-31&sig=<the signature>&spr=https&se=<the validity end time>&srt=co&ss=b&sp=rl;" } |
| Sdílený přístupový podpis by měl mít oprávnění pro čtení a seznam u tabulek a entit. |
| Sdílený přístupový podpis kontejneru |
|---|
{ "connectionString" : "ContainerSharedAccessUri=https://<your storage account>.blob.core.windows.net/<container name>?sv=2016-05-31&sr=c&sig=<the signature>&se=<the validity end time>&sp=rl;" } |
| Sdílený přístupový podpis by měl mít v kontejneru oprávnění ke čtení a seznam. Další informace najdete v tématu Udělení omezeného přístupu k prostředkům Azure Storage pomocí sdílených přístupových podpisů (SAS). |
Poznámka:
Pokud používáte přihlašovací údaje SAS, musíte přihlašovací údaje ke zdroji dat pravidelně aktualizovat obnovenými podpisy, aby se zabránilo jejich vypršení platnosti. Pokud vyprší platnost přihlašovacích údajů SAS, indexer selže s chybovou zprávou typu "Přihlašovací údaje zadané v připojovacím řetězci jsou neplatné nebo vypršela jejich platnost".
Oddíl pro zvýšení výkonu
Azure AI Vyhledávač ve výchozím nastavení používá následující interní filtr dotazů ke sledování toho, které zdrojové entity byly od posledního spuštění aktualizovány: Timestamp >= HighWaterMarkValue Vzhledem k tomu, že tabulky Azure nemají v poli sekundární index Timestamp , tento typ dotazu vyžaduje úplnou kontrolu tabulky, a proto je pomalý pro velké tabulky.
Abyste se vyhnuli úplnému prohledávání, můžete pomocí oddílů tabulky zúžit rozsah jednotlivých úloh indexeru.
Pokud je možné data přirozeně rozdělit do několika rozsahů oddílů, vytvořte zdroj dat a odpovídající indexer pro každý rozsah oddílů. Každý indexer nyní musí zpracovat jenom konkrétní rozsah oddílů, což vede k lepšímu výkonu při zpracování dotazů. Pokud data, která je potřeba indexovat, mají malý počet pevných oddílů, ještě lépe: každý indexer prohledá pouze oddíly.
Pokud například chcete vytvořit zdroj dat pro zpracování rozsahu oddílů s klíči od
000do100, použijte dotaz podobný tomuto:"container" : { "name" : "my-table", "query" : "PartitionKey ge '000' and PartitionKey lt '100' " }Pokud jsou data rozdělená podle času (například pokud vytváříte nový oddíl každý den nebo týden), zvažte následující přístup:
V definici zdroje dat zadejte dotaz podobný následujícímu příkladu:
(PartitionKey ge <TimeStamp>) and (other filters).Sledujte průběh indexeru pomocí rozhraní API pro získání stavu indexeru a pravidelně aktualizujte
<TimeStamp>podmínku dotazu na základě nejnovější úspěšné hodnoty horní meze.Pokud při tomto přístupu potřebujete spustit úplné přeindexování, resetujte nejen indexer, ale také dotaz zdroje dat.
Přidání vyhledávacích polí do indexu
Do indexu vyhledávání přidejte pole pro příjem obsahu a metadat entit tabulky.
Vytvořte nebo aktualizujte index a definujte vyhledávací pole, která ukládají obsah z entit:
POST https://[service name].search.windows.net/indexes?api-version=2026-04-01
{
  "name" : "my-search-index",
  "fields": [
    { "name": "Key", "type": "Edm.String", "key": true, "searchable": false },
    { "name": "SomeColumnInMyTable", "type": "Edm.String", "searchable": true }
  ]
}
Vytvořte pole klíče dokumentu ("key": true), ale indexer ho automaticky naplní. Indexer tabulky naplní pole klíče zřetězením klíčů oddílu a klíčů řádku z tabulky. Pokud je například PartitionKey
1řádku a RowKey je1_123, pak hodnota klíče je11_123. Pokud má klíč oddílu hodnotu null, použije se pouze klíč řádku.Pokud k vytvoření indexu používáte Průvodce importem dat , Azure Portal odvodí pole Klíč pro index vyhledávání a použije implicitní mapování polí pro připojení zdrojových a cílových polí. Pole nemusíte přidávat sami a nemusíte nastavovat mapování polí.
Pokud používáte rozhraní REST API a chcete implicitní mapování polí, vytvořte a pojmenujte pole klíče dokumentu "Klíč" v definici indexu vyhledávání, jak je znázorněno v předchozím kroku (
{ "name": "Key", "type": "Edm.String", "key": true, "searchable": false }). Indexer vyplní pole Klíč automaticky bez nutnosti mapování polí.Pokud nechcete ve vyhledávacím indexu pole s názvem Klíč, přidejte do definice indexeru explicitní mapování polí s požadovaným názvem pole a nastavte zdrojové pole na Klíč:
 "fieldMappings" : [
   {
     "sourceFieldName" : "Key",
     "targetFieldName" : "MyDocumentKeyFieldName"
   }
]
Teď přidejte do indexu všechna další pole entity, která chcete použít. Pokud například entita vypadá jako v následujícím příkladu, měl by mít index vyhledávání pole pro HotelName, Description a Category, aby tyto hodnoty získal.
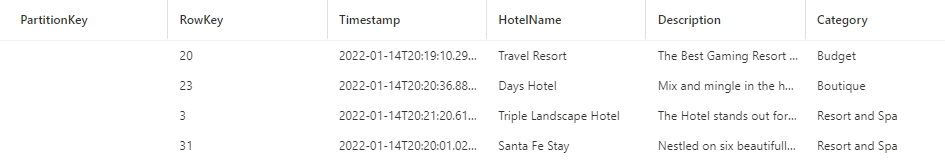
Použití stejných názvů a kompatibilních datových typů minimalizuje potřebu mapování polí. Pokud jsou názvy a typy stejné, indexer může automaticky určit cestu k datům.
Konfigurace a spuštění indexeru tabulky
Jakmile budete mít index a zdroj dat, budete připraveni vytvořit indexer. Konfigurace indexeru určuje vstupy, parametry a vlastnosti, které řídí chování doby běhu.
Vytvořte nebo aktualizujte indexer tak, že ho pojmenujte a odkazujete na zdroj dat a cílový index:
POST https://[service name].search.windows.net/indexers?api-version=2026-04-01
{
    "name" : "my-table-indexer",
    "dataSourceName" : "my-table-storage-ds",
    "targetIndexName" : "my-search-index",
    "disabled": null,
    "schedule": null,
    "parameters" : {
        "batchSize" : null,
        "maxFailedItems" : null,
        "maxFailedItemsPerBatch" : null,
        "configuration" : { }
    },
    "fieldMappings" : [ ],
    "cache": null,
    "encryptionKey": null
}
Určete mapování polí, pokud existují rozdíly v názvu nebo typu pole nebo pokud potřebujete v indexu vyhledávání více verzí zdrojového pole. Cílové pole je název pole v indexu vyhledávání.
 "fieldMappings" : [
   {
     "sourceFieldName" : "Description",
     "targetFieldName" : "HotelDescription"
   }
]
Další informace o dalších vlastnostech najdete v tématu Vytvoření indexeru .
Indexer se spustí automaticky při jeho vytvoření. Můžete tomu zabránit nastavením "zakázáno" na hodnotu true. Pokud chcete řídit provádění indexeru, spusťte indexer na vyžádání nebo ho umístěte do plánu.
Kontrola stavu indexeru
Pokud chcete monitorovat stav indexeru a historii spuštění, zkontrolujte historii spuštění indexeru na portálu Azure nebo odešlete požadavek rozhraní REST API na získání stavu indexeru.
Na stránce vyhledávací služby otevřete Správa vyhledávání>Indexery.
Vyberte indexer pro přístup ke konfiguraci a historii spuštění.
Výběrem konkrétní úlohy indexeru zobrazíte podrobnosti, upozornění a chyby.
Historie vykonávání obsahuje až 50 nedávno dokončených vykonání, které jsou seřazeny v obráceném chronologickém pořadí tak, aby nejnovější vykonání bylo první.
Další kroky
Přečtěte si další informace o tom, jak spustit indexer, monitorovat stav nebo naplánovat spuštění indexeru. Následující články platí pro indexery, které načítá obsah ze služby Azure Storage: