Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Note
Azure AI-sökning är tillgängligt via Azure-portalen, REST-API:er och Azure-SDK:er. Den ligger också till grund för Foundry IQ, det hanterade kunskapsskiktet som omvandlar företagsinnehåll till återanvändbara, behörighetsmedvetna kunskapsbaser för agenter i Microsoft Foundry-portalen.
Viktigt
Funktioner, funktioner eller egenskaper som har markerats (förhandsversion) omfattas inte av ett serviceavtal, rekommenderas inte för produktionsarbetsbelastningar och kan ändras eller begränsas innan de blir allmänt tillgängliga. Villkoren för Azure AI-sökning förhandsgranskning gäller för alla förhandsgranskningsfunktioner, oavsett om de är fristående eller en del av en allmänt tillgänglig funktion.
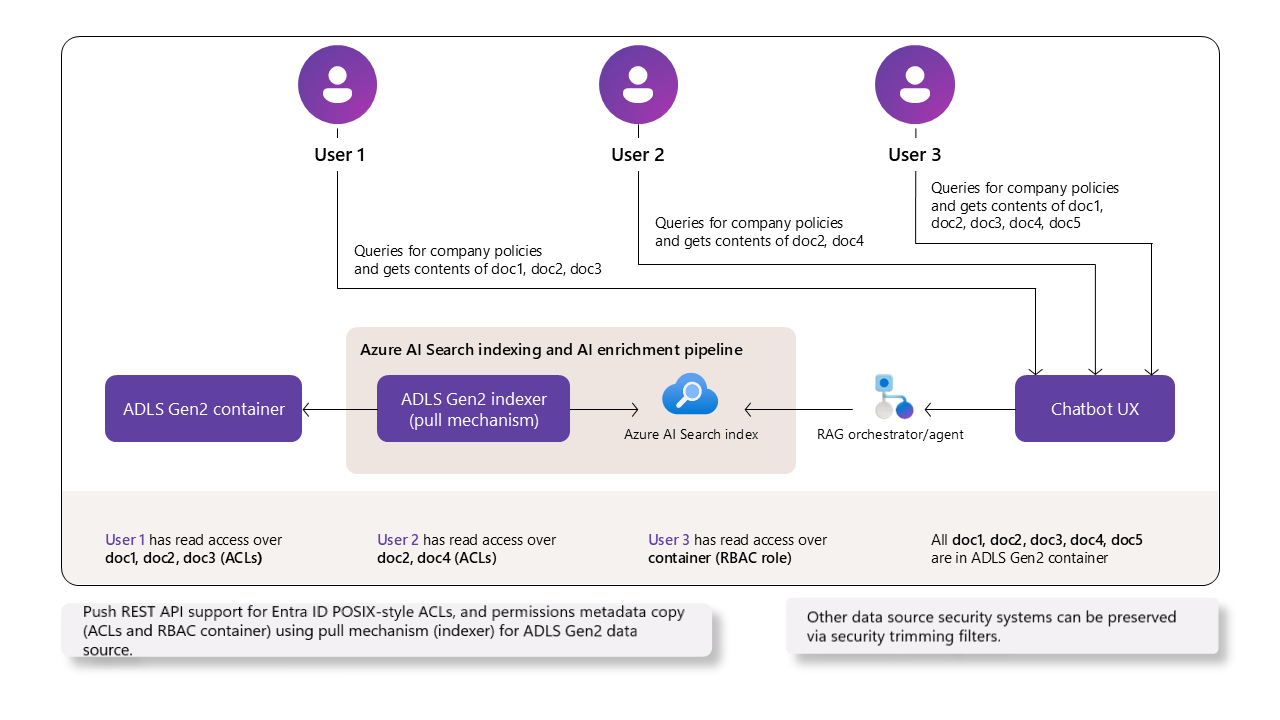
Azure Data Lake Storage (ADLS) Gen2 stöder åtkomst per användare till kataloger och filer via åtkomstkontrollistor (ACL) och role-baserad åtkomstkontroll (Azure RBAC). Attribute-baserad åtkomstkontroll (Azure ABAC) stöds inte.
Azure AI-sökning kan mata in dessa behörighetsmetadata (förhandsversion) tillsammans med dokumentinnehåll med hjälp av ett REST API för förhandsversion. Användare som saknar åtkomst till en katalog eller fil i lagringen ser inte motsvarande dokument i sökresultaten. Detta är en av flera strategier för åtkomstkontroll på dokumentnivå i Azure AI-sökning.
Den här artikeln beskriver hur du konfigurerar en ADLS Gen2-indexerare eller en ADLS Gen2-blob-kunskapskälla för att automatiskt hämta behörighetsmetadata till ett sökindex. Den kompletterar indexdata från ADLS Gen2 och Skapa en blob-kunskapskälla för ADLS Gen2 med information som är specifik för behörighetsinmatning. Information om hur du skickar behörighetsmetadata manuellt finns i Indexera dokument-ACL:er med push-API:et.
Förutsättningar
Microsoft Entra ID autentisering och auktorisering. Tjänster och appar måste finnas i samma klientorganisation. Användare kan finnas i olika klientorganisationer så länge alla klienter använder Microsoft Entra ID. Rolltilldelningar används för varje autentiserad anslutning.
Azure AI-sökning på en fakturerbar nivå (Basic eller högre) i valfri region. Söktjänsten måste ha rollbaserad åtkomst aktiverad och en systemtilldelad eller användartilldelad hanterad identitet.
ADLS Gen2-blobar i ett hierarkiskt namnområde med användarbehörigheter som beviljas via ACL:er eller roller.
REST API version 2025-05-01-preview eller senare för indexerarens behörighetsinmatning. REST API version 2025-11-01-preview eller senare för stöd för kunskapskällor. Använd det senaste rest-API:et för förhandsversionen eller ett förhandsversions-SDK-paket som stöder behörighetsfilter.
Begränsningar
Den Azure portalen stöder inte den här funktionen.
ADLS Gen2-gränser för rolltilldelningar och ACL-poster gäller.
Identitetskategorierna
owning users,owning groupsochOther(all) ACL stöds inte under förhandsversionen. Användnamed usersochnamed groupstilldelningar i stället.Följande indexeringsfunktioner stöder inte behörighetsarv i indexerade dokument från ADLS Gen2. Om du använder någon av dessa funktioner i en kompetensuppsättning eller indexerare ingår inte behörigheter på dokumentnivå i det indexerade innehållet.
Kunskapslager, inklusive det resurslager som krävs för bildvisning (förhandsversion) i agentbaserad hämtning. Därför stöds inte bildservering för kunskapskällor som matar in ACL:er eller RBAC-omfång.
Stöd för behörighetsmodellen
I det här avsnittet jämförs åtkomstkontrollfunktioner på dokumentnivå mellan ADLS Gen2 och Azure AI-sökning. Den förklarar vilka Azure Data Lake Storage (ADLS) Gen2-åtkomstkontrollmekanismer AI Search stöder eller mappar. Detta hjälper dig att förstå hur behörigheter tillämpas på dokumentnivå.
| ADLS Gen2-funktion | Beskrivning | Stöds | Anteckningar |
|---|---|---|---|
| RBAC | Grovkornig åtkomst på containernivå | Ja | AI Search hedrar RBAC för åtkomst till alla dokument i hela containern. |
| ABAC | Attributbaserade villkor ovanpå RBAC | Nej | AI Search utvärderar inte ABAC-villkor för åtkomst på dokumentnivå. |
| ACL | Detaljerade behörigheter på katalog-/filnivå (dokument) | Ja | AI Search använder ACL:er på dokumentnivå för behörighetsfilter. |
| Säkerhetsgrupper | Gruppbaserade behörighetstilldelningar | Ja | Stöds om säkerhetsgrupper mappas i ACL på dokumentnivå. |
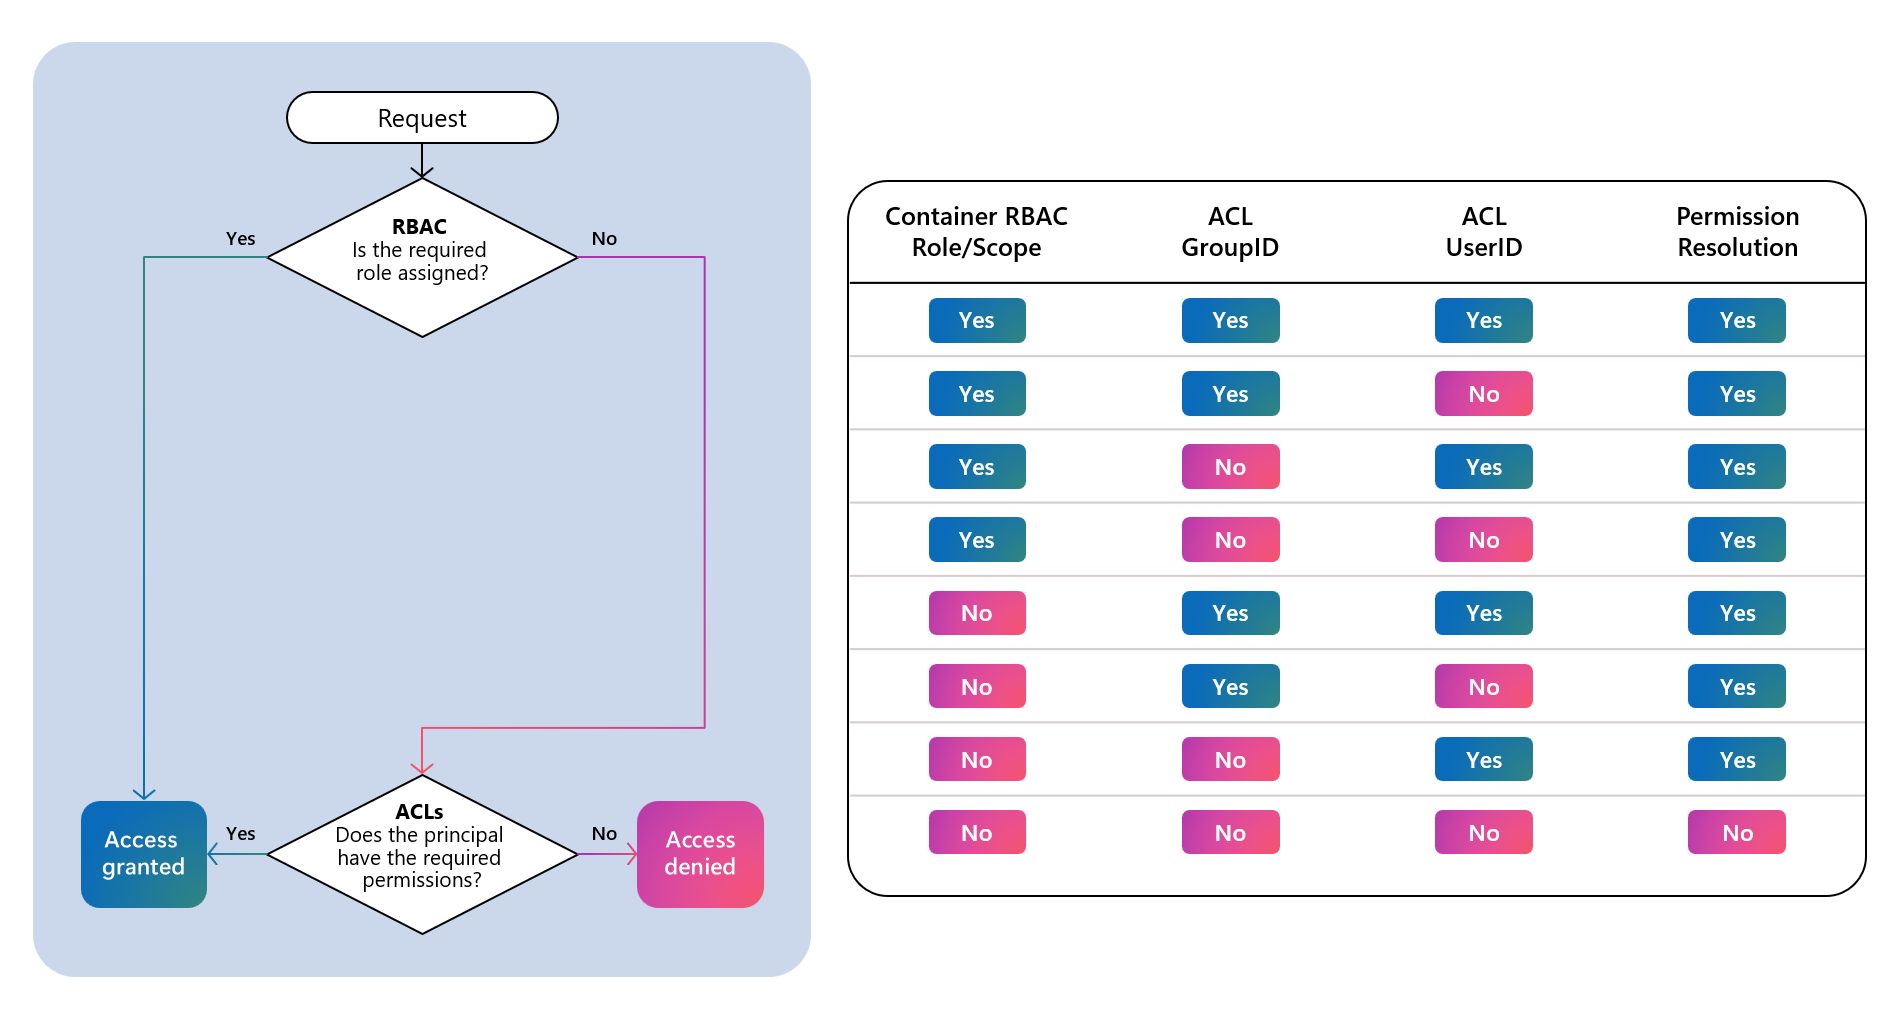
Vid frågetillfället utvärderar Azure AI-sökning RBAC på containernivå först och kontrollerar sedan ACL-poster på dokumentnivå. Åtkomst beviljas om någon mekanism tillåter det.
Om ACL-hierarkiska behörigheter
Indexerare och kunskapskällor kan hämta ACL-tilldelningar från den angivna containern och alla kataloger som leder till varje fil genom att följa ADLS Gen2-flödet för hierarkisk åtkomstutvärdering. De slutliga effektiva åtkomstlistorna för varje fil beräknas och de olika åtkomstkategorierna indexeras i motsvarande indexfält.
I till exempel ADLS Gen2 vanliga scenarier som rör behörigheter som filsökvägen /Oregon/Portland/Data.txt.
| Operation | / | Oregon/ | Portland/ | Data.txt |
|---|---|---|---|---|
| Läs Data.txt | --X | --X | --X | R-- |
Indexeraren eller kunskapskällan samlar in ACL:er från varje container och katalog. Den fastställer sedan effektiv åtkomst på lägre nivåer och fortsätter tills den löser behörigheter för varje fil.
/ assigned access vs Oregon/ assigned access
  => Oregon/ effective access vs Portland/ assigned access
    => Portland/ effective access vs Data.txt assigned access
      => Data.txt effective access
Konfigurera ADLS Gen2
En indexerare eller kunskapskälla kan hämta ACL:er på ett lagringskonto om följande villkor uppfylls. Mer information om ACL-tilldelningar finns i ADLS Gen2 ACL-tilldelningar.
Tillstånd
För indexering måste din söktjänstidentitet ha behörigheten Storage Blob Data Reader .
Om du testar lokalt bör du också ha en rolltilldelning för Storage Blob Data Reader . Mer information finns i Anslut till Azure Storage med hjälp av en hanterad identitet.
Behörigheter för rotcontainer
Tilldela alla
GroupochUseruppsättningar (säkerhetsobjekt) i rotcontainern/medReadochExecutebehörigheter.Se till att både
ReadochExecuteläggs till som "Standardbehörigheter" så att de sprids till nyligen skapade filer och kataloger automatiskt.
Sprida behörigheter nedåt i filhierarkin
Även om nya kataloger och filer ärver behörigheter ärver befintliga kataloger och filer inte automatiskt dessa tilldelningar.
Använd ADLS Gen2-verktyget för att tillämpa ACL:er rekursivt för tilldelningar som sprids på befintligt innehåll. Det här verktyget sprider rotcontainerns ACL-tilldelningar till alla underliggande kataloger och filer.
Ta bort överflödiga behörigheter
När du har tillämpat ACL:er rekursivt granskar du behörigheter för varje katalog och fil.
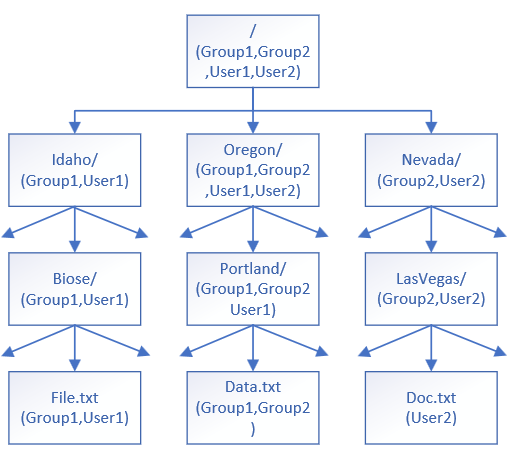
Ta bort alla Group eller User uppsättningar som inte ska ha åtkomst till specifika kataloger eller filer. Ta till exempel bort User2 från mappen Portland/, och för mappen Idaho ta bort Group2 och User2 från dess tilldelningar och så vidare.
Exempel på ACL-tilldelningsstruktur
Här är ett diagram över ACL-tilldelningsstrukturen för den fiktiva kataloghierarkin i ADLS Gen2-dokumentationen.
Uppdatera ACL-tilldelningar över tid
När nya ACL-tilldelningar läggs till eller ändras upprepar du med tiden föregående steg för att säkerställa korrekt spridning och behörighetsjustering. Uppdaterade behörigheter i ADLS Gen2 uppdateras i sökindexet när du matar in innehållet igen med hjälp av indexeraren eller kunskapskällan.
Konfigurera Azure AI-sökning
Kom ihåg att söktjänsten måste ha:
Tillstånd
För indexering måste klienten som utfärdar API-anropet ha behörigheten Search Service-deltagare för att kunna skapa objekt, behörigheten Search Index Data Contributor att utföra dataimport och Search Index Data Reader för att köra frågor mot ett index.
Om du testar lokalt bör du ha samma rolltilldelningar. Mer information finns i Anslut till Azure AI-sökning med hjälp av roller.
Konfigurera en kunskapskälla
Om du använder en kunskapskälla används definitioner i kunskapskällan för att generera en fullständig indexeringspipeline (indexerare, datakälla och index). ACL-tilldelningar identifieras och inkluderas automatiskt i det genererade indexet. Du behöver inte ändra något av de genererade objekten om du vill ha behörighetsarv i ditt indexerade innehåll.
Viktiga punkter om konfigurationen som gör att det fungerar för det här scenariot:
-
isADLSGen2är inställt på true och uppfyller datakällans krav för det här scenariot. -
ingestionPermissionOptionsanger användar- och grupp-ID:t.
# Create / Update Azure Blob Knowledge Source
###
PUT {{url}}/knowledgesources/azure-blob-ks?api-version=2026-08-01-preview
api-key: {{key}}
Content-Type: application/json

{
    "name": "azure-blob-ks",
    "kind": "azureBlob",
    "description": "A sample azure blob knowledge source",
    "azureBlobParameters": {
        "connectionString": "{{blob-connection-string}}",
        "containerName": "blobcontainer",
        "folderPath": null,
        "isADLSGen2": true,
        "ingestionParameters": {
            "identity": null,
            "embeddingModel": {
                "kind": "azureOpenAI",
                "azureOpenAIParameters": {
                    "deploymentId": "text-embedding-3-large",
                    "modelName": "text-embedding-3-large",
                    "resourceUri": "{{aoai-endpoint}}",
                    "apiKey": "{{aoai-key}}"
                }
            },
            "chatCompletionModel": null,
            "disableImageVerbalization": true,
            "ingestionSchedule": null,
             "ingestionPermissionOptions": [
                "userIds","groupIds"
                           ],
            "contentExtractionMode": "minimal",
            "aiServices": {
                "uri": "{{ai-endpoint}}",
                "apiKey": "{{ai-key}}"
            }
        }
    }
}
###
Konfigurera indexerarbaserad indexering
Om du använder en indexerare konfigurerar du den, datakällan och indexet för att hämta behörighetsmetadata från ADLS Gen2-blobar.
Skapa datakällan
Det här avsnittet kompletterar Indexdata från ADLS Gen2 med information som är specifik för att mata in behörigheter tillsammans med dokumentinnehåll i ett Azure AI-sökning index.
Datakällans typ måste vara
adlsgen2.Datakällan måste ha
indexerPermissionOptionsmeduserIds,groupIdsoch/ellerrbacScope.För
rbacScopekonfigurerar du reťazec pripojenia med hanterat identitetsformat.För anslutningssträngar med hjälp av en användartilldelad hanterad identitet måste du också ange egenskapen
identity.
JSON-exempel med systemhanterad identitet:
{
    "name" : "my-adlsgen2-acl-datasource",
    "type": "adlsgen2",
    "indexerPermissionOptions": ["userIds", "groupIds", "rbacScope"],
    "credentials": {
    "connectionString": "ResourceId=/subscriptions/<your subscription ID>/resourceGroups/<your resource group name>/providers/Microsoft.Storage/storageAccounts/<your storage account name>/;"
    },
    "container": {
    "name": "<your container name>",
    "query": "<optional-virtual-directory-name>"
    }
}
JSON-schemaexempel med en användarhanterad identitet i reťazec pripojenia:
{
    "name" : "my-adlsgen2-acl-datasource",
    "type": "adlsgen2",
    "indexerPermissionOptions": ["userIds", "groupIds", "rbacScope"],
    "credentials": {
    "connectionString": "ResourceId=/subscriptions/<your subscription ID>/resourceGroups/<your resource group name>/providers/Microsoft.Storage/storageAccounts/<your storage account name>/;"
    },
    "container": {
    "name": "<your container name>",
    "query": "<optional-virtual-directory-name>"
    },
    "identity": {
    "@odata.type": "#Microsoft.Azure.Search.DataUserAssignedIdentity",
    "userAssignedIdentity": "/subscriptions/{subscription-ID}/resourceGroups/{resource-group-name}/providers/Microsoft.ManagedIdentity/userAssignedIdentities/{user-assigned-managed-identity-name}"
    }
}
Skapa behörighetsfält i indexet
I Azure AI-sökning kontrollerar du att ditt index innehåller fältdefinitioner för behörighetsmetadata. Behörighetsmetadata kan indexeras när indexerPermissionOptions anges i datakällans definition.
Rekommenderade schemaattribut för ACL (UserIds, GroupIds) och RBAC-omfång:
- Fältet för Användaridentifierare (ID) med värdet för tillståndsfilter
userIds. - Fältet Grupp-ID med värde för behörighetsfilter
groupIds. - RBAC-omfångsfält med
rbacScopebehörighetsfiltervärde. - Egenskap
permissionFilterOptionför att aktivera filtrering vid frågetillfället. - Använda strängfält för behörighetsmetadata
- Ställ in
filterablepå sant för alla fält.
Observera att det retrievable är falskt. Du kan ställa in det till true under utvecklingen för att kontrollera att behörigheter finns, men kom ihåg att återgå till false innan du distribuerar till en produktionsmiljö.
JSON-schemaexempel:
{
  ...
  "fields": [
    ...
    { "name": "UserIds", "type": "Collection(Edm.String)", "permissionFilter": "userIds", "filterable": true, "retrievable": false },
    { "name": "GroupIds", "type": "Collection(Edm.String)", "permissionFilter": "groupIds", "filterable": true, "retrievable": false },
    { "name": "RbacScope", "type": "Edm.String", "permissionFilter": "rbacScope", "filterable": true, "retrievable": false }
  ],
  "permissionFilterOption": "enabled"
}
Konfigurera indexeraren
Fältmappningar i en indexerare anger datasökvägen till fält i ett index. Mål- och målfält som varierar beroende på namn eller datatyp kräver en explicit fältmappning. Följande metadatafält i ADLS Gen2 kan behöva fältmappningar om du varierar fältnamnet:
-
metadata_user_ids (
Collection(Edm.String)) – listan med ACL-användar-ID:t. -
metadata_group_ids (
Collection(Edm.String)) – listan med ACL-grupp-ID:t. -
metadata_rbac_scope (
Edm.String) – containerns RBAC-omfång.
Ange fieldMappings i indexeraren att dirigera behörighetsmetadata till målfält under indexering.
JSON-schemaexempel:
{
  ...
  "fieldMappings": [
    { "sourceFieldName": "metadata_user_ids", "targetFieldName": "UserIds" },
    { "sourceFieldName": "metadata_group_ids", "targetFieldName": "GroupIds" },
    { "sourceFieldName": "metadata_rbac_scope", "targetFieldName": "RbacScope" }
  ]
}
Rekommendationer och metodtips
Planera ADLS Gen2-mappstrukturen noggrant innan du skapar några mappar.
Organisera identiteter i grupper och använd grupper när det är möjligt, i stället för att ge åtkomst direkt till enskilda användare. Genom att kontinuerligt lägga till enskilda användare i stället för att tillämpa grupper ökar antalet åtkomstkontrollposter som måste spåras och utvärderas. Om du inte följer den här bästa metoden kan det leda till mer frekventa uppdateringar av säkerhetsmetadata som krävs för indexet när dessa metadata ändras, vilket orsakar ökade fördröjningar och ineffektivitet i uppdateringsprocessen.
Synkronisera behörigheter mellan indexerat innehåll och källinnehåll
Aktivering av ACL- eller RBAC-berikning på en indexerare fungerar bara automatiskt i två situationer:
Den allra första fullständiga indexeringskörningen/datakrypningen: alla behörighetsmetadata som finns vid den tidpunkten för varje dokument registreras.
Helt nya dokument har lagts till efter att ACL/RBAC-stöd har aktiverats: deras ACL/RBAC-information matas in tillsammans med deras innehåll.
Om du ändrar dokumentbehörigheter, till exempel att lägga till en användare i en ACL eller uppdatera en rolltilldelning, visas inte ändringen i sökindexet om du inte uppmanar indexeraren att crawla dokumentets behörighetsmetadata igen.
Välj någon av följande mekanismer, beroende på hur många objekt som har ändrats:
| Omfång för ändringen | Bästa utlösare | Vad uppdateras vid nästa körning |
|---|---|---|
| En enda blob eller bara en handfull | Uppdatera blobens tidsstämpel Last-Modified i lagringen (tryck på filen) |
Dokumentinnehåll och ACL/RBAC-metadata |
| Dussintals till tusentals blobar | Anropa /resetdocs (förhandsversion) och lista de berörda dokumentnycklarna. | Dokumentinnehåll och ACL/RBAC-metadata |
| Hela datakällan | Anropa /resync (förhandsversion) med alternativet för behörigheter. | Bara ACL/RBAC-metadata (innehållet lämnas orört) |
Resetdocs (förhandsversion) API-exempel:
POST https://{service}.search.windows.net/indexers/{indexer}/resetdocs?api-version=2026-08-01-preview
{
  "documentKeys": [
    "1001",
    "4452"
  ]
}
Omsynkronisera (förhandsversion) API-exempel:
POST https://{service}.search.windows.net/indexers/{indexer}/resync?api-version=2026-08-01-preview
{
  "options": [
    "permissions"
  ]
}
Viktigt
Om du ändrar behörigheter för indexerade dokument och inte utlöser någon av mekanismerna ovan fortsätter sökindexet att betjäna inaktuella ACL- eller RBAC-data. Nya dokument fortsätter att indexeras automatiskt. ingen manuell utlösare behövs för dem.
Borttagningsspårning
Om du vill hantera blobborttagning effektivt kontrollerar du att borttagningsspårning är aktiverat innan indexeraren körs för första gången. Med den här funktionen kan systemet identifiera borttagna blobar i källan och ta bort dem från indexet.