Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Note
Azure AI-sökning är tillgängligt via Azure-portalen, REST-API:er och Azure-SDK:er. Den ligger också till grund för Foundry IQ, det hanterade kunskapsskiktet som omvandlar företagsinnehåll till återanvändbara, behörighetsmedvetna kunskapsbaser för agenter i Microsoft Foundry-portalen.
Felsökningssessioner är en visuell redigerare som fungerar med en befintlig kompetensuppsättning i Azure-portalen, som exponerar strukturen och innehållet i ett enda berikat dokument när det produceras av en indexerare och kompetensuppsättning under hela sessionen. Eftersom du arbetar med ett livedokument är sessionen interaktiv – du kan identifiera fel, ändra och köra en färdighet samt verifiera resultatet i realtid. Om dina ändringar löser problemet kan du överföra dem till en publicerad färdighetsuppsättning för att tillämpa korrigeringarna globalt.
I den här artikeln beskrivs scenarier som stöds och hur redigeraren är organiserad. Flikar och avsnitt i redigeraren packar upp olika lager av kunskapsuppsättningen så att du kan undersöka kompetensuppsättningens struktur, flöde och det innehåll som genereras vid körning.
Stödda scenarier
Använd Felsökningssessioner för att undersöka och lösa problem med:
Inbyggda kunskaper som används för AI-berikning, till exempel OCR, bildanalys, entitetsigenkänning och extrahering av nyckelord.
Inbyggda färdigheter som används för integrerad vektorisering, med datasegmentering via Text Split och vektorisering via en inbäddningsfärdighet.
Anpassade kunskaper som används för att integrera extern bearbetning som du tillhandahåller.
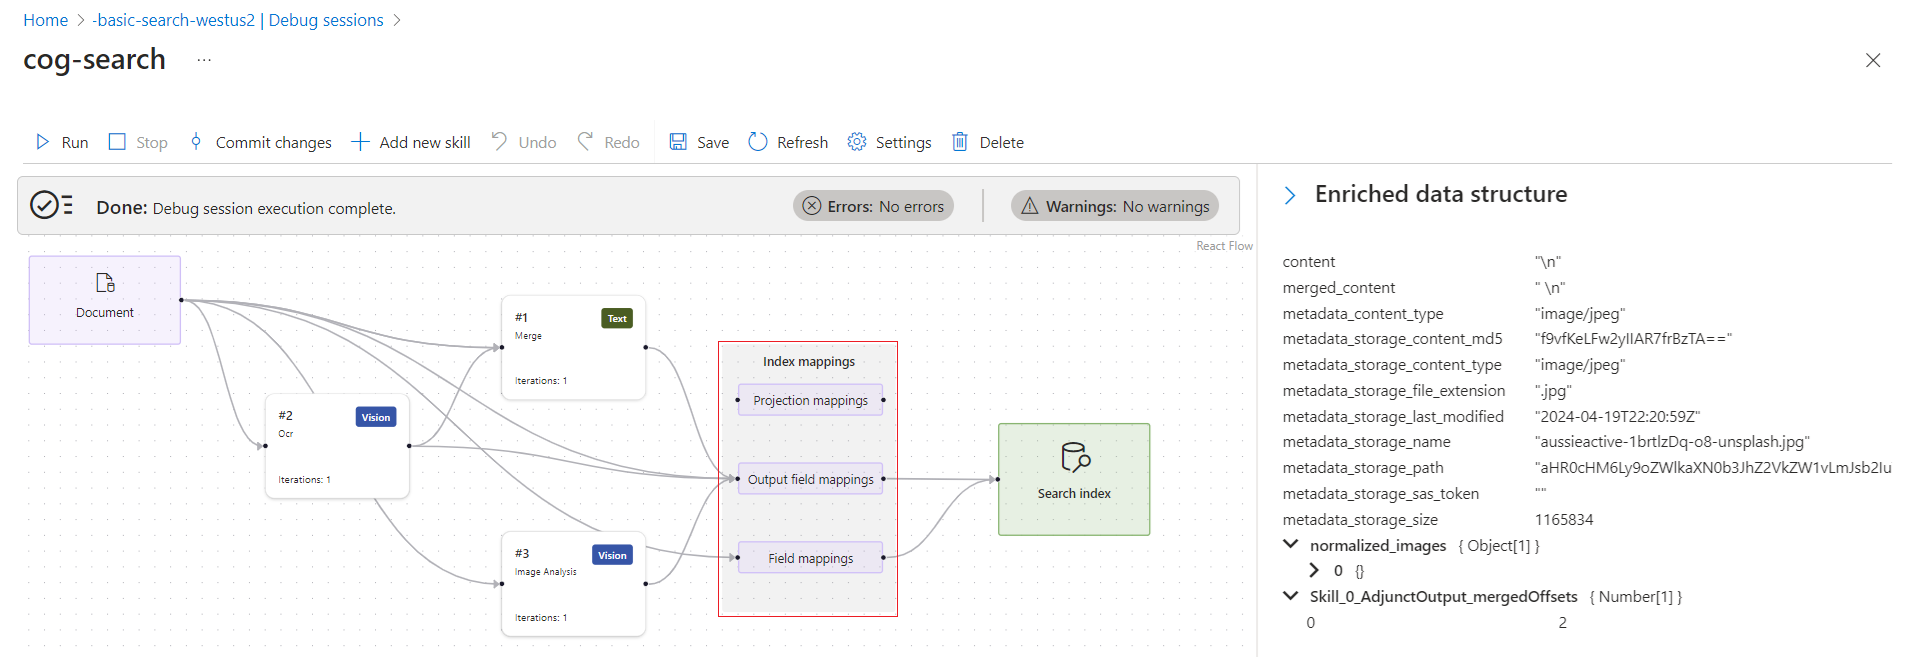
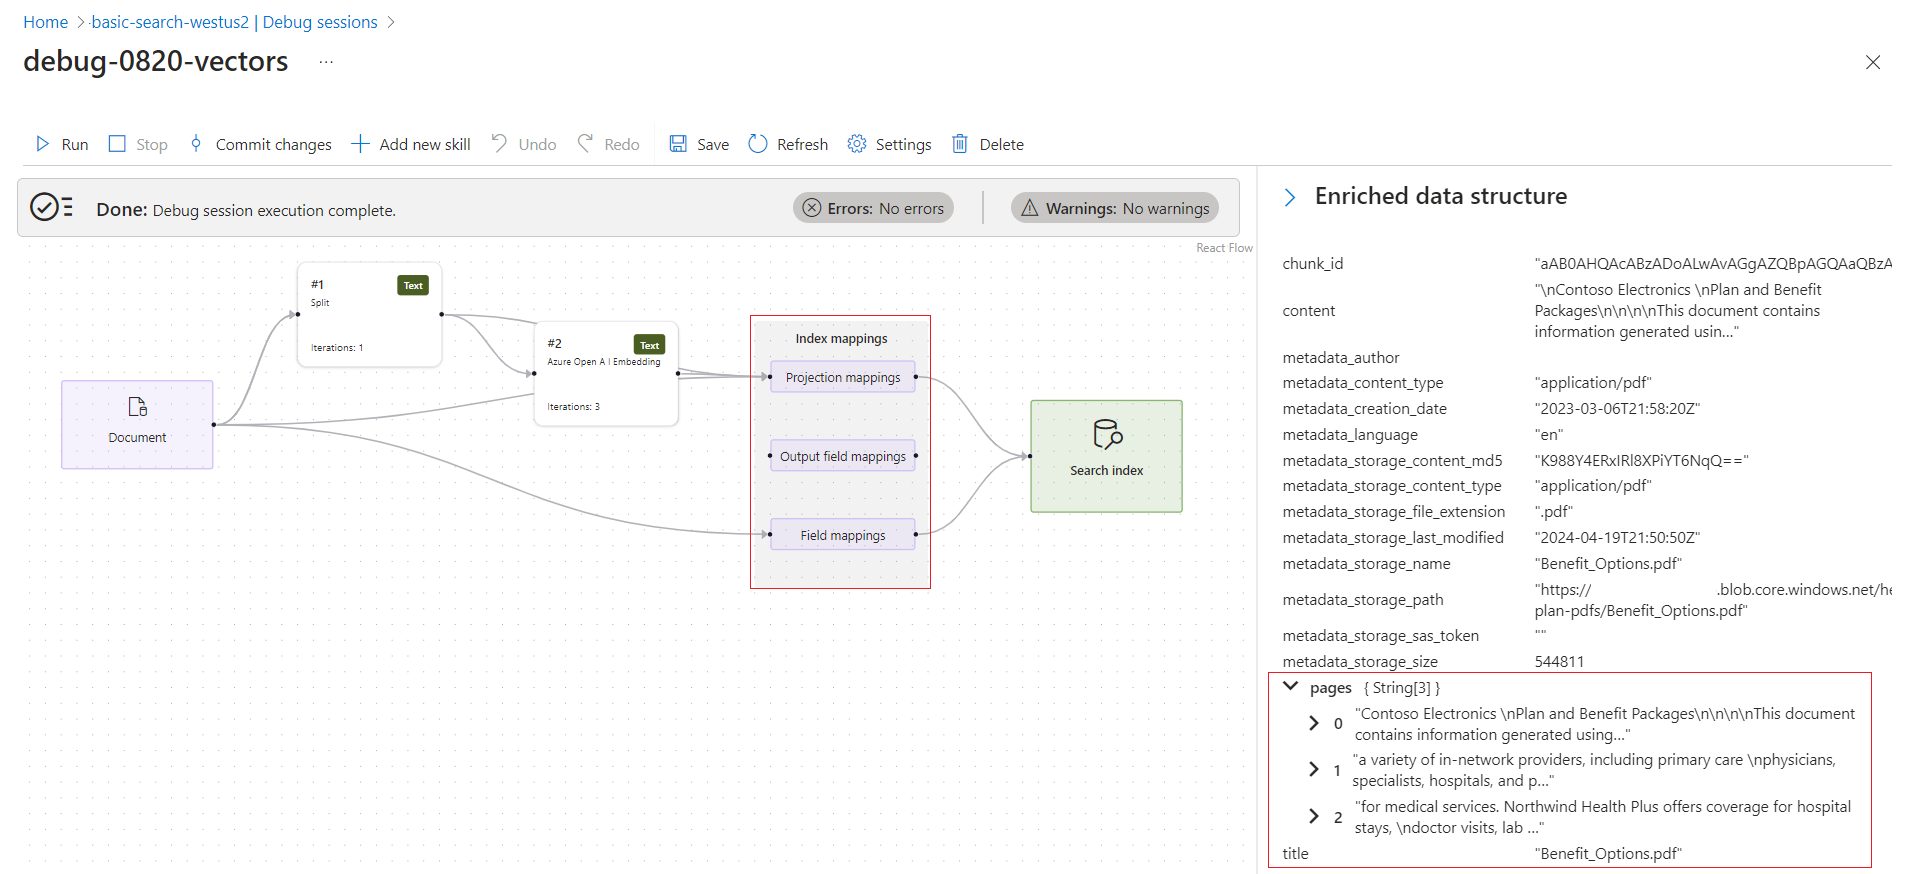
Jämför följande felsökningssessionsbilder för de två första scenarierna. I båda scenarierna visar ytan utvecklingen av färdigheter som genererar eller transformerar innehåll på väg från källdokumentet till sökindexet. Flödet innehåller indexmappningsalternativ och du kan spåra pilarna för att följa bearbetningsspåret. Informationsfönstret till höger är kontextkänsligt. Den visar en representation av det berikade dokumentet som skapas av pipelinen, eller information om en färdighet eller mappning.
Den första bilden visar ett mönster för tillämpad AI-berikning (inga vektorer). Färdigheter kan köras sekventiellt eller parallellt om det inte finns några beroenden. Indexmappningar visar hur berikat eller genererat innehåll överförs från minnesinterna datastrukturer till fält i ett index. Berikat dokument visar den datastruktur som kompetensuppsättningen skapar.
Den andra bilden visar ett typiskt mönster för integrerad vektorisering. Kunskaper för integrerad vektorisering omfattar vanligtvis en kunskap om textdelning och en inbäddningsfärdighet. En kunskap om textdelning delar upp ett dokument i segment. En inbäddningsfärdighet anropar ett inbäddnings-API för att vektorisera dessa segment. Den här färdigheten delar upp innehåll i en samling av "sidor". För integrerad vektorisering styr projektionsmappningar hur segment mappas till fält i indexet.
Begränsningar
Felsökningssessioner fungerar med alla allmänt tillgängliga indexeringsdatakällor och de flesta förhandsgranskningsdatakällor, med följande undantag:
SharePoint-indexerare.
Azure Cosmos DB för MongoDB-indexeraren.
Om en rad misslyckas under indexet och det inte finns några motsvarande metadata för Azure Cosmos DB för NoSQL kanske felsökningssessionen inte väljer rätt rad.
Om en partitionerad samling tidigare inte partitionerades för SQL-API:et för Azure Cosmos DB hittar inte felsökningssessionen dokumentet.
För anpassade kunskaper stöds inte en användartilldelad hanterad identitet för en felsökningssessionsanslutning till Azure Storage. Som anges i förhandskraven kan du använda en systemhanterad identitet eller ange en fullständig åtkomst anslutningssträng som innehåller en nyckel. Mer information finns i Ansluta en söktjänst till andra Azure-resurser med hjälp av en hanterad identitet.
Datakällor med kryptering aktiverat via kundhanterade nycklar (CMK).
Delade privata länkar stöds inte. Om din söktjänst använder privat slutpunktsanslutning för att nå datakällor eller andra resurser kan felsökningssessioner inte komma åt dessa resurser. En lösning finns i Felsöka sessioner och privat anslutning.
För närvarande är möjligheten att välja vilket dokument som ska felsökas inte tillgänglig. Den här begränsningen är inte permanent och bör hävas snart. Just nu väljer Felsökningssessioner det första dokumentet i källdatacontainern eller mappen.
Så här fungerar en felsökningssession
När du startar en session skapar söktjänsten en kopia av kompetensuppsättningen, indexeraren och en datakälla som innehåller ett enda dokument som används för att testa kompetensuppsättningen. Tjänsten Azure AI-sökning sparar alla sessionstillstånd till en ny blobcontainer som skapas i ett Azure Storage konto som du anger. Det genererade containernamnet har prefixet ms-az-cognitive-search-debugsession. Det här prefixet minskar risken för att oavsiktligt exportera sessionsdata till en annan container i ditt konto.
Om du konfigurerar anslutningen till lagringskontot med hjälp av en hanterad identitet tilldelar du Storage Blob Data Contributor rollen till din söktjänstidentitet på lagringskontot. I ditt lagringskonto aktiverar du betrodda tjänster för att tillåta skrivåtkomst från Azure AI-sökning.
En cachelagrad kopia av det berikade dokumentet och kompetensuppsättningen läses in i den visuella redigeraren så att du kan granska innehållet och metadata i det berikade dokumentet, med möjlighet att kontrollera varje dokumentnod och redigera alla aspekter av kompetensuppsättningsdefinitionen. Alla ändringar som görs i sessionen cachelagras. Dessa förändringar kommer inte att påverka det publicerade färdighetssettet om du inte committar dem. Genomförande av ändringar kommer att skriva över produktionsfärdigheterna.
Om berikningspipelinen inte har några fel kan en felsökningssession användas för att stegvis utöka ett dokument, testa och verifiera varje ändring innan du genomför ändringarna.
Felsökningssessioner hjälper dig att identifiera rotorsaken till fel eller varningar genom att analysera data, kunskapsindata och utdata samt fältmappningar. Använd fönstret kunskapsinformation för att kontrollera vad varje färdighet får som indata och producerar som utdata. Den här inspektionen hjälper dig att kontrollera att kunskapsdefinitioner, uttryck och fältmappningar är korrekt utformade. Om indexeraren stöter på konfigurationsproblem, till exempel felaktig nätverkskonfiguration eller behörighetsrelaterade åtkomstfel, läser du det specifika felmeddelandet och den länkade dokumentationen. Felsökningsvägledning finns i Vanliga indexeringsfel och varningar.
Felsöka sessioner och privat anslutning
Felsökningssessioner stöder inte delade privata länkar. Om din tjänst för produktionssökning använder privat slutpunktsanslutning för att komma åt datakällor eller andra resurser kan felsökningssessioner inte köras mot den tjänsten.
Lösning: använd en testsöktjänst
Om du vill felsöka din kompetensuppsättning skapar du en separat Azure AI-sökning tjänst utan begränsningar för privat anslutning. Om du vill hålla produktionsdata och schemainformation borta från en icke-privat miljö skapar du testkonfigurationen med syntetiska dokument:
- Skapa testdokument som matchar fälttyperna och strukturen för dina produktionsdata, men använd allmänna fältnamn (till exempel
content, ,titlecategory) och platshållarvärden i stället för verkliga data. Kompetensuppsättningslogik beror på innehållstyper och struktur, inte specifika fältnamn. - Kopiera JSON-filen för kompetensuppsättningen från din produktionstjänst. Om kunskapsindata refererar till namn på produktionsfält uppdaterar du dessa referenser så att de matchar dina allmänna testfältnamn. Använd fältmappningar i testindexeraren för att justera testfältnamn med kunskapsuppsättningsindata.
- Konfigurera en indexerare så att den körs mot testdatakällan.
Kör felsökningssessionen i testtjänsten för att inspektera kunskapsindata och utdata, validera kunskapsuttryck och fältmappningar och identifiera fel. När dina ändringar har verifierats återställer du referenserna för det ursprungliga produktionsfältets namn i kunskapsuppsättningens JSON och tillämpar dem på produktionstjänsten igen.
Felsökningssessionslayout
Den visuella redigeraren är organiserad som ett gränssnitt som visar en sekvens av åtgärder, som börjar med delning av dokument, följt av funktioner, mappningar och ett index.
Välj en färdighet eller mappning, och ett fönster öppnas vid sidan av med relevant information.
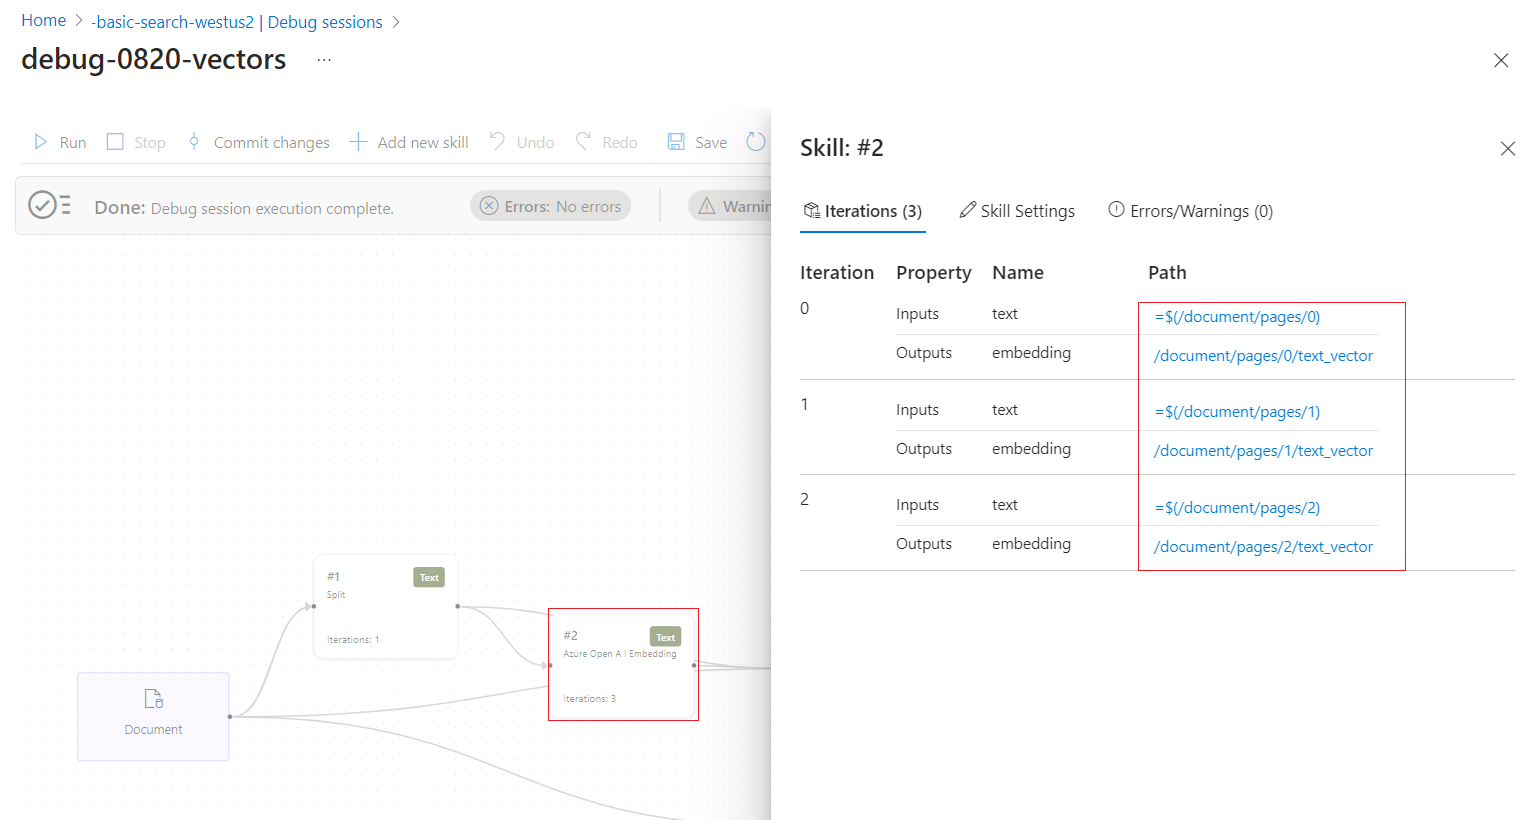
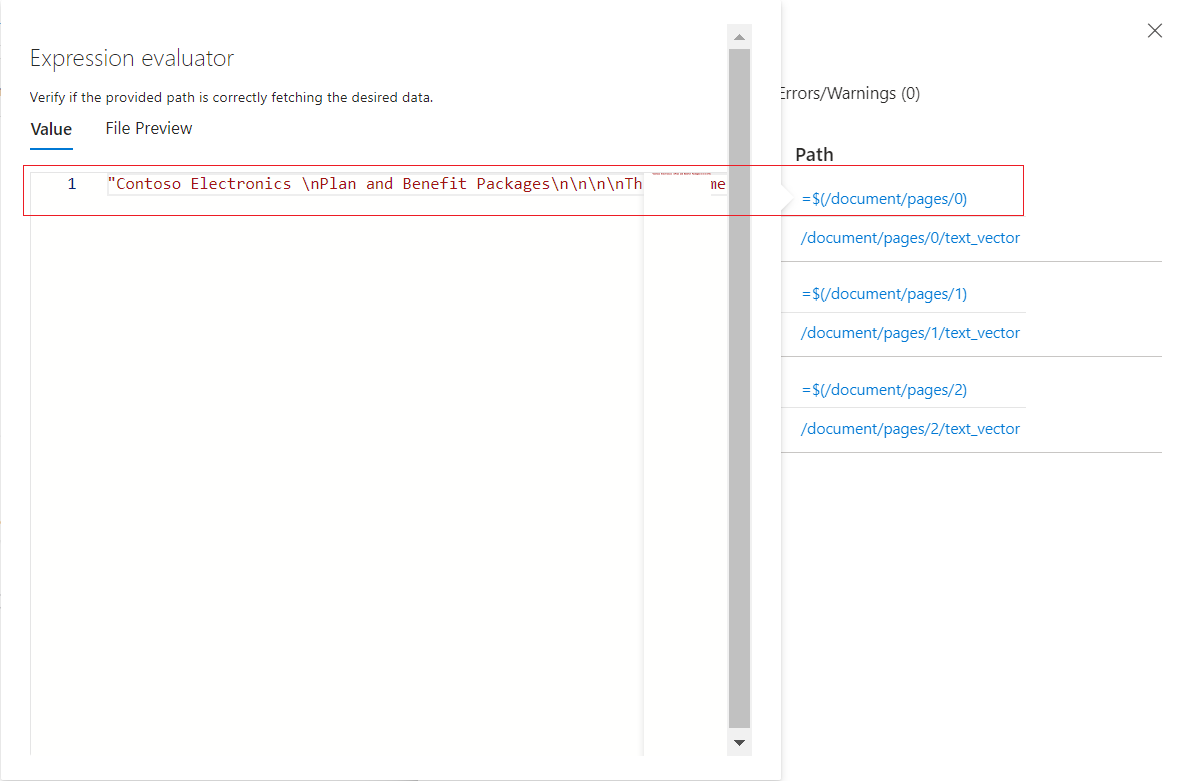
Följ länkarna för att öka detaljnivån i kompetensbearbetningen. Följande skärmbild visar till exempel utdata från den första iterationen av färdigheten Textdelning.
Fönstret för Kompetensdetaljer
Fönstret Kunskapsinformation innehåller följande avsnitt:
- Iterationer: Visar hur många gånger en färdighet körs. Du kan kontrollera indata och utdata för var och en.
- Kunskapsinställningar: Visa eller redigera JSON-kompetensuppsättningsdefinitionen.
- Fel och varningar: Visar de fel eller varningar som är specifika för den här färdigheten.
Fönstret Utökad datastruktur
Fönstret Berikad datastruktur skjuts ut åt sidan när du väljer den blå visa eller dölj pilsymbolen. Det är en mänsklig läsbar representation av vad det berikade dokumentet innehåller. Föregående skärmbilder i den här artikeln visar exempel på den berikade datastrukturen.
Nästa steg
Nu när du förstår elementen i felsökningssessioner startar du din första felsökningssession på en befintlig kompetensuppsättning.