Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Observera
Azure AI-sökning är tillgängligt via Azure-portalen, REST-API:er och Azure-SDK:er. Den ligger också till grund för Foundry IQ, det hanterade kunskapsskiktet som omvandlar företagsinnehåll till återanvändbara, behörighetsmedvetna kunskapsbaser för agenter i Microsoft Foundry-portalen.
I Azure AI-sökning kan du köra en indexerare på flera sätt:
- Kör omedelbart när indexeraren skapas. Det här alternativet är standard om du inte skapar indexeraren i inaktiverat tillstånd.
- Kör enligt ett schema för att anropa körning med jämna mellanrum. Om en schemalagd indexerare slutar utlösa kan du läsa Vanliga frågor och svar om schemaläggningsbeteende för återställningssteg.
- Kör vid behov, med eller utan återställning.
Den här artikeln beskriver hur du kör indexerare på begäran, med och utan återställning. Den beskriver även indexeringsprogrammets utförande, varaktighet och parallellitet.
Så här ansluter indexerare till Azure resurser
Indexerare är ett av de få undersystem som gör utgående anrop till andra Azure resurser. Beroende på den externa datakällan kan du använda nycklar eller roller för att autentisera anslutningen.
När det gäller Azure roller har indexerare inte separata identiteter: en anslutning från sökmotorn till en annan Azure resurs använder en söktjänsts system- eller användartilldelade hanterade identitet, plus en rolltilldelning på målresursen Azure. Om indexeraren ansluter till en Azure resurs i ett virtuellt nätverk bör du skapa en delad privat länk för den anslutningen.
Observera
Indexerare fungerar med behörigheter på tjänstnivå i stället för användarbehörigheter. En indexerare kan skriva till valfritt index i söktjänsten, även om du har tilldelat roller för att begränsa åtkomsten till specifika index. Mer information finns under Omfång och indexeringsåtgärder per index.
Indexerkörning
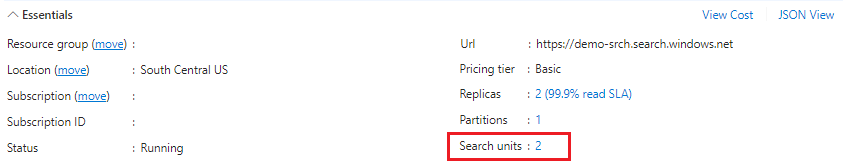
En söktjänst kör ett indexerarjobb per sökenhet. Varje söktjänst börjar med en sökenhet, men varje ny partition eller replik ökar sökenheterna för din tjänst. Du kan kontrollera antalet sökenheter i Azure portalens essential-avsnitt på sidan Overview. Om du behöver samtidig bearbetning kontrollerar du att sökenheterna innehåller tillräckligt många repliker. Indexerare körs inte i bakgrunden, så du kan uppleva mer begränsning av förfrågningar än vanligt om tjänsten är under belastning.
Följande skärmbild visar antalet sökenheter som avgör hur många indexerare som kan köras samtidigt.
När indexerarens körning startar kan du inte pausa eller stoppa den. Indexerarens körning stoppas när det inte finns fler dokument att läsa in eller uppdatera, eller när den maximala tidsgränsen för körning har uppnåtts.
Du kan köra flera indexerare samtidigt med tillräcklig kapacitet, men varje indexerare är en enda instans. Om du startar en ny instans medan indexeraren redan körs uppstår följande fel: "Failed to run indexer "<indexer name>" error: "Another indexer invocation is currently in progress; concurrent invocations are not allowed."
Körningsmiljö för indexerare
Ett indexeringsjobb körs i en miljö med hanterad körning. För närvarande finns det två miljöer:
En privat exekveringsmiljö körs i sökkluster som är specifika för bara din söktjänst.
En miljö med flera klienter har innehållsprocessorer som Microsoft hanterar och skyddar utan extra kostnad. Den här miljön avlastar beräkningsintensiv bearbetning, så tjänstspecifika resurser är tillgängliga för rutinåtgärder. Så ofta som möjligt genomförs de flesta kompetenser i en miljö med flera klientorganisationer. Den här miljön är standard.
Beräkningsintensiv bearbetning avser kompetensuppsättningar som körs på innehållsprocessorer och indexeringsjobb som bearbetar en stor mängd dokument eller dokument av stor storlek. Heuristik och systeminformation bestämmer icke-kompetensbearbetning på innehållsprocessorer med flera klientorganisationer och är inte under kundkontroll.
Du kan förhindra användningen av multitenantmiljön på Standard2 eller högre tjänster genom att binda en indexerare och bearbetning av kompetensuppsättningar exklusivt till dina sökkluster.
Ange parametern executionEnvironment i indexerarens definition så att den alltid kör en indexerare i den privata körningsmiljön.
IP-brandväggar blockerar miljön för flera klientorganisationer, så om du har en brandvägg skapar du en regel som tillåter processoranslutningar med flera klientorganisationer.
Indexerarens gränser varierar för varje miljö:
| Arbetsbelastning | Maximal varaktighet | Maximalt antal jobb | Körningsmiljö |
|---|---|---|---|
| Privat exekvering | 24 timmar | Ett indexerarjobb per sökenhet1. | Indexering körs inte i bakgrunden. I stället balanserar söktjänsten alla indexeringsjobb mot pågående frågor och objekthanteringsåtgärder (till exempel att skapa eller uppdatera index). När du kör indexerare bör du förvänta dig att se viss frågesvarstid om indexeringsvolymerna är stora. |
| Multitenant | 2 timmar 2 | Obestämd 3 | Eftersom innehållsbearbetningsklustret är multitenant lägger systemet till innehållsprocessorer för att möta efterfrågan. Om du upplever en fördröjning i körning på begäran eller schemalagd körning, beror det förmodligen på att systemet antingen lägger till processorer eller väntar på att en processor ska bli tillgänglig. |
1 Sökenheter kan vara flexibla kombinationer av partitioner och repliker, men indexeringsjobb är inte knutna till det ena eller det andra. Med andra ord, om du har 12 enheter kan du ha 12 indexerarjobb som körs samtidigt i privat exekvering, oavsett hur sökenheterna distribueras.
2 Om det behövs mer än två timmar för att bearbeta alla data aktiverar du ändringsidentifiering och schemalägger indexeraren att köras med 5 minuters intervall för att återuppta indexeringen snabbt om den stoppas på grund av en timeout. Se Indexera en stor datauppsättning för fler strategier.
3 "Obestämd" innebär att gränsen inte kvantifieras av antalet jobb. Vissa arbetsbelastningar, till exempel bearbetning av kompetensuppsättningar, kan köras parallellt, vilket kan resultera i många jobb även om endast en indexerare är inblandad. Även om miljön inte har några begränsningar gäller indexeringsgränser för söktjänsten fortfarande.
Kör utan återställning
En Run Indexer-åtgärd identifierar och bearbetar endast det som behövs för att synkronisera sökindexet med ändringar i den underliggande datakällan. Inkrementell indexering börjar med att hitta ett internt högvattenmärke för att hitta det senast uppdaterade sökdokumentet. Det här dokumentet blir startpunkten för indexeringskörning över nya och uppdaterade dokument i datakällan.
Ändringsidentifiering är viktigt för att avgöra vad som är nytt eller uppdaterat i datakällan. Indexerare använder funktionerna för ändringsidentifiering i den underliggande datakällan för att avgöra vad som är nytt eller uppdaterat i datakällan.
Azure Storage har inbyggd ändringsidentifiering via egenskapen LastModified.
Andra datakällor, till exempel Azure SQL eller Azure Cosmos DB, kräver konfiguration för ändringsidentifiering innan indexeraren kan läsa nya och uppdaterade rader.
Om det underliggande innehållet är oförändrat har en körningsåtgärd ingen effekt. I det här fallet anger indexerarens körningshistorik att 0\0 dokument har bearbetats.
Om du vill bearbeta alla dokument igen måste du återställa indexeraren.
Återställa indexerare
Efter den första körningen håller en indexerare reda på vilka sökdokument som indexeras via ett internt högvattenmärke. Markören exponeras inte, men internt vet indexeraren var den senast stannade.
Om du vill återskapa hela eller en del av ett index använder du Återställ API:er som är tillgängliga på fallande nivåer i objekthierarkin:
- Återställ indexerare rensar högvattenmärket och utför en fullständig omindexering av alla dokument.
- Omsynkronisera indexerare (förhandsversion) utför en effektiv partiell omindexering av alla dokument.
- Återställ dokument (förhandsversion) indexerar om ett visst dokument eller en lista med dokument.
- Återställ färdigheter (förhandsversion) startar bearbetning av färdigheter för en viss färdighet.
Efter återställningen följer du med kommandot Kör för att bearbeta nya och befintliga dokument igen. Du kan inte ta bort överblivna sökdokument som inte har någon motsvarighet i datakällan via återställning och körning. Information om hur du tar bort specifika dokument finns i Ta bort dokument i ett sökindex eller Dokument – Index.
Observera
Tabeller får inte vara tomma. Om du använder TRUNCATE TABLE för att rensa rader tar inte en återställning och omkörning av indexeraren bort motsvarande sökdokument. För att ta bort överblivna sökdokument måste du indexera dem med en borttagningsåtgärd.
Så här återställer och kör du indexerare
Återställning rensar högvattenmärket. Alla dokument i sökindexet flaggas för fullständig överskrivning, utan infogade uppdateringar eller sammanslagning till befintligt innehåll. För indexerare med en kompetensuppsättning och berikningscachelagring (förhandsversion) återställer återställning av indexet också automatiskt kompetensuppsättningen.
Det faktiska arbetet inträffar när du följer en återställning med ett Kör-kommando:
- Alla nya dokument som hittat den underliggande källan läggs till i sökindexet.
- Alla dokument som finns i både datakällan och sökindexet skrivs över i sökindexet.
- Allt förbättrat innehåll som skapas från färdighetsuppsättningar återskapas. Berikningscachen, om den är aktiverad, uppdateras.
Som tidigare nämnts är återställning en passiv åtgärd: du bör följa upp med ett Kör-kommando för att bygga om indexet.
Återställnings-/körningsåtgärder gäller för ett sökindex eller ett kunskapslager, för specifika dokument eller projektioner och för cachelagrade berikanden om en återställning uttryckligen eller implicit innehåller kunskaper.
Återställning gäller också för skapa- och uppdateringsoperationer. Det utlöser inte borttagning eller rensning av överblivna dokument i sökindexet. Mer information om hur du tar bort dokument finns i Dokument – Index.
Du kan inte ångra en återställningsåtgärd.
Gå till söktjänsten i Azure-portalen.
På sidan Översikt väljer du fliken Indexerare .
Välj en indexerare.
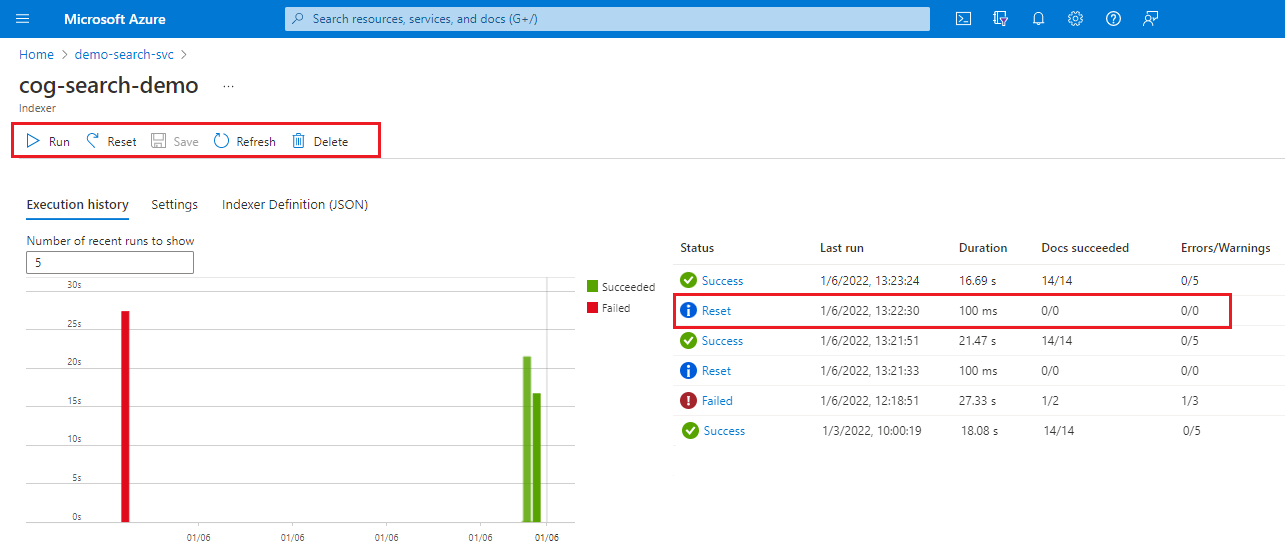
Välj kommandot Återställ och välj sedan Ja för att bekräfta åtgärden.
Uppdatera sidan för att visa statusen. Du kan välja objektet för att visa dess information.
Välj Kör för att starta indexeringsbearbetningen eller vänta på nästa schemalagda körning.
Så här återställer du kunskaper (förhandsversion)
Begäran om återställning av kunskaper bearbetar selektivt en eller flera kunskaper under nästa indexerarkörning. För indexerare som har kompetensuppsättningar kan du återställa enskilda färdigheter för att framtvinga upparbetning av just den kompetensen och eventuella underordnade färdigheter som är beroende av dess utdata. Om du har aktiverat berikningscache uppdateras även begäran.
För indexerare som har cachelagring aktiverat kan du uttryckligen begära bearbetning för kunskapsuppdateringar som indexeraren inte kan identifiera. Om du till exempel gör externa ändringar, till exempel omarbetningar av en anpassad färdighet, använder du det här API:et för att köra färdigheten igen. Processen uppdaterar utdata, till exempel ett kunskapslager eller sökindex, med hjälp av återanvändbara data från cacheminnet och nytt innehåll enligt den uppdaterade färdigheten.
Använd det senaste förhandsversions-API:et.
POST /skillsets/[skillset name]/resetskills?api-version=2026-08-01-preview
{
    "skillNames" : [
        "#1",
        "#5",
        "#6"
    ]
}
Du kan ange individuella färdigheter, som du ser i föregående exempel, men om någon av dessa färdigheter kräver utdata från olistade färdigheter (#2 till #4) kör processen olistade färdigheter såvida inte cacheminnet kan ge nödvändig information. För att detta villkor ska vara sant får cachelagrade berikningar för färdigheter #2 till #4 inte vara beroende av #1 (som anges för återställning).
Om du inte anger några kunskaper kör processen hela kompetensuppsättningen och uppdaterar även cacheminnet om cachelagring är aktiverat.
Kom ihåg att följa upp med Run Indexer för att anropa faktisk bearbetning.
Så här återställer du dokument (förhandsversion)
API:et Indexerare – Återställ dokument (förhandsversion) accepterar en lista med dokumentnycklar så att du kan uppdatera specifika dokument. Om du anger återställningsparametrarna avgör de enbart vad som bearbetas, oavsett andra ändringar i underliggande data. Om till exempel 20 blobar har lagts till eller uppdaterats sedan den senaste indexeraren kördes, men du bara återställer ett dokument, bearbetar indexeraren endast dokumentet.
Per dokument uppdaterar indexeraren alla fält i sökdokumentet med värden och metadata från datakällan. Du kan inte välja vilka fält som ska uppdateras.
Om datakällan är Azure Data Lake Storage (ADLS) Gen2 och blobarna är associerade med behörighetsmetadata, matar indexeraren in dessa behörigheter i sökindexet igen om behörigheterna ändras i underliggande data. Mer information finns i Omindexera ACL- och RBAC-omfång med ADLS Gen2-indexerare.
Om du berikar dokumentet via en kompetensuppsättning och det har cachelagrade data anropar indexeraren kunskapsuppsättningen för bara de angivna dokumenten och uppdaterar cachen för de omarbetade dokumenten.
När du testar det här API:et för första gången kan följande API:er hjälpa dig att verifiera och testa beteendena. Använd det senaste förhandsversions-API:et.
Anropa indexerare – Hämta status med en förhandsversion av API:et för att kontrollera återställningsstatus och körningsstatus. Du hittar information om återställningsbegäran i slutet av statussvaret.
Anropa indexerare – Återställ Dokument med en förhandsversion av API:et för att ange vilka dokument som ska bearbetas.
POST https://[service name].search.windows.net/indexers/[indexer name]/resetdocs?api-version=2026-08-01-preview
{
    "documentKeys" : [
        "1001",
        "4452"
    ]
}
API:et accepterar två typer av dokumentidentifierare som indata: Dokumentnycklar som unikt identifierar dokument i ett sökindex och datakällans dokumentidentifierare som unikt identifierar dokument i en datakälla. Brödtexten ska innehålla antingen en lista med dokumentnycklar eller en lista över dokumentidentifierare för datakällan som indexeraren söker efter i datakällan. När API:et anropas läggs dokumentnycklarna eller datakällans dokumentidentifierare till för återställning till indexerarens metadata. Vid nästa schemalagda eller på begäran-körning av indexeraren bearbetar indexeraren endast återställningsdokumenten.
Om du använder dokumentnycklar för att återställa dokument och dina dokumentnycklar refereras till i en indexerarefältmappning använder indexeraren fältmappning för att hitta rätt fält i den underliggande datakällan.
De dokumentnycklar som du anger i begäran är värden från sökindexet, som kan skilja sig från motsvarande fält i datakällan. Om du är osäker på nyckelvärdet skickar du en fråga för att returnera värdet. Du kan använda
selectför att bara returnera dokumentnyckelfältet.För blobar som indexeraren parsar i flera sökdokument (där
parsingModeär inställt på jsonLines eller jsonArrays eller avgränsadText) genererar indexeraren dokumentnyckeln och du kan vara okänd för den. I det här scenariot returnerar en fråga för dokumentnyckeln rätt värde.Om du vill att indexeraren ska sluta försöka bearbeta dokument för återställning ställer du in
"documentKeys"eller"datasourceDocumentIds"på en tom lista[]. Den här åtgärden resulterar i att indexeraren återupptar regelbunden indexering baserat på högvattenmärket. Ogiltiga dokumentnycklar eller dokumentnycklar som inte finns ignoreras.
Anropa Kör indexerare (valfri API-version) för att bearbeta de dokument som du har angett. Indexeraren indexerar endast de specifika dokumenten.
Anropa Kör indexerare en andra gång för att bearbeta från det senaste högvattenmärket.
Anropa Sökdokument för att söka efter uppdaterade värden och även för att returnera dokumentnycklar om du är osäker på värdet. Använd
"select": "<field names>"om du vill begränsa vilka fält som visas i svaret.
Skriv över dokumentnyckellistan
Om du anropar API:et Återställ dokument flera gånger med olika nycklar läggs de nya nycklarna till i listan över återställning av dokumentnycklar. Om du anropar API:et med parametern overwrite inställd på true ersätts den aktuella listan med den nya:
POST https://[service name].search.windows.net/indexers/[indexer name]/resetdocs?api-version=2026-08-01-preview
{
    "documentKeys" : [
        "200",
        "630"
    ],
    "overwrite": true
}
Så här synkroniserar du om indexerare (förhandsversion)
Omsynkronisera indexerare är ett REST API för förhandsversion som utför en partiell omindexering av alla dokument. En indexerare anses synkroniserad med sin datakälla när specifika fält i alla dokument i målindexet överensstämmer med data i datakällan. Vanligtvis uppnår en indexerare synkronisering efter en lyckad första körning. Om du tar bort ett dokument från datakällan förblir indexeraren synkroniserad enligt den här definitionen. Under nästa indexeringskörning tas dock motsvarande dokument i målindexet bort om borttagningsspårning är aktiverat.
Om du ändrar ett dokument i datakällan blir indexeraren osynkroniserad. I allmänhet synkroniserar mekanismer för ändringsspårning indexeraren igen under nästa körning. I Azure Storage uppdateras till exempel en blobs senast ändrade tid när blobben ändras, så att indexeraren kan omindexera den vid nästa indexeringskörning eftersom den uppdaterade tiden överskrider högvattenmärket som sattes vid föregående körning.
Däremot ändras för vissa datakällor, till exempel ADLS Gen2, inte tidpunkten för den senaste ändringen när åtkomstkontrollistorna (ACL:erna) för en blob ändras, så ändringsspårning fungerar inte om ACL:er ska importeras. Därför indexeras inte den ändrade bloben på nytt i den efterföljande körningen, eftersom endast dokument som ändrats efter att det senaste högvattenmärket har bearbetats.
När du använder antingen "reset" eller "reset docs" kan det här problemet åtgärdas, men "reset" kan vara tidskrävande och ineffektivt för stora datamängder, och "reset docs" kräver att du identifierar dokumentnyckeln för den blob som du vill uppdatera.
Omsynkronisera indexerare är ett effektivt och bekvämt alternativ. Du placerar helt enkelt indexeraren i omsynkroniseringsläge och anger innehållet som ska synkroniseras om genom att anropa API:et för omsynkroniseringsindexerare. I nästa körning inspekterar indexeraren endast den relevanta delen av data i källan och undviker all onödig bearbetning som inte är relaterad till angivna data. Den frågar också de befintliga dokumenten i målindexet och uppdaterar endast de dokument som visar avvikelser mellan datakällan och målindexet. Efter omsynkroniseringskörningen synkroniseras indexeraren och återgår till vanligt indexerarkörningsläge för efterföljande körningar.
Så här synkroniserar du om och kör indexerare
Anropa indexerare – Synkronisera om med en förhandsversion av API:et för att ange vilket innehåll som ska synkroniseras igen.
POST https://[service name].search.windows.net/indexers/[indexer name]/resync?api-version=2026-08-01-preview { "options" : [ "permissions" ] }- Fältet
optionskrävs. För närvarande ärpermissionsdet enda alternativet som stöds . Det vill: endast behörighetsfilterfält i målindexet uppdateras.
- Fältet
Anropa Kör indexerare (valfri API-version) för att synkronisera indexeraren igen.
Anropa Kör indexerare en andra gång för att bearbeta från det senaste högvattenmärket.
Kontrollera återställningsstatusen "currentState"
Följ dessa steg om du vill kontrollera återställningsstatusen och se vilka dokumentnycklar som placeras i kö för bearbetning:
Anropa Get Indexer Status med ett förhandsversions-API.
Förhandsgransknings-API:et
currentStatereturnerar avsnittet som hittades i slutet av svaret."currentState": { "mode": "indexingResetDocs", "allDocsInitialTrackingState": "{\"LastFullEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"LastAttemptedEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"NameHighWaterMark\":null}", "allDocsFinalTrackingState": "{\"LastFullEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"LastAttemptedEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"NameHighWaterMark\":null}", "resetDocsInitialTrackingState": null, "resetDocsFinalTrackingState": null, "resyncInitialTrackingState": null, "resyncFinalTrackingState": null, "resetDocumentKeys": [ "200", "630" ] }Kontrollera läget:
För Återställ kunskaper anger du "läge" till
indexingAllDocseftersom potentiellt alla dokument påverkas, när det gäller de fält som AI-berikning fyller.För Omsynkronisera indexerare anger du "läge" till
indexingResync. Indexeraren kontrollerar alla dokument och fokuserar på intresserade data i datakällan och intresserade fält i målindexet.För Återställ dokument anger du "läge" till
indexingResetDocs. Indexeraren behåller den här statusen tills den bearbetar alla dokumentnycklar som anges i anropet för återställningsdokument. Under den här tiden körs inga andra indexeringsjobb medan åtgärden pågår. Att hitta alla dokument i listan över dokumentnycklar kräver att varje dokument öppnas för att lokalisera och matcha mot nyckeln. Den här processen kan ta en stund om datamängden är stor. Om en blobcontainer innehåller hundratals blobar och de dokument som du vill återställa finns i slutet, hittar indexeraren inte matchande blobar förrän den kontrollerar alla andra först.När indexeraren har bearbetat dokumenten igen kör du Hämta indexerarstatus igen. Indexeraren återgår till
indexingAllDocsläget och bearbetar alla nya eller uppdaterade dokument vid nästa körning.
Kontrollera indexerarens körningskvot för S3 HD- och serverlösa söktjänster
Det här avsnittet gäller för S3 HD(Standard 3 High Density) och serverlösa söktjänster. Aggregerat kvotbeteende och planeringsvägledning finns i Indexer-körning på Serverlös och S3 HD (förhandsversion)..
Varje indexeringskörning har en maximal körtid på två timmar. Dessutom delar alla indexerare på 24 timmars sammanlagd körtid per tjänst under varje 24-timmarsperiod i UTC.
För att hjälpa dig att övervaka indexerarens körningstider i förhållande till 24-timmarsfönstret, returnerar Hämta tjänststatistik och Hämta indexerarstatus nu mer information i svaret.
Spåra kumulativ körningstid kvot
Spåra en söktjänsts sammanlagda körtid för indexeraren och avgör hur mycket körtidskvot som återstår under den aktuella 24-timmarsperioden.
Skicka en GET-begäran till söktjänstens slutpunkt. Hjälp med att konfigurera en REST-klient och hämta en åtkomsttoken finns i Ansluta till en söktjänst.
GET {{search-endpoint}}/servicestats?api-version=2026-08-01-preview
  Content-Type: application/json
  Authorization: Bearer {{accessToken}}
Svaren innehåller indexersRuntime egenskaper som visar start- och sluttider för fönstret, kumulativa sekunder som används av alla indexerare och sekunder som återstår för tjänsten.
Spåra indexerarens drifttidskvot
Returnera samma information för en enskild indexerare.
GET {{search-endpoint}}/indexers/hotels-sample-indexer/search.status?api-version=2026-08-01-preview
  Content-Type: application/json
  Authorization: Bearer {{accessToken}}
Svaren innehåller runtime egenskaper som visar start- och sluttider för fönstret, sekunder som används av indexeraren och sekunder som återstår för alla indexerare i tjänsten.
Nästa steg
API:er för återställning används för att bestämma omfånget för nästa indexerarkörning. För faktisk bearbetning måste du anropa en indexerare på begäran eller tillåta att ett schemalagt jobb slutför arbetet. När körningen är klar återgår indexeraren till normal bearbetning, oavsett om det är enligt ett schema eller bearbetning på begäran.
När du har återställt och kört indexerarjobben igen kan du övervaka status från söktjänsten eller hämta detaljerad information via resursloggning.