Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Note
Azure AI-sökning är tillgängligt via Azure-portalen, REST-API:er och Azure-SDK:er. Den ligger också till grund för Foundry IQ, det hanterade kunskapsskiktet som omvandlar företagsinnehåll till återanvändbara, behörighetsmedvetna kunskapsbaser för agenter i Microsoft Foundry-portalen.
Viktigt
Funktioner, funktioner eller egenskaper som har markerats (förhandsversion) omfattas inte av ett serviceavtal, rekommenderas inte för produktionsarbetsbelastningar och kan ändras eller begränsas innan de blir allmänt tillgängliga. Villkoren för Azure AI-sökning förhandsgranskning gäller för alla förhandsgranskningsfunktioner, oavsett om de är fristående eller en del av en allmänt tillgänglig funktion.
Den här artikeln beskriver hur du lägger till cachelagring i en kompetensuppsättningens pipeline så att du kan ändra nedströms berikningssteg utan full ombyggnad varje gång. Cachelagring för berikning (förhandsversion) kräver ett REST-API i förhandsversion. Som standard är en kompetensuppsättning tillståndslös, och om du ändrar någon del av dess sammansättning krävs en fullständig omkörning av indexeraren. Med en berikningscache avgör indexeraren vilka delar av dokumentträdet som måste uppdateras baserat på ändringar i kompetensuppsättningen eller indexerarens definition. Indexeraren bevarar och återanvänder befintliga bearbetade utdata där det är möjligt.
Du placerar cachelagrat innehåll i Azure Storage med hjälp av en reťazec pripojenia som du anger. Indexeraren skapar dessa objekt när det körs. Betrakta berikningscachen som en intern komponent som hanteras av din söktjänst och som du inte får ändra.
Viktigt
En cache för berikning är inte en säkerhetskopia av utdata från en kompetensuppsättning, indexerarens tillstånd eller indexerade dokument. Den spårar inte vilka dokument som slutför bearbetningen. För stora datakällor läser du avsnittet Begränsningar innan du aktiverar cachelagring.
- En container med namnet
ms-az-search-indexercache-<alpha-numeric-string> - Tabeller med namnet
MsAzSearchIndexerCacheIndex<alpha-numeric-string>
Förutsättningar
Azure Storage för lagring av cachelagrade förbättringar. Lagringskontot måste vara generellt v2.
Om du bara behöver synkroniserad dokumentborttagning från både cacheminnet och indexet när blobar tas bort från datakällan aktiverar du en borttagningsprincip i indexeraren. Utan den här principen stöds inte dokumentborttagning från cacheminnet.
Du bör känna till hur du konfigurerar indexerare och kompetensuppsättningar. Börja med indexeröversikt och fortsätt sedan till färdighetsuppsättningar för att lära dig mer om beriknings-pipelines.
Begränsningar
Försiktighet
Om du använder SharePoint indexeraren (förhandsversion) bör du undvika inkrementell berikning. Under vissa omständigheter blir cachen ogiltig. Om du vill ladda om den igen, utför du en återställning av indexeraren och en fullständig ombyggnad.
Stora datakällor har ytterligare en cachebegränsning.
Försiktighet
För stora datakällor kan en berikningscache öka den totala omarbetningen när långvariga kunskaper, upprepade avbrott eller frekventa kompetensfel inträffar. Indexeraren prioriterar korrekthet framför att minimera upparbetning, så en kvarvarande cachelagring från upprepade avbrott förstärker återförsöksbeteendet. Det här beteendet förväntas, inte en bugg.
För att åtgärda en växande cachekö delar du upp datakällan i mindre containrar eller virtuella mappar. Använd sedan parallella indexerare som pekar på samma index. Om du vill koppla från cacheminnet anger du cache egenskapen till null på indexeraren. Mer information om partitioneringsmönstret finns i Indexera stora datauppsättningar .
Behörigheter
En Azure AI-sökning identitet behöver skrivåtkomst till Azure Storage:
- Storage Blob Data-medverkare
- Storage Table Data-deltagare
Syntaxen reťazec pripojenia avgör om en systemtilldelad eller användartilldelad identitet används. Mer information finns i Anslut till Azure Storage med hjälp av en hanterad identitet.
Ange cacheegenskapen
Använd den här proceduren för både nya och befintliga indexerare.
I indexerarens definition anger du cache med:
- (Krävs)
storageConnectionStringinställt på en Azure Storage anslutningssträng. - (Valfritt)
enableReprocessing(truesom standard). Ställ in den påfalseför att tillfälligt pausa inkrementell berikning och växla tillbaka den tilltruesenare.
Välj Indexerare till vänster.
Välj Lägg till indexerare för att skapa en ny indexerare eller öppna en befintlig i JSON-redigeringsläge.
Aktivera inkrementell berikning, ange lagringskonto för berikningscache och spara indexeraren.
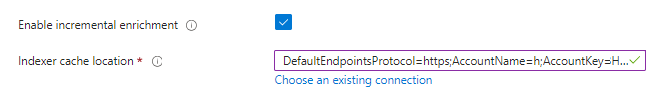
Återställ indexeraren om den redan finns.
Kör indexeraren. Denna engångs fullständiga ombyggnad initierar cachen. När det har laddats in tillämpas inkrementell återanvändning på efterföljande körningar.