Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Nota
O Pesquisa de IA do Azure está disponível através do portal Azure, APIs REST e SDKs do Azure. Também sustenta o Foundry IQ, a camada de conhecimento gerida que transforma conteúdos empresariais em bases de conhecimento reutilizáveis e conscientes de permissões para agentes no portal Microsoft Foundry.
O Pesquisa de IA do Azure é um serviço totalmente gerido e alojado na cloud que liga os seus dados à IA. O serviço unifica o acesso a conteúdos empresariais e web para que agentes e grandes modelos de linguagem (LLMs) possam usar contexto, histórico de chat e sinais multifonte para produzir respostas fiáveis e fundamentadas.
Casos de uso comuns incluem pesquisa clássica e geração aumentada por recuperação (RAG) usando recuperação baseada em agentes, em que o serviço orquestra o planeamento da consulta, a recuperação e a construção da resposta. Estas capacidades suportam cenários que vão desde experiências de pesquisa tradicionais até agentes e aplicações de chat baseadas em IA, adequadas tanto para cenários empresariais como para consumidores.
Quando cria um serviço de pesquisa, estão incluídas as seguintes funcionalidades:
- Dois motores: pesquisa clássica para pedidos únicos e recuperação agentical para pesquisa paralela, iterativa e assistida por LLM.
- Consultas em texto completo, vetoriais, híbridas e multimodais sobre conteúdos locais (indexados) e remotos.
- Enriquecimento da IA para segmentar, vetorizar e tornar o conteúdo bruto pesquisável.
- Ajuste de relevância para melhorar a correspondência de intenções e a qualidade dos resultados.
- Escala, segurança, monitorização e conformidade do Azure.
- Integrações Azure com plataformas de dados suportadas, Azure OpenAI e Microsoft Foundry.
Porque usar o Pesquisa de IA do Azure?
Agentes terrestres e chatbots em dados proprietários, empresariais ou web para respostas precisas e conscientes do contexto.
Aceda a dados de Armazenamento de Blobs do Azure, Azure Cosmos DB, Microsoft SharePoint, Microsoft OneLake e outras fontes de dados suportadas. Escolha acesso indexado ou remoto com base nas suas necessidades de frescura, latência e conformidade.
Enriquecer e estruturar o conteúdo no momento da indexação ou da consulta com ferramentas que executam segmentação, integração e transformações assistidas por LLM.
Combine pesquisa em texto completo com pesquisa vetorial (pesquisa híbrida) para equilibrar precisão e recordação.
Consulta conteúdos contendo texto e imagens num único pipeline multimodal.
Implementar facilmente funcionalidades relacionadas com a pesquisa: ajuste de relevância, navegação facetada, filtros (incluindo pesquisa geoespacial), mapeamento de sinónimos e autocompletamento.
Fornecer segurança empresarial, controlo de acessos e conformidade através do Microsoft Entra ID, Azure Private Link, controlo de acesso ao nível do documento e acesso baseado em funções.
Escalar e operar em produção com a fiabilidade, monitorização e diagnóstico do Azure (logs, métricas e alertas), e ferramentas REST API ou SDK para automação.
Para mais informações sobre funcionalidades específicas, consulte Características de Pesquisa de IA do Azure.
O que é a pesquisa clássica?
A pesquisa clássica é um modelo de recuperação que prioriza o índice para consultas previsíveis e de baixa latência. Cada consulta tem como alvo um único índice de pesquisa pré-definido e devolve documentos ordenados num ciclo de pedido–resposta. Durante a recolha não ocorre planeamento, iteração ou síntese assistida por LLM.
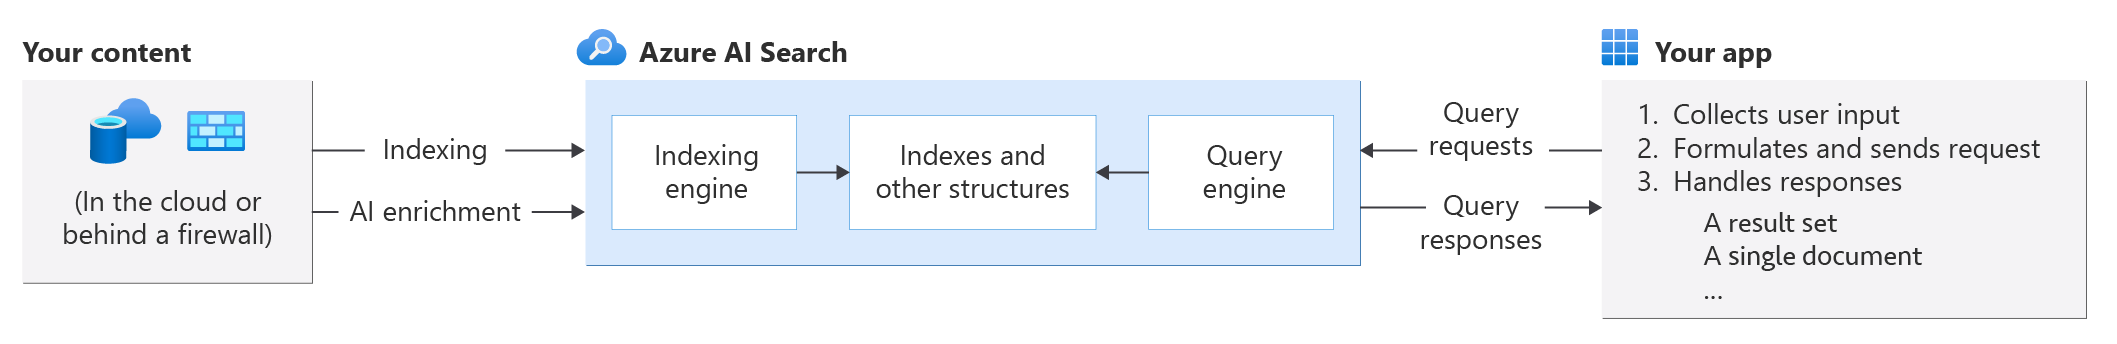
Nesta arquitetura, o seu serviço de pesquisa situa-se entre os repositórios de dados que contêm o seu conteúdo não processado e a aplicação do cliente. A aplicação é responsável por enviar pedidos de consulta para o seu serviço de pesquisa e tratar das respostas.
Esta arquitetura tem duas cargas de trabalho principais:
A indexação carrega conteúdo num índice e torna-o pesquisável. Internamente, o texto de entrada é tokenizado e armazenado em índices invertidos, enquanto os vetores de entrada são armazenados em índices vetoriais. O Pesquisa de IA do Azure só pode indexar documentos JSON. Podes usar o método push para carregar documentos JSON diretamente ou o método pull (indexador ou workflow de aplicação lógica) para recuperar e serializar dados em JSON.
Durante a indexação, pode usar o enriquecimento de IA para fragmentar texto, gerar vetores e aplicar outras transformações que criam estrutura e conteúdo. O Pesquisa de IA do Azure serializa então a saída enriquecida em documentos JSON e ingere-os no índice.
Nota
Este diagrama separa os motores de indexação e de consulta para maior clareza, mas no Pesquisa de IA do Azure, são o mesmo componente a operar em modos de leitura-escrita e apenas leitura.
O que é a recuperação agentica?
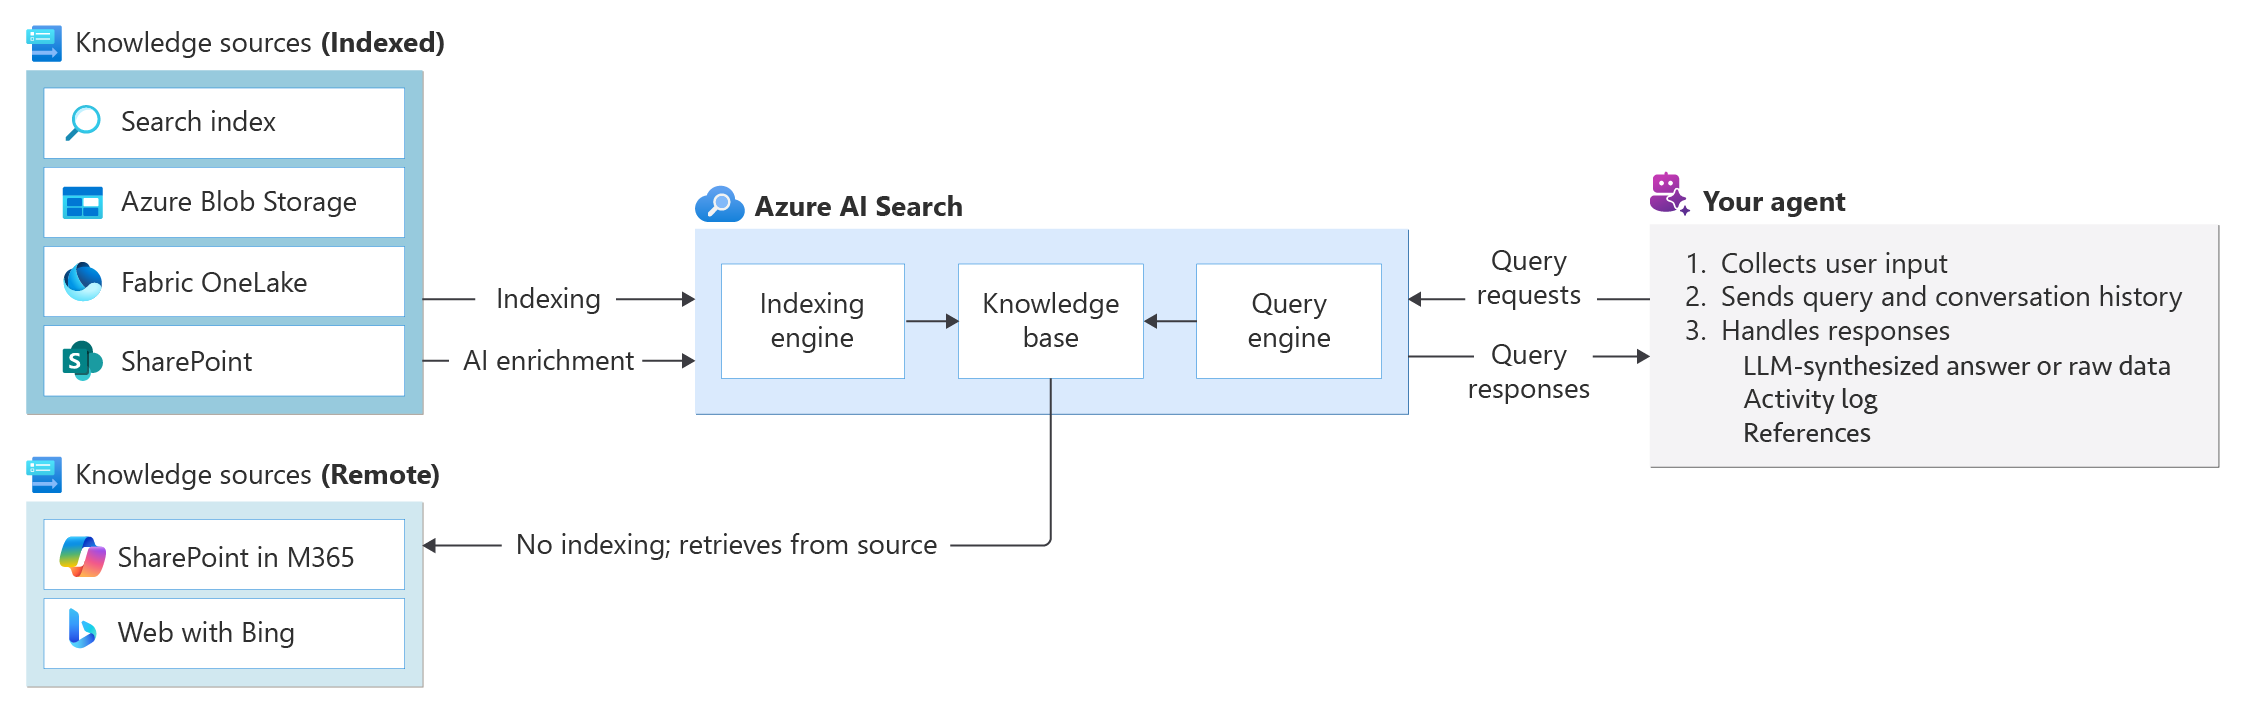
A recuperação autónoma é um pipeline de múltiplas consultas concebido para fluxos de trabalho complexos entre agentes. Cada consulta tem como alvo uma base de conhecimento que representa um domínio completo do conhecimento. O seu agente consulta a base de conhecimento para saber em que se basear, enquanto a base de conhecimento trata de como fazer o grounding.
Uma base de conhecimento consiste em uma ou mais fontes de conhecimento, um LLM opcional para planeamento de consultas e síntese de respostas, e parâmetros que regem o comportamento de recuperação. Cada consulta passa por planeamento, decomposição em subconsultas focadas, recuperação paralela a partir de fontes de conhecimento, reclassificação semântica e fusão de resultados. A resposta em três frentes está otimizada para o consumo de agentes.
Por trás do funcionamento, a recuperação agêntica baseia-se na arquitetura clássica de pesquisa ao adicionar uma camada de contexto (base de conhecimento) que orquestra a recuperação multi-fonte. As fontes de conhecimento podem ser indexadas ou remotas: as fontes indexadas usam os mesmos motores de indexação e consulta que a pesquisa clássica, enquanto as fontes remotas contornam a indexação e são consultadas em tempo real.
Como se comparam
A pesquisa clássica e a recuperação agential são modos complementares de recuperação de informação. Ambos suportam pesquisa em texto completo, vetorial, híbrida e multimodal . No entanto, diferem na forma como o conteúdo é ingerido e consultado. A tabela seguinte resume as suas principais diferenças.
| Aspeto | Pesquisa clássica | Recuperação agêntica |
|---|---|---|
| Corpus de pesquisa | Índice de pesquisa | Fonte de conhecimento |
| Alvo de busca | Um índice definido por um esquema | Uma base de conhecimento que aponta para uma ou mais fontes de conhecimento |
| Plano de consulta | Sem plano, apenas um pedido | Plano assistido por LLM ou fornecido pelo utilizador |
| Pedido de consulta | Pesquise documentos num índice | Recuperar de fontes de conhecimento |
| Resposta | Resultados de pesquisa nivelados com base no esquema | Resposta formulada por LLM ou dados de origem bruta, registo de atividade e referências |
| Restrições regionais | Não | Sim |
| Estado | Disponível de forma geral | Disponível de forma geral, com algumas funcionalidades em pré-visualização |
| Suporte dedicado a modelos de preços | Sim | Sim |
| Suporte para o modelo de preços sem servidor (pré-visualização) | Sim | Sim |
Como começar
Pode aceder ao Pesquisa de IA do Azure através do portal do Azure, REST APIs, e SDKs do Azure para .NET, Java, JavaScript, e Python.
O portal é útil para administração de serviços e gestão de conteúdos, com ferramentas para prototipar as suas bases de conhecimento, fontes de conhecimento, índices, indexadores, conjuntos de competências e fontes de dados. APIs e SDKs REST são úteis para automação de produção.
Escolhe o teu caminho
Antes de começar, utilize esta lista de verificação para tomar decisões importantes:
Escolha um modelo de preços: Selecione entre o modelo Dedicado ou Serverless (pré-visualização). Consulte Escolha um modelo de preços e um nível de serviço para obter ajuda na escolha do modelo que melhor se adequa às suas necessidades.
Escolha como quer recuperar os dados: Pode consultar diretamente a partir de um índice de pesquisa para resultados previsíveis e de baixa latência, ou usar a recuperação agente para consultar em múltiplos índices através de uma base de conhecimento. Se está a construir uma aplicação tradicional sem agente ou chatbot, as consultas de índice direto podem satisfazer a maioria das necessidades com menor custo e complexidade. Se quiseres trabalhar com múltiplas fontes de conhecimento ou suportar cenários mais avançados, considera usar a recuperação por agente com esforço mínimo de raciocínio (pré-visualização).
Escolha uma região: Se estiveres a usar recuperação agente, escolhe uma região suportada. Para pesquisa clássica, escolha uma região que ofereça as funcionalidades e capacidade de que precisa.
Escolha um método de ingestão para conteúdos indexados: Se o seu conteúdo estiver numa fonte de dados suportada, use o método pull para recuperar e serializar dados em JSON. Se não tiver uma fonte de dados suportada, ou se o seu conteúdo e índice tiverem de ser sincronizados em tempo real, o método push é a sua única opção.
Precisas de vetores? LLMs e agentes não precisam de vetores. Só os use se precisar de pesquisa por similaridade ou se tiver conteúdo que possa ser homogeneizado em vetores. Pesquisa de IA do Azure oferece vetorização
integrada para esta tarefa. Precisa de herança de permissões baseada no utilizador? O SharePoint remoto foi concebido para este cenário, mas também pode herdar permissões de utilizador associadas ao conteúdo no Armazenamento de Blobs do Azure ou ADLS Gen2. Para todos os outros cenários, podes usar a solução alternativa do filtro de segurança .
Escolha os seus recursos de aprendizagem
Estes guias de início rápido e exemplos estão disponíveis para o ajudar a dar os primeiros passos.
- Quickstart: Recuperação agentica (portal ou programática)
- Quickstart: Pesquisa em texto completo (portal ou programática)
- Quickstart: Pesquisa vetorial (portal ou programática)
Dica
Para ajuda com soluções complexas ou personalizadas, contacte um parceiro com profunda experiência em Pesquisa de IA do Azure.