Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Nota
O Pesquisa de IA do Azure está disponível através do portal Azure, APIs REST e SDKs do Azure. Também sustenta o Foundry IQ, a camada de conhecimento gerida que transforma conteúdos empresariais em bases de conhecimento reutilizáveis e conscientes de permissões para agentes no portal Microsoft Foundry.
A pesquisa por texto integral é uma abordagem na recuperação de informação que corresponde a texto simples armazenado num índice. Por exemplo, dado um formulário de consulta "hotéis em San Diego na praia", o motor de busca procura cadeias tokenizadas baseadas nesses termos. Para tornar as digitalizações mais eficientes, as cadeias de consulta passam por análise lexical: colocar todos os termos em minúsculas, remover palavras de parada como "o" e reduzir os termos às suas formas raiz primitivas. Quando são encontrados termos correspondentes, o motor de busca recupera documentos, ordena-os por ordem de relevância e devolve os principais resultados.
A execução de consultas pode ser complexa. Este artigo destina-se a programadores que precisam de uma compreensão mais profunda de como funciona a pesquisa de texto completo no Pesquisa de IA do Azure. Para consultas de texto, o Pesquisa de IA do Azure entrega resultados esperados de forma fluida na maioria dos cenários, mas ocasionalmente pode obter um resultado que parece "errado" de alguma forma. Nestas situações, ter experiência nas quatro fases da execução de consultas Lucene (análise sintática de consultas, análise lexical, correspondência de documentos e pontuação) pode ajudar a identificar alterações específicas aos parâmetros de consulta ou à configuração de índices que produzam o resultado desejado.
Nota
Pesquisa de IA do Azure usa Apache Lucene para pesquisa de texto completo, mas a integração com Lucene não é exaustiva. Expomos e estendemos seletivamente a funcionalidade do Lucene para possibilitar os cenários importantes para o Pesquisa de IA do Azure.
Visão geral e diagrama da arquitetura
A execução da consulta tem quatro etapas:
- Análise sintática de consultas
- Análise lexical
- Recuperação de documentos
- Pontuação
Uma consulta de pesquisa em texto completo começa com a análise do texto da consulta para extrair termos de pesquisa e operadores. Existem dois analisadores para que possas escolher entre velocidade e complexidade. Segue-se uma fase de análise, onde termos individuais de consulta são por vezes decompostos e reconstituídos em novas formas. Este passo ajuda a alargar o alcance para o que pode ser considerado um possível pareamento. O motor de busca analisa então o índice para encontrar documentos com termos correspondentes e pontua cada correspondência. Um conjunto de resultados é então ordenado por uma pontuação de relevância atribuída a cada documento correspondente individual. Os que estão no topo da lista classificada são devolvidos à aplicação de chamada.
O diagrama seguinte ilustra os componentes usados para processar um pedido de pesquisa:
Diagrama da arquitetura de consultas 
| Componentes chave | Descrição funcional |
|---|---|
| Analisadores de consulta | Separe os termos de consulta dos operadores de consulta e crie a estrutura de consulta (uma árvore de consultas) a ser enviada para o motor de busca. |
| Analisadores | Realizar análise lexical sobre termos de consulta. Este processo pode envolver transformar, remover ou expandir termos de consulta. |
| Índice | Uma estrutura de dados eficiente usada para armazenar e organizar termos pesquisáveis extraídos de documentos indexados. |
| Motor de busca | Recupera e pontua documentos correspondentes com base no conteúdo do índice invertido. |
Anatomia de um pedido de pesquisa
Um pedido de pesquisa é uma especificação completa do que deve ser devolvido num conjunto de resultados. Na sua forma mais simples, é uma consulta vazia sem qualquer critério. Um exemplo mais realista inclui parâmetros, vários termos de consulta, talvez com âmbito para certos campos, com possivelmente uma expressão de filtro e regras de ordenação.
O exemplo seguinte é um pedido de pesquisa que pode enviar a Pesquisa de IA do Azure usando a API REST:
POST /indexes/hotels/docs/search?api-version=2026-04-01
{
    "search": "Spacious, air-condition* +\"Ocean view\"",
    "searchFields": "description, title",
    "searchMode": "any",
    "filter": "price ge 60 and price lt 300",
    "orderby": "geo.distance(location, geography'POINT(-159.476235 22.227659)')",
    "queryType": "full"
}
Para este pedido, o motor de busca realiza as seguintes operações:
Encontra documentos onde o preço é pelo menos 60 dólares e menos de 300 dólares.
Executa a consulta. Neste exemplo, a consulta de pesquisa consiste em frases e termos:
"Spacious, air-condition* +\"Ocean view\""(Os utilizadores normalmente não inserem pontuação, mas ao incluí-la no exemplo, podemos explicar como os analisadores a lidam com ela.)Para esta consulta, o motor de busca analisa os campos de descrição e título especificados em "searchFields" à procura de documentos que contenham
"Ocean view", e adicionalmente sobre o termo"spacious", ou sobre termos que comecem com o prefixo"air-condition". O parâmetro "searchMode" é usado para corresponder a qualquer termo (padrão) ou a todos eles, nos casos em que um termo não é explicitamente exigido (+).Ordena o conjunto resultante de hotéis por proximidade a uma determinada localização geográfica e depois devolve os resultados à aplicação que chama.
A maior parte deste artigo é sobre o processamento da consulta de pesquisa: "Spacious, air-condition* +\"Ocean view\"". Filtragem e ordenação estão fora do âmbito. Para mais informações, consulte a documentação de referência da API de Pesquisa.
Fase 1: Análise sintática de consultas
Como referido, a cadeia de consulta é a primeira linha do pedido:
"search": "Spacious, air-condition* +\"Ocean view\"",
O analisador de consultas separa operadores (como * e + no exemplo) dos termos de pesquisa e desconstrói a consulta de pesquisa em subconsultas de um tipo suportado:
- Consulta de termos para termos autónomos (como Spacious)
- Consulta de frases para termos entre aspas (como ocean view)
-
consulta de prefixo para termos seguidos de um operador de
*prefixo (como ar condicionado)
Para uma lista completa dos tipos de consulta suportados, veja a sintaxe de consulta Lucene.
Os operadores associados a uma subconsulta determinam se a consulta "deve ser" ou "pode ser" satisfeita para que um documento seja considerado uma correspondência. Por exemplo, +"Ocean view" é "obrigatório" devido ao operador +.
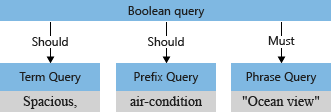
O analisador de consultas reestrutura as subconsultas numa árvore de consultas (uma estrutura interna que representa a consulta), que passa para o motor de busca. Na primeira fase da análise sintática de consultas, a árvore de consultas apresenta-se assim:
Analisadores suportados: Simple e Full Lucene
Pesquisa de IA do Azure expõe duas linguagens de consulta diferentes: simple (por defeito) e full. Ao definir o queryType parâmetro com o seu pedido de pesquisa, indica ao analisador de consultas qual a linguagem de consulta que escolhe, para que ele saiba como interpretar os operadores e a sintaxe.
A linguagem de consulta Simple é intuitiva e robusta, frequentemente adequada para interpretar diretamente a introdução do utilizador como está, sem necessidade de processamento do lado do cliente. Suporta operadores de consulta familiares dos motores de busca web.
A linguagem de consulta Full Lucene, que se obtém ao definir
queryType=full, estende a linguagem de consulta Simple por defeito, adicionando suporte para mais operadores e tipos de consulta como curinga, fuzzy, regex e consultas por campo. Por exemplo, uma expressão regular enviada em sintaxe de consulta simples seria interpretada como uma cadeia de consulta e não como uma expressão. O pedido de exemplo neste artigo utiliza a linguagem de consulta Full Lucene.
Impacto do modo de pesquisa no parser
Outro parâmetro de pedido de pesquisa que afeta a análise é o parâmetro "searchMode". Controla o operador padrão para consultas booleanas: qualquer (padrão) ou todos.
Quando "searchMode=any", que é o padrão, o delimitador de espaço entre spacious e air-condition é OR (||), tornando a consulta de exemplo equivalente a:
Spacious,||air-condition*+"Ocean view"
Operadores explícitos, como + em +"Ocean view", são inequívocos na construção de consulta booleana (o termo deve corresponder). Menos óbvio é como interpretar os termos restantes: espaçoso e ar condicionado. Deverá o motor de busca encontrar correspondências com vista para o oceano, espaçosoe ar condicionado? Ou deveria escolher vista para o oceano mais qualquer um dos termos restantes?
Por predefinição ("searchMode=any"), o motor de busca assume a interpretação mais ampla. Qualquer um dos campos deve ser combinado, refletindo a semântica do "ou". A árvore de consulta inicial ilustrada anteriormente, com as duas operações "deveria", mostra o padrão.
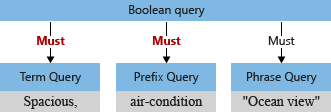
Suponha que agora definimos "searchMode=all". Neste caso, o espaço é interpretado como uma operação "and". Ambos os termos restantes devem estar presentes no documento para que isso seja considerado uma correspondência. A consulta de exemplo resultante seria interpretada da seguinte forma:
+Spacious,+air-condition*+"Ocean view"
Uma árvore de consulta modificada para esta consulta, onde um documento correspondente é a interseção das três subconsultas, seria a seguinte:
Nota
Escolher "searchMode=any" em vez de "searchMode=all" é uma decisão que deve ser tomada através de consultas representativas. Utilizadores que provavelmente incluam operadores (comum ao pesquisar em repositórios de documentos) podem encontrar resultados mais intuitivos se "searchMode=all" informar construtos de consulta booleana. Para mais informações sobre a interação entre "searchMode" e operadores, veja Sintaxe simples de consulta.
Fase 2: Análise lexical
Os analisadores lexicais processam consultas de termos e consultas de frases após a árvore de consulta ser estruturada. Um analisador aceita as entradas de texto fornecidas pelo parser, processa o texto e depois envia de volta os termos tokenizados para serem incorporados na árvore de consultas.
A forma mais comum de análise lexical é a análise linguística, que transforma termos de consulta com base em regras específicas de uma determinada língua. Isto envolve:
- Reduzir um termo de consulta à forma raiz de uma palavra.
- Remover palavras não essenciais (palavras de encerramento, como "the" ou "and" em inglês).
- Fragmentar uma palavra composta em partes componentes.
- Colocar uma palavra maiúscula em minúsculas.
Todas estas operações tendem a apagar as diferenças entre o texto fornecido pelo utilizador e os termos armazenados no índice. Estas operações vão além do processamento de texto e exigem um conhecimento aprofundado da própria língua. Para adicionar esta camada de consciência linguística, Pesquisa de IA do Azure suporta uma longa lista de analisadores linguagem tanto do Lucene como do Microsoft.
Nota
Dependendo do seu cenário, os requisitos de análise podem variar de mínimos a elaborados. Pode controlar a complexidade da análise lexical selecionando um dos analisadores pré-definidos ou criando o seu próprio analisador personalizado. Os analisadores estão orientados para campos pesquisáveis e são especificados como parte de uma definição de campo. Isto permite variar a análise lexical por campo. Se não especificado, utiliza-se o analisador Luceno padrão .
No nosso exemplo, antes da análise, a árvore inicial de consultas tem o termo "Spacious", com um "S" maiúsculo e uma vírgula que o analisador de consultas interpreta como parte do termo de consulta (uma vírgula não é considerada um operador de linguagem de consulta).
Quando o analisador padrão processa o termo, irá transformar em minúsculas as palavras "vista para o oceano" e "espaçoso" e remover o caráter vírgula. A árvore de consultas modificada tem este aspeto:

Testar comportamentos de analisadores
O comportamento de um analisador pode ser testado usando a API Analyze. Fornece o texto que queres analisar para ver que termos o analisador em questão gera. Por exemplo, para ver como o analisador padrão processaria o texto "ar-condicionado", pode emitir o seguinte pedido:
{
    "text": "air-condition",
    "analyzer": "standard"
}
O analisador padrão divide o texto de entrada nos seguintes dois tokens, anotando-os com atributos como deslocamentos de início e fim (usados para realçar hits), bem como a sua posição (usada para correspondência de frases):
{
  "tokens": [
    {
      "token": "air",
      "startOffset": 0,
      "endOffset": 3,
      "position": 0
    },
    {
      "token": "condition",
      "startOffset": 4,
      "endOffset": 13,
      "position": 1
    }
  ]
}
Exceções à análise lexical
A análise lexical aplica-se apenas a tipos de consulta que requerem termos completos, seja uma consulta de termos ou uma consulta de frase. Não se aplica a tipos de consulta com termos incompletos — consulta prefixo, consulta coringa e consulta regex — nem a uma consulta difusa. Esses tipos de consulta, incluindo a consulta prefixo com o termo air-condition* do nosso exemplo, são adicionados diretamente à árvore de consultas, contornando a fase de análise. A única transformação realizada em termos de consulta desses tipos é converter para minúsculas.
Fase 3: Recuperação de documentos
A recuperação de documentos refere-se à procura de documentos com termos correspondentes no índice. Esta fase é melhor compreendida através de um exemplo. Vamos começar com um índice de hotéis que tem o seguinte esquema simples:
{
    "name": "hotels",
    "fields": [
        { "name": "id", "type": "Edm.String", "key": true, "searchable": false },
        { "name": "title", "type": "Edm.String", "searchable": true },
        { "name": "description", "type": "Edm.String", "searchable": true }
    ]
}
Assuma ainda que este índice contém os seguintes quatro documentos:
{
    "value": [
        {
            "id": "1",
            "title": "Hotel Atman",
            "description": "Spacious rooms, ocean view, walking distance to the beach."
        },
        {
            "id": "2",
            "title": "Beach Resort",
            "description": "Located on the north shore of the island of Kauaʻi. Ocean view."
        },
        {
            "id": "3",
            "title": "Playa Hotel",
            "description": "Comfortable, air-conditioned rooms with ocean view."
        },
        {
            "id": "4",
            "title": "Ocean Retreat",
            "description": "Quiet and secluded"
        }
    ]
}
Como os termos são indexados
Para compreender a procura, é útil conhecer alguns conceitos básicos sobre indexação. A unidade de armazenamento é um índice invertido, um para cada campo pesquisável. Dentro de um índice invertido existe uma lista ordenada de todos os termos de todos os documentos. Cada termo corresponde à lista de documentos em que ocorre, como é evidente no exemplo abaixo.
Para produzir os termos num índice invertido, o motor de busca realiza uma análise lexical sobre o conteúdo dos documentos, semelhante ao que acontece durante o processamento de consultas:
- As entradas de texto são passadas para um analisador, em minúsculas, sem pontuação, e assim por diante, dependendo da configuração do analisador.
- Os tokens são o resultado da análise lexical.
- Os termos são adicionados ao índice.
É comum, mas não obrigatório, usar os mesmos analisadores para operações de pesquisa e indexação para que os termos de consulta se assemelhem mais a termos dentro do índice.
Nota
Pesquisa de IA do Azure permite especificar diferentes analisadores para indexação e pesquisa através de parâmetros adicionais indexAnalyzer e searchAnalyzer. Se não especificado, o conjunto de analisadores com a analyzer propriedade é usado tanto para indexação como para pesquisa.
Índice invertido para exemplos de documentos
Voltando ao nosso exemplo, para o campo do título , o índice invertido é assim:
| Termo | Lista de documentos |
|---|---|
| atman | 1 |
| praia | 2 |
| hotel | 1, 3 |
| oceano | 4 |
| Playa | 3 |
| Estância | 2 |
| Retirada | 4 |
No campo do título, apenas hotel aparece em dois documentos: 1 e 3.
Para o campo de descrição , o índice é o seguinte:
| Termo | Lista de documentos |
|---|---|
| Aéreo | 3 |
| e | 4 |
| praia | 1 |
| condicionado | 3 |
| confortável | 3 |
| Distância | 1 |
| ilha | 2 |
| Kauaʻi | 2 |
| Localizado | 2 |
| Norte | 2 |
| oceano | 1, 2, 3 |
| de | 2 |
| em | 2 |
| Silêncio | 4 |
| Quartos | 1, 3 |
| isolado | 4 |
| Costa | 2 |
| Espaçoso | 1 |
| O | 1, 2 |
| a | 1 |
| vista | 1, 2, 3 |
| Caminhada | 1 |
| com | 3 |
Comparar termos de consulta com termos indexados
Dados os índices invertidos acima, vamos voltar à consulta de exemplo e ver como os documentos correspondentes são encontrados para a nossa consulta de exemplo. Lembre-se que a árvore final de consultas é esta:
Durante a execução da consulta, consultas individuais são executadas independentemente nos campos pesquisáveis.
O TermQuery, "spacious", corresponde ao documento 1 (Hotel Atman).
A PrefixQuery, "ar-condicionado*", não corresponde a nenhum documento.
Este comportamento por vezes confunde os programadores. Embora o termo ar condicionado exista no documento, está dividido em dois termos pelo analisador padrão. Lembre-se que as consultas prefixas, que contêm termos parciais, não são analisadas. Assim, os termos com o prefixo "ar-condicionado" são consultados no índice invertido e não encontrados.
A PhraseQuery, "vista para o oceano", procura os termos "oceano" e "vista" e verifica a proximidade dos termos no documento original. Os documentos 1, 2 e 3 correspondem a esta consulta no campo de descrição. Note que o documento 4 tem o termo "oceano" no título, mas não é considerado uma correspondência, pois procuramos a expressão "vista para o oceano" em vez de palavras individuais.
Nota
Uma consulta de pesquisa é executada independentemente em todos os campos pesquisáveis no índice Pesquisa de IA do Azure, a menos que limite os campos definidos com o parâmetro searchFields, como ilustrado no exemplo de pedido de pesquisa. Os documentos que correspondem em qualquer um dos campos selecionados são devolvidos.
No geral, para a consulta em questão, os documentos que correspondem são 1, 2 e 3.
Fase 4: Pontuação
Cada documento num conjunto de resultados de pesquisa recebe uma pontuação de relevância. A função da pontuação de relevância é classificar melhor aqueles documentos que melhor respondem a uma pergunta do utilizador, conforme expressa pela consulta de pesquisa. A pontuação é calculada com base nas propriedades estatísticas dos termos que coincidiram. No cerne da fórmula de pontuação está a frequência de termo–frequência inversa do documento (TF/IDF). Em consultas que contêm termos raros e comuns, o TF/IDF promove resultados que contêm o termo raro. Por exemplo, num índice hipotético com todos os artigos da Wikipédia, a partir de documentos que correspondem à consulta o presidente, documentos que correspondem ao presidente são considerados mais relevantes do que documentos que correspondem o.
Exemplo de pontuação
Recorde os três documentos que correspondiam à nossa consulta de exemplo:
search=Spacious, air-condition* +"Ocean view"
{
  "value": [
    {
      "@search.score": 0.25610128,
      "id": "1",
      "title": "Hotel Atman",
      "description": "Spacious rooms, ocean view, walking distance to the beach."
    },
    {
      "@search.score": 0.08951007,
      "id": "3",
      "title": "Playa Hotel",
      "description": "Comfortable, air-conditioned rooms with ocean view."
    },
    {
      "@search.score": 0.05967338,
      "id": "2",
      "title": "Ocean Resort",
      "description": "Located on a cliff on the north shore of the island of Kauai. Ocean view."
    }
  ]
}
O Documento 1 correspondeu melhor à consulta porque tanto o termo espaçoso como a expressão necessária vista para o oceano aparecem no campo de descrição. Os dois documentos seguintes correspondem apenas à expressão vista para o oceano. Pode surpreender-se que as pontuações de relevância dos documentos 2 e 3 sejam diferentes, mesmo que correspondam à consulta da mesma forma. Isto porque a fórmula de pontuação tem mais componentes do que apenas TF/IDF. Neste caso, o documento 3 recebeu uma pontuação ligeiramente superior porque a sua descrição é mais curta. Saiba mais sobre a Fórmula Prática de Pontuação da Lucene para compreender como o comprimento do campo e outros fatores podem influenciar a pontuação de relevância.
Alguns tipos de consulta (wildcard, prefixo e regex) contribuem sempre com uma pontuação constante para a pontuação global do documento. Isto permite que correspondências encontradas através da expansão da consulta sejam incluídas nos resultados sem afetar a classificação.
Um exemplo ilustra porque isto é importante. As pesquisas por wildcard, incluindo as pesquisas por prefixo, são ambíguas por definição porque a entrada é uma cadeia parcial com potenciais correspondências num número muito grande de termos díspares. Considere uma entrada de "tour*", com correspondências encontradas em "tours", "tourette" e "tourmalina". Dada a natureza destes resultados, não há forma razoável de inferir quais os termos mais valiosos do que outros. Por esta razão, ignoramos as frequências dos termos ao pontuar resultados em consultas de tipos curinga, prefixo e regex. Num pedido de pesquisa em várias partes que inclui termos parciais e completos, os resultados da entrada parcial são incorporados com uma pontuação constante para evitar viés para correspondências potencialmente inesperadas.
Ajuste de relevância
Existem duas formas de ajustar as pontuações de relevância no Pesquisa de IA do Azure:
Os perfis de pontuação promovem documentos na lista ordenada de resultados com base num conjunto de regras. No nosso exemplo, poderíamos considerar documentos que coincidiam no campo de título mais relevantes do que documentos que coincidiam no campo de descrição. Além disso, se o nosso índice tivesse um campo de preços para cada hotel, poderíamos promover documentos com preços mais baixos. Saiba mais sobre como adicionar perfis de pontuação a um índice de pesquisa.
O aumento de termos (disponível apenas na sintaxe de consulta Full Lucene) fornece um operador
^de aumento que pode ser aplicado a qualquer parte da árvore de consultas. No nosso exemplo, em vez de pesquisar pelo prefixo air-condition*, pode-se procurar o termo exato air-condition ou o prefixo, mas documentos que correspondem ao termo exato são classificados mais altos ao aplicar impulso na consulta de termos: air-condition^2||air-condition*. Saiba mais sobre potenciação de termos numa consulta.
Pontuação num índice distribuído
Todos os índices no Pesquisa de IA do Azure são automaticamente divididos em múltiplos fragmentos, o que nos permite distribuir rapidamente o índice entre múltiplos nós durante o aumento ou a redução da escala do serviço. Quando um pedido de busca é emitido, ele é realizado contra cada fragmento de maneira independente. Os resultados de cada fragmento são então fundidos e ordenados por pontuação (se não estiver definida outra ordenação). É importante saber que a função de pontuação pondera a frequência do termo de consulta contra a sua frequência inversa nos documentos em todos os documentos dentro do fragmento, não em todos os fragmentos!
Isto significa que uma pontuação de relevância pode ser diferente para documentos idênticos se estiverem em shards diferentes. Felizmente, tais diferenças tendem a desaparecer à medida que o número de documentos no índice cresce devido à distribuição mais uniforme dos termos. Não é possível assumir em que fragmento cada documento será colocado. No entanto, assumindo que uma chave de documento não muda, ela é sempre atribuída ao mesmo shard.
Em geral, a pontuação dos documentos não é o melhor atributo para ordenar documentos se a estabilidade da ordem for importante. Por exemplo, dados dois documentos com pontuação idêntica, não há garantia de que um apareça primeiro nas sequências seguintes da mesma consulta. A pontuação do documento deve apenas dar uma noção geral da relevância do documento em relação a outros documentos do conjunto de resultados.
Conclusão
O sucesso dos motores de busca comerciais elevou as expectativas para a pesquisa em texto integral em detrimento dos dados privados. Para quase qualquer tipo de experiência de pesquisa, agora esperamos que o motor compreenda a nossa intenção, mesmo quando os termos estão mal escritos ou incompletos. Podemos até esperar correspondências baseadas em termos ou sinónimos quase equivalentes que nunca especificámos.
Do ponto de vista técnico, a pesquisa por texto integral é altamente complexa, exigindo uma análise linguística sofisticada e uma abordagem sistemática ao processamento de formas que destilam, expandam e transformam termos de consulta para entregar um resultado relevante. Dadas as complexidades inerentes, existem muitos fatores que podem afetar o resultado de uma consulta. Por esta razão, investir tempo a compreender a mecânica da pesquisa por texto integral oferece benefícios concretos ao tentar lidar com resultados inesperados.
Este artigo explorou a pesquisa por texto integral no contexto do Pesquisa de IA do Azure. Esperamos que lhe forneça base suficiente para reconhecer causas potenciais e soluções para resolver problemas comuns de consultas.
Próximos passos
Constrói o índice de exemplo, experimenta diferentes consultas e revê os resultados. Para instruções, consulte Construa e consulte um índice no portal Azure.
Experimente outra sintaxe de consulta da secção de exemplo Search Documents ou da Simple query syntax no explorador de pesquisa no portal Azure.
Revise os perfis de pontuação se quiser ajustar o ranking na sua aplicação de pesquisa.
Configure analisadores personalizados para processamento mínimo ou processamento especializado em campos específicos.